noticias
A IA que reescreve as próprias regras: Self-Harness mostra que o futuro dos agentes pode estar fora do modelo
**Etiqueta: 🔬 Tecnologia Explicada**
A IA que reescreve as próprias regras: Self-Harness mostra que o futuro dos agentes pode estar fora do modelo
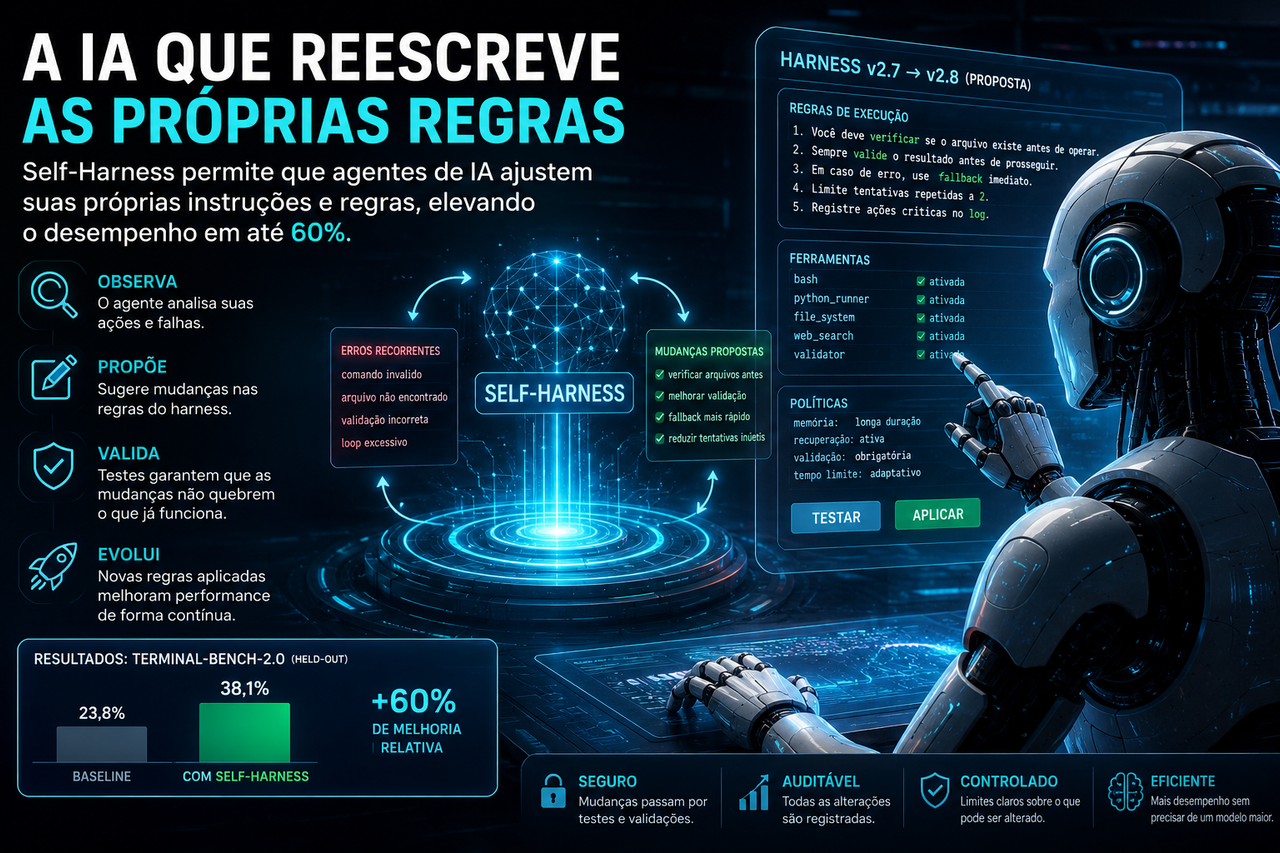
A nova fronteira dos agentes de inteligência artificial talvez não esteja apenas em modelos maiores, mais caros ou treinados com volumes cada vez mais absurdos de dados. Uma pesquisa apresentada sob o nome Self-Harness aponta para uma direção mais sutil e, em muitos aspectos, mais importante: permitir que o próprio agente analise suas falhas, identifique padrões de erro e proponha mudanças nas regras que organizam seu comportamento.
Não se trata de uma IA ganhando consciência, nem de um sistema mágico que aprende sozinho no sentido cinematográfico da expressão.
Trata-se de algo tecnicamente mais modesto, porém estrategicamente mais relevante: uma arquitetura em que o modelo permanece o mesmo, mas o ambiente operacional ao redor dele passa a evoluir com base em evidências.
Para entender o peso disso, é preciso abandonar a ideia simplificada de que um agente de IA é apenas um modelo conversando com o usuário. Na prática, um agente moderno é uma combinação entre modelo, instruções de sistema, ferramentas disponíveis, memória, regras de validação, políticas de execução, mecanismos de tentativa e erro, limites de segurança e formas de verificar se a tarefa realmente foi concluída. Esse conjunto é chamado de harness, uma espécie de estrutura operacional que transforma uma IA genérica em um sistema capaz de agir em um ambiente específico. Quando um agente falha, portanto, o problema nem sempre está no “cérebro” do modelo. Muitas vezes, está na forma como ele foi instruído a usar ferramentas, registrar progresso, validar resultados ou se recuperar de uma ação mal executada.
O Self-Harness entra justamente nesse ponto. Em vez de depender exclusivamente de engenheiros humanos ajustando manualmente prompts, fluxos e regras de execução, o framework cria um ciclo em que o próprio agente observa suas trajetórias anteriores, identifica grupos de falhas recorrentes e propõe pequenas alterações no harness. Essas alterações não são aceitas automaticamente. Elas passam por uma etapa de validação, com testes de regressão, para reduzir o risco de que uma mudança resolva um problema específico e piore o comportamento geral do sistema.
O avanço está menos na ideia romântica de “autoaperfeiçoamento” e mais na disciplina experimental: observar, propor, testar, aceitar ou rejeitar.
Na prática, isso muda a forma como empresas podem pensar agentes de IA em produção. Hoje, muitos projetos travam porque o agente funciona bem em demonstrações curtas, mas degrada quando precisa executar tarefas longas, lidar com ambientes reais, corrigir erros, preservar contexto ou entregar artefatos verificáveis. O Self-Harness sugere que uma parte desse gargalo pode ser atacada não com um modelo maior, mas com um sistema melhor de aprendizagem operacional. O agente passa a aprender, não alterando seus pesos internos, mas refinando as regras externas que orientam sua própria execução. É como trocar a obsessão por um funcionário mais inteligente pela construção de um ambiente de trabalho mais bem desenhado.
O impacto inicial deve aparecer primeiro em agentes técnicos, especialmente aqueles que operam em terminal, programação, automação, análise de arquivos, execução de comandos e resolução de tarefas verificáveis. Esse é o território ideal porque há rastros claros do que aconteceu, logs de execução, comandos usados, arquivos criados, erros retornados e critérios objetivos de sucesso ou fracasso. Em ambientes assim, o agente consegue comparar intenção e resultado com mais precisão. Isso é muito diferente de pedir que uma IA melhore sozinha em uma conversa vaga, subjetiva ou aberta, onde não há um verificador confiável dizendo se a resposta realmente resolveu o problema.
O detalhe mais importante é que o Self-Harness não promete uma inteligência artificial livre para modificar qualquer coisa. O escopo é controlado. O modelo não reescreve seus próprios pesos, não altera sua arquitetura interna e não ganha autonomia irrestrita sobre o sistema. Ele propõe mudanças em superfícies específicas do harness, dentro de limites definidos pelos pesquisadores. Essa distinção é essencial porque separa avanço técnico de fantasia perigosa. O que está sendo testado é uma forma de evolução operacional supervisionada por evidências, e não uma IA desgovernada reprogramando a si mesma sem freios.
Ainda assim, há riscos reais. O primeiro é o overfitting operacional: o agente pode aprender regras que funcionam bem em um benchmark, mas não generalizam para tarefas reais. O segundo é a opacidade progressiva: se muitas alterações forem aceitas ao longo do tempo sem documentação adequada, o harness pode se tornar um labirinto de remendos difíceis de auditar. O terceiro é a segurança. Um agente que aprende a modificar suas próprias regras de execução precisa de limites muito claros sobre o que pode alterar, quais ferramentas pode acessar e quais validações são obrigatórias antes de uma mudança entrar em produção. Autoaperfeiçoamento sem governança vira dívida técnica com marketing bonito.
O que ninguém ainda está discutindo com a profundidade necessária é que essa linha de pesquisa desloca parte do valor da IA para fora do modelo. Durante os últimos anos, a indústria concentrou atenção em quem tinha o maior modelo, a maior janela de contexto, o maior cluster de GPUs e a melhor pontuação em benchmarks. O Self-Harness aponta para uma camada diferente de competição: quem tem o melhor sistema operacional para agentes. Nesse cenário, vencer não significa apenas ter o modelo mais poderoso, mas ter o melhor conjunto de rotinas, verificadores, memória, ferramentas, políticas, logs, testes e mecanismos de adaptação.
Essa mudança pode ser especialmente relevante para empresas que não têm orçamento para operar os modelos mais caros do mercado. Se um modelo menor, combinado com um harness bem ajustado, consegue reduzir erros e melhorar desempenho em tarefas específicas, o custo de adoção de agentes pode cair. Isso não elimina a vantagem dos modelos de ponta, mas cria um caminho intermediário mais pragmático. Em vez de esperar pelo próximo salto de escala, equipes podem investir em instrumentação, testes, observabilidade e ciclos de melhoria do comportamento agente. É menos glamouroso que anunciar uma nova IA revolucionária, mas provavelmente mais útil para quem precisa colocar sistemas funcionando na vida real.
Do ponto de vista cultural, o Self-Harness também muda a narrativa sobre autonomia. A pergunta deixa de ser “a IA vai pensar por conta própria?” e passa a ser “quais partes do seu próprio processo a IA pode melhorar com segurança?”.
Essa formulação é mais madura porque reconhece que sistemas inteligentes podem participar da melhoria de seus ambientes sem que isso implique consciência, intenção ou vontade própria. Um agente pode detectar que costuma insistir em comandos fracassados, que esquece de verificar arquivos gerados ou que demora demais para sair da exploração e partir para a implementação. A partir daí, pode propor regras melhores para evitar esses padrões no futuro.
A análise da PixBugTech é que o Self-Harness representa um passo importante na engenharia de agentes, mas não deve ser vendido como revolução absoluta. Ele mostra que há muito desempenho escondido no design do harness, e que agentes podem ajudar a descobrir ajustes que humanos talvez demorassem mais para perceber. Ao mesmo tempo, o próprio estudo deixa claro que esse processo precisa de avaliadores, testes e limites. A parte mais promissora não é a IA “reescrever as próprias regras” de forma livre, mas a criação de um ciclo auditável em que falhas viram evidências, evidências viram propostas, propostas viram testes e apenas mudanças aprovadas viram comportamento novo.
O futuro mais provável é que agentes corporativos passem a ter camadas de autoavaliação contínua. Eles não apenas executarão tarefas, mas também manterão relatórios sobre onde falharam, quais padrões se repetiram, quais regras deveriam ser revisadas e quais mudanças melhoraram ou pioraram o desempenho. Isso aproxima agentes de IA de sistemas de software mais maduros, com logs, testes, versionamento e rollback. A diferença é que a própria IA começa a participar da manutenção do seu ambiente operacional. Não como dona do sistema, mas como uma colaboradora técnica dentro de uma arquitetura controlada.
No longo prazo, frameworks como Self-Harness podem marcar a passagem da era dos agentes improvisados para a era dos agentes gerenciáveis.
A primeira geração encantou porque parecia capaz de fazer tudo. A segunda precisará provar que consegue melhorar sem se perder, agir sem quebrar processos, adaptar-se sem comprometer segurança e aprender com falhas sem transformar cada correção em um novo problema. É nesse ponto que a pesquisa fica interessante: não porque aproxima a IA de uma fantasia autônoma, mas porque aproxima os agentes de algo muito mais útil e difícil — sistemas que evoluem com método.
👉 Dúvida? Então veja mais em: [https://pixbugtech.com/linksuteis](https://pixbugtech.com/linksuteis)