noticias
A Lei da IA já existia. Agora a Europa começa a cobrar
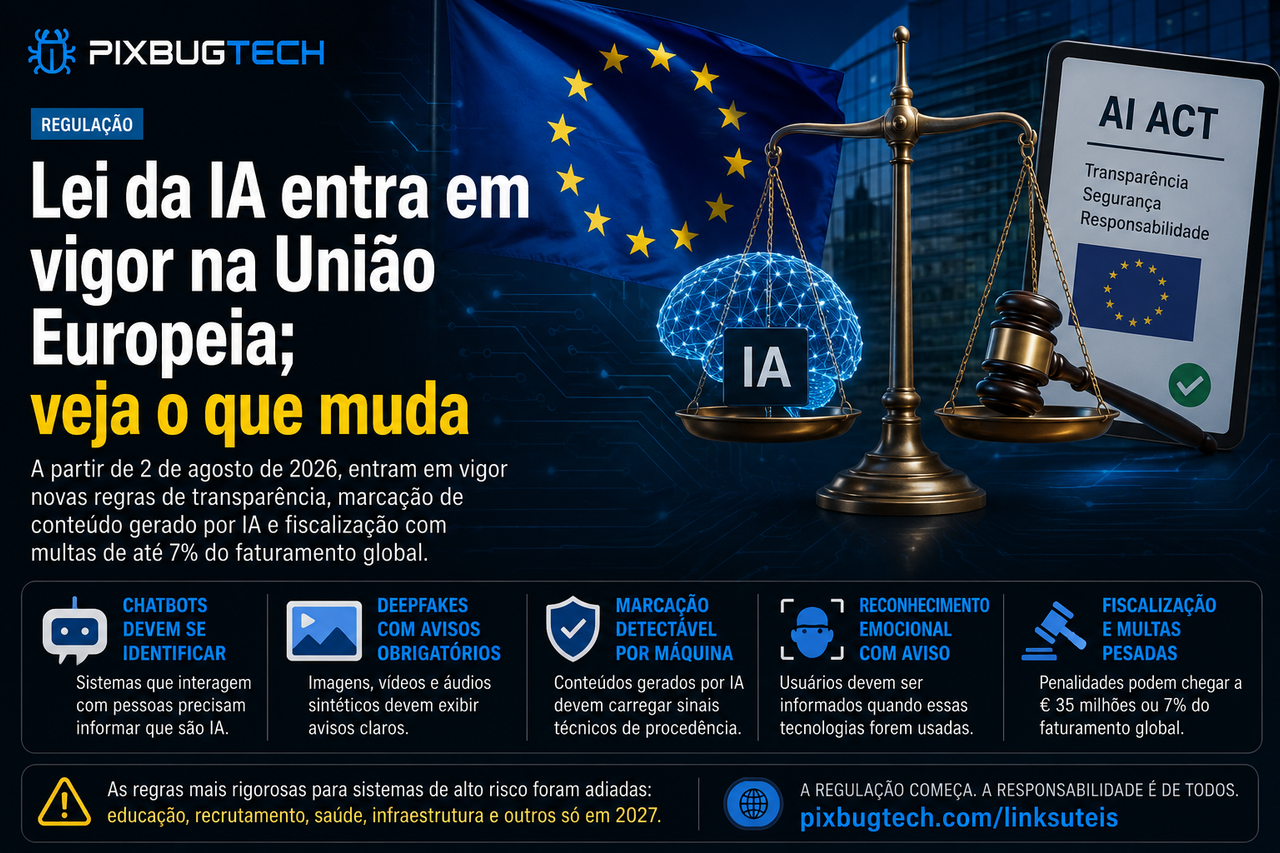
**A partir de 2 de agosto de 2026, chatbots devem se identificar, deepfakes passam a exigir avisos e conteúdos sintéticos precisam carregar marcações detectáveis. Mas as regras mais duras para sistemas de alto risco foram adiadas, revelando os limites políticos da regulação europeia**
A União Europeia chega neste domingo, 2 de agosto de 2026, a uma das etapas mais importantes de sua regulamentação sobre inteligência artificial. A partir de agora, autoridades nacionais e o Escritório Europeu de Inteligência Artificial passam a exercer poderes mais amplos de fiscalização, enquanto empresas precisam cumprir novas obrigações de transparência para chatbots, agentes digitais, geradores de imagens, sistemas de reconhecimento emocional e conteúdos manipulados por IA.
Dizer que a Lei da IA “entra em vigor” agora, entretanto, simplifica demais o cronograma. O regulamento europeu foi publicado e passou a existir juridicamente em 2024. Algumas práticas consideradas inaceitáveis foram proibidas em fevereiro de 2025, e regras para modelos de propósito geral, categoria que inclui a base tecnológica de sistemas como ChatGPT, Gemini e Claude, começaram a ser aplicadas em agosto daquele ano. O que muda em 2026 é que a legislação deixa de ser principalmente uma promessa regulatória e ganha mecanismos mais visíveis de cobrança.
A mudança mais imediata estará diante do usuário. Sistemas que conversam diretamente com pessoas deverão informar, de maneira clara, que a interação está sendo conduzida por uma inteligência artificial, salvo quando isso for evidente. A obrigação inclui chatbots, avatares digitais e agentes capazes de executar tarefas ou manter diálogos em nome de empresas.
Isso parece simples, mas alcança um mercado que passou anos tentando tornar suas máquinas cada vez mais humanas. Assistentes de atendimento recebem nomes, fotografias artificiais, vozes naturais e roteiros cuidadosamente escritos para evitar que o consumidor perceba a automação. A Europa decidiu que esse teatro precisa ter uma placa na entrada.
Deepfakes precisarão ser identificados
Imagens, vídeos e áudios gerados ou manipulados por inteligência artificial que possam parecer autênticos deverão ser claramente identificados quando forem apresentados ao público. Não será suficiente esconder a informação nos termos de uso ou depender apenas de metadados invisíveis.
Empresas que fornecem sistemas generativos também deverão incluir marcações legíveis por máquinas nos conteúdos produzidos. A intenção é permitir que plataformas, mecanismos de busca, verificadores e outras ferramentas reconheçam que determinado arquivo foi criado ou alterado artificialmente.
As duas medidas cumprem funções diferentes. A marcação técnica tenta construir uma cadeia automatizada de procedência. O aviso visível informa diretamente a pessoa que assiste, lê ou escuta o material. Um arquivo pode carregar metadados e, ainda assim, precisar exibir uma indicação perceptível de que foi manipulado.
A obrigação não transforma todo uso de inteligência artificial em deepfake. Correções técnicas, edições convencionais, determinados efeitos cinematográficos e alterações que não procuram simular a realidade podem ficar fora da classificação. Obras artísticas, satíricas ou ficcionais também podem utilizar formas de aviso que não destruam a experiência criativa.
A dificuldade estará em determinar quando uma manipulação deixa de ser edição e começa a produzir uma falsa aparência de autenticidade. Melhorar a iluminação de uma fotografia não é o mesmo que colocar uma pessoa em um lugar onde ela nunca esteve. Entre esses extremos existe uma enorme área cinzenta que será disputada por plataformas, produtoras, anunciantes e autoridades.
O arquivo precisará carregar sua própria história
A exigência de uma marcação detectável tenta responder a um problema que o velho aviso “feito com IA” não consegue resolver sozinho. Uma imagem pode ser copiada, recortada, comprimida, convertida para outro formato e publicada milhares de vezes. Durante esse percurso, legendas desaparecem, contextos são removidos e o conteúdo termina circulando como se fosse um registro legítimo.
A ideia europeia é fazer com que o próprio arquivo carregue algum sinal técnico de sua origem. Isso pode envolver metadados, credenciais criptográficas, marcas imperceptíveis ou outros sistemas interoperáveis de procedência.
Não existe, porém, uma tecnologia perfeita para essa função. Metadados podem ser removidos. Marcas podem sofrer com compressão, edição ou captura de tela. Sistemas de detecção baseados apenas na aparência do conteúdo produzem falsos positivos e falsos negativos. Uma obrigação legal pode acelerar a adoção de padrões, mas não elimina as limitações técnicas.
O risco é que a marcação se transforme em um ritual de conformidade. A empresa insere um identificador no arquivo original, cumpre formalmente a regra e considera o problema resolvido, embora o sinal desapareça depois da primeira repostagem. A eficiência da lei dependerá da adoção coordenada por geradores, editores, redes sociais, aplicativos de mensagens e plataformas de distribuição.
Sem essa cadeia, o rótulo corre o risco de funcionar apenas enquanto o conteúdo permanece dentro do ambiente controlado pela empresa que o produziu.
Textos sobre assuntos públicos entram na discussão
A regulamentação também alcança textos gerados ou manipulados por IA quando são publicados para informar o público sobre assuntos de interesse coletivo. Isso inclui política, administração pública, Justiça, segurança, saúde, economia, ciência, meio ambiente, cultura e outros temas relevantes ao debate social.
A norma não determina que qualquer frase auxiliada por IA receba automaticamente um aviso. A própria Comissão Europeia reconhece uma exceção importante: textos submetidos a revisão humana efetiva, controle editorial e responsabilidade jurídica identificável podem ser dispensados da rotulagem pública.
Essa distinção será especialmente relevante para jornais, portais, agências, assessorias, instituições públicas e produtores profissionais de conteúdo. Utilizar uma ferramenta para organizar dados, revisar uma estrutura ou auxiliar na redação não é tratado da mesma forma que publicar automaticamente um texto sem que uma pessoa competente examine as afirmações.
A revisão precisa ser substantiva. Corrigir ortografia, ajustar vírgulas ou aprovar mecanicamente o material não equivale a exercer controle editorial. Deve existir alguém com autoridade para verificar fontes, questionar conclusões, alterar o texto, rejeitar a publicação e assumir responsabilidade por ela.
A regra europeia, nesse ponto, toca em uma diferença que parte da indústria prefere ignorar: usar IA em uma redação não elimina necessariamente o jornalismo, mas publicar a saída de uma máquina sem apuração, edição ou responsabilidade transforma o conteúdo em outra coisa. Automatizar a escrita é fácil. Automatizar a credibilidade continua sendo uma promessa de vendedor.
Reconhecimento emocional também deverá ser revelado
Pessoas expostas a sistemas de reconhecimento de emoções ou categorização biométrica deverão ser informadas de que essas tecnologias estão sendo utilizadas. Isso alcança ferramentas que afirmam interpretar expressões faciais, tom de voz, movimentos corporais ou características biométricas para inferir estados emocionais ou classificar indivíduos.
A obrigação de transparência não significa que a União Europeia considere essas tecnologias cientificamente confiáveis. Em alguns contextos, como escolas e ambientes de trabalho, determinados usos de reconhecimento emocional já enfrentavam proibições desde 2025.
O aviso resolve apenas o problema da invisibilidade. Uma pessoa pode agora saber que está sendo analisada por uma máquina, mas isso não responde se o sistema funciona, se a inferência é legítima, se existe consentimento real ou se aquela tecnologia deveria estar operando.
Esse é um limite recorrente da transparência regulatória. Informar não equivale a justificar. Um aviso pode revelar que existe uma câmera analisando expressões sem oferecer qualquer poder concreto para recusar a análise.
Empresas brasileiras também podem ser atingidas
A aplicação da lei não depende apenas da localização física da empresa. Fornecedores estabelecidos fora da União Europeia podem ser alcançados quando colocam sistemas no mercado europeu ou quando os resultados produzidos por suas ferramentas são utilizados dentro do bloco.
Uma startup brasileira que oferece um chatbot para clientes europeus, uma agência que produz campanhas sintéticas destinadas à Europa ou uma plataforma que processa dados de usuários europeus não deveria presumir que está fora do alcance da regulamentação apenas por manter seus servidores ou sua sede no Brasil.
O impacto prático será sentido primeiro nos contratos. Empresas europeias começarão a exigir informações sobre marcação de conteúdo, documentação técnica, fornecedores de modelos, proteção de dados, mecanismos de supervisão e resposta a incidentes. Mesmo organizações que não sejam diretamente fiscalizadas poderão receber as obrigações por meio da cadeia comercial.
Isso cria uma espécie de exportação regulatória. Para continuar atendendo ao mercado europeu, fornecedores estrangeiros tendem a incorporar requisitos da União Europeia ao produto inteiro, em vez de manter duas arquiteturas completamente separadas.
O fenômeno já ocorreu com o Regulamento Geral de Proteção de Dados. A Europa não domina todas as grandes plataformas digitais, mas utiliza o tamanho de seu mercado para influenciar como essas plataformas operam internacionalmente.
As multas deixam de ser uma ameaça abstrata
O novo estágio também fortalece a capacidade de investigação. O Escritório Europeu de IA poderá solicitar documentação, exigir informações, avaliar modelos, pedir acesso técnico, determinar medidas corretivas e, em situações graves, restringir a disponibilidade de determinados sistemas.
A fiscalização será dividida. O Escritório Europeu terá papel central sobre modelos de propósito geral e determinados sistemas ligados a grandes plataformas. Autoridades nacionais cuidarão da maior parte das outras aplicações. Instituições da própria União Europeia ficarão sob a supervisão do órgão europeu responsável pela proteção de dados.
Violações de obrigações como transparência e deveres aplicáveis a modelos de propósito geral podem resultar em multas de até € 15 milhões ou 3% do faturamento mundial anual da empresa, prevalecendo o valor mais elevado. O uso de práticas proibidas pode levar a penalidades de até € 35 milhões ou 7% da receita global.
Os números chamam atenção, mas a ameaça financeira não garante fiscalização uniforme. Os países europeus possuem estruturas administrativas, recursos técnicos e prioridades diferentes. Uma lei complexa aplicada por autoridades com capacidades desiguais pode produzir decisões inconsistentes e criar jurisdições mais tolerantes que outras.
A União Europeia tenta reduzir essa fragmentação concentrando parte da supervisão no Escritório de IA e oferecendo códigos de prática, orientações técnicas e canais de denúncia. Ainda assim, fiscalizar um sistema que muda semanalmente, utiliza componentes de várias empresas e pode operar em servidores de outro continente será muito mais difícil do que publicar uma tabela de multas.
As regras mais difíceis foram adiadas
A principal ressalva desta nova etapa está no que não começa agora. Poucos dias antes de 2 de agosto, a União Europeia colocou em vigor o chamado AI Omnibus, uma reforma que simplificou partes da legislação e estendeu os prazos para sistemas classificados como de alto risco.
Ferramentas utilizadas em educação, recrutamento, infraestrutura crítica, biometria, migração, fronteiras e outras áreas sensíveis deverão cumprir suas obrigações mais rigorosas a partir de 2 de dezembro de 2027. Sistemas de IA incorporados a produtos regulados, como máquinas, brinquedos e elevadores, ganharam prazo até 2 de agosto de 2028.
A mudança foi apresentada como uma forma de conceder mais tempo para a elaboração de padrões técnicos, adaptação das empresas e redução de custos administrativos. Também demonstra a pressão enfrentada pela União Europeia para não transformar sua ambição regulatória em uma desvantagem comercial diante dos Estados Unidos e da China.
Existe uma ironia difícil de ignorar. As obrigações mais simples de comunicar que “isto foi feito por uma máquina” avançam em 2026. As regras que exigem documentação, avaliação de riscos, qualidade de dados, rastreabilidade, supervisão humana, segurança e robustez em sistemas capazes de afetar empregos, crédito, educação e serviços públicos foram empurradas para frente.
A transparência é necessária, mas politicamente menos dolorosa. Colocar uma etiqueta em uma imagem custa menos do que reconstruir um sistema de recrutamento para provar que ele não discrimina candidatos.
A lei regula riscos, não a inteligência
A estrutura europeia divide os usos da IA por níveis de risco. Aplicações triviais, como filtros de spam ou recursos em videogames, recebem poucas obrigações. Sistemas capazes de manipular pessoas, explorar vulnerabilidades ou realizar determinadas formas de vigilância podem ser proibidos. Entre esses extremos estão ferramentas que exigem transparência e sistemas de alto risco sujeitos a controles mais profundos.
Essa abordagem é mais racional do que tentar regular qualquer programa que utilize aprendizado de máquina. O problema é que a classificação depende do contexto. O mesmo modelo pode produzir uma legenda para uma fotografia, selecionar currículos, orientar uma decisão médica ou auxiliar uma investigação policial.
O risco não está apenas dentro do algoritmo. Ele nasce da combinação entre tecnologia, finalidade, base de dados, poder de decisão e consequências para quem é avaliado.
Uma ferramenta aparentemente limitada pode se tornar crítica quando integrada a um processo institucional. Um chatbot de atendimento muda de natureza quando passa a negar benefícios, interpretar direitos ou recomendar decisões sem possibilidade real de revisão humana.
A lei europeia tenta acompanhar essa mudança de contexto, mas empresas continuarão procurando enquadramentos menos exigentes. Boa parte das disputas futuras não será sobre o funcionamento técnico da IA, e sim sobre qual categoria jurídica deve ser aplicada ao sistema.
O rótulo não resolverá a desinformação
Saber que uma imagem foi produzida por IA é útil, mas não determina se ela é verdadeira ou falsa. Uma fotografia autêntica pode ser publicada com uma legenda mentirosa. Uma imagem sintética pode reconstruir corretamente um evento histórico. Um texto escrito inteiramente por uma pessoa pode espalhar desinformação, enquanto um relatório auxiliado por IA pode estar apoiado em fontes verificáveis.
A origem do conteúdo e a veracidade da informação são problemas relacionados, mas diferentes.
Existe ainda o risco de um efeito perverso. À medida que conteúdos artificiais passam a receber rótulos, fraudadores podem explorar a ausência de marcação como uma falsa prova de autenticidade. Um arquivo sem identificação não será necessariamente humano; poderá apenas ter perdido ou removido seus sinais técnicos.
A legislação cria uma camada de procedência, não um detector universal da verdade. Seu sucesso dependerá de educação digital, jornalismo, mecanismos de contestação, responsabilização das plataformas e capacidade técnica para preservar os sinais ao longo da distribuição.
A Europa começa pelo possível
A nova fase da Lei da IA representa uma mudança real. Empresas já não poderão tratar a identidade artificial de seus sistemas como uma escolha de design. Plataformas generativas precisarão pensar em procedência desde a criação do conteúdo. Organizações profissionais terão de decidir quem revisa, quem aprova e quem assume responsabilidade pelo que uma máquina produz.
Também é uma legislação incompleta e submetida às mesmas pressões econômicas que tenta controlar. O adiamento das regras de alto risco mostra que a União Europeia não está regulando de uma posição confortável. Ela precisa proteger direitos sem sufocar empresas locais em um mercado dominado por corporações estrangeiras com mais capital, infraestrutura e poder político.
A partir de 2 de agosto de 2026, a pergunta deixa de ser apenas se uma empresa declarou apoio aos princípios da inteligência artificial responsável. Autoridades poderão perguntar onde está a documentação, como o conteúdo é marcado, quem responde pelo sistema e por que o usuário não foi informado.
Ainda não é o controle integral da inteligência artificial imaginado pelas manchetes. É o início de uma infraestrutura de fiscalização. A diferença parece burocrática, mas é justamente onde as leis deixam de ser discursos e começam a produzir consequências.
👉 Dúvida? Então veja mais em: https://pixbugtech.com/linksuteis