noticias
Agentes de programação aceleram o desenvolvimento, mas a conta da IA começa a assustar as empresas
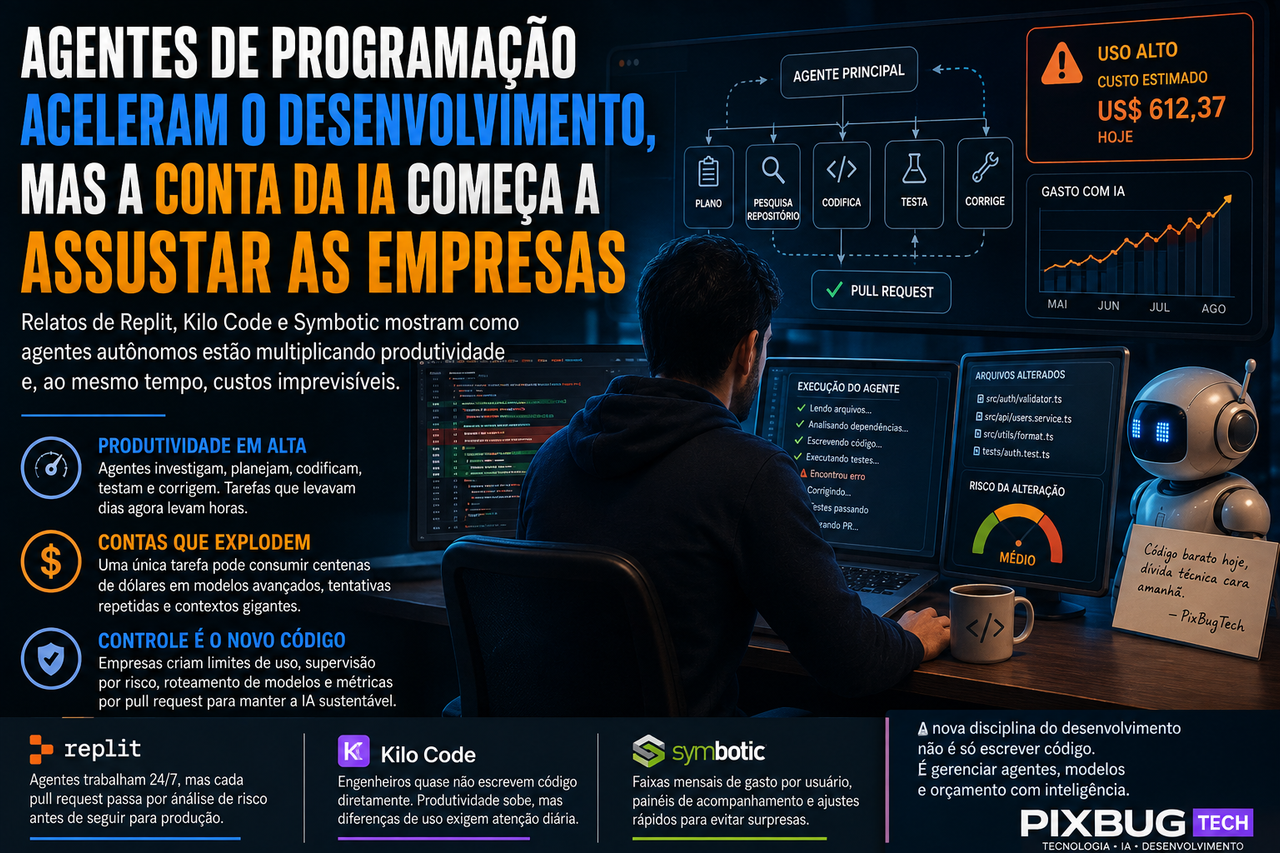
Os agentes de inteligência artificial estão mudando a rotina de equipes de software com uma velocidade que os departamentos financeiros ainda não aprenderam a acompanhar. Ferramentas capazes de investigar repositórios, planejar alterações, escrever código, executar testes e corrigir os próprios erros já assumem tarefas que antes consumiam horas ou dias de trabalho humano. O ganho de produtividade pode ser real, mas vem acompanhado de uma nova categoria de despesa: execuções longas, imprevisíveis e difíceis de relacionar diretamente ao valor entregue.
Relatos apresentados por Replit, Kilo Code e Symbotic durante o VB Transform 2026 mostram que o problema deixou de ser experimental. Algumas empresas já acompanham gastos por funcionário, estabelecem limites mensais, distribuem tarefas entre modelos de preços diferentes e investigam usuários que consomem centenas de dólares em um único dia. A preocupação não é apenas impedir desperdícios. É compreender quanto custa, de fato, permitir que uma máquina trabalhe de maneira autônoma sobre um sistema complexo.
A discussão costuma começar pelo preço dos tokens, a unidade usada para medir o texto processado e produzido pelos modelos. Esse indicador, porém, explica cada vez menos. Um agente não recebe uma solicitação e simplesmente devolve uma resposta. Ele abre arquivos, pesquisa dependências, consulta documentação, escreve uma primeira solução, executa testes, encontra erros, revisa o plano e tenta novamente. Em alguns casos, cria agentes auxiliares para investigar partes diferentes do problema.
O prompt digitado pelo desenvolvedor pode ser pequeno. A operação desencadeada por ele não é.
O custo não está na pergunta, mas em tudo o que o agente faz depois
Assistentes tradicionais de programação foram desenvolvidos para completar trechos de código, explicar funções ou sugerir correções. O consumo era relativamente previsível porque a interação permanecia curta e dependia da ação constante do usuário. Agentes alteram esse equilíbrio ao transformar uma instrução em um processo que pode continuar por vários minutos ou horas.
Cada nova etapa exige que o modelo receba contexto suficiente para entender o que aconteceu anteriormente. Isso pode incluir o histórico da tarefa, a estrutura do projeto, arquivos relevantes, mensagens de erro, resultados de testes e regras internas do repositório. Quando a execução se prolonga, parte desse material é reenviada repetidamente.
Uma tarefa que falha dez vezes não gera apenas dez respostas adicionais. Ela pode exigir que milhares de linhas sejam novamente processadas a cada tentativa. Se o sistema usa um modelo de alto desempenho, com uma janela de contexto extensa e preço elevado, uma atividade aparentemente simples pode consumir um orçamento desproporcional ao resultado.
É por isso que a queda no preço unitário dos modelos não significa necessariamente redução da despesa total. A inferência fica mais barata, mas os agentes usam mais inferência. Eles trabalham por períodos maiores, processam mais arquivos e multiplicam chamadas que antes precisariam ser iniciadas manualmente.
A indústria está repetindo uma velha história da computação: quando um recurso se torna mais acessível, sua utilização cresce mais rapidamente do que sua eficiência. Servidores mais baratos não diminuíram o consumo mundial de infraestrutura. Armazenamento barato não fez empresas guardarem menos dados. Modelos mais baratos provavelmente não farão agentes utilizarem menos processamento.
Na Kilo Code, o desenvolvedor já administra máquinas que programam
A Kilo Code apresentou uma das descrições mais radicais dessa mudança. Segundo a cofundadora Emilie Schario, engenheiros da companhia passam apenas uma pequena parcela do tempo escrevendo ou lendo código diretamente. Grande parte da implementação é realizada por agentes, enquanto os profissionais humanos se concentram na definição de objetivos, na investigação de problemas difíceis e na revisão do que foi produzido.
A declaração não deve ser confundida com uma prova de que programadores se tornaram dispensáveis. O que muda é o ponto em que o conhecimento humano entra no processo. Escrever uma função pode deixar de ser a atividade principal, mas decidir qual função deve existir, quais restrições precisam ser respeitadas e como identificar um erro sutil continua exigindo experiência.
Quanto mais código a máquina produz, mais importante se torna o julgamento de quem supervisiona. Um agente consegue entregar uma solução tecnicamente plausível para um problema mal formulado. Também pode implementar corretamente uma funcionalidade que não deveria ter sido criada. Velocidade de execução não corrige decisões ruins; apenas faz com que elas cheguem mais rápido ao repositório.
A automação também cria diferenças expressivas de consumo entre profissionais. Schario relatou o caso de um engenheiro que aparece repetidamente entre os maiores usuários dos recursos da empresa e precisa explicar quais atividades estão sendo executadas. Em determinado momento, esse uso teria atingido cerca de US$ 600 em um único dia.
O número parece alarmante, mas isoladamente não diz se houve desperdício. Se o agente resolveu uma falha crítica, produziu várias alterações aprovadas ou eliminou semanas de trabalho, a despesa pode ser razoável. Caso tenha passado horas repetindo tentativas sobre uma tarefa mal definida, o mesmo valor representa apenas processamento desperdiçado.
Essa ambiguidade expõe o problema central. Empresas sabem quanto pagam por uma licença de software, por um servidor ou por um profissional. Ainda não sabem quanto deveriam pagar por uma tarefa executada por agentes, especialmente quando o custo depende da complexidade do projeto, da quantidade de tentativas e do modelo escolhido em cada etapa.
A Kilo Code passou a observar o gasto relacionado a cada pull request, isto é, cada conjunto de alterações enviado para revisão. A métrica é mais útil do que contar tokens, mas continua imperfeita. Um pull request pode corrigir uma falha grave ou apenas alterar um detalhe visual. Pode ser aprovado imediatamente, refeito várias vezes ou abandonado.
Contar entregas não basta quando as entregas possuem valores tão diferentes.
A Replit tenta colocar risco e orçamento no mesmo sistema
A Replit trabalha com uma arquitetura na qual agentes podem planejar, implementar e testar mudanças, enquanto outra camada avalia o risco de cada alteração. Modificações simples podem seguir um fluxo mais automatizado; mudanças sensíveis são encaminhadas para revisão humana.
Essa separação é necessária porque a autonomia não pode ser uniforme. Alterar o texto de uma página institucional não apresenta o mesmo risco que modificar autenticação, pagamentos ou controle de acesso. Permitir que os dois tipos de tarefa avancem sob as mesmas regras seria uma maneira eficiente de transformar produtividade em incidente.
Amol Jain, chefe de engenharia de produto da Replit, relatou um caso em que a equipe não conseguia reproduzir nem resolver um erro profundo do sistema. O problema foi entregue a um gerenciador de agentes, que distribuiu a investigação entre múltiplas instâncias. Depois de localizar a origem da falha, novos agentes teriam sido acionados para produzir a correção. Cerca de seis horas depois, havia um pull request preparado.
O caso mostra o potencial da automação agêntica. A máquina conseguiu sustentar uma investigação durante horas, testar hipóteses em paralelo e organizar o resultado para avaliação posterior. Esse tipo de trabalho pode ser especialmente valioso fora do horário comercial, quando incidentes continuam afetando usuários, mas a equipe humana está reduzida.
A mesma arquitetura, no entanto, pode consumir recursos durante horas sem produzir uma solução útil. Um agente não necessariamente percebe que a tarefa perdeu sentido econômico. Se recebe permissão para continuar, continuará procurando arquivos, modificando código e executando testes até encontrar uma condição de encerramento ou atingir algum limite externo.
O ser humano costuma interromper uma investigação quando percebe que está preso, pedir ajuda ou redefinir o problema. O agente precisa ser programado para reconhecer essas situações. Sem limites de tempo, custo ou tentativas, a autonomia se transforma em perseverança cega.
A cobrança da Replit baseada em esforço reflete essa realidade. Operações simples consomem menos recursos; tarefas longas, integrações e ciclos repetidos utilizam mais créditos. Até conversas de planejamento podem gerar custos, mesmo quando nenhum código é alterado. Isso rompe com a expectativa criada por décadas de software vendido por licença mensal previsível.
A plataforma oferece alertas e limites rígidos de orçamento. Esses controles são úteis, mas também revelam que os agentes não se comportam como uma ferramenta tradicional. Eles se aproximam de uma infraestrutura computacional variável, cujo consumo precisa ser acompanhado quase em tempo real.
O agente caro pode estar fora da engenharia
Um dos episódios mais interessantes relatados pela Replit ocorreu em uma equipe de suporte, não entre desenvolvedores. A empresa identificou um usuário com consumo excepcionalmente alto e descobriu que a automação estava executando tarefas com um modelo muito mais caro do que o necessário.
O fluxo funcionava. O problema era econômico.
Esse tipo de situação tende a se repetir conforme agentes forem adotados em departamentos jurídicos, financeiros, administrativos e comerciais. Um funcionário pode criar uma rotina para analisar documentos, responder clientes ou organizar relatórios sem perceber que cada execução aciona um modelo de fronteira, processa um contexto extenso e realiza várias chamadas auxiliares.
Em uma empresa tradicional, a maior parte da infraestrutura tecnológica é contratada e controlada por equipes especializadas. Com agentes, qualquer departamento pode começar a consumir capacidade de inteligência artificial por meio de uma interface simples. A descentralização aumenta a inovação, mas também espalha despesas que antes permaneciam concentradas.
O orçamento de IA poderá se fragmentar em centenas de pequenas decisões tomadas por pessoas que não conhecem o custo técnico das ferramentas utilizadas. Uma tarefa aparentemente banal, executada dezenas de vezes por dia, pode superar rapidamente o valor de um contrato corporativo.
A Replit afirma ter observado ganhos de produtividade de aproximadamente três vezes em determinados usos de engenharia. O dado deve ser tratado como percepção interna da companhia, não como resultado universal ou auditoria independente. A produtividade em software é difícil de medir e frequentemente reduzida a indicadores que favorecem a narrativa da automação.
Mais linhas de código não significam necessariamente melhor produto. Mais pull requests podem representar apenas mudanças menores. Uma funcionalidade entregue rapidamente pode exigir meses de manutenção ou introduzir falhas que só aparecerão em produção.
A IA facilita medir o que foi produzido. Continua difícil medir o que realmente valeu a pena produzir.
A Symbotic transformou consumo de IA em autorização administrativa
A Symbotic, especializada em automação de armazéns, adotou uma estratégia mais próxima da gestão financeira convencional. Funcionários recebem faixas mensais de utilização, enquanto gestores acompanham tendências de consumo, atividades realizadas e alterações submetidas aos repositórios.
Quando um profissional precisa de mais capacidade, o limite pode ser aumentado. Quando o uso não se justifica, a empresa consegue intervir antes que a despesa cresça silenciosamente.
O método não resolve a avaliação do retorno, mas cria responsabilidade. Em vez de descobrir o problema apenas depois do fechamento da fatura, o gestor participa da decisão de ampliar o orçamento. A inteligência artificial deixa de ser tratada como recurso ilimitado e passa a competir com outras prioridades da empresa.
A Symbotic também enfrentou o impacto de mudanças comerciais impostas pelos fornecedores. O encerramento de condições promocionais e acessos mais baratos obrigou a companhia a reconsiderar quais modelos deveriam ser utilizados em diferentes tarefas e linguagens.
Esse risco aparece pouco nas apresentações sobre produtividade. Uma empresa pode estruturar seus processos considerando determinado modelo, preço ou limite de uso. Se o fornecedor altera a cobrança, reduz a franquia ou retira uma funcionalidade, toda a economia da operação precisa ser refeita.
A dependência não está apenas no código. Está na disponibilidade do modelo que ajuda a produzi-lo.
Quanto mais os agentes participam do desenvolvimento, maior fica a exposição a decisões externas. Um aumento de preço pode reduzir a produtividade viável. Uma mudança de política pode bloquear dados sensíveis. A retirada de um modelo pode alterar o comportamento de fluxos já consolidados.
Empresas que não mantiverem alternativas descobrirão que terceirizaram parte de sua capacidade de engenharia para uma tabela de preços que não controlam.
Usar o melhor modelo em tudo é uma forma elegante de desperdiçar dinheiro
Replit, Kilo Code e Symbotic convergem em uma conclusão pouco glamourosa, mas essencial: a maioria das tarefas não precisa do modelo mais poderoso disponível.
Modelos de fronteira podem ser necessários para decisões arquitetônicas, falhas difíceis, migrações extensas e problemas de segurança. Usá-los para formatar arquivos, produzir testes previsíveis, revisar documentação ou executar pequenas alterações é financeiramente ineficiente.
A alternativa é distribuir tarefas entre modelos diferentes. Um sistema mais avançado pode interpretar o problema e criar o plano. Um modelo menor executa mudanças repetitivas. Outra ferramenta revisa o resultado. O modelo mais caro só entra quando a dificuldade ou o risco justificam sua utilização.
Essa estratégia, conhecida como roteamento, reduz custos, mas adiciona uma nova camada de engenharia. Modelos não diferem apenas em preço e qualidade. Possuem políticas de retenção, limites de contexto, regiões de processamento e comportamentos distintos diante do mesmo código.
Uma empresa pode economizar na inferência e gastar mais com correções. Um modelo barato que falha repetidamente pode custar mais do que uma opção cara que resolve a tarefa na primeira tentativa. O cálculo precisa incluir todas as tentativas, o tempo humano de revisão e os defeitos introduzidos.
A conta correta não é quanto custa uma chamada. É quanto custa chegar a um resultado aceito.
Tokens medem processamento, não produtividade
O setor ainda utiliza tokens porque são fáceis de contabilizar. O problema é que eles dizem quanto foi processado, não o que foi alcançado.
Pesquisas recentes sobre agentes de programação indicam que a mesma tarefa pode apresentar grande variação de consumo entre execuções. Também não existe uma relação simples entre gastar mais tokens e produzir uma resposta melhor. Em alguns casos, o agente consome recursos adicionais porque está avançando em uma investigação complexa. Em outros, apenas repete tentativas sem melhorar.
Os próprios agentes demonstram dificuldade para estimar antecipadamente quanto uma tarefa exigirá. Antes de começar, não sabem se encontrarão rapidamente os arquivos corretos ou se serão empurrados para uma sequência de erros, dependências quebradas e testes demorados.
Isso torna frágeis as previsões tradicionais de orçamento. Uma equipe pode estimar que determinada atividade consumirá alguns dólares e descobrir, horas depois, que múltiplos agentes processaram o mesmo repositório repetidamente.
A métrica mais útil é o custo por tarefa aceita, incluindo tentativas, revisões e correções. Ainda assim, ela precisa ser relacionada ao impacto real. Uma tarefa pode ser tecnicamente concluída e comercialmente irrelevante.
O retorno aparece quando a automação reduz o tempo de solução de incidentes, antecipa uma entrega importante, evita trabalho repetitivo ou melhora a qualidade de forma verificável. Sem essa conexão, o painel apenas transforma desperdício em gráfico.
Sistemas antigos continuarão exigindo humanos que entendam suas cicatrizes
Agentes funcionam melhor em projetos novos, nos quais a arquitetura pode ser organizada desde o início e as regras estão relativamente claras. Em sistemas antigos, encontram dependências acumuladas, integrações frágeis e decisões que nunca foram documentadas adequadamente.
Um trecho de código aparentemente absurdo pode existir para preservar compatibilidade com um cliente importante. Uma tabela aparentemente redundante pode sustentar um relatório usado por outro departamento. Um comportamento considerado defeituoso pode ter se tornado parte informal do contrato com os usuários.
O agente vê o estado atual do código. Nem sempre compreende a história que produziu aquele estado.
Jared Go, engenheiro de IA e nuvem da Symbotic, destacou que os agentes apresentam mais facilidade em projetos novos, enquanto ambientes antigos continuam exigindo forte intervenção humana. A observação é importante porque a maior parte do software empresarial não foi criada para receber agentes de IA.
Bancos, órgãos públicos, indústrias e grandes varejistas operam sistemas construídos ao longo de décadas. A possibilidade de automatizar sua manutenção é atraente, mas o custo de uma interpretação incorreta pode ultrapassar qualquer economia obtida na programação.
A inteligência artificial consegue produzir código com rapidez. Compreender por que determinada regra existe continua sendo outra profissão.
Produzir código barato pode criar uma manutenção muito cara
Existe ainda um efeito que raramente aparece nas demonstrações: quanto mais fácil fica criar software, maior se torna a quantidade de software que as empresas precisam manter.
Quando uma funcionalidade exigia semanas de desenvolvimento, equipes eram obrigadas a escolher prioridades. Com agentes, torna-se possível gerar integrações, painéis, automações e experimentos em poucas horas. Como o custo inicial parece baixo, a organização acumula projetos.
Cada novo componente passa a exigir atualizações, testes, documentação, monitoramento e correções de segurança. Dependências ficam obsoletas. Serviços externos mudam. Regras de negócio são alteradas. Uma automação criada para economizar algumas horas pode permanecer durante anos dentro da infraestrutura.
O agente reduz o custo de escrever a primeira versão. Não elimina o ciclo de vida do código.
O resultado pode ser uma nova dívida técnica produzida em escala industrial. Em vez de poucos sistemas difíceis de manter, empresas passam a ter dezenas de aplicações criadas rapidamente e compreendidas superficialmente.
A afirmação de que alguns engenheiros quase não leem mais o código produzido pelos agentes é especialmente preocupante nesse aspecto. Ler código não é apenas uma atividade manual. É uma forma de construir conhecimento sobre o sistema.
Se a produção cresce mais rápido do que a compreensão humana, a empresa ganha velocidade operacional e perde autonomia técnica.
Documentação automática, testes robustos, mapas de dependência, registro de decisões e observabilidade deixam de ser boas práticas opcionais. Tornam-se o mínimo necessário para impedir que os agentes construam uma infraestrutura que ninguém consegue explicar.
Controle de custos e segurança começam a ser o mesmo problema
Um agente de programação não consome apenas tokens. Ele abre arquivos, executa comandos, acessa serviços, modifica repositórios e interage com credenciais. Na prática, transforma-se em uma identidade operacional dentro da infraestrutura da empresa.
Quanto maior sua autonomia, maior também a superfície de risco. O agente pode incluir informações confidenciais no contexto enviado ao modelo, seguir instruções maliciosas escondidas em um arquivo, modificar componentes indevidos ou produzir código vulnerável.
Limites de tempo, orçamento e número de tentativas não servem apenas para proteger a fatura. Eles reduzem a quantidade de ações que um sistema comprometido ou desorientado consegue executar.
Uma sessão com consumo anormal pode indicar que o agente ficou preso em um erro. Também pode significar que saiu do escopo, encontrou conteúdo malicioso ou começou a processar dados que não deveriam estar disponíveis.
A gestão financeira da IA começa a se misturar com segurança, governança e controle de acesso. Empresas que tratarem cada área separadamente terão painéis diferentes tentando explicar o mesmo incidente.
O desenvolvedor não desaparece; torna-se responsável por uma força de trabalho computacional
A chegada dos agentes altera o papel do profissional de software. Em vez de executar cada mudança, o desenvolvedor distribui tarefas, escolhe modelos, define níveis de autonomia e estabelece critérios de aceitação.
É uma função menos próxima da digitação de código e mais parecida com a gestão de um sistema produtivo. O engenheiro passa a administrar máquinas capazes de trabalhar em paralelo, consumir orçamento e tomar decisões operacionais.
Isso exige mais do que saber escrever prompts. Será necessário compreender arquitetura, segurança, custos, testes e limitações dos modelos. O profissional precisa saber quando a máquina está acelerando o trabalho e quando apenas está produzindo mais atividade.
A facilidade da interface pode criar uma geração de usuários capazes de solicitar software sem entender o que foi construído. Para experimentos pequenos, isso pode ser suficiente. Em sistemas críticos, é uma dependência perigosa.
O profissional mais valioso não será aquele que simplesmente gera mais código. Será quem consegue transformar capacidade computacional em resultado confiável e interromper o agente quando o trabalho já não justifica a despesa.
A conta alta não prova fracasso, mas encerra a fase da ingenuidade
Os gastos crescentes não significam que os agentes de programação falharam. Eles mostram que essas ferramentas estão assumindo tarefas maiores e sendo usadas com intensidade suficiente para afetar os orçamentos.
Tecnologias irrelevantes raramente criam problemas financeiros desse tamanho.
O que termina agora é a fase em que bastava anunciar a adoção de inteligência artificial e apresentar algumas demonstrações impressionantes. Com agentes executando centenas de tarefas todos os dias, empresas terão de demonstrar retorno, controlar riscos e explicar por que determinada execução consumiu mais do que outra.
Replit, Kilo Code e Symbotic estão construindo respostas diferentes: supervisão baseada em risco, acompanhamento por pull request, distribuição entre modelos e limites mensais por funcionário. Nenhuma dessas soluções elimina a imprevisibilidade. Todas reconhecem que autonomia sem governança é apenas uma maneira tecnologicamente sofisticada de perder o controle.
A próxima disputa entre plataformas de programação com IA não será vencida apenas por quem produzir o código mais convincente em uma demonstração. Vencerá quem conseguir entregar alterações úteis com custo previsível, segurança suficiente e rastreabilidade sobre cada decisão.
Produzir código está ficando mais barato. Saber qual código deve existir, quanto vale pagar por ele e quando a máquina precisa parar está se tornando mais caro — e muito mais importante.
👉 Dúvida? Então veja mais em: https://pixbugtech.com/linksuteis