noticias
Amazon lança TorchNeuron para desafiar a Nvidia e facilitar o uso de chips alternativos em inteligência artificial
CATEGORIA EDITORIAL: INTELIGÊNCIA ARTIFICIAL E HARDWARE
Amazon lança TorchNeuron para desafiar a Nvidia e facilitar o uso de chips alternativos em inteligência artificial
Nova ferramenta de código aberto permite executar aplicações desenvolvidas em PyTorch nos processadores Trainium da AWS com alterações mínimas, atacando uma das maiores vantagens competitivas da Nvidia: seu ecossistema de software.
Meta description: Amazon lança TorchNeuron para executar IA nos chips Trainium sem reescrever código e desafiar o domínio da Nvidia no mercado de inteligência artificial.
Slug: `amazon-torchneuron-chips-ia-nvidia-pytorch-trainium`
A AWS apresentou o **TorchNeuron**, ferramenta gratuita e de código aberto que permite executar aplicações de inteligência artificial nos chips Trainium sem precisar reescrever o código desenvolvido em PyTorch.
A novidade mira diretamente uma das maiores fortalezas da Nvidia: o ecossistema CUDA, que mantém milhões de desenvolvedores ligados às suas GPUs.
💻 Mas será que facilitar a migração de software é suficiente para ameaçar a liderança da Nvidia?
A disputa agora vai muito além da potência dos chips.
Leia a análise completa na **PixBugTech**.
\#Amazon #Nvidia #TorchNeuron #InteligenciaArtificial #AWS #PyTorch #PixBugTech
Briefing da imagem editorial
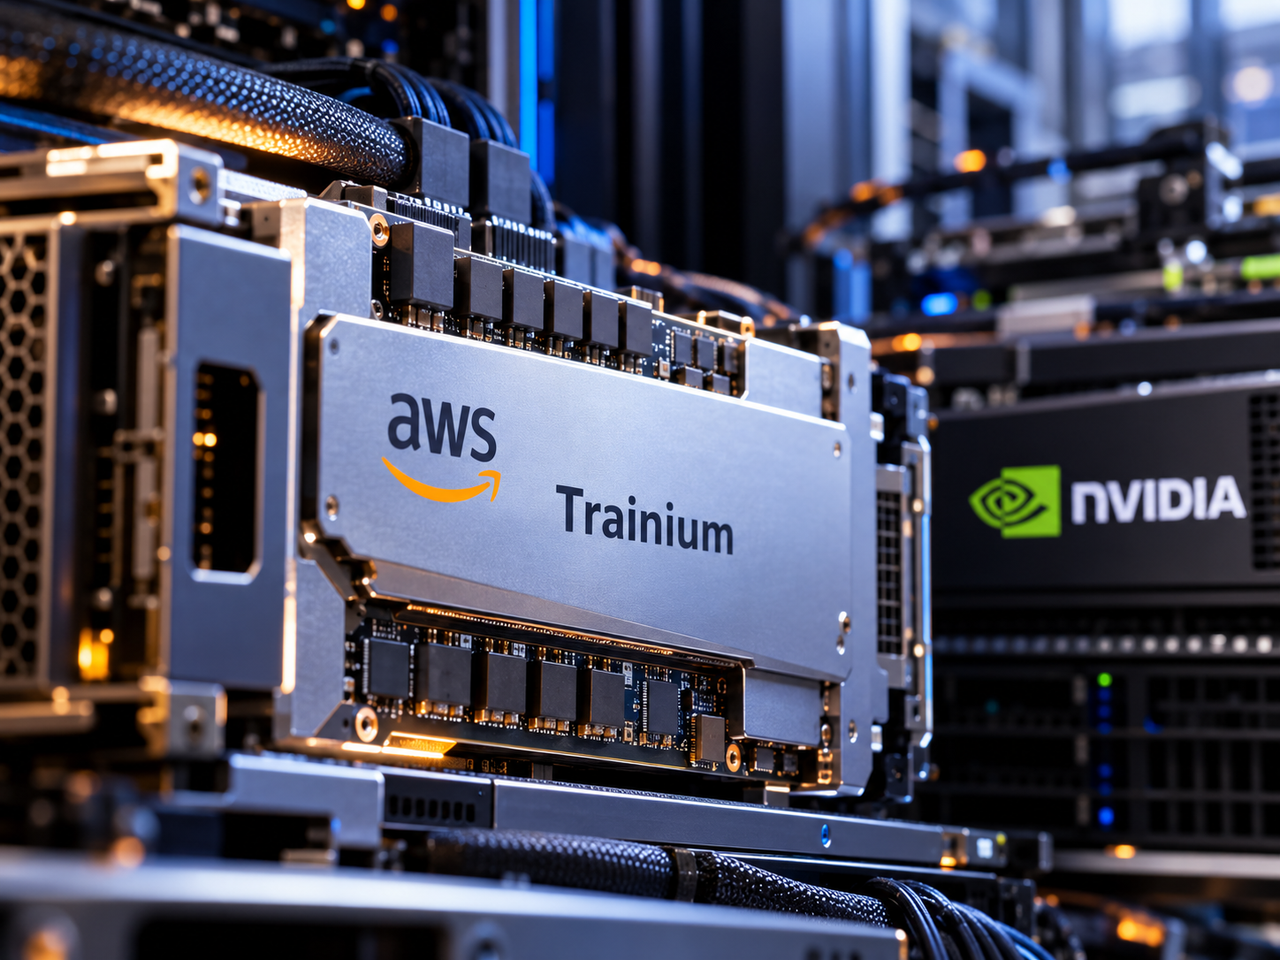
Imagem editorial fotorrealista, horizontal em proporção 4:3, destinada a 800 × 600 pixels. Fotografia macro de uma placa aceleradora para inteligência artificial instalada em uma infraestrutura de servidores, com elementos visuais discretos que remetam ao processamento de IA e à arquitetura de semicondutores. A identidade da Amazon AWS e da Nvidia deve aparecer em elementos reconhecíveis, sem sugerir um produto conjunto ou confronto físico fictício. Iluminação técnica realista, fundo com racks desfocados e composição sofisticada, sem hologramas, cérebros digitais, robôs ou estética cyberpunk.
Texto alternativo: Processador de inteligência artificial em infraestrutura de servidores, representando a iniciativa da Amazon de ampliar o uso dos chips Trainium e desafiar o domínio da Nvidia com o TorchNeuron.
Matéria completa
Amazon lança TorchNeuron e ataca o verdadeiro poder da Nvidia no mercado de inteligência artificial
Ferramenta de código aberto permite executar projetos desenvolvidos em PyTorch nos chips Trainium da AWS com mudanças mínimas, reduzindo uma das principais barreiras para abandonar a infraestrutura baseada em GPUs da Nvidia.
A Amazon apresentou uma ferramenta capaz de atingir um dos pontos mais importantes da liderança da Nvidia no mercado de inteligência artificial: a dependência dos desenvolvedores de seu ecossistema de software. Anunciado em 19 de outubro de 2026 e disponibilizado em versão pública no dia 20, o TorchNeuron permite executar aplicações desenvolvidas com PyTorch diretamente nos aceleradores Trainium da Amazon Web Services (AWS), sem exigir a reescrita completa dos projetos.
A iniciativa pode parecer apenas mais uma atualização de software para desenvolvedores, mas seu significado econômico é consideravelmente maior. Durante anos, a Nvidia construiu uma posição privilegiada não apenas por fabricar processadores poderosos, mas por oferecer ferramentas que tornaram suas GPUs uma escolha natural para treinamento e execução de modelos de IA.
A Amazon pretende reduzir essa vantagem ao permitir que equipes utilizem seus projetos existentes em outra arquitetura de hardware com poucas modificações.
Segundo a companhia, mais de 30 organizações participaram dos testes iniciais da ferramenta, incluindo empresas que trabalham com robótica, geração de vídeo, modelos de representação do mundo, reconhecimento de voz e descoberta de medicamentos.
O TorchNeuron chega em um momento no qual as grandes empresas de tecnologia investem bilhões de dólares em infraestrutura computacional e buscam alternativas para controlar custos, ampliar a capacidade de processamento e diminuir a dependência de fornecedores específicos.
O domínio da Nvidia não depende apenas dos seus processadores
Para compreender a importância do TorchNeuron, é necessário observar como a Nvidia consolidou sua posição na indústria.
A empresa começou a desenvolver o CUDA em 2006, criando uma plataforma de computação paralela que permite utilizar GPUs para tarefas muito além da renderização gráfica.
Com o avanço das técnicas de aprendizado profundo, essa infraestrutura passou a oferecer ferramentas essenciais para pesquisadores e empresas que treinam redes neurais.
O resultado foi a formação de um ecossistema que reúne bibliotecas, compiladores, frameworks, ferramentas de otimização e uma comunidade numerosa de profissionais especializados.
Essa integração é uma vantagem econômica poderosa.
Quando uma empresa desenvolve seus sistemas de inteligência artificial utilizando ferramentas otimizadas para determinado hardware, migrar para outro fornecedor pode envolver adaptações, novos testes, revalidação de resultados e treinamento de profissionais.
Mesmo quando um processador concorrente apresenta condições comerciais mais atraentes, esses custos de migração podem tornar a substituição pouco vantajosa.
É justamente essa dependência que a Amazon pretende reduzir.
Por que o PyTorch é tão importante nessa disputa?
O PyTorch é um framework de código aberto amplamente utilizado para desenvolver, treinar e executar modelos de inteligência artificial.
Criado originalmente pelo Facebook e atualmente mantido sob a estrutura da Linux Foundation, tornou-se uma das principais ferramentas de pesquisa e desenvolvimento de modelos de aprendizado profundo.
Segundo a Amazon, aproximadamente 85% dos pesquisadores e desenvolvedores de IA utilizam PyTorch em seus projetos. Esse percentual é uma estimativa apresentada pela própria companhia e não deve ser interpretado como uma medição independente de participação de mercado.
Sua popularidade faz da compatibilidade com PyTorch um requisito estratégico para fabricantes de aceleradores.
Uma empresa que consiga executar aplicações existentes sem obrigar seus clientes a reconstruir toda a infraestrutura de software elimina parte importante da resistência à adoção de novos processadores.
Para a Amazon, isso representa uma oportunidade de oferecer os chips Trainium a organizações que anteriormente consideravam a migração tecnicamente complexa ou economicamente arriscada.
Como funciona o TorchNeuron?
O TorchNeuron funciona como uma camada de integração que conecta aplicações desenvolvidas em PyTorch aos aceleradores AWS Trainium.
Em termos simplificados, o software permite que operações definidas no framework sejam executadas utilizando a infraestrutura computacional da Amazon, em vez de depender exclusivamente de GPUs tradicionais.
A AWS afirma que, em muitos projetos, a migração poderá ser realizada com uma alteração na configuração responsável por selecionar o dispositivo de processamento.
Isso representa uma diferença significativa em relação aos procedimentos que anteriormente exigiam adaptações específicas para a arquitetura Trainium.
Arquitetura simplificada do TorchNeuron
Aplicação de inteligência artificial
Modelos e operações escritos em PyTorch
TorchNeuron
Integração nativa do PyTorch com o Trainium
AWS Neuron
Compilação, execução e otimização
AWS Trainium2 / Trainium3
Hardware que realiza os cálculos de IA
Representação conceitual do funcionamento da ferramenta; não corresponde a um diagrama físico dos chips.
Além da compatibilidade com PyTorch, a ferramenta trabalha com tecnologias utilizadas em sistemas de treinamento distribuído, incluindo o TorchTitan.
Esse tipo de integração é importante porque modelos modernos de inteligência artificial frequentemente precisam distribuir cálculos entre múltiplos aceleradores.
Treinar um modelo de linguagem com bilhões de parâmetros, por exemplo, pode exigir a coordenação de centenas ou milhares de processadores, com mecanismos específicos de comunicação, sincronização e gerenciamento de memória.
O TorchNeuron procura preservar fluxos de trabalho familiares aos desenvolvedores, permitindo utilizar uma infraestrutura diferente sem abandonar completamente as ferramentas já conhecidas.
A compatibilidade, entretanto, não significa que qualquer aplicação funcionará imediatamente ou que todos os recursos do PyTorch já estejam disponíveis.
Determinadas operações especializadas, bibliotecas externas e otimizações de baixo nível ainda podem exigir adaptações.
Também não existe garantia de desempenho equivalente entre arquiteturas diferentes: a velocidade e o custo final dependem do modelo, da carga computacional, das técnicas de otimização e da configuração utilizada.
Trainium2 e Trainium3: os processadores da Amazon entram na disputa
O TorchNeuron foi desenvolvido para funcionar com as gerações Trainium2 e Trainium3, aceleradores projetados pela própria Amazon para treinamento e inferência de modelos de inteligência artificial.
[Amazon releases new AI chip amid industry push to challenge Nvidia's dominance](https://images.openai.com/static-rsc-4/dznBDFWctIXVSpkF8MexVe2Qnr6CNFmwsX3rA_res6N3Ul1VhWi5OduUCf4Ca6LO_nxIN-wsCvt7SwDTFeQz-sA_YodUfdRKyJ0MmJG7mgNRDzY794XPskG4fIa_mbOG3EENjshs3dgMQ3iOPJvJPkgSDFGWi5Gtchg9VdvbAH0?purpose=inline)
AWS Trainium3
Terceira geração dos aceleradores de IA da Amazon, desenvolvida para cargas computacionais intensivas em centros de dados, incluindo modelos generativos e sistemas de raciocínio.
Diferentemente de uma GPU de uso geral, os chips Trainium são projetados para executar tarefas específicas de aprendizado de máquina em grandes ambientes computacionais.
Essa especialização permite otimizar diferentes componentes da infraestrutura para padrões de processamento comuns em redes neurais.
Segundo especificações divulgadas pela AWS, o Trainium3 utiliza fabricação em 3 nanômetros, oferece até 2,52 petaflops de capacidade computacional FP8 por chip e integra 144 GB de memória HBM3e.
A memória de alta largura de banda desempenha papel importante nesse tipo de processador porque grandes modelos precisam movimentar enormes quantidades de dados entre memória e unidades de cálculo.
A Amazon também afirma que os servidores equipados com Trainium3 podem oferecer ganhos expressivos de desempenho e eficiência energética em comparação com a geração anterior.
Esses números, entretanto, descrevem condições e comparações definidas pela fabricante. Eles não demonstram, isoladamente, superioridade sobre toda a linha de produtos da Nvidia.
Para determinar qual plataforma oferece o melhor resultado, é necessário comparar sistemas completos em cargas reais, considerando custo de utilização, desempenho sustentado, comunicação entre chips, consumo energético e maturidade do software.
A vantagem econômica pode ser tão importante quanto o desempenho
A fabricação de processadores próprios permite que a Amazon controle uma parcela maior dos custos e das características técnicas de sua infraestrutura.
Em vez de depender exclusivamente da aquisição de GPUs de terceiros, a companhia pode projetar aceleradores adaptados às demandas dos serviços que oferece pela AWS.
Essa estratégia é particularmente relevante para empresas que operam centros de dados em escala global.
Quando uma organização executa milhões de solicitações de modelos de IA diariamente, pequenas diferenças no custo por operação podem representar valores consideráveis ao longo de um ano.
O custo total não depende apenas do preço de aquisição de um processador.
Ele também envolve eletricidade, refrigeração, memória, capacidade de rede, utilização efetiva do equipamento, licenciamento, manutenção e trabalho de engenharia.
A Amazon sustenta que os sistemas Trainium podem oferecer vantagens econômicas para determinadas cargas de IA. A companhia cita, por exemplo, ganhos de custo-benefício de 30% a 40% para configurações Trainium2 em comparação com instâncias específicas equipadas com GPUs.
Essas comparações são apresentadas pela própria AWS e não podem ser generalizadas para todos os projetos.
Um sistema mais barato por hora, mas que demore consideravelmente mais para concluir uma tarefa, pode não representar a melhor escolha.
Da mesma forma, uma plataforma que exige semanas de adaptação de software pode eliminar parte da economia prometida pelo hardware.
O TorchNeuron procura atuar precisamente sobre esse segundo problema.
Ao reduzir o trabalho de migração, a Amazon tenta fazer com que a decisão sobre infraestrutura seja determinada com maior peso pelos resultados econômicos e técnicos, e menos pelas dificuldades de abandonar uma plataforma já conhecida.
A Amazon quer competir com a Nvidia sem deixar de comprar seus chips
Existe uma particularidade importante nessa disputa: a Amazon não pretende necessariamente substituir todas as GPUs da Nvidia em seus centros de dados.
A AWS continua oferecendo instâncias baseadas em processadores Nvidia, atendendo clientes que precisam dessa tecnologia ou que preferem manter ambientes já estruturados.
Paralelamente, desenvolve e comercializa infraestrutura com seus próprios aceleradores.
As duas estratégias não são contraditórias.
Como provedora de computação em nuvem, a Amazon tem interesse em disponibilizar diferentes arquiteturas e atender à demanda dos clientes, independentemente do fabricante escolhido.
Como desenvolvedora de hardware, também possui incentivos para ampliar a utilização de seus chips proprietários.
Essa posição permite que a companhia participe da expansão do mercado de inteligência artificial mesmo quando seus clientes continuam utilizando GPUs da Nvidia.
Ao mesmo tempo, cria condições para negociar fornecedores, diversificar sua infraestrutura e reduzir riscos associados à concentração da cadeia de suprimentos.
O papel da Anthropic e dos grandes modelos de linguagem
A estratégia de chips próprios já possui aplicações de grande escala.
A Anthropic, responsável pela família de modelos Claude, utiliza infraestrutura Trainium em projetos de treinamento e operação de inteligência artificial.
O projeto Rainier, desenvolvido pela Amazon em colaboração com a Anthropic, foi estruturado para reunir centenas de milhares de aceleradores Trainium2.
Essa iniciativa demonstra que os chips da AWS não estão limitados a experimentos acadêmicos ou aplicações de pequeno porte.
No entanto, utilizar Trainium em grandes projetos não significa que a plataforma seja automaticamente adequada a todos os modelos disponíveis.
Cada arquitetura apresenta características próprias de memória, processamento, interconexão e ferramentas de desenvolvimento.
A viabilidade de adoção depende da capacidade de aproveitar esses recursos de maneira eficiente.
Código aberto: a nova arma para conquistar desenvolvedores
O TorchNeuron está sendo disponibilizado como software de código aberto sob a licença Apache 2.0.
Isso permite que desenvolvedores estudem, utilizem e modifiquem o código de acordo com as condições estabelecidas pela licença.
A decisão tem importância estratégica.
Ferramentas abertas podem atrair contribuições de comunidades técnicas, facilitar auditorias e permitir que organizações compreendam melhor as dependências de sua infraestrutura.
Ao mesmo tempo, a abertura de uma camada de software não torna toda a plataforma independente de fornecedores.
O TorchNeuron continua direcionado à execução de aplicações nos aceleradores Trainium, cuja infraestrutura comercial está vinculada à AWS.
Dessa forma, a Amazon reduz uma forma de dependência tecnológica — a necessidade de desenvolver aplicações especificamente para GPUs Nvidia — enquanto incentiva a adoção de sua própria plataforma de computação em nuvem.
Essa distinção ajuda a compreender os limites da iniciativa.
O código aberto facilita o acesso à tecnologia, mas não elimina automaticamente custos de migração, restrições operacionais ou a dependência dos serviços necessários para executar os modelos.
Google e outros fabricantes também procuram alternativas ao CUDA
A movimentação da Amazon faz parte de uma transformação mais ampla na indústria.
O Google desenvolve suas próprias unidades de processamento tensorial, conhecidas como TPUs, enquanto a AMD investe em aceleradores Instinct e no ecossistema de software ROCm.
Cada empresa tenta oferecer alternativas capazes de executar modelos de inteligência artificial com desempenho competitivo e custos atraentes.
O grande desafio não é apenas fabricar processadores com capacidade matemática elevada.
É garantir que desenvolvedores consigam utilizá-los sem reconstruir seus projetos do início.
Por esse motivo, compatibilidade com frameworks populares, bibliotecas especializadas e ferramentas de desenvolvimento tornou-se uma dimensão fundamental da concorrência.
A iniciativa da Amazon evidencia como o mercado começa a deslocar parte da disputa da fabricação de semicondutores para a experiência de desenvolvimento e operação dos sistemas.
A Nvidia conserva uma vantagem relevante por sua experiência acumulada, pela maturidade do CUDA e pela ampla utilização de suas tecnologias.
Mas a possibilidade de executar uma mesma aplicação em diferentes arquiteturas, com menos alterações, tende a tornar as alternativas mais acessíveis.
Análise da equipe: o maior adversário da Nvidia pode ser a liberdade de escolha
A estratégia da Amazon parte de uma constatação importante: processadores competitivos não bastam quando o software mantém os clientes presos a uma arquitetura.
O mercado de inteligência artificial foi construído sobre anos de investimentos em ferramentas, bibliotecas e otimizações que favorecem as GPUs da Nvidia.
Essa vantagem não desaparece simplesmente porque outra empresa apresenta um chip com boas especificações.
Por isso, o TorchNeuron merece atenção.
Em vez de tentar convencer desenvolvedores a abandonar ferramentas conhecidas, a Amazon procura adaptar sua arquitetura aos fluxos de trabalho que eles já utilizam.
Essa abordagem ataca diretamente os custos de mudança de fornecedor.
O efeito potencial é ampliar a concorrência entre plataformas de processamento, permitindo que empresas escolham infraestrutura com maior flexibilidade.
Entretanto, existem limitações importantes.
A simplicidade anunciada precisa funcionar em aplicações reais, incluindo sistemas que utilizam bibliotecas especializadas, operações personalizadas e treinamento distribuído em grande escala.
Também será necessário demonstrar que a compatibilidade não provoca perdas relevantes de desempenho ou dificuldades de manutenção.
A situação é semelhante à observada em outras áreas da computação: implementar compatibilidade com uma plataforma amplamente adotada pode reduzir barreiras de entrada, mas alcançar o mesmo nível de estabilidade, otimização e suporte exige investimento contínuo.
O verdadeiro sucesso do TorchNeuron não será medido pela quantidade de linhas de código que ele promete economizar, mas pela capacidade de permitir que empresas mudem de infraestrutura sem comprometer seus projetos.
Existe ainda uma questão econômica mais ampla.
Embora a ferramenta possa reduzir a dependência da Nvidia, ela também pode estimular a concentração de aplicações dentro da infraestrutura AWS.
Portanto, o avanço não deve ser confundido com uma descentralização completa do mercado.
A disputa continua envolvendo grandes empresas com capacidade financeira para desenvolver semicondutores, construir centros de dados e operar plataformas globais de inteligência artificial.
O próximo capítulo da corrida pelos chips de IA será decidido pelo software
O lançamento do TorchNeuron reforça uma mudança importante na indústria: a competição entre fabricantes de aceleradores já não pode ser compreendida exclusivamente pelas especificações físicas dos processadores.
A maturidade das ferramentas de desenvolvimento, a facilidade de migração, a compatibilidade com projetos existentes e o custo operacional ganharam importância semelhante.
Para a Nvidia, o desafio será preservar as vantagens de seu ecossistema enquanto outras empresas procuram eliminar as dificuldades de utilizar arquiteturas concorrentes.
Para a Amazon, o trabalho começa agora.
A companhia terá de ampliar a compatibilidade do TorchNeuron, demonstrar resultados consistentes em diferentes aplicações e convencer organizações de que seus aceleradores oferecem vantagens suficientes para justificar a migração.
Se essa estratégia produzir resultados, a indústria poderá avançar para um cenário no qual o software de inteligência artificial tenha maior liberdade para utilizar diferentes tipos de processadores.
Isso não significaria necessariamente o fim da liderança da Nvidia.
Significaria, porém, que uma das maiores vantagens competitivas da empresa — a dificuldade de abandonar seu ecossistema — começaria a perder parte de sua força.
E, em um mercado que movimenta investimentos de centenas de bilhões de dólares, diminuir o custo de trocar de fornecedor pode ser tão importante quanto desenvolver um processador mais rápido.
👉 Dúvida? Então veja mais em: [https://pixbugtech.com/linksuteis](https://pixbugtech.com/linksuteis?utm_source=chatgpt.com)