noticias
AMD entra na disputa pelo supercomputador de IA do Brasil e amplia competição em projeto bilionário
**Categoria editorial:** Inteligência Artificial / Hardware / Infraestrutura
AMD entra na disputa pelo supercomputador de IA do Brasil e amplia competição em projeto bilionário
**Linha fina:** Empresa confirmou interesse na infraestrutura de 7.200 petaflops que será instalada no Rio Grande do Norte.
A escolha dos chips pode definir não apenas desempenho, mas custos, software e o grau de dependência tecnológica do projeto brasileiro.
**Meta description:** AMD quer disputar o supercomputador de IA do Brasil, projeto de até R$ 1 bilhão que colocará chips, software e soberania tecnológica à prova.
**Slug:** `amd-supercomputador-ia-brasil`
**Palavra-chave principal:** supercomputador de IA do Brasil
Matéria completa
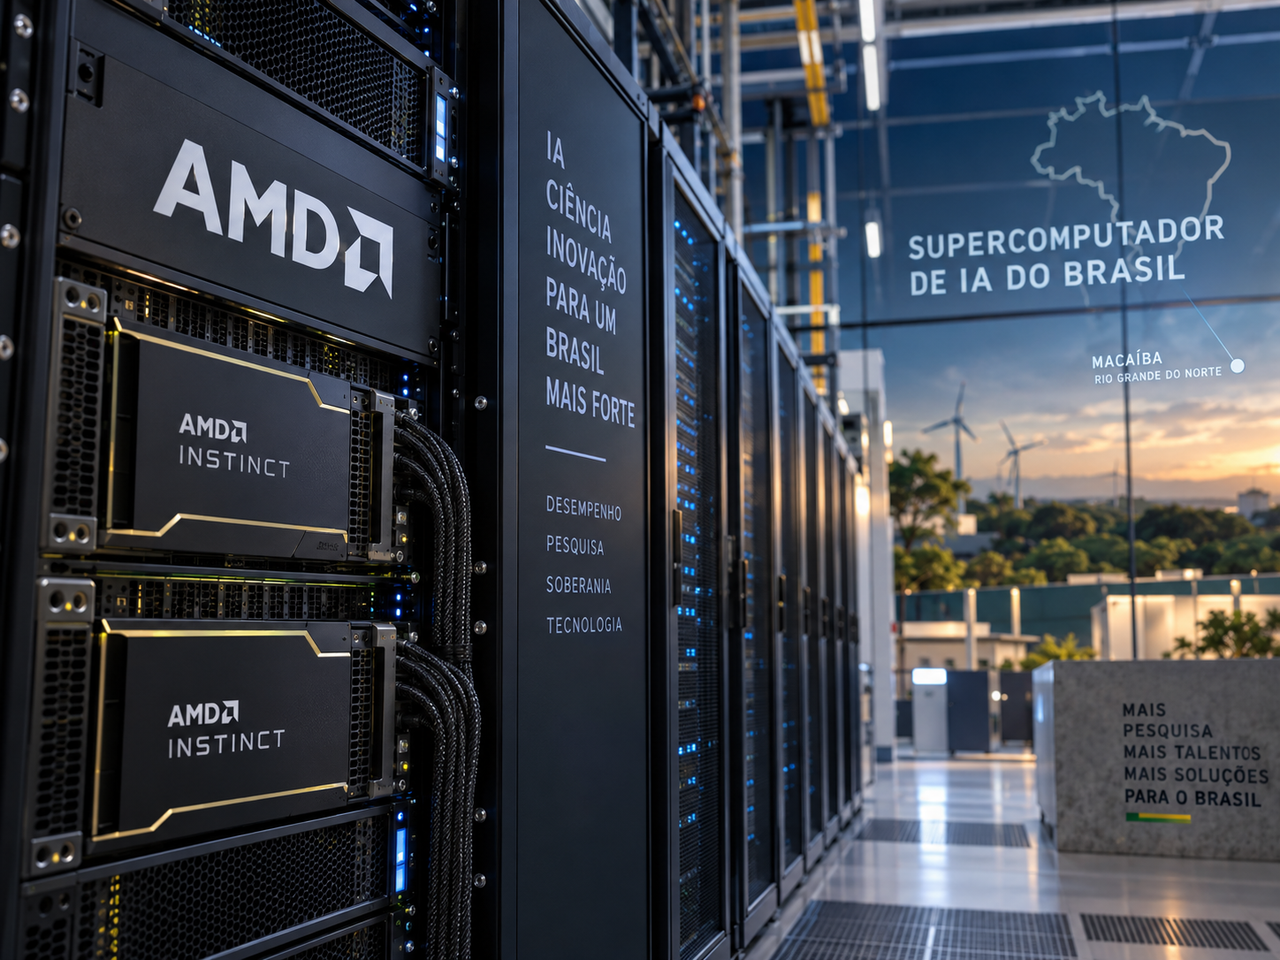
A AMD quer participar da disputa por uma das peças mais importantes da infraestrutura brasileira de inteligência artificial: o novo supercomputador de alto desempenho que será instalado no Parque Científico e Tecnológico Augusto Severo, em Macaíba, na região metropolitana de Natal, no Rio Grande do Norte.
O interesse foi confirmado por Sergio Santos, diretor-geral da AMD no Brasil, que afirmou que a companhia já trabalha no projeto, forneceu informações técnicas ao Ministério da Ciência, Tecnologia e Inovação durante a preparação do edital e pretende participar da concorrência por meio de parceiros responsáveis pela integração dos equipamentos.
Entre as empresas citadas nesse ecossistema estão Dell, Lenovo e HP, capazes de combinar processadores, aceleradores, redes, armazenamento e software em grandes clusters computacionais.
A entrada da AMD torna a disputa especialmente relevante porque havia expectativa de que uma solução baseada predominantemente em tecnologia da Nvidia pudesse ocupar posição privilegiada no projeto.
Essa expectativa, porém, nunca significou resultado definido: a aquisição será realizada por processo competitivo do tipo técnica e preço, e o fornecedor final ainda não foi escolhido.
Mais importante do que descobrir qual logotipo aparecerá nos servidores é entender o que está realmente sendo comprado.
O governo não está simplesmente adquirindo um computador muito grande.
Está tentando construir uma infraestrutura capaz de oferecer treinamento e execução de modelos de inteligência artificial em escala que hoje praticamente não existe dentro do país.
O projeto brasileiro está perto da marca de R$ 1 bilhão
A Fundação de Apoio ao Desenvolvimento da Computação Científica publicou em 20 de agosto de 2026 a Seleção Pública nº 27/2026 para contratar uma solução integrada de High Performance Computing, ou HPC, voltada a inteligência artificial, pesquisa, desenvolvimento tecnológico e inovação.
O instrumento oficial estabelece valor de **R$ 959.040.959,04** para o objeto da contratação e prevê a sessão presencial da seleção para **8 de outubro de 2026**, em Petrópolis, no Rio de Janeiro.
Reportagens sobre o projeto também mencionam investimento global de aproximadamente **R$ 1,06 bilhão**, mas as duas cifras não devem ser tratadas automaticamente como equivalentes: o documento oficial especifica o valor da contratação enquanto anúncios governamentais podem considerar componentes adicionais da iniciativa.
A infraestrutura ficará em Macaíba, mas o desenvolvimento das especificações e a condução técnica são responsabilidade do Laboratório Nacional de Computação Científica, o LNCC, unidade vinculada ao Ministério da Ciência, Tecnologia e Inovação.
Os recursos vêm do Fundo Nacional de Desenvolvimento Científico e Tecnológico e o projeto integra o Plano Brasileiro de Inteligência Artificial, estratégia que tenta ampliar a capacidade computacional disponível dentro do país.
A previsão divulgada pelo governo é de uma máquina capaz de alcançar **7.200 petaflops**, voltada ao desenvolvimento e treinamento de modelos de IA e a aplicações científicas de grande escala.
Universidades, instituições científicas, órgãos públicos e empresas estão entre os usuários previstos para a infraestrutura.
É uma mudança de escala considerável.
Mas os números precisam ser interpretados com algum cuidado.
Os 7.200 petaflops não significam automaticamente um computador 266 vezes mais rápido
Uma comparação recorrente coloca os 7.200 petaflops previstos para a nova infraestrutura ao lado dos aproximadamente 27 petaflops atribuídos ao Santos Dumont, atualmente a principal máquina científica operada pelo LNCC.
A divisão resulta em algo perto de 267 vezes.
Parece simples.
Tecnicamente, pode não ser.
Supercomputadores podem ter desempenho medido em diferentes precisões numéricas e diferentes benchmarks.
Treinamento de inteligência artificial, por exemplo, utiliza intensamente operações em precisões menores, como FP16, BF16 e formatos ainda mais compactos, enquanto o tradicional ranking TOP500 utiliza o benchmark HPL em dupla precisão para medir desempenho de computação científica.
Uma máquina pode entregar vários exaflops em cargas de IA e registrar resultado bastante diferente no HPL.
Por isso, a afirmação de que o sistema brasileiro ficará entre os dez supercomputadores mais poderosos do mundo deve, por enquanto, ser entendida como uma **projeção do governo**, não como uma posição confirmada no TOP500.
A classificação só poderá ser estabelecida depois que a máquina estiver instalada, configurada e submetida a benchmarks comparáveis.
Essa distinção não diminui a importância do projeto.
Ao contrário: ajuda a entender para que ele está realmente sendo construído.
É uma máquina de IA antes de ser uma máquina para disputar ranking
A prioridade declarada é permitir treinamento, inferência e pesquisa envolvendo sistemas avançados de inteligência artificial.
Isso muda completamente a arquitetura desejável.
Grandes modelos não dependem apenas da quantidade de processadores disponíveis.
Eles precisam movimentar enormes volumes de dados entre milhares de unidades computacionais sem deixar GPUs esperando umas pelas outras.
A rede interna do cluster passa a ser tão importante quanto os próprios chips.
Memória de alta largura de banda, armazenamento paralelo, interconexões de baixa latência, refrigeração, distribuição elétrica e software de orquestração tornam-se partes inseparáveis do desempenho final.
Em sistemas dessa escala, instalar milhares de aceleradores rápidos ligados por uma infraestrutura inadequada é uma maneira bastante cara de construir um congestionamento.
É justamente por isso que empresas como Dell, Lenovo e HPE entram na equação.
Elas não vendem simplesmente um conjunto de GPUs.
Integram servidores, aceleradores, redes, sistemas de armazenamento, refrigeração e camadas de software para entregar o cluster como uma infraestrutura única.
A AMD tem experiência suficiente para disputar esse mercado
Caso uma proposta baseada em AMD avance, ela não representaria uma experiência improvisada.
A companhia já participa de algumas das maiores instalações de supercomputação do planeta.
Na edição de junho de 2026 do TOP500, o **El Capitan**, equipado com processadores AMD EPYC e aceleradores Instinct MI300A, ocupava a segunda posição mundial, com 1,809 exaflop no benchmark HPL.
O **Frontier**, também baseado em processadores EPYC e aceleradores AMD Instinct, aparecia em terceiro lugar, com 1,353 exaflop.
Isso demonstra que a AMD já possui hardware comprovado em sistemas de escala exaflop.
Não significa, entretanto, que o futuro supercomputador brasileiro necessariamente utilizará MI300, MI350, EPYC ou qualquer outra família específica.
Até agora, a AMD confirmou o interesse comercial e a participação através de integradores, mas **não há confirmação pública de qual arquitetura ou quais modelos de chips seriam apresentados na proposta brasileira**.
Esse detalhe precisa permanecer claro.
Interesse não é contrato.
Portfólio disponível não é especificação escolhida.
E uma eventual proposta não significa vitória na concorrência.
A verdadeira batalha pode acontecer entre ROCm e CUDA
O aspecto mais interessante da possível entrada da AMD talvez nem esteja no silício.
Está no software.
A Nvidia construiu durante quase duas décadas um ecossistema de computação acelerada centrado no CUDA, utilizado por universidades, laboratórios, empresas e praticamente toda a indústria moderna de inteligência artificial.
Bibliotecas, ferramentas de desenvolvimento, sistemas de treinamento distribuído e uma enorme quantidade de código foram otimizados para esse ambiente.
Esse ecossistema funciona como uma vantagem competitiva difícil de reproduzir apenas fabricando uma GPU rápida.
A resposta da AMD é o **ROCm**, sua plataforma aberta de computação para GPUs, que reúne compiladores, bibliotecas, runtimes e ferramentas voltadas a inteligência artificial e HPC.
Atualmente o ambiente oferece suporte a estruturas amplamente utilizadas como PyTorch e JAX, além de ferramentas de inferência e execução de modelos distribuídos.
Isso torna uma arquitetura baseada em AMD tecnicamente viável para cargas modernas de IA.
Mas viável não significa necessariamente transparente.
Laboratórios brasileiros que já possuem códigos, bibliotecas e pipelines construídos especificamente sobre CUDA podem precisar portar, testar e otimizar aplicações antes de alcançar desempenho semelhante em outra plataforma.
É aí que uma licitação dessa escala precisa olhar além do preço do hardware.
Comprar o chip mais barato pode produzir uma máquina mais cara
O custo real de um supercomputador aparece durante anos de operação.
Energia elétrica, refrigeração, manutenção, suporte, substituição de componentes, pessoal especializado e desenvolvimento de software podem representar parcelas enormes do investimento total.
Existe ainda o custo menos visível da compatibilidade.
Uma solução que demande grandes equipes para adaptar aplicações científicas pode ter preço inicial atraente e custo operacional elevado.
Por outro lado, depender quase integralmente de um único fornecedor cria outra forma de despesa: o chamado **vendor lock-in**, quando migrar para uma plataforma concorrente passa a ser tecnicamente difícil ou economicamente inconveniente.
A presença da AMD na disputa pode ser valiosa mesmo antes de sabermos quem vencerá.
Mais competição permite comparar arquitetura, eficiência energética, suporte, transferência de tecnologia e condições comerciais.
Em uma aquisição próxima de R$ 1 bilhão, pequenas diferenças percentuais podem representar dezenas de milhões de reais.
O Brasil quer diminuir uma dependência, mas não eliminará todas as outras
A justificativa estratégica do governo está associada à chamada soberania computacional.
A ministra da Ciência, Tecnologia e Inovação, Luciana Santos, afirmou durante o anúncio do projeto que uma parcela significativa do processamento relacionado à inteligência artificial brasileira atualmente ocorre fora do país.
A nova infraestrutura pretende permitir que parte dessas cargas seja executada em território nacional.
Há benefícios evidentes.
Dados sensíveis podem permanecer dentro de infraestrutura controlada no Brasil.
Pesquisadores deixam de depender exclusivamente de capacidade comprada em nuvens estrangeiras.
Projetos públicos podem ter acesso a poder computacional que seria financeiramente proibitivo para universidades isoladamente.
Também passa a existir uma infraestrutura estratégica disponível para treinamento de modelos em português, pesquisas científicas e aplicações específicas para necessidades brasileiras.
Mas possuir fisicamente os servidores não equivale automaticamente a independência tecnológica.
Os processadores continuarão sendo estrangeiros.
Os aceleradores também.
Boa parte das ferramentas de software e da cadeia de fabricação de semicondutores permanecerá fora do país.
A soberania possível nesse estágio está muito mais relacionada a **controle operacional, conhecimento técnico, dados, capacidade de desenvolver software e liberdade para escolher fornecedores** do que à fabricação nacional integral da máquina.
Macaíba terá de receber muito mais do que racks de servidores
Um supercomputador dessa dimensão transforma infraestrutura elétrica e térmica em parte central do projeto.
Cada acelerador de última geração pode consumir centenas de watts, e milhares deles operando simultaneamente produzem uma concentração de calor que sistemas tradicionais de ar-condicionado simplesmente não conseguem administrar.
Instalações modernas de HPC utilizam soluções como refrigeração líquida direta, circuitos independentes de água e sistemas sofisticados de recuperação térmica.
Também precisam de alimentação elétrica redundante, conectividade de alta capacidade e segurança física.
A escolha do Parque Científico e Tecnológico Augusto Severo foi associada justamente à necessidade de acomodar essa infraestrutura e descentralizar parte da capacidade computacional brasileira, historicamente concentrada em outras regiões.
O desafio não termina quando a máquina for ligada.
Na verdade, começa ali.
Uma máquina bilionária pode ficar subutilizada se faltar gente e software
Existe uma armadilha conhecida em grandes projetos tecnológicos públicos e privados: concentrar atenção no equipamento e tratar pessoas como detalhe.
Um supercomputador não produz pesquisa sozinho.
É necessário formar equipes capazes de programar sistemas distribuídos, otimizar kernels, trabalhar com redes de alta velocidade, administrar armazenamento paralelo e manter clusters com milhares de aceleradores funcionando simultaneamente.
Também será necessário definir como a capacidade será distribuída.
Universidades competirão por tempo de processamento?
Empresas privadas poderão utilizar recursos subsidiados?
Projetos estratégicos terão prioridade?
Quem decidirá quais modelos poderão consumir semanas de processamento?
Como serão protegidos dados confidenciais executados por instituições diferentes dentro da mesma infraestrutura?
Essas questões administrativas podem parecer secundárias diante de milhares de GPUs.
Não são.
Uma máquina ocupada pelos projetos errados pode desperdiçar tanto dinheiro quanto uma máquina tecnicamente ruim.
Quem ganha primeiro com o novo supercomputador
Universidades e centros de pesquisa provavelmente estão entre os beneficiários mais imediatos.
Hoje, treinar modelos grandes ou realizar simulações muito pesadas frequentemente exige acesso a nuvens comerciais ou colaboração com instituições que já possuem infraestrutura de alto desempenho.
Uma instalação nacional compartilhada pode reduzir essa barreira.
Órgãos públicos também poderiam desenvolver aplicações em saúde, agricultura, clima, defesa, ciência de materiais e processamento de grandes bases administrativas sem necessariamente enviar todos os dados para provedores estrangeiros.
Startups e empresas brasileiras podem se beneficiar caso o modelo de acesso permita utilização comercial ou projetos cooperativos.
Mas há um risco de concentração.
Se acessar o sistema exigir equipes altamente especializadas, projetos pequenos continuarão de fora mesmo que a infraestrutura exista.
Democratizar computação não significa apenas instalar computadores.
É preciso construir interfaces, capacitação, suporte e políticas de acesso capazes de transformar capacidade teórica em capacidade utilizável.
Análise da equipe
A entrada da AMD melhora o projeto brasileiro antes mesmo de qualquer decisão sobre qual arquitetura será contratada.
Uma aquisição dessa dimensão não deveria começar com fornecedor escolhido e terminar com uma licitação criada para justificá-lo.
Quanto mais arquiteturas capazes de atender aos requisitos técnicos disputarem efetivamente o contrato, maior a possibilidade de o Brasil negociar desempenho, eficiência energética, suporte, treinamento e transferência de conhecimento.
A Nvidia possui enorme vantagem no ecossistema de inteligência artificial graças ao CUDA e à presença dominante de seus aceleradores no mercado.
A AMD, por sua vez, já demonstrou que consegue operar na escala dos maiores supercomputadores do mundo e vem transformando o ROCm em uma alternativa cada vez mais relevante.
O erro seria reduzir essa decisão a uma guerra de benchmarks.
Para o Brasil, a melhor arquitetura não será necessariamente aquela que atingir o maior número estampado em uma apresentação.
Será aquela capaz de entregar computação útil durante anos, com custo previsível, software sustentável, infraestrutura eficiente e liberdade suficiente para que a próxima expansão não dependa de reconstruir todo o ecossistema.
O que devemos acompanhar agora
O primeiro ponto será a própria Seleção Pública nº 27/2026.
A sessão prevista para outubro deverá mostrar quais integradores realmente apresentarão propostas e quais arquiteturas serão oferecidas.
Depois virão detalhes que hoje ainda estão ausentes da discussão pública: quantidade e modelo dos aceleradores, processadores, memória, interconexão, armazenamento, eficiência energética, refrigeração e compromissos de transferência de tecnologia.
Também será fundamental descobrir qual métrica sustenta os anunciados 7.200 petaflops.
Saber se o número representa desempenho de IA em baixa precisão, capacidade teórica de pico ou algum benchmark específico muda completamente a comparação internacional.
Por fim, será necessário acompanhar o software.
Se a disputa efetivamente colocar Nvidia e AMD frente a frente, o Brasil terá uma oportunidade rara de avaliar não apenas duas famílias de chips, mas duas estratégias diferentes para a infraestrutura que sustenta inteligência artificial.
O supercomputador de Macaíba poderá ser um equipamento extraordinariamente rápido.
Seu verdadeiro valor, porém, será medido por outra pergunta:
**quanto conhecimento, pesquisa e capacidade tecnológica permanecerão no Brasil depois que os primeiros benchmarks deixarem de ser novidade?**
👉 Dúvida? Então veja mais em: https://pixbugtech.com/linksuteis