noticias
AMD Threadripper Halo Station leva IA de data center para uma workstation com 96 núcleos
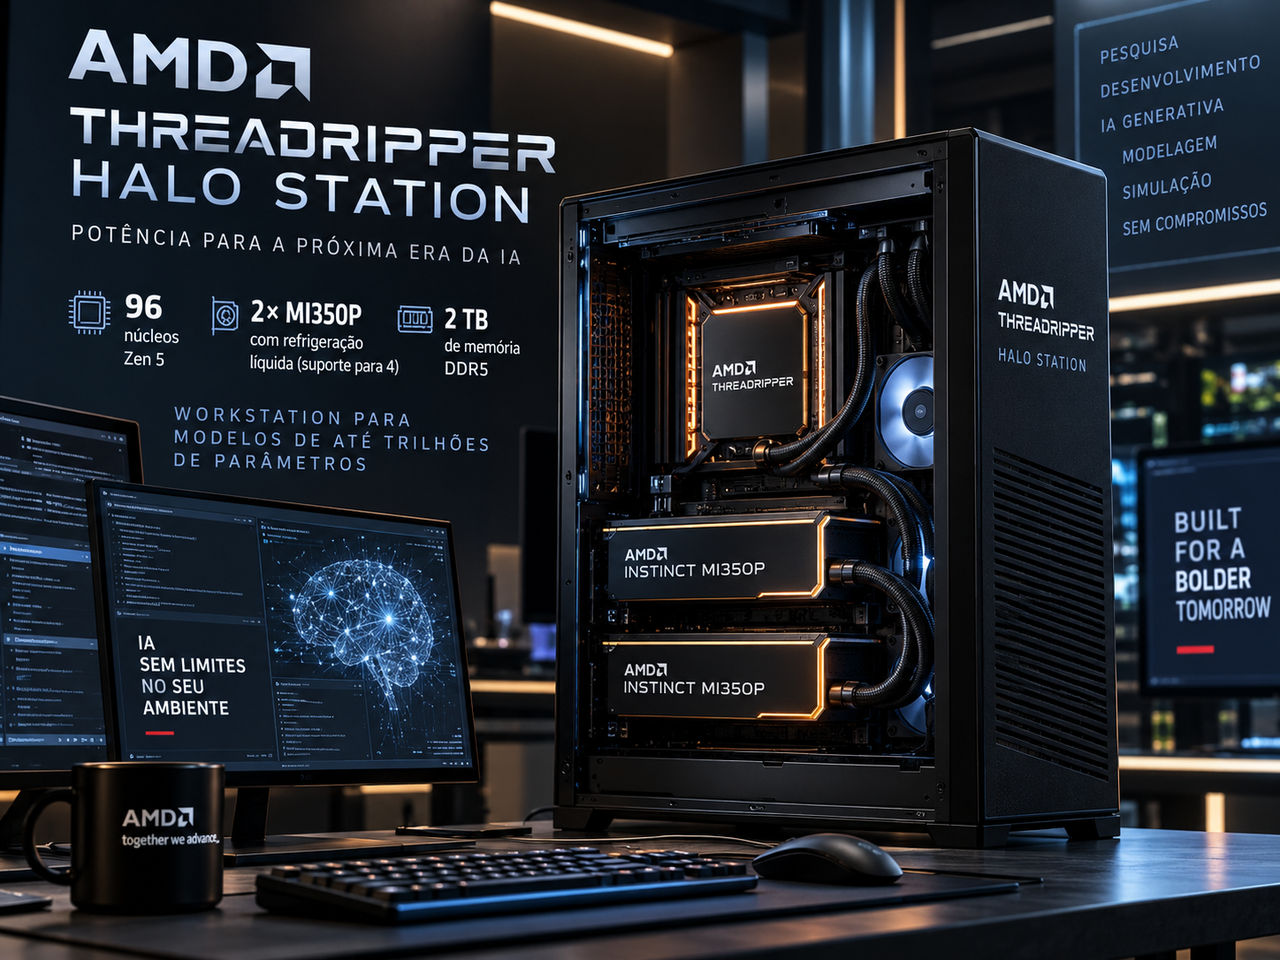
**Linha fina:** Com dois aceleradores Instinct MI350P, 288 GB de HBM3E e possibilidade de expansão, máquina apresentada na IFA 2026 tenta aproximar modelos gigantes de IA da infraestrutura privada das empresas.
A AMD apresentou na IFA 2026 uma workstation que ajuda a borrar definitivamente a fronteira entre computador profissional e servidor de inteligência artificial. Batizada de **Threadripper Halo Station**, a máquina combina o Ryzen Threadripper PRO 9995WX, de 96 núcleos Zen 5, com dois aceleradores Instinct MI350P e 2 TB de memória DDR5. A configuração inicial oferece 288 GB de HBM3E dedicada às GPUs e foi projetada com caminho de expansão para quatro aceleradores, elevando essa capacidade para 576 GB.
A fabricante afirma que o sistema poderá executar modelos de inteligência artificial com mais de 1 trilhão de parâmetros e chegou a classificá-lo como “a workstation mais poderosa do mundo”. A primeira afirmação é tecnicamente plausível em determinadas configurações de modelo e precisão numérica; a segunda continua sendo uma declaração promocional da AMD enquanto não existirem benchmarks independentes capazes de comparar a Halo Station com outras máquinas desse segmento.
O produto, porém, é relevante mesmo sem o superlativo. Ele mostra uma mudança importante no mercado: depois de anos concentrando inteligência artificial de grande porte em data centers e serviços de nuvem, fabricantes começam a disputar quem consegue colocar uma parcela dessa capacidade computacional dentro do escritório.
O Threadripper é enorme, mas não é ele que faz a maior parte da IA
O processador utilizado na Halo Station é o Ryzen Threadripper PRO 9995WX, atual topo da linha profissional da AMD. Ele possui 96 núcleos e 192 threads, arquitetura Zen 5, clock máximo de até 5,4 GHz, 384 MB de cache L3 e TDP de 350 watts.
É uma CPU extremamente poderosa para compilação, simulação, renderização, processamento científico e tarefas profissionais fortemente paralelas. Em uma máquina dedicada a grandes modelos de linguagem, entretanto, seu papel é principalmente alimentar, coordenar e preparar trabalho para os aceleradores.
A parte mais importante para IA está nos dois **AMD Instinct MI350P**.
Cada placa possui 144 GB de memória HBM3E, totalizando 288 GB na configuração apresentada. Essa memória oferece largura de banda de até 4 TB por segundo por acelerador, uma diferença importante em relação à memória DDR5 convencional porque modelos de linguagem precisam movimentar enormes quantidades de dados entre memória e unidades computacionais durante a geração de tokens.
A Halo Station também prevê uma configuração futura com quatro MI350P. Nesse cenário, seriam 576 GB de HBM3E disponíveis entre os aceleradores.
Não é apenas “muita memória”. É memória de altíssima largura de banda colocada exatamente onde os cálculos de IA acontecem.
A história do modelo de 1 trilhão de parâmetros exige uma explicação
A capacidade de executar modelos com mais de 1 trilhão de parâmetros é provavelmente o número que mais chama atenção no anúncio. Também é aquele que mais facilmente pode produzir uma interpretação errada.
Um parâmetro é, de forma simplificada, um valor numérico aprendido durante o treinamento. Um modelo com 1 trilhão deles pode ocupar quantidades radicalmente diferentes de memória dependendo da precisão utilizada.
Se cada parâmetro fosse armazenado em 16 bits, seriam necessários aproximadamente **2 terabytes apenas para os pesos do modelo**. Em oito bits, cerca de 1 terabyte. Com quantização para quatro bits, a conta teórica cai para aproximadamente 500 GB.
E ainda existem outros consumidores de memória.
O sistema precisa lidar com cache de atenção, contexto, buffers temporários, estruturas do software de inferência e diversos outros dados necessários para que o modelo efetivamente funcione.
Isso significa que os 576 GB de HBM3E de uma Halo Station equipada com quatro aceleradores podem colocar determinados modelos de 1 trilhão de parâmetros quantizados dentro de uma faixa executável, mas não permitem concluir que qualquer modelo dessa escala poderá simplesmente ser carregado e executado integralmente na memória das GPUs.
A máquina possui outro recurso importante: os 2 TB de DDR5 ligados ao Threadripper.
Partes do modelo podem permanecer nessa memória e serem transferidas quando necessárias. É uma técnica útil para executar modelos maiores do que a VRAM disponível, mas existe uma consequência inevitável: **caber na máquina não é a mesma coisa que rodar rapidamente nela**.
HBM3E e DDR5 ficam no mesmo computador, mas pertencem a mundos diferentes
Essa diferença de memória talvez seja o ponto técnico mais importante da Halo Station.
Os Instinct MI350P acessam sua HBM3E com largura de banda que chega a vários terabytes por segundo. A memória DDR5 do sistema, embora enorme e rápida pelos padrões de uma workstation, está ligada à CPU e precisa atravessar outras interconexões para alimentar os aceleradores.
Quando um modelo cabe inteiramente na memória rápida das GPUs, os aceleradores podem trabalhar sem depender constantemente da RAM principal.
Quando ele não cabe, partes precisam ser movimentadas.
Esse tráfego pode transformar a interconexão entre CPU, memória e aceleradores em gargalo. Quanto maior a quantidade de dados transferida durante cada etapa da inferência, mais significativa tende a ser a penalidade.
É por isso que a informação “executa modelos de 1 trilhão de parâmetros” sozinha diz menos do que parece.
Para avaliar a máquina de verdade será necessário saber quantos tokens por segundo ela entrega, quanto tempo demora para produzir o primeiro token, quais quantizações foram utilizadas, quanto do modelo está em HBM e quanto permanece na DDR5.
Sem esses números, sabemos que a Halo Station possui capacidade para lidar com modelos enormes. Ainda não sabemos com que eficiência fará isso.
Não estamos falando de treinar um novo GPT dentro do escritório
Há outra distinção importante.
Executar um modelo e treiná-lo do zero são tarefas completamente diferentes.
Na inferência, os pesos já existem e o sistema utiliza o modelo para responder perguntas, processar documentos, gerar código, analisar imagens ou executar outras tarefas.
No treinamento, bilhões ou trilhões de parâmetros precisam ser ajustados repetidamente sobre enormes conjuntos de dados. Além da memória necessária para os próprios pesos, entram gradientes, estados do otimizador e uma quantidade colossal de operações matemáticas.
Grandes modelos de fronteira são treinados em clusters formados por centenas ou milhares de aceleradores conectados por redes de altíssima velocidade.
A Threadripper Halo Station não elimina essa infraestrutura.
Sua função é outra: permitir que empresas, pesquisadores e desenvolvedores executem, testem, adaptem e possivelmente façam ajustes em modelos muito grandes sem depender permanentemente de um cluster remoto.
É uma diferença menos espetacular para uma apresentação de produto, mas muito mais importante na prática.
O consumo de energia entrega a verdadeira dimensão dessa workstation
A arquitetura também produz uma questão que raramente aparece nas fotografias promocionais: energia.
Cada Instinct MI350P possui potência total de placa configurável entre 450 e 600 watts. O Threadripper PRO 9995WX possui TDP de 350 watts.
Uma Halo Station com dois aceleradores pode, portanto, reunir componentes cujo envelope máximo combinado chega a aproximadamente 1.550 watts antes de considerar memória, armazenamento, bombas, ventoinhas, placa-mãe e perdas da fonte de alimentação.
Com quatro MI350P, apenas CPU e aceleradores poderiam chegar teoricamente a cerca de 2.750 watts.
Esses valores não representam consumo constante na tomada. Uma máquina raramente mantém todos os seus componentes simultaneamente no limite máximo durante todo o tempo.
Ainda assim, mostram por que a Halo Station está muito distante de uma workstation convencional.
A refrigeração líquida adotada no sistema deixa de ser uma escolha estética e passa a fazer parte da solução térmica necessária para colocar essa densidade de computação dentro de um gabinete.
Também surge uma pergunta bastante mundana para um produto de inteligência artificial: onde exatamente essa máquina será ligada?
Dependendo da configuração elétrica, uma instalação de quatro aceleradores pode exigir cuidados que não existem para um desktop profissional tradicional. Energia, climatização, ruído e dissipação térmica passam a fazer parte do planejamento.
É o data center chegando à mesa, inclusive nos inconvenientes.
A AMD quer atacar uma conta que começa a incomodar empresas
A existência de um equipamento como esse também mostra uma mudança na economia da IA generativa.
No início da adoção, utilizar APIs ou alugar GPUs em nuvem fazia bastante sentido. Empresas podiam testar modelos sem comprar servidores, montar infraestrutura de refrigeração ou manter especialistas em hardware.
Quando a utilização cresce e se torna permanente, a conta começa a mudar.
Uma organização que executa milhões de inferências diariamente pode comparar o custo recorrente das GPUs alugadas com a compra de equipamento próprio. A infraestrutura local exige capital inicial, manutenção, energia e pessoal, mas elimina parte da cobrança proporcional ao uso dos provedores externos.
Há ainda aplicações em que a questão principal não é financeira.
Empresas podem possuir documentos estratégicos, projetos industriais, código-fonte, propriedade intelectual ou bases de dados que preferem não enviar continuamente a um serviço remoto.
Executar IA localmente permite estabelecer uma arquitetura na qual esses dados podem permanecer dentro da infraestrutura da organização.
Isso não torna a Halo Station automaticamente segura. Uma máquina local continua vulnerável a erros de configuração, invasões, permissões inadequadas e software malicioso.
A diferença está no controle.
O proprietário decide onde o modelo roda, onde os dados permanecem e quais sistemas externos participam do processamento.
A comparação inevitável é com a NVIDIA DGX Station
A proposta coloca a AMD diante de uma concorrente bastante óbvia.
A NVIDIA criou a atual DGX Station para um objetivo semelhante: levar grandes cargas de trabalho de inteligência artificial a uma máquina instalada ao lado do usuário.
A arquitetura, porém, é bastante diferente.
A DGX Station utiliza o superchip GB300 Grace Blackwell Ultra, no qual uma CPU Grace de 72 núcleos e uma GPU Blackwell Ultra trabalham conectadas por NVLink-C2C. O sistema pode oferecer até 748 GB de memória coerente, permitindo que CPU e GPU enxerguem um grande espaço de memória com uma integração muito mais estreita do que aquela disponível em uma arquitetura tradicional baseada em PCI Express.
A NVIDIA também anuncia suporte a modelos de até 1 trilhão de parâmetros.
A AMD segue por outro caminho.
A Halo Station utiliza uma CPU x86 Threadripper convencionalmente separada dos aceleradores MI350P. Cada GPU possui sua própria HBM3E e comunica-se pelo ecossistema PCI Express da plataforma.
Isso traz vantagens e limitações.
A arquitetura da AMD pode oferecer flexibilidade de expansão, compatibilidade x86 e uma quantidade enorme de RAM convencional. A abordagem da NVIDIA aposta em uma memória coerente e em uma interconexão de altíssima velocidade entre CPU e GPU.
Qual solução será melhor dependerá da carga de trabalho.
E é justamente por isso que comparações baseadas apenas na soma de memória ou no número de parâmetros suportados são insuficientes.
A AMD também precisa vencer uma disputa que não acontece no silício
Existe um segundo concorrente dentro da Halo Station: o ecossistema CUDA.
A NVIDIA passou anos transformando CUDA em muito mais do que uma interface para suas GPUs. Bibliotecas, frameworks, aplicações empresariais, kernels customizados, ferramentas científicas e sistemas de inferência foram construídos em torno desse ambiente.
A AMD responde com o ROCm, sua plataforma aberta para computação acelerada.
O ecossistema amadureceu consideravelmente e atualmente suporta ferramentas importantes utilizadas em IA, incluindo PyTorch, JAX e SGLang. Isso reduz a distância que durante anos dificultou a adoção das GPUs Instinct fora de grandes instalações especializadas.
Mesmo assim, compatibilidade não significa ausência de trabalho.
Uma empresa com software profundamente dependente de CUDA pode precisar validar bibliotecas, substituir extensões, adaptar kernels ou revisar pipelines antes de migrar.
Esse custo de engenharia pode ser tão importante quanto o preço do hardware.
A disputa entre AMD e NVIDIA, portanto, não será decidida apenas por quem coloca mais memória dentro de uma torre. Será decidida também por quanto trabalho existe entre retirar a máquina da caixa e executar nela a aplicação que realmente importa.
O preço pode ser tão extraordinário quanto as especificações
A AMD ainda não apresentou preço oficial da Threadripper Halo Station nem detalhou quando o sistema chegará comercialmente ao mercado.
O Tom’s Hardware calculou que apenas CPU, memória e os dois aceleradores da configuração apresentada podem superar US$ 100 mil a preços de mercado. Uma estação completa, com armazenamento, refrigeração, fonte, placa-mãe e componentes empresariais, pode avançar significativamente além desse valor.
É importante tratar esses números como estimativa, não como tabela oficial da AMD.
Mesmo assim, eles ajudam a definir o público.
A Halo Station não foi projetada para alguém que deseja executar um modelo local para conversar com documentos ou gerar imagens em casa. Existem computadores de algumas centenas ou milhares de dólares capazes de realizar essas tarefas com modelos menores.
Estamos falando de laboratórios, universidades, equipes de engenharia, empresas de inteligência artificial, setores de pesquisa e organizações que conseguem justificar economicamente centenas de gigabytes de memória de acelerador.
Chamar isso de “computador pessoal” porque o gabinete cabe embaixo de uma mesa seria tecnicamente possível.
Também seria um pouco generoso com o conceito de pessoal.
A computação local aumenta autonomia, mas não necessariamente democratiza a IA
Uma máquina dessa categoria oferece algo cada vez mais valioso: independência operacional.
Uma organização pode manter seus próprios modelos, decidir quando atualizá-los, trabalhar sem limites de API e não depender da disponibilidade comercial de um provedor para executar determinadas cargas.
Essa autonomia, porém, custa caro.
A nuvem permite que uma pequena empresa utilize durante algumas horas um acelerador que jamais conseguiria comprar. A infraestrutura local inverte a lógica: o custo por operação pode cair depois de grande utilização, mas alguém precisa pagar o equipamento antes do primeiro token ser produzido.
Isso cria uma contradição interessante.
A IA local reduz dependência de grandes provedores de nuvem, mas sistemas capazes de executar os maiores modelos continuam acessíveis principalmente a organizações com muito capital.
Descentralizar a computação não significa automaticamente distribuir o poder computacional.
Análise da equipe
A Threadripper Halo Station talvez seja menos importante como produto isolado do que como sinal do caminho que a indústria está tomando.
Durante décadas, “workstation” significou um computador profissional especialmente poderoso. A Halo Station leva o conceito a outro território: centenas de gigabytes de HBM, aceleradores derivados do mercado de data centers, consumo de energia que pode ultrapassar alguns quilowatts e capacidade para carregar modelos gigantescos.
É quase um pequeno servidor de IA que ganhou permissão para morar no escritório.
Para a AMD, a estratégia também é bastante clara. A empresa não precisa convencer todo o mercado a abandonar a NVIDIA. Precisa provar que existe uma alternativa economicamente e tecnicamente viável para empresas que querem mais memória local, arquitetura x86, aceleradores Instinct e menor dependência de um único ecossistema de software.
O hardware já chama atenção suficiente.
As perguntas difíceis começam agora.
Qual será o desempenho real de inferência? Como modelos que excedem a HBM se comportarão ao utilizar DDR5? Quanto ruído e calor a máquina produzirá em carga prolongada? Qual será o consumo medido na tomada? Quanto custará uma configuração comercial completa? E, talvez mais importante, quanto esforço será necessário para transferir aplicações complexas desenvolvidas para CUDA ao ambiente ROCm?
Sem essas respostas, declarar a Halo Station a workstation mais poderosa do planeta é mais publicidade do que ciência.
Mas a máquina evidencia uma transformação que não depende dessa disputa de slogan.
Durante a primeira corrida da inteligência artificial generativa, empresas competiram para construir data centers cada vez maiores.
A próxima fase começa a levar parte desse poder na direção oposta.
Não para o notebook e nem para o computador doméstico, mas para uma nova classe de máquinas capazes de colocar, a poucos metros do usuário, uma quantidade de computação que até recentemente pertencia quase exclusivamente ao data center.
👉 Dúvida? Então veja mais em: https://pixbugtech.com/linksuteis