noticias
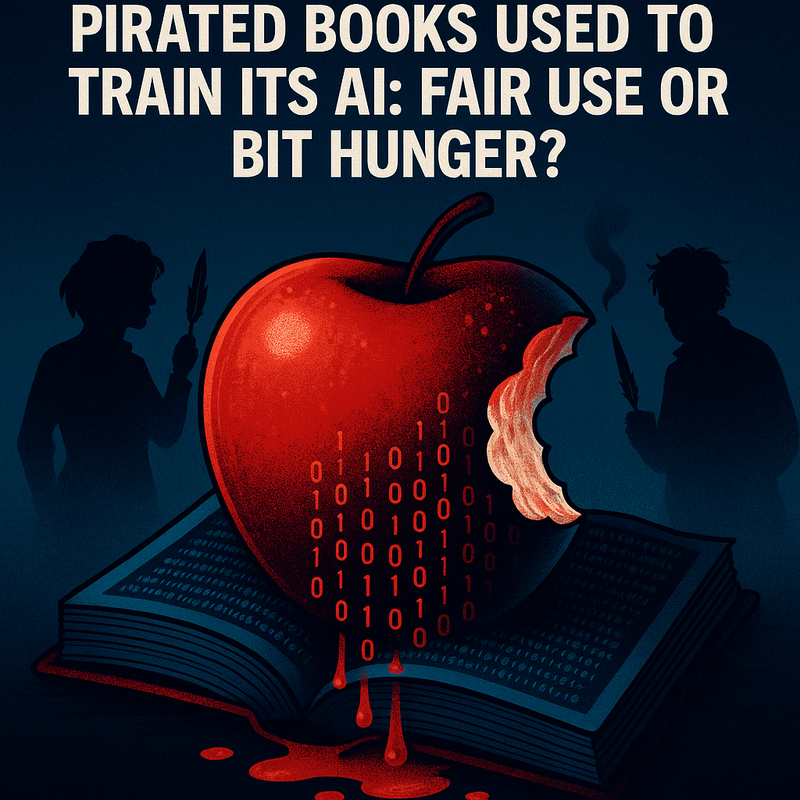
Apple no Banco dos Réus: Quando a Maçã Morde a Literatura — e os Autores Mordem de Volta
📡 Notícias e Tendências
E se o seu assistente virtual estivesse recitando versos do seu autor favorito... roubados de um PDF pirata?
Sim, é esse o enredo tragicômico que levou a Apple, a gigante do design e da privacidade, para o banco dos réus.
Dois autores norte-americanos descobriram que parte de suas obras teria sido engolida por um crawler faminto de dados — o Applebot — e usada para treinar a Apple Intelligence, o novo brinquedo bilionário de Cupertino.
Agora, a discussão deixou de ser sobre “fair use” e virou “fair theft”: até onde vai o direito de uma empresa ensinar uma IA sem pedir licença aos criadores?
Aqui no PixBugTech, mergulhamos nessa batalha que mistura ganância, tecnologia e um leve cheiro de hipocrisia digital.
O Processo: Quando a Literatura Vira Dataset
O caso foi aberto no Tribunal Federal do Norte da Califórnia em 5 de setembro de 2025, com dois nomes de peso no comando:
Grady Hendrix, autor de terror psicológico que transforma o cotidiano em pesadelo;
Jennifer Roberson, veterana da fantasia épica com mais de cem títulos publicados.
Ambos acusam a Apple de ter usado obras protegidas por copyright — sem permissão — no treinamento dos modelos OpenELM, base da sua nova suíte de IA.
O alvo direto é o Applebot, o scraper que há quase uma década varre a web indexando sites, livros e textos para alimentar o ecossistema da empresa.
Segundo a ação, o robô teria mergulhado em shadow libraries — bibliotecas piratas online como Bibliotik e Library Genesis — e absorvido uma base conhecida como Books3, que contém quase 200 mil obras literárias em formato textual.
Entre clássicos e indies, o material teria sido usado para “ensinar” os modelos da Apple a escrever, resumir e criar conteúdo com o mesmo estilo dos autores originais.
O processo é direto:
“A Apple copiou e utilizou obras protegidas por copyright para treinar seus modelos de IA, que hoje geram textos concorrentes a essas mesmas obras, sem autorização ou compensação.”
Tradução do juridiquês: a Maçã virou canibal — comeu os livros e agora vende versões processadas deles, disfarçadas de “inteligência artificial”.
O Banquete dos Dados: Quando a IA Se Alimenta de Pirataria
A Apple apresentou ao mundo o OpenELM como uma alternativa “ética” e “open-source” aos modelos fechados da OpenAI e da Anthropic.
Mas a ironia é cruel: segundo a denúncia, o treinamento teria começado com um cardápio de livros roubados.
Para entender o estrago, basta lembrar como um LLM aprende: ele devora milhões de palavras, identifica padrões e replica estilos linguísticos.
O problema é de onde essas palavras vêm.
Se parte da base vem de cópias ilegais de obras literárias, o modelo aprende com o que é, na prática, material fruto de violação de direitos autorais.
A acusação ainda reforça um ponto delicado: enquanto autores independentes penam para vender exemplares digitais, a Apple usaria seus textos para enriquecer uma IA que já é o diferencial de produtos como o iPhone 16, o MacBook M4 Ultra e o Vision Pro 2.
Um detalhe incômodo: após o anúncio da Apple Intelligence na WWDC 2025, as ações da empresa subiram US$ 200 bilhões.
Ou seja — lucro recorde, mas sem pagar um centavo aos criadores que alimentaram o sistema.
Fair Use ou Fair Steal? A Zona Cinzenta do Século XXI
A Apple se defende com o velho mantra do Vale do Silício: “uso justo”.
Segundo os advogados da empresa, treinar uma IA em conteúdo público é o equivalente a “ler para aprender”.
Mas os autores retrucam: ler é uma coisa; copiar, indexar e reproduzir é outra.
A linha que separa aprendizado de apropriação nunca foi tão turva.
Se a IA consegue imitar o estilo de um autor real — e ainda competir com ele em marketplaces —, o prejuízo é mais do que teórico.
É a transformação de arte em algoritmo, sem contrato, sem crédito e sem consciência.
E o argumento moral pesa: a Apple sempre vendeu a imagem de empresa ética, “protetora da privacidade”, com slogans como “What happens on your iPhone, stays on your iPhone”.
Agora, críticos ironizam: “A não ser que o que acontece seja um download de 200 mil livros piratas.”
O Clube dos Réus: Big Tech e o Déjà-vu dos Processos
A Apple pode até estar no centro do palco, mas não está sozinha.
A OpenAI já enfrenta uma ação da Authors Guild e do New York Times;
a Meta responde por usar textos piratas no LLaMA;
e a Anthropic, em agosto de 2025, desembolsou US$ 1,5 bilhão para encerrar uma disputa semelhante.
O que difere o caso da Apple é o tom de hipocrisia: enquanto outras empresas já admitem práticas questionáveis, a Maçã manteve seu habitual silêncio de aço inoxidável — sem negar, sem confirmar, apenas “monitorando a situação”.
Mas a pressão global cresce: a União Europeia, com o AI Act, exige transparência total sobre datasets usados em IAs classificadas como “de alto risco”.
Se a Apple for obrigada a abrir os logs de treinamento, pode expor não só os livros pirateados, mas todo o ecossistema de scraping que sustenta o OpenELM.
O Que Está em Jogo: A Alma da Criatividade Digital
O impacto desse processo vai muito além da literatura.
Se os autores vencerem, cria-se um precedente mundial: empresas terão de pagar pelo conteúdo que usam para treinar modelos, transformando copyright em commodity de IA.
Mas, se perderem, o recado é outro — que tudo na internet é fair game, e que a propriedade intelectual morreu no altar da eficiência algorítmica.
Para artistas e escritores, é o momento de redefinir o pacto com a tecnologia.
A IA pode ser parceira criativa, mas só se for alimentada com respeito.
Do contrário, viramos todos apenas dados em uma sopa neural que se alimenta de nós — literalmente.
Análise da Equipe PixBugTech: Entre o Gênio e o Plágio
Nos nossos laboratórios (onde o café é amargo e os debates, intensos), damos nota 7.5/10 para o “escândalo ético” da Apple.
Contemporaneidade: 9/10 – pauta central da era generativa;
Ética de design: 6/10 – transparência zero;
Impacto de mercado: 8/10 – possível freio no hype de IA corporativa;
Inovação: 7/10 – eficiente, mas construída sobre areia movediça jurídica.
Insight PixBugTech: o problema não é a IA aprender — é ela fingir que aprendeu sozinha.
Empresas, preparem-se: os datasets do futuro precisarão de contratos, não só crawlers.
Conclusão Inteligente: A Mordida Que Doeu no Mercado
No fim, a Apple pode vencer no tribunal, mas já perdeu na narrativa.
A empresa que construiu sua reputação em privacidade agora é acusada de violar o bem mais íntimo de qualquer criador: suas palavras.
E isso dói mais do que qualquer bug no sistema.
Seja qual for o veredito, uma coisa é certa: o caso Hendrix & Roberson vs. Apple é o marco zero de uma nova era.
Uma era onde “inteligência artificial” precisará ser tão responsável quanto genial.
Porque, no mundo digital, quem planta pirataria colhe processo — e talvez poesia.
🔍 Análise de Tendência Crítica
👉 Dúvida? Então veja mais em: https://pixbugtech.com/linksuteis
🧠 SEO Otimizado:
Palavras-chave: Apple processada IA livros piratas, direitos autorais inteligência artificial, Apple Intelligence 2025, copyright na era da IA.