noticias
Avatares de IA estão aprendendo a ouvir e ver e o próximo salto do vídeo será parecer que alguém realmente presta atenção
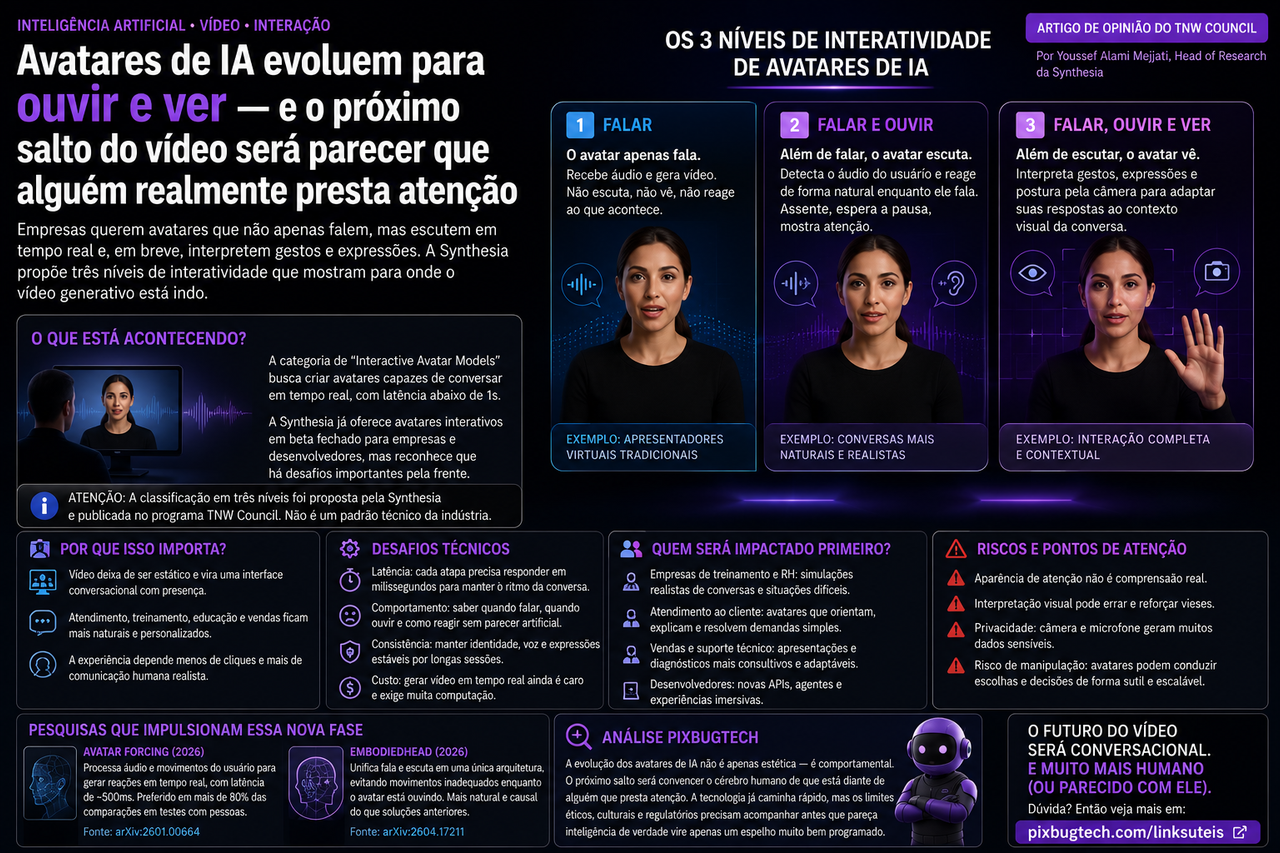
Durante os últimos anos, a indústria de vídeo generativo concentrou sua energia em uma competição visual relativamente fácil de compreender: rostos mais realistas, movimentos mais naturais, vozes mais convincentes e menos defeitos perceptíveis. Essa corrida continua, mas começa a perder o posto de principal fronteira. A próxima disputa está na interatividade. Empresas e laboratórios querem construir avatares que não apenas recitem uma resposta pronta, mas percebam quando o usuário fala, reajam durante a escuta, respeitem o tempo de uma conversa e, em uma etapa posterior, interpretem gestos, postura e expressões captadas pela câmera. O objetivo deixa de ser fabricar um vídeo bonito e passa a ser simular presença.
A tese ganhou visibilidade em um artigo publicado pela The Next Web, que propõe três níveis de interatividade para avatares de inteligência artificial: falar; falar e ouvir; falar, ouvir e ver. Mas há uma ressalva editorial importante. O texto foi escrito por Youssef Alami Mejjati, chefe de pesquisa da Synthesia, empresa que desenvolve e comercializa avatares de IA, e apareceu no TNW Council, programa cujos artigos representam as opiniões de seus autores. Portanto, a classificação não é um padrão técnico reconhecido pela indústria ou por alguma entidade reguladora. É uma estrutura proposta por uma companhia interessada diretamente nesse mercado útil para compreender a evolução tecnológica, mas também parte de uma estratégia de posicionamento.
O que está acontecendo
A Synthesia chama essa nova categoria de **Interactive Avatar Models**, modelos capazes de gerar em tempo real a representação visual de um agente que conversa com uma pessoa. A empresa considera essencial que a resposta aconteça com latência suficientemente baixa para preservar o ritmo natural do diálogo, normalmente em menos de um segundo. A ideia é aproximar os agentes de IA da experiência de uma chamada de vídeo, substituindo a interface abstrata de texto ou voz por um rosto que fala, escuta e reage.
Atualmente, a companhia oferece seus avatares interativos em beta fechado. Desenvolvedores podem conectar seus próprios modelos de linguagem, agentes e regras de conversação, enquanto a Synthesia fornece a camada visual: voz, animação, expressão e comportamento durante a escuta. A empresa reconhece que ainda trabalha em problemas como latência, tratamento de interrupções, repetibilidade, expressividade e qualidade das reações. Não se trata, portanto, de uma tecnologia totalmente amadurecida, mas de um produto experimental já orientado a usos corporativos.
A mudança parece sutil, porém é estrutural. Um avatar tradicional recebe um áudio e produz uma boca sincronizada, expressões e gestos. Um avatar interativo precisa lidar com sinais que chegam continuamente, decidir se deve falar ou permanecer em silêncio, perceber quando o usuário ainda não terminou uma frase e reagir visualmente sem parecer um boneco executando movimentos aleatórios. O problema deixa de ser apenas geração audiovisual e passa a envolver comportamento social em tempo real.
Os três níveis propostos
No primeiro nível, o avatar apenas fala. Ele recebe o áudio da própria resposta e gera movimentos de boca, rosto e corpo compatíveis. Não sabe quem está diante dele, não observa o interlocutor e não reage ao que acontece enquanto fala. Grande parte dos apresentadores virtuais disponíveis comercialmente ainda funciona dessa maneira: são vídeos gerados sob demanda, mesmo quando aparentam espontaneidade.
No segundo nível, o avatar também escuta. Além de processar sua própria voz, recebe o áudio do usuário e produz pequenos sinais de atenção enquanto a outra pessoa fala. Pode assentir com a cabeça, ajustar a expressão, emitir uma breve confirmação, demonstrar dúvida ou esperar uma pausa antes de responder. Parece pouco, mas esse é o ponto em que uma animação começa a se comportar como participante da conversa.
No terceiro nível, o sistema acrescenta visão. Com autorização para acessar a câmera, poderia interpretar postura, direção do olhar, movimentos, gestos e expressões faciais. Um avatar poderia perceber que o usuário desviou a atenção, levantou a mão, sorriu, demonstrou hesitação ou simplesmente saiu da frente da câmera. Em vez de responder apenas ao conteúdo das palavras, passaria a adaptar seu comportamento ao contexto visual do encontro.
A própria Synthesia considera que o salto decisivo ocorre entre o primeiro e o segundo nível. Um rosto que continua se movimentando de maneira indiferente enquanto o usuário fala pode parecer menos natural do que um assistente puramente sonoro, que pelo menos permanece silencioso durante a escuta. O realismo visual aumenta a expectativa comportamental: quanto mais humano o avatar parece, mais evidente se torna qualquer reação fora de hora.
O verdadeiro desafio é parecer que está ouvindo
Conversas humanas são construídas por sinais mínimos. Uma pausa ligeiramente mais longa pode indicar dúvida. Um movimento de cabeça mostra acompanhamento. Um “hum” pode demonstrar atenção ou apenas avisar que o interlocutor ainda está presente. Pessoas também antecipam o momento em que a outra parte terminará de falar e ajustam a própria entrada para não interromper cedo demais.
Reproduzir esse comportamento exige que o sistema trate voz e movimento como partes do mesmo fenômeno. A solução mais simples seria conectar reconhecimento de fala, modelo de linguagem, sintetizador de voz e gerador de vídeo como módulos separados. O problema é que cada etapa introduz atraso, e decisões tomadas isoladamente podem produzir movimentos incoerentes. O avatar pode sorrir diante de uma notícia triste, assentir antes de compreender a frase ou iniciar uma resposta enquanto o usuário ainda está falando.
A Synthesia argumenta que áudio e movimento precisam ser modelados conjuntamente, permitindo que voz, expressão e postura sejam produzidas como elementos coordenados. Pesquisas recentes seguem direção semelhante. O projeto Avatar Forcing, apresentado em 2026, processa áudio e movimento do usuário para produzir reações em tempo real a fala, risos e gestos, com latência aproximada de 500 milissegundos. Em avaliações descritas pelos pesquisadores, os movimentos reativos foram preferidos em mais de 80% das comparações com a solução usada como referência.
Outro trabalho, chamado EmbodiedHead, procura unificar estados de fala e escuta em uma mesma arquitetura. A pesquisa parte de um problema comum: avatares que parecem razoáveis enquanto falam, mas continuam mexendo a boca, desviando o olhar ou exibindo movimentos inadequados quando deveriam estar ouvindo. O modelo utiliza condicionamento explícito para controlar a transição entre escutar e falar sem depender de informações futuras incompatíveis com uma conversa realmente causal.
Latência é mais importante do que resolução
Uma resposta pode ter imagem perfeita e ainda fracassar como conversa se chegar tarde demais. Seres humanos toleram alguns atrasos em chamadas de vídeo, mas uma pausa longa após cada frase transforma o diálogo em uma sequência de comandos. O avatar precisa reconhecer a fala, compreender o pedido, formular a resposta, sintetizar áudio e gerar imagem antes que o silêncio se torne desconfortável.
É por isso que o próximo salto não depende apenas de rostos mais detalhados. Sistemas interativos precisam produzir vídeo continuamente, sem esperar que uma sequência inteira seja concluída antes de mostrar o primeiro quadro. Pesquisas como InteractiveAvatar usam geração em fluxo e mecanismos de memória para manter aparência e comportamento consistentes durante sessões prolongadas, evitando que o rosto mude gradualmente ou perca coerência conforme a conversa avança.
O desafio também é econômico. Gerar vídeo fotorrealista em tempo real exige muito mais processamento do que exibir texto ou sintetizar apenas voz. Uma empresa pode produzir um vídeo corporativo durante alguns minutos de processamento e reutilizá-lo milhares de vezes. Já um avatar interativo precisa gerar conteúdo novo para cada usuário, durante toda a conversa. Quanto mais expressivo e visualmente sofisticado for o modelo, maior tende a ser o custo por sessão.
Essa diferença poderá determinar quais aplicações chegarão primeiro ao mercado. Avatares não precisam atingir perfeição cinematográfica para funcionar em um treinamento interno ou quiosque de atendimento. Precisam ser rápidos, previsíveis e baratos o bastante para operar durante horas. A tecnologia comercialmente vencedora talvez não seja a mais realista, mas a que entrega expressividade suficiente sem transformar cada conversa em uma pequena conta de estúdio de animação.
O que muda na prática
O primeiro mercado provável é o treinamento corporativo. Em vez de assistir a um vídeo sobre atendimento, negociação ou liderança, o funcionário poderia conversar com um personagem que interpreta um cliente difícil, um colaborador insatisfeito ou um supervisor. O sistema analisaria respostas, apresentaria objeções e adaptaria o exercício ao desempenho do participante. A própria Synthesia já apresenta treinamento, simulação de conversas, onboarding e suporte como aplicações prioritárias de seus avatares interativos.
Atendimento ao consumidor também aparece como campo evidente. Um avatar poderia explicar produtos, orientar configurações e acompanhar processos em terminais, sites ou aplicativos. A imagem humana pode reduzir a distância emocional de um chatbot convencional, especialmente para pessoas menos acostumadas a interfaces de texto. No entanto, também pode aumentar a irritação quando a resposta estiver errada. Um botão que falha parece defeito de software; um rosto que sorri enquanto não resolve o problema parece deboche industrializado.
Em vendas, o avatar poderia adaptar a apresentação conforme as dúvidas, perceber hesitação e conduzir o usuário por diferentes argumentos. Na educação, poderia ajustar o ritmo, identificar sinais de confusão e propor novas explicações. Em entretenimento, personagens deixariam de seguir apenas diálogos gravados e passariam a reagir ao jogador ou espectador em tempo real.
O vídeo, nesse cenário, deixa de ser um objeto concluído. Passa a funcionar como interface. O usuário não assiste apenas ao conteúdo; conversa com ele.
Quem será impactado primeiro
Profissionais que produzem treinamento, atendimento e comunicação corporativa serão os primeiros a sentir a mudança. Uma empresa poderá manter um único avatar disponível em diferentes idiomas, horários e regiões, atualizando seu conhecimento sem realizar novas filmagens. Isso reduz custos de produção, mas também desloca trabalho de apresentadores, atores, locutores e equipes audiovisuais para a criação, supervisão e manutenção de identidades digitais.
Centrais de atendimento podem adotar esses sistemas como uma evolução visual dos chatbots. O impacto sobre trabalhadores dependerá de como forem usados. Avatares podem absorver perguntas repetitivas e liberar equipes humanas para situações complexas, mas também podem ser empregados simplesmente para reduzir pessoal, inclusive em contextos onde julgamento e empatia real continuam necessários.
Desenvolvedores terão de pensar em outra arquitetura de produto. O rosto visível é apenas a camada final. Por trás dele ainda existe um modelo de linguagem, acesso a dados, regras, ferramentas, segurança e mecanismos para decidir quando transferir a conversa para uma pessoa. Um avatar expressivo não corrige uma base de conhecimento desatualizada nem transforma um agente mal projetado em especialista.
O que pode dar errado
O primeiro risco é confundir reação com compreensão. Um avatar pode assentir, sustentar contato visual e produzir sinais de empatia sem entender emocionalmente o usuário. Esses gestos são resultados probabilísticos calculados para parecer adequados, não evidência de consciência, cuidado ou interesse. Quanto mais competente for a simulação, maior será a tendência humana de atribuir intenções que não existem.
O segundo risco está na interpretação visual. Expressões, gestos e formas de olhar não possuem significado universal. Uma pessoa pode evitar a câmera por timidez, deficiência, hábito cultural ou simples distração. Um sistema pode interpretar esse comportamento como desinteresse, insegurança ou resistência comercial. A promessa de “ler a sala” pode rapidamente virar classificação imprecisa de emoções e personalidades.
O terceiro problema é a privacidade. Um avatar de terceiro nível depende de câmera, microfone e análise contínua do comportamento. Mesmo que parte do processamento aconteça localmente, o sistema pode produzir registros sobre voz, rosto, postura, atenção e respostas emocionais. Em ambientes de trabalho ou educação, essa coleta cria uma assimetria séria: a pessoa pode sentir que precisa manter a câmera ligada para participar de um processo avaliado pela organização.
Há ainda o risco de manipulação. Um avatar pode adaptar tom, expressão e ritmo para aumentar confiança, permanência ou conversão. Um vendedor humano está sujeito a normas profissionais, supervisão e limites físicos. Um agente digital pode realizar milhares de conversas simultâneas, testar variações comportamentais e otimizar quais expressões geram maior probabilidade de compra. A interação deixa de ser apenas personalizada e pode se tornar experimental.
O rosto não resolve o problema da inteligência
Empresas podem cair na tentação de tratar a camada visual como prova de sofisticação. Um avatar com movimentos naturais causa impacto imediato em uma demonstração, mas o valor desaparece rapidamente se o agente não souber resolver tarefas, reconhecer limites ou admitir incerteza.
Existe também o risco de aumento da frustração. Usuários já se irritam com bots que repetem respostas. Colocar um rosto simpático sobre o mesmo fluxo não melhora a lógica; apenas dá expressão humana à incapacidade do sistema. Quanto mais realista for o avatar, maior será a expectativa de competência, memória e sensibilidade.
A experiência também depende de consistência entre linguagem e comportamento. Um agente pode oferecer uma resposta cuidadosa enquanto exibe uma expressão inadequada, ou utilizar palavras empáticas com um ritmo de fala excessivamente alegre. Esses conflitos são especialmente perigosos em saúde, finanças, recursos humanos e outros contextos nos quais a forma da comunicação influencia confiança e tomada de decisão.
O que ninguém ainda está discutindo
O ponto menos discutido é que **escutar** está se tornando uma aparência produzida por software. Até agora, sistemas de IA precisavam demonstrar competência principalmente pelo conteúdo de suas respostas. Avatares interativos acrescentam uma segunda camada: podem aparentar atenção antes mesmo de responder.
Isso cria uma nova forma de poder comunicacional. Uma pessoa tende a confiar mais em quem olha, reage e acompanha seu ritmo. Se esses comportamentos puderem ser calibrados industrialmente, empresas não estarão apenas automatizando conversas; estarão automatizando sinais sociais que historicamente ajudavam seres humanos a decidir quem parecia confiável.
Também existe um risco de padronização emocional. As empresas responsáveis pelos modelos decidirão como um “bom ouvinte” deve se comportar: com que frequência deve sorrir, quando deve interromper, quanto contato visual deve manter e quais expressões representam empatia. Essas escolhas podem transformar normas culturais específicas em padrão global de comportamento aceitável.
Outro aspecto pouco discutido é o direito de recusar interação visual. Quando avatares passarem a funcionar melhor com câmera ligada, organizações poderão incentivar ou pressionar usuários a fornecer imagem. A interface mais avançada poderá exigir mais exposição pessoal. A opção de desligar a câmera precisa permanecer real, e não virar uma modalidade inferior de atendimento.
A classificação em três níveis precisa ser tratada com cautela
A analogia com os níveis de automação de veículos é elegante, mas possui limitações. Carros autônomos operam dentro de categorias desenvolvidas e discutidas por entidades técnicas. Os três níveis de avatares foram propostos pela própria Synthesia para descrever uma direção de pesquisa e organizar sua estratégia de produto. A companhia afirma que os sistemas atuais, inclusive os seus, ainda se encontram principalmente no primeiro nível, enquanto a escuta natural e a visão contextual continuam como metas de desenvolvimento.
Isso não torna a classificação inútil. Ela ajuda a separar três capacidades frequentemente misturadas em campanhas comerciais. Um avatar pode falar sem ouvir. Pode ouvir áudio sem observar vídeo. Pode receber imagem sem compreender adequadamente os sinais. Dividir essas funções evita tratar qualquer rosto animado como agente plenamente interativo.
O problema surgirá se a indústria usar os níveis como selos de maturidade sem avaliações independentes. Um produto pode dizer que “vê” porque processa a câmera, embora interprete gestos de forma instável. Pode dizer que “escuta” porque reage a volume e pausas, sem compreender a intenção. A presença de um sensor não garante qualidade comportamental.
Análise PixBugTech
A leitura da PixBugTech é que a próxima revolução do vídeo de IA não será medida apenas pela capacidade de enganar os olhos. Ela será medida pela capacidade de sustentar uma conversa sem quebrar o ritmo, reagir de forma coerente e respeitar limites claros de privacidade e decisão.
O segundo nível proposto pela Synthesia realmente parece ser a mudança mais importante. Um avatar que aprende a permanecer atento enquanto o usuário fala deixa de ser apenas um vídeo gerado e começa a funcionar como interface social. Isso pode tornar treinamentos, atendimento e educação muito mais naturais. Também pode tornar sistemas de persuasão mais convincentes.
O terceiro nível amplia ainda mais essa tensão. Perceber postura, rosto e gestos pode melhorar acessibilidade e adaptação, mas também introduz vigilância comportamental em cada conversa. O desafio não será apenas fazer o avatar enxergar. Será determinar o que ele pode inferir, armazenar e fazer com aquilo que viu.
A tecnologia está avançando mais rápido do que os hábitos necessários para reconhecê-la. Pessoas aprenderam a desconfiar de e-mails suspeitos e chamadas automáticas. Ainda não aprenderam a avaliar um rosto digital que olha nos olhos, demonstra compreensão e nunca se cansa de convencer.
Conclusão
Avatares de IA estão deixando de ser apresentadores de vídeos gravados para se tornarem agentes visuais em tempo real. A proposta de três níveis falar, falar e ouvir, falar, ouvir e ver — ajuda a explicar essa transição, embora seja uma classificação criada pela Synthesia e não um padrão consolidado da indústria. ([TNW | The heart of tech][1])
Pesquisas recentes já demonstram geração reativa com latências próximas de meio segundo, movimentos condicionados pela fala e sistemas capazes de alternar entre escuta e resposta. Ao mesmo tempo, os produtos comerciais permanecem em beta e ainda trabalham para resolver interrupções, consistência, custo e expressividade. ([arXiv][4])
O próximo salto não será um avatar com pele mais perfeita. Será um avatar que espera você terminar, reage no momento certo e parece compreender aquilo que ouviu.
A parte técnica está avançando. A parte mais difícil será lembrar que parecer atento não é a mesma coisa que se importar.
👉 Dúvida? Então veja mais em: [https://pixbugtech.com/linksuteis](https://pixbugtech.com/linksuteis)