noticias
Benchmarks de IA estão ficando bons demais para medir pouco demais
**Etiqueta: 🤖 Inteligência Artificial**
Benchmarks de IA estão ficando bons demais para medir pouco demais
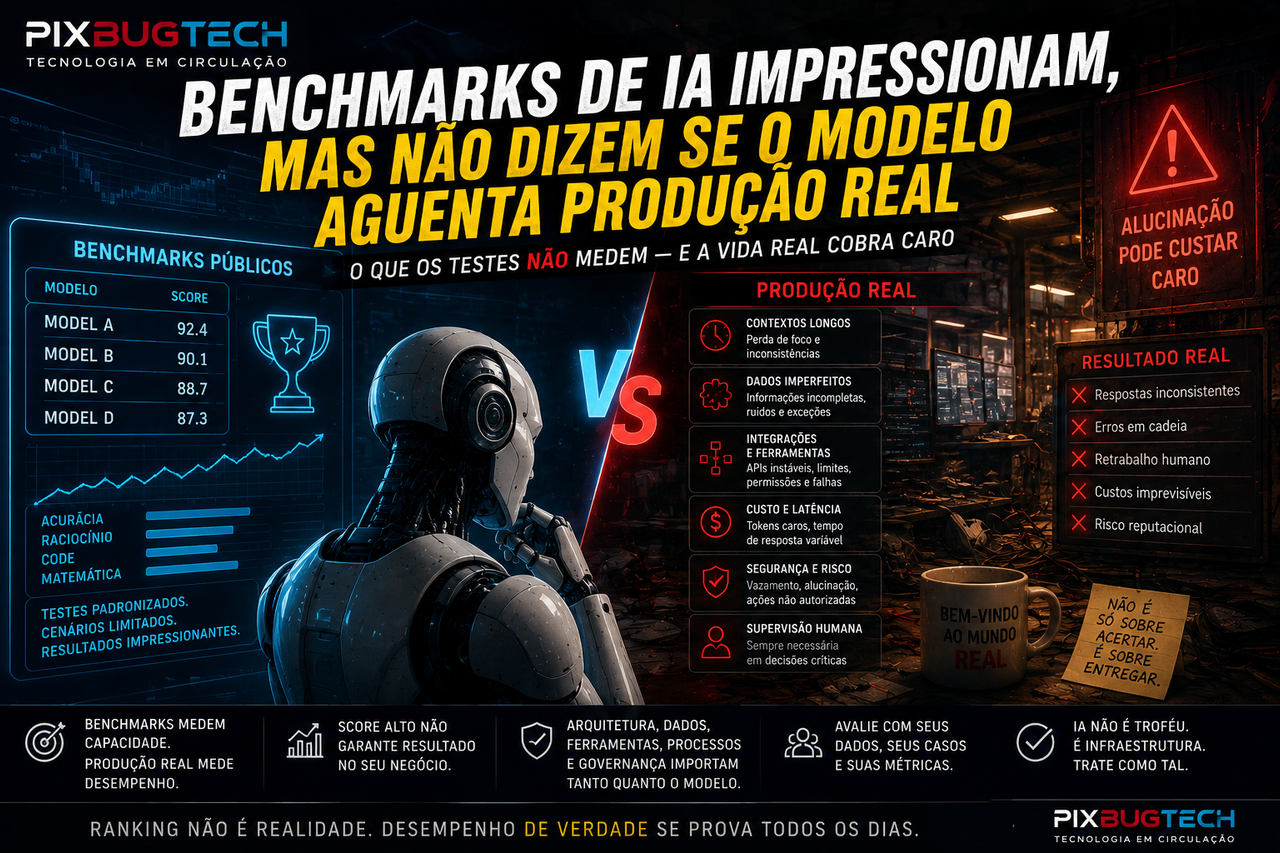
A indústria de inteligência artificial aprendeu a vender progresso por placar. Um modelo sobe alguns pontos em matemática, empata outro em programação, ultrapassa um rival em raciocínio, aparece melhor em uma tabela e imediatamente vira manchete de superioridade técnica. O problema é que benchmarks são instrumentos úteis, mas não são o mundo. Eles medem recortes, tarefas, formatos e condições específicas. A vida real, especialmente em empresas, sistemas críticos, fluxos jurídicos, atendimento, código, análise documental e automação, não se comporta como uma prova organizada. O que está ficando cada vez mais claro é que a IA pode vencer testes padronizados e ainda falhar no que realmente importa: consistência, custo, integração, rastreabilidade, latência, governança e capacidade de operar sob pressão.
O que está acontecendo é uma crise silenciosa de validade. Benchmarks continuam importantes porque oferecem uma referência mínima para comparação. Sem eles, a discussão vira marketing puro. Mas o mercado passou a tratá-los como se fossem equivalentes diretos de inteligência prática, e essa equivalência é frágil. Um modelo que responde bem a perguntas de múltipla escolha pode não ser confiável em um fluxo de trabalho longo. Um agente que resolve um desafio de código isolado pode degradar um projeto real depois de vinte alterações sucessivas. Uma IA que parece brilhante em raciocínio abstrato pode tropeçar quando precisa lidar com arquivos incompletos, permissões, ferramentas instáveis, contexto empresarial e exigência de explicabilidade.
A pesquisa sobre benchmarking em IA já mostrava sinais desse esgotamento. Estudos sobre a dinâmica global de criação e saturação de benchmarks indicam que muitos testes rapidamente caminham para quase saturação, enquanto parte deles falha em capturar uso amplo e utilidade real. Isso cria uma distorção: a indústria otimiza modelos para vencer o placar disponível, mas o placar disponível nem sempre representa os problemas que empresas e usuários enfrentam diariamente. A crítica é ainda mais profunda quando se observa que benchmarks influentes podem funcionar como substitutos simbólicos de progresso geral, mesmo quando têm problemas de validade conceitual e não cobrem a diversidade do mundo que afirmam representar.
Na prática, o que muda é que empresas precisam parar de escolher IA apenas por ranking público. Um modelo pode ser excelente em avaliações gerais e mediano no domínio específico de uma organização. Outro pode parecer menos impressionante no leaderboard, mas ser mais barato, mais rápido, mais previsível, mais fácil de integrar e mais estável em produção. Em ambiente corporativo, a pergunta correta raramente é “qual modelo venceu o benchmark?”. A pergunta correta é “qual sistema entrega o resultado necessário, com custo aceitável, risco controlado, latência previsível, logs auditáveis e manutenção possível?”. Essa diferença separa compra por entusiasmo de adoção tecnológica responsável.
Quem será impactado primeiro são as empresas que estão saindo da fase de experimentação e entrando na fase de produção. Durante o piloto, benchmarks públicos ajudam a justificar testes. Em produção, eles não bastam. O modelo precisa lidar com documentos reais, usuários reais, exceções reais, integrações reais, falhas reais e custos reais. O que parecia irrelevante em demonstração vira problema operacional: tokens caros demais, respostas inconsistentes, dificuldade de reproduzir erro, limites de contexto, baixa aderência ao tom da empresa, alucinação em detalhes pequenos, lentidão em horário de pico e incapacidade de explicar por que uma decisão foi tomada.
O caso dos agentes de IA deixa essa tensão ainda mais evidente. Um agente não é apenas um modelo respondendo perguntas. Ele lê contexto, escolhe ferramentas, chama APIs, escreve arquivos, executa comandos, consulta memória, resume etapas e decide o próximo passo. Benchmarks tradicionais tendem a medir tarefas encapsuladas, mas agentes reais operam em ciclos. O erro pode não aparecer na primeira resposta. Ele pode surgir depois de uma cadeia de pequenas decisões ruins. Um resumo ligeiramente incompleto leva a uma chamada de ferramenta inadequada. Uma validação fraca aceita um resultado plausível. Um arquivo é alterado sem preservar uma dependência. No final, o sistema “passou” por várias etapas, mas perdeu integridade.
O que pode dar errado é a criação de uma cultura de otimização para o teste. Isso não é novidade na tecnologia. Benchmarks de hardware, banco de dados e software sempre correram o risco de virar teatro quando fornecedores ajustam sistemas para vencer cenários específicos que não representam a operação real. A própria literatura geral sobre benchmarks em computação reconhece que usuários valorizam previsibilidade, pior caso, estabilidade e desempenho sob carga, enquanto muitos testes enfatizam médias, recortes isolados ou condições artificiais. Com IA, o problema fica mais delicado porque a saída é linguística, probabilística e frequentemente julgada por critérios subjetivos.
Outro ponto pouco discutido é que benchmark costuma medir capacidade, não governança. Uma empresa não adota IA apenas para obter resposta correta em uma questão. Ela precisa saber se o sistema mantém logs, respeita políticas, protege dados, permite auditoria, opera com permissões mínimas, integra-se a sistemas legados e oferece fallback quando falha. Nada disso aparece de forma suficiente em grande parte dos rankings públicos. O modelo mais capaz em uma tarefa abstrata pode ser o menos adequado para um fluxo regulado. Em direito, saúde, finanças, educação, segurança ou governo, essa diferença não é detalhe. É o centro da decisão.
Também há um problema de custo. Um benchmark raramente captura a economia completa da operação. Um modelo pode pontuar melhor, mas exigir mais tokens, mais latência, mais engenharia de prompt, mais chamadas de ferramenta, mais retries e mais revisão humana. Em escala, esse “melhor” pode ficar caro demais. Por outro lado, um modelo menor, combinado com boas instruções, bons filtros, boas ferramentas e avaliação local, pode entregar resultado superior no contexto de uma empresa específica. A comparação correta não é apenas modelo contra modelo. É sistema contra sistema, com infraestrutura, processo, custo e risco incluídos na conta.
O que ninguém ainda está discutindo com profundidade suficiente é que o futuro da avaliação de IA provavelmente será privado, contextual e contínuo. Empresas maduras não vão depender apenas de benchmarks públicos. Elas criarão seus próprios conjuntos de avaliação com dados sintéticos, casos reais anonimizados, exemplos críticos, fluxos de regressão, métricas de custo, tempo de resposta, taxa de intervenção humana e impacto operacional. O benchmark deixará de ser uma tabela externa e passará a ser parte da infraestrutura interna de governança. Assim como software sério tem testes automatizados, IA séria precisará ter avaliação contínua antes, durante e depois da implantação.
Essa mudança exige outra postura dos líderes. Em vez de perguntar “qual é o melhor modelo?”, será preciso perguntar “melhor para quê, em qual ambiente, com qual custo e sob qual risco?”. Parece menos glamouroso, mas é muito mais útil. A empresa que compra IA pelo ranking pode impressionar em reunião. A empresa que mede IA pelo desempenho real constrói vantagem operacional. A diferença aparece depois de semanas de uso, quando o entusiasmo inicial dá lugar à rotina: usuários reclamam, processos travam, exceções aparecem, custos crescem e a tecnologia precisa provar que aguenta o cotidiano.
Para desenvolvedores, a consequência é igualmente direta. O trabalho não será apenas plugar o modelo mais novo. Será construir camadas de avaliação, observabilidade e controle. Isso inclui testes de regressão para prompts, comparação entre modelos em casos próprios, análise de falhas, medição de latência, monitoramento de custo, auditoria de respostas e revisão humana em pontos críticos. A engenharia de IA entra, assim, em uma fase menos mágica e mais madura. O modelo continua importante, mas vira apenas uma parte do sistema.
A análise da equipe PixBugTech é que os benchmarks continuarão existindo, mas perderão a aura de verdade absoluta. Eles serão úteis como termômetro inicial, não como diagnóstico completo. O mercado precisa parar de confundir desempenho demonstrável com desempenho operacional. Uma IA boa em prova pode ser ruim em produção. Uma IA menos espetacular em ranking pode ser excelente dentro de um fluxo bem desenhado. O valor real não nasce apenas do modelo, mas da combinação entre modelo, contexto, ferramenta, governança, interface, custo e supervisão.
Essa leitura também conversa com o próprio caminho da PixBugTech. Um portal automatizado por IA, uma redação assistida, um módulo administrativo, um sistema jurídico ou uma arquitetura agentiva não melhora apenas porque troca de modelo. Melhora quando cria processos, avalia resultados, corrige instruções, compara saídas, controla publicação, valida imagens, mede impacto e aprende com uso real. O benchmark externo pode dizer que uma IA é poderosa. Só o uso concreto mostra se ela é confiável para o trabalho que precisa ser feito.
O futuro plausível é uma indústria com duas camadas de avaliação. A primeira será pública, rápida e barulhenta: rankings, benchmarks, comparativos e manchetes. A segunda será privada, silenciosa e decisiva: avaliações internas, testes por domínio, métricas de produção e governança contínua. Quem ficar apenas na primeira camada comprará promessa. Quem dominar a segunda construirá vantagem. E talvez esse seja o ponto mais importante: em IA, desempenho real não é o que o modelo faz quando tudo está organizado para ele vencer. Desempenho real é o que ele entrega quando o mundo volta a ser bagunçado.
👉 Dúvida? Então veja mais em: https://pixbugtech.com/linksuteis