noticias
Cerebras roda modelo de 1 trilhão de parâmetros a quase 7x a velocidade de nuvens GPU — e isso muda tudo na inferência
**📡 Notícia & Análise Técnica**
**Cerebras roda modelo de 1 trilhão de parâmetros a quase 7x a velocidade de nuvens GPU — e isso muda tudo na inferência**
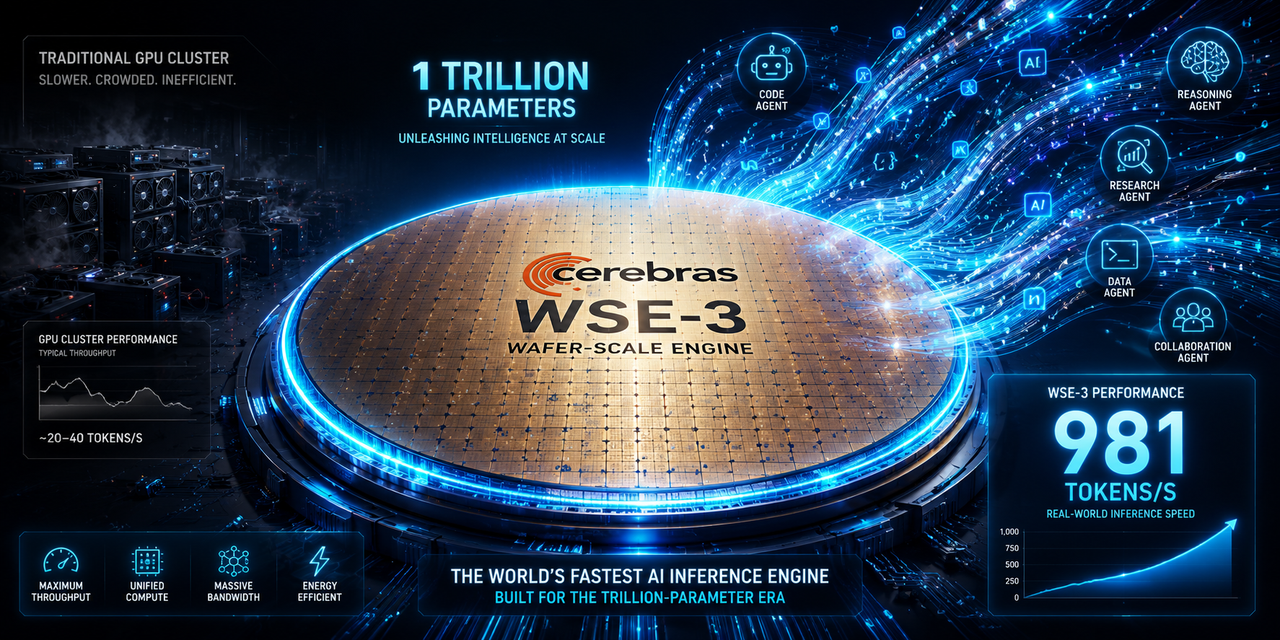
Menos de uma semana após o maior IPO de tech de 2026, a Cerebras Systems não perdeu tempo. A empresa anunciou que está servindo o Kimi K2.6 — modelo MoE de 1 trilhão de parâmetros da chinesa Moonshot AI — para clientes empresariais a **981 tokens de saída por segundo**.
É praticamente 7 vezes mais rápido que o melhor provedor GPU e 29 vezes mais rápido que o endpoint oficial do próprio Kimi em tarefas agentic reais. O Bash da inferência encontrou seu Fish: wafer-scale computing não é mais só promessa técnica. É realidade em produção.
O que aconteceu de fato
Benchmark independente da Artificial Analysis confirmou: Cerebras entregou respostas completas (10 mil tokens de entrada + 500 de saída) em **5,6 segundos**, contra 163,7 segundos no endpoint oficial do Kimi. Para tarefas de coding e agentes, a diferença não é incremental — é transformacional.
O Kimi K2.6 é um Mixture-of-Experts com 32 bilhões de parâmetros ativados por token, janela de contexto de 256 mil tokens e liderança em benchmarks como SWE-Bench Pro (58,6%) e outros de agentic workflows.
**Mergulho 1: Por que wafer-scale resolve o que GPU não consegue**
GPUs tradicionais (mesmo em clusters NVL72) sofrem com o bottleneck de interconnect. Parâmetros precisam viajar constantemente entre chips via NVLink ou similar.
O Wafer-Scale Engine 3 (WSE-3) da Cerebras é um monstro: um único chip do tamanho de uma wafer de silício, com 4 trilhões de transistores, 900 mil núcleos e 44 GB de SRAM on-chip de altíssima largura de banda.
No caso do Kimi K2.6, todos os experts de uma camada ficam no mesmo wafer. A comunicação all-to-all acontece em velocidade SRAM — mais de 200 vezes a largura de banda de NVLink. Isso elimina gargalos que destroem performance em modelos gigantes. Resultado: latência dramática e throughput absurdo.
Mergulho 2: Implicações práticas para empresas
Para times de desenvolvimento e agentes autônomos, velocidade não é luxo — é produtividade. Esperar 30 segundos por iteração de código quebra fluxo. Com Cerebras, o loop humano-IA fica quase instantâneo.
Empresas Fortune 500 (software, finanças e saúde) já estão em trials de produção. O foco é enterprise: capacidade garantida, performance previsível e alternativa real aos modelos caros e congestionados da Anthropic/OpenAI.
Preço por token é comparável ao meio-alto das GPUs — a Cerebras não compete no segmento “barato e lento”. Eles vendem pickup truck de alta performance, não carro popular.
**Mergulho 3: Contexto geopolítico e futuro**
Um modelo chinês (Moonshot AI) rodando em hardware americano para clientes ocidentais. Em 2026, isso levanta bandeiras de compliance em setores regulados. Mas também mostra que os melhores modelos abertos estão cruzando fronteiras rapidamente.
A Cerebras não para no open-weight. Promete trazer frontier closed models com a mesma velocidade em breve. Enquanto isso, a aquisição da Groq pela Nvidia por US$ 20 bi mostra que o mercado de inferência rápida virou prioridade máxima.
Análise da equipe PixBugTech
• **Performance Técnica**: 9.5/10 — Números verificados independentes são impressionantes.
• **Vantagem Arquitetural**: 9/10 — Wafer-scale resolve problemas fundamentais de escala que GPUs ainda sofrem.
• **Utilidade Prática (Agentic/Coding)**: 9.5/10 — Transforma experiência de uso real.
• **Acessibilidade e Preço**: 7.5/10 — Forte em enterprise; ainda não democratizado.
• **Riscos/Desafios**: Dependência de hardware especializado, capacidade limitada por cluster e complexidade geopolítica (7/10).
**Conclusão**
A Cerebras acaba de provar que a arquitetura wafer-scale não é apenas viável para modelos trilionários — é superior em inferência de alta velocidade. Enquanto o mercado discute quem tem o modelo mais inteligente, a empresa californiana lembra que, para muitos casos de uso reais, **quão rápido** o modelo responde importa tanto quanto quão bom ele é.
O terminal de IA está prestes a ficar muito mais responsivo. Para devs cansados de esperar, para agentes que precisam agir em tempo real e para empresas que não querem ficar na fila de capacidade da Anthropic.
O GPU cloud ainda domina volume, mas o wafer-scale está roubando o trono da velocidade. E 2026 mal começou.
**Piada leve de encerramento**: Enquanto GPU clusters ficam no trânsito de interconnect, o wafer da Cerebras é uma rodovia de 200 pistas com pista exclusiva. Trilhão de parâmetros? Segura o café que ele já respondeu.