noticias
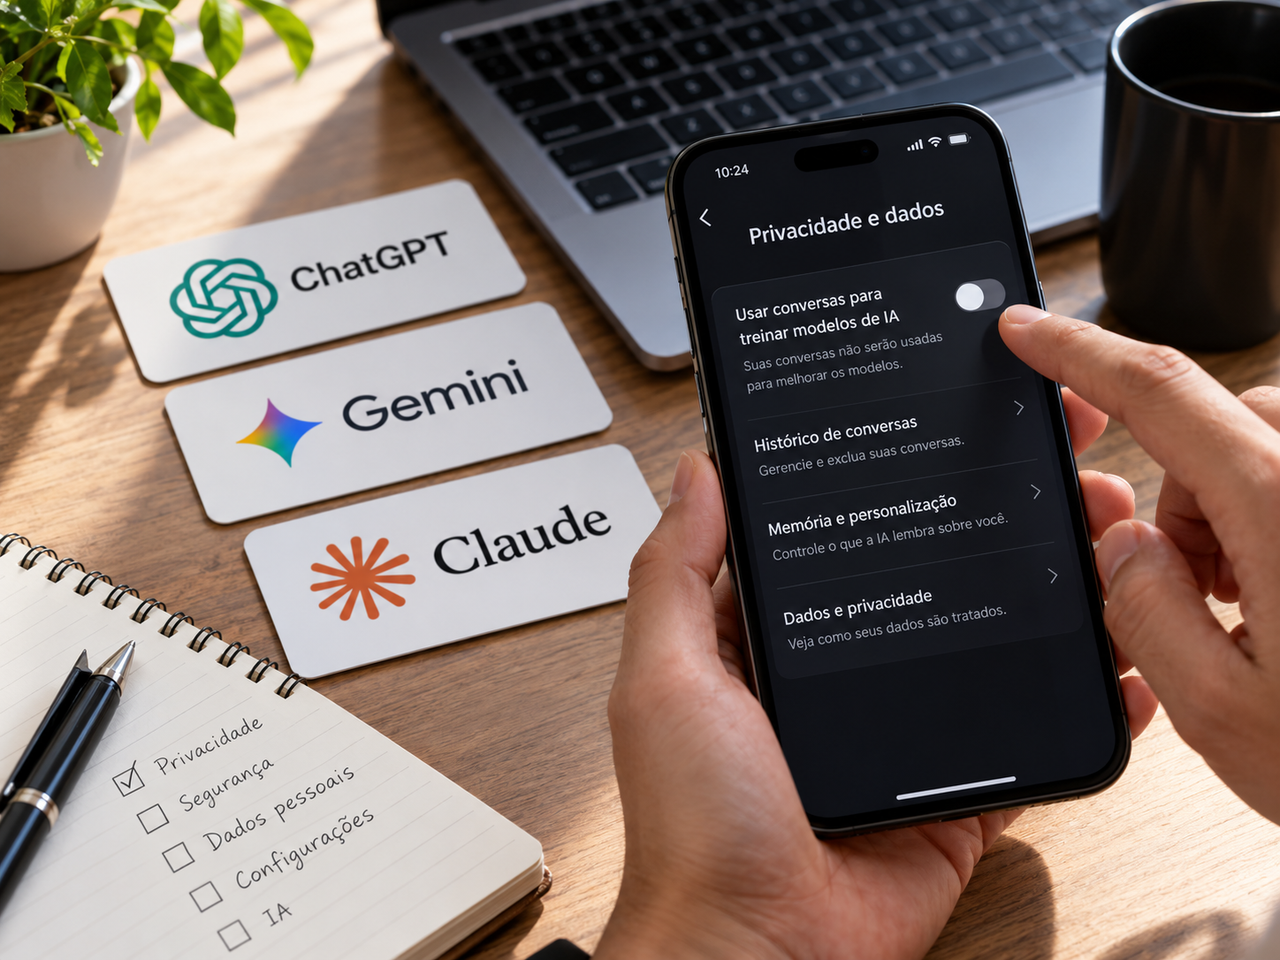
ChatGPT, Gemini e Claude podem usar suas conversas para treinar IA; veja como impedir
CATEGORIA EDITORIAL: INTELIGÊNCIA ARTIFICIAL, PRIVACIDADE E SEGURANÇA DIGITAL
ChatGPT, Gemini e Claude podem usar suas conversas para treinar IA; veja como impedir
As três plataformas oferecem controles para limitar o uso das conversas no aprimoramento de seus modelos. Entretanto, desativar o treinamento não significa excluir os dados, impedir sua retenção ou garantir sigilo absoluto.
Meta description: ChatGPT, Gemini e Claude podem usar seus chats para treinar IA. Veja como desativar o treinamento e proteger conversas e dados pessoais.
Slug: `chatgpt-gemini-claude-impedir-treinamento-conversas-privacidade`
Matéria completa
ChatGPT, Gemini e Claude podem usar suas conversas para treinar IA; saiba como impedir e proteger seus dados
As principais plataformas de inteligência artificial permitem controlar o uso de mensagens no treinamento de modelos, mas possuem regras diferentes para armazenamento, histórico, revisão humana e exclusão de informações.
Uma conversa com inteligência artificial pode revelar muito mais sobre uma pessoa do que uma pesquisa convencional na internet. Ao utilizar ChatGPT, Gemini ou Claude, é comum compartilhar dúvidas profissionais, documentos, informações financeiras, problemas pessoais, estratégias empresariais e até dados que dificilmente seriam publicados em uma rede social. O que muitos usuários desconhecem é que parte dessas informações pode ser utilizada pelas empresas responsáveis pelas plataformas para melhorar seus modelos de inteligência artificial.
O funcionamento depende do serviço, do tipo de conta e, principalmente, das configurações de privacidade escolhidas pelo usuário. Em determinadas modalidades de uso, conversas podem ser aproveitadas para treinamento ou avaliação de modelos. Em outras, existem mecanismos que impedem essa finalidade.
OpenAI, Google e Anthropic oferecem controles para restringir o uso de informações enviadas aos seus assistentes. Entretanto, as três companhias adotam procedimentos diferentes para armazenamento, exclusão e tratamento dos conteúdos.
Uma das distinções mais importantes é que desativar o treinamento não significa que a empresa deixará imediatamente de armazenar ou processar as mensagens.
Os serviços ainda podem precisar manter determinadas informações para responder às solicitações, investigar abusos, proteger sistemas ou cumprir obrigações legais.
Compreender essas diferenças é essencial para quem utiliza inteligência artificial no cotidiano, especialmente em atividades profissionais que envolvem documentos confidenciais ou dados pessoais de terceiros.
O que significa permitir que uma inteligência artificial seja treinada com suas conversas?
Modelos de inteligência artificial generativa são desenvolvidos a partir do processamento de grandes volumes de informações. Durante o treinamento, algoritmos ajustam parâmetros matemáticos para identificar padrões de linguagem, relações entre conceitos e estruturas presentes nos dados.
Esse processo permite que sistemas como ChatGPT, Gemini e Claude produzam respostas, interpretem documentos, desenvolvam códigos e executem diferentes atividades.
Entretanto, o treinamento inicial não encerra o desenvolvimento de um modelo.
As empresas continuam aprimorando seus sistemas por meio de diferentes técnicas, que podem envolver novos conjuntos de dados, avaliações humanas, testes de segurança e exemplos de interações reais.
Conversas com usuários podem fornecer informações sobre dificuldades enfrentadas pelos assistentes, respostas inadequadas e situações que não foram suficientemente contempladas durante o desenvolvimento.
Uma pergunta que o modelo interpretou incorretamente, por exemplo, pode ajudar pesquisadores a identificar limitações e desenvolver mecanismos de melhoria.
Isso não significa que cada mensagem enviada modifique imediatamente o modelo utilizado naquele momento.
O treinamento costuma ocorrer em processos separados, utilizando dados selecionados e procedimentos próprios de avaliação.
Também não significa que o sistema funcione como um arquivo convencional capaz de reproduzir automaticamente todas as conversas utilizadas no treinamento.
Ainda assim, técnicas de aprendizado de máquina podem memorizar determinados conteúdos, especialmente quando existem padrões específicos, informações repetidas ou condições que favorecem a reprodução de dados.
Por esse motivo, a possibilidade de utilizar conversas reais no treinamento exige cuidados relacionados à privacidade, à proteção de informações e à transparência sobre o tratamento dos dados.
Como impedir que o ChatGPT utilize suas conversas para treinamento
A OpenAI permite que usuários de contas pessoais desativem o uso de novas conversas no aprimoramento dos modelos.
O procedimento é realizado diretamente nas configurações do ChatGPT e não exige apagar o histórico.
Passo a passo no computador
1. Abra o ChatGPT e acesse o menu da sua conta.
2. Clique em Configurações.
3. Entre em Controles de dados.
4. Localize Melhorar o modelo para todo mundo.
5. Desative essa opção e confirme a alteração, quando solicitado.
Depois da mudança, as novas conversas não serão utilizadas para treinar os modelos da OpenAI, conforme a política divulgada pela companhia.
O histórico continuará disponível normalmente, permitindo consultar interações anteriores.
Passo a passo no celular
Nos aplicativos para Android e iPhone, o processo é semelhante.
Abra o menu lateral, toque no ícone do seu perfil, acesse as configurações de Controles de dados e desative a opção Melhorar o modelo para todo mundo.
Para usuários conectados, a configuração é aplicada à conta e vale nos diferentes dispositivos utilizados.
Isso significa que não é necessário repetir o procedimento no computador e no smartphone quando ambos utilizam a mesma conta.
O que acontece com as conversas antigas?
Desativar o treinamento não remove automaticamente o histórico existente.
As conversas continuam armazenadas de acordo com as políticas de retenção aplicáveis e permanecem disponíveis para consulta, salvo quando o usuário decide excluí-las.
Também é importante compreender que a desativação protege novas interações contra o uso em treinamento futuro, mas não equivale a desfazer processos de treinamento já realizados.
Outro detalhe merece atenção: a OpenAI informa que, quando o usuário envia avaliações sobre respostas, como feedback positivo ou negativo, a conversa associada poderá ser utilizada no aprimoramento dos modelos, mesmo que o treinamento regular esteja desativado.
Portanto, o controle principal reduz uma finalidade de utilização dos dados, mas não deve ser confundido com uma garantia absoluta de que nenhuma informação será processada para outros objetivos autorizados pelas políticas do serviço.
Chat temporário oferece uma camada adicional de privacidade
O ChatGPT também disponibiliza conversas temporárias.
Esse recurso foi desenvolvido para permitir interações que não precisam permanecer no histórico regular da conta.
Enquanto permanecem temporárias, essas conversas não aparecem no histórico, não criam nem atualizam memórias e não são utilizadas para aprimorar os modelos.
Entretanto, a OpenAI informa que elas podem ser mantidas por até 30 dias por motivos de segurança.
Isso significa que um chat temporário não representa uma comunicação completamente anônima ou uma garantia de eliminação instantânea dos dados.
Em determinadas configurações, essas conversas também podem utilizar recursos existentes de personalização, desde que estejam habilitados para a conta.
Caso o usuário salve uma conversa temporária como chat normal, ela passa a seguir as configurações regulares aplicáveis.
Memória do ChatGPT é diferente de treinamento
Outra distinção frequentemente ignorada envolve o recurso de memória.
O treinamento de modelos busca aprimorar sistemas utilizados por diferentes pessoas. A memória, por sua vez, permite que o ChatGPT utilize informações relevantes de interações anteriores para personalizar respostas destinadas a determinado usuário.
Essas finalidades não são equivalentes.
Uma pessoa pode desativar o uso de seus chats no treinamento e continuar utilizando recursos de memória e personalização.
Da mesma forma, desativar a memória não representa, por si só, uma instrução para impedir que conversas sejam utilizadas no treinamento.
O usuário deve verificar separadamente os controles relacionados à personalização e ao aprimoramento dos modelos.
Nas versões atuais do ChatGPT, as informações de memória podem ser administradas nas configurações de Personalização, incluindo a revisão do resumo de memória e das fontes relevantes.
Essa separação é importante porque a proteção das informações depende de compreender para qual finalidade cada recurso utiliza os dados.
Como impedir que o Gemini utilize suas conversas para treinar IA
No Gemini, do Google, o principal controle está relacionado à opção Manter atividade.
Quando habilitada, essa configuração permite que determinadas interações sejam armazenadas na atividade da conta e utilizadas para desenvolver ou melhorar serviços do Google, incluindo modelos de inteligência artificial generativa.
O conteúdo pode envolver mensagens escritas, arquivos enviados, imagens e outras informações compartilhadas durante a utilização do assistente.
O Google também informa que determinadas interações podem passar por revisão humana, seguindo mecanismos próprios de tratamento dos dados.
Passo a passo no Gemini
1. Acesse o Gemini pelo aplicativo ou navegador.
2. Abra o menu de configurações da conta.
3. Entre na seção Atividade.
4. Localize a opção Manter atividade.
5. Selecione Desativar ou Desativar e excluir atividade, conforme sua preferência.
A primeira opção interrompe o armazenamento de novas interações no histórico de atividade utilizado para essa finalidade.
A segunda também permite solicitar a exclusão da atividade anteriormente armazenada, respeitadas as condições e exceções descritas pelo Google.
O caminho exato pode variar conforme o dispositivo e a versão do aplicativo.
O Gemini ainda pode manter conversas por 72 horas
Mesmo quando a opção Manter atividade está desativada, o Google informa que novas conversas podem permanecer armazenadas na conta por até 72 horas.
Essa retenção é utilizada para permitir o funcionamento do serviço, manter determinado contexto conversacional e realizar verificações relacionadas à segurança.
O Google afirma que, com a opção desativada e sem envio de feedback, as novas conversas não são utilizadas para melhorar seus modelos de inteligência artificial.
Entretanto, isso não significa que o conteúdo deixe de ser processado.
Para produzir uma resposta, o Gemini precisa analisar as informações enviadas durante a interação.
Também podem existir procedimentos de segurança e prevenção de abusos que independem da autorização para treinamento.
Essa diferença entre processamento operacional e treinamento de modelos é fundamental para compreender os limites do controle.
O Google pode armazenar dados mesmo depois de excluir o histórico?
Sim, em determinadas circunstâncias.
A política de privacidade do Gemini informa que conversas anteriormente selecionadas para revisão humana podem continuar armazenadas separadamente da conta do usuário.
Segundo o Google, dados analisados por prestadores de serviços podem ser mantidos por até três anos após serem desconectados da identidade da conta.
Isso significa que excluir a atividade visível não garante necessariamente a eliminação imediata de todas as cópias anteriormente utilizadas em procedimentos de revisão.
O objetivo declarado pela empresa é impedir que esses dados sejam diretamente associados ao usuário durante determinadas etapas de análise.
Entretanto, a desvinculação de identificadores não deve ser confundida automaticamente com anonimização irreversível.
Dependendo do conteúdo, documentos, mensagens e informações contextuais podem continuar permitindo a identificação de pessoas.
É justamente por isso que especialistas em privacidade recomendam evitar o envio de informações sensíveis desnecessárias, mesmo quando existem mecanismos de proteção.
Desativar o histórico pode limitar funcionalidades
O Google também informa que algumas integrações com aplicativos conectados podem ficar indisponíveis quando a opção Manter atividade está desativada.
Isso ocorre porque determinados recursos dependem de informações armazenadas para oferecer personalização ou integração entre serviços.
O Gemini pode interagir com produtos do ecossistema Google e, conforme as permissões concedidas, acessar informações provenientes de aplicativos conectados.
É importante observar que esses dados possuem regras próprias de tratamento.
A companhia afirma, por exemplo, que não utiliza diretamente toda a caixa de entrada do Gmail ou a biblioteca do Google Fotos para treinar modelos generativos apenas porque esses serviços estão conectados ao assistente.
Entretanto, informações de aplicativos conectados que passam a integrar uma conversa podem estar sujeitas às condições de tratamento aplicáveis à atividade do Gemini.
Por isso, a revisão das permissões dos aplicativos conectados deve fazer parte da configuração de privacidade.
Claude também permite impedir o uso das conversas no treinamento
O Claude, desenvolvido pela Anthropic, oferece controles específicos relacionados ao aprimoramento dos modelos.
Nas modalidades pessoais, como Free, Pro e Max, o usuário pode definir se autoriza a utilização de suas conversas e sessões de programação para essa finalidade.
A empresa também possui regras específicas para o Claude Code, ferramenta destinada a atividades de desenvolvimento de software.
Passo a passo para desativar o treinamento no Claude
1. Abra o Claude no navegador ou aplicativo.
2. Acesse o menu da conta.
3. Entre em Settings, ou Configurações.
4. Selecione Privacy, correspondente à seção de privacidade.
5. Localize Help Improve our AI models.
6. Desative a opção.
A Anthropic informa que, depois dessa alteração, novas conversas e sessões de programação deixam de ser utilizadas no treinamento futuro dos modelos.
A política também estabelece uma diferença relevante em relação a informações já armazenadas.
Ao desativar essa configuração, a empresa afirma que deixará de utilizar conversas anteriormente armazenadas em novas execuções de treinamento.
Entretanto, conteúdos que já participaram de treinamentos concluídos ou de processos em andamento não podem ser automaticamente retirados dos modelos resultantes.
Anthropic pode reter determinados dados por até cinco anos
A política de privacidade do Claude estabelece que, quando o usuário autoriza a utilização de conversas para aprimoramento dos modelos, os dados podem ser mantidos em formato desidentificado por até cinco anos nos sistemas de treinamento.
Esse prazo está relacionado a conteúdos elegíveis ao treinamento e não significa que todas as conversas de todos os usuários sejam obrigatoriamente armazenadas por cinco anos.
A empresa também informa que conversas excluídas normalmente são removidas do histórico imediatamente e apagadas dos sistemas de armazenamento em até 30 dias, ressalvadas as exceções aplicáveis.
O Claude oferece ainda conversas em modo incógnito, que não são utilizadas para aprimorar os modelos, mesmo quando o usuário habilitou a melhoria de modelos nas configurações gerais.
Contudo, a Anthropic mantém procedimentos de segurança que podem envolver a análise de interações sinalizadas por mecanismos automatizados de detecção.
Portanto, a escolha de não participar do treinamento regular não elimina necessariamente todo processamento destinado à segurança.
ChatGPT, Gemini e Claude: quais são as principais diferenças?
Embora as três empresas ofereçam mecanismos para limitar o treinamento, a maneira como organizam esses controles varia.
| Plataforma | Como impedir o treinamento | Retenção informada em situações específicas |
| ---------- | --------------------------------------------- | ------------------------------------------------------------------------ |
| ChatGPT | Desativar “Melhorar o modelo para todo mundo” | Chats temporários podem ser retidos por até 30 dias |
| Gemini | Desativar “Manter atividade” | Novas conversas podem permanecer por até 72 horas |
| Claude | Desativar “Help Improve our AI models” | Dados autorizados para treinamento podem ser mantidos por até cinco anos |
Os períodos apresentados não representam prazos gerais e diretamente comparáveis de armazenamento de todas as conversas. Cada número se refere a uma condição específica descrita pela respectiva empresa.
A comparação evidencia que privacidade não depende exclusivamente da existência de um botão para desativar treinamento.
É necessário considerar o histórico, os mecanismos de retenção, a revisão humana, o processamento para segurança e os serviços conectados.
As empresas podem ler suas conversas?
As três plataformas informam que podem existir situações em que determinados conteúdos sejam analisados por profissionais autorizados ou por prestadores de serviços envolvidos em atividades específicas.
Essas situações podem incluir avaliação de qualidade, investigação de abusos, tratamento de feedback e procedimentos de segurança.
Isso não significa que funcionários tenham acesso irrestrito a todas as conversas nem que cada mensagem seja obrigatoriamente lida por uma pessoa.
As empresas declaram adotar mecanismos de limitação de acesso e proteção de dados.
Entretanto, é incorreto presumir que toda interação com um chatbot esteja protegida por um nível de confidencialidade equivalente ao de determinadas comunicações profissionais legalmente sigilosas.
A diferença torna-se especialmente relevante quando o usuário compartilha dados de terceiros.
Um advogado, por exemplo, pode utilizar inteligência artificial para organizar argumentos ou revisar a estrutura de um documento.
Mas enviar integralmente uma petição acompanhada de informações pessoais, documentos médicos, dados financeiros e detalhes de um processo exige atenção à confidencialidade, à legislação aplicável e às políticas da plataforma utilizada.
O mesmo cuidado vale para empresas que compartilham contratos, códigos proprietários, estratégias comerciais e informações internas.
Planos empresariais possuem regras diferentes?
Sim. As políticas de utilização de dados podem variar significativamente entre contas pessoais, produtos empresariais e interfaces de programação.
A OpenAI informa que os dados enviados por meio de suas ofertas empresariais, educacionais e de API não são utilizados para treinar modelos por padrão.
A Anthropic adota uma política semelhante para produtos comerciais como Claude for Work e sua API, salvo situações específicas de autorização, feedback ou condições contratuais aplicáveis.
No ecossistema Google, as regras também variam conforme a modalidade de utilização, incluindo produtos vinculados ao Google Workspace e serviços corporativos.
Essa distinção é importante porque uma empresa que utiliza um chatbot por meio de uma conta pessoal pode estar sujeita a condições diferentes daquelas estabelecidas em um contrato empresarial.
Entretanto, não utilizar dados para treinamento não significa oferecer automaticamente retenção zero, ausência de registros operacionais ou proteção contra todos os riscos.
Organizações precisam avaliar controles de acesso, prazos de armazenamento, processamento regional, compartilhamento com terceiros e regras contratuais antes de adotar uma plataforma para atividades sensíveis.
Desativar o treinamento protege contra vazamentos de dados?
Não necessariamente.
A opção de impedir o treinamento atua sobre uma finalidade específica de utilização das informações.
Ela não impede, por si só, que um usuário compartilhe dados com a plataforma, que informações sejam processadas para gerar respostas ou que ocorram incidentes de segurança.
Existem também riscos relacionados à utilização de integrações externas.
Quando um assistente de inteligência artificial acessa ferramentas conectadas, documentos ou serviços de terceiros, os dados podem atravessar diferentes sistemas.
Cada integração pode possuir regras próprias de autenticação, armazenamento e utilização das informações.
Além disso, usuários podem compartilhar involuntariamente conteúdos por meio de links públicos de conversas ou permissões concedidas a outras pessoas.
Esses mecanismos representam riscos diferentes daqueles relacionados ao treinamento.
Por esse motivo, proteger dados exige uma abordagem mais ampla do que apenas alterar uma configuração.
Quais informações devem ser evitadas em conversas com IA?
A inteligência artificial pode ser útil para organizar documentos, analisar informações e auxiliar na tomada de decisões. Entretanto, nem todos os dados precisam ser compartilhados integralmente para realizar essas tarefas.
Em muitos casos, é possível substituir informações identificáveis por dados fictícios ou anonimizar parte do conteúdo.
Alguns exemplos merecem atenção especial:
• Senhas, tokens e chaves de API: permitem acesso a contas e sistemas quando expostos.
• Documentos pessoais: CPF, RG, informações bancárias e endereços podem identificar indivíduos.
• Dados médicos: exames, diagnósticos e históricos de saúde exigem cuidados adicionais.
• Processos judiciais sigilosos: podem envolver informações legalmente protegidas e deveres profissionais de confidencialidade.
• Informações empresariais: códigos proprietários, contratos e estratégias podem estar sujeitos a obrigações contratuais de sigilo.
• Dados de terceiros: a pessoa que utiliza a IA nem sempre possui autorização para compartilhar informações de outras pessoas.
Uma boa prática consiste em fornecer apenas os dados necessários para que o sistema execute determinada tarefa.
Se a intenção é revisar a linguagem de um contrato, por exemplo, pode não ser necessário incluir nomes completos, números de documentos e informações financeiras das partes.
Se o objetivo é analisar uma planilha, muitas vezes os registros podem ser substituídos por identificadores fictícios, preservando apenas os valores indispensáveis para o cálculo.
Essa abordagem reduz a exposição sem eliminar a utilidade da ferramenta.
O que diz a LGPD sobre o uso de conversas para treinar inteligência artificial?
No Brasil, o tratamento de dados pessoais deve observar a Lei Geral de Proteção de Dados Pessoais, conhecida pela sigla LGPD.
A legislação estabelece princípios como finalidade, adequação, necessidade, transparência e segurança no tratamento das informações.
Também reconhece direitos dos titulares relacionados ao acesso, à correção e à eliminação de dados em determinadas condições.
Isso significa que empresas responsáveis por serviços de inteligência artificial precisam possuir bases legais adequadas para tratar dados pessoais e fornecer informações sobre as finalidades desse processamento.
Entretanto, a aplicação da LGPD a sistemas de inteligência artificial envolve questões técnicas e jurídicas complexas.
Um dos principais desafios está na diferença entre excluir um registro armazenado e remover a influência de informações que já participaram do treinamento de um modelo.
Em um banco de dados convencional, determinada informação pode ser localizada e excluída de maneira relativamente direta.
Em modelos de aprendizado de máquina, o treinamento modifica parâmetros matemáticos a partir de padrões presentes em grandes conjuntos de dados.
Isso pode tornar a remoção de contribuições específicas tecnicamente mais complexa.
A dificuldade operacional não elimina obrigações legais, mas demonstra por que o tratamento de dados em inteligência artificial exige mecanismos próprios de governança e avaliação.
Para os consumidores, o caminho mais prudente continua sendo limitar preventivamente a exposição de informações desnecessárias.
Análise da equipe: a privacidade virou uma configuração que poucos usuários verificam
A possibilidade de utilizar conversas para aprimorar modelos cria uma relação econômica e tecnológica peculiar entre empresas de inteligência artificial e seus usuários.
As plataformas oferecem sistemas capazes de auxiliar em tarefas profissionais, pesquisas, programação e atividades pessoais.
Em contrapartida, determinadas interações podem fornecer informações valiosas para aperfeiçoar esses mesmos serviços.
O problema não está necessariamente na existência desse mecanismo.
Dados de utilização podem contribuir para identificar erros, corrigir limitações e desenvolver sistemas mais eficientes.
A questão central é o grau de controle e conhecimento que os usuários possuem sobre o tratamento dessas informações.
Grande parte das pessoas utiliza assistentes de inteligência artificial sem examinar detalhadamente as configurações de privacidade.
Essa situação se torna ainda mais relevante porque os chatbots incentivam interações extensas, nas quais os usuários frequentemente descrevem situações pessoais ou profissionais com grande riqueza de detalhes.
Uma conversa isolada pode parecer pouco relevante.
Entretanto, ao longo de meses, o histórico de interações pode revelar hábitos, projetos, interesses, dificuldades e informações que ajudam a construir um retrato bastante detalhado de determinada pessoa.
A existência de controles para impedir treinamento representa uma medida importante, mas não resolve todos os problemas.
A principal confusão está em tratar três operações diferentes como se fossem a mesma coisa: armazenar conversas, utilizar informações para personalização e empregar dados no treinamento de modelos.
Uma plataforma pode deixar de utilizar mensagens para treinamento e continuar armazenando o histórico.
Também pode permitir a exclusão de conversas, mas preservar determinados registros temporariamente por razões de segurança.
Da mesma forma, recursos de personalização podem utilizar informações anteriormente compartilhadas sem que isso represente treinamento do modelo principal.
Essas distinções raramente são evidentes para quem utiliza o serviço apenas como ferramenta cotidiana.
Outro problema envolve a maneira como os controles são apresentados.
Quando o usuário precisa navegar por diferentes menus para compreender como seus dados são utilizados, o exercício efetivo de suas escolhas depende de conhecimento técnico e familiaridade com as configurações.
A responsabilidade pela proteção das informações não deveria recair exclusivamente sobre a atenção individual de cada consumidor.
Transparência, configurações compreensíveis e mecanismos de exclusão verificáveis são elementos importantes para estabelecer confiança.
Ao mesmo tempo, usuários e empresas precisam reconhecer que nenhuma configuração substitui uma política responsável de compartilhamento de dados.
A maneira mais segura de proteger uma informação extremamente sensível continua sendo evitar enviá-la a sistemas externos quando isso não for necessário ou quando não existirem garantias adequadas de confidencialidade.
Como utilizar inteligência artificial com mais privacidade?
ChatGPT, Gemini e Claude oferecem mecanismos que permitem reduzir a utilização das conversas no treinamento de modelos.
No ChatGPT, o usuário pode desativar a opção Melhorar o modelo para todo mundo e continuar mantendo seu histórico.
No Gemini, a desativação de Manter atividade impede o uso regular de novas conversas para aprimoramento dos modelos, ressalvadas as condições específicas relacionadas a feedback e outros procedimentos descritos pelo Google.
No Claude, a opção Help Improve our AI models permite interromper a utilização de conversas e sessões de programação em treinamentos futuros, observadas as exceções e condições aplicáveis.
Esses controles representam uma melhoria importante na capacidade de escolha dos usuários.
Entretanto, a proteção efetiva também depende de compreender o que acontece com as informações depois que elas são enviadas.
Conversas podem continuar sendo processadas para gerar respostas, determinadas informações podem permanecer armazenadas temporariamente e integrações externas podem envolver outras políticas de dados.
Para quem utiliza inteligência artificial em atividades profissionais, a revisão dessas configurações deve ser acompanhada de cuidados com documentos, permissões de acesso e informações confidenciais.
Também é recomendável verificar periodicamente as políticas de privacidade, já que empresas podem modificar recursos, procedimentos e condições de tratamento.
A inteligência artificial está se tornando uma ferramenta cotidiana para milhões de pessoas, mas sua conveniência não elimina a necessidade de estabelecer limites claros para o compartilhamento de informações.
O controle sobre os próprios dados começa com uma decisão simples: compreender quais informações estão sendo fornecidas, por quanto tempo poderão permanecer armazenadas e para quais finalidades poderão ser utilizadas.
Impedir o treinamento é uma parte importante dessa proteção. Saber o que não deve ser compartilhado é a outra.
👉 Dúvida? Então veja mais em: [https://pixbugtech.com/linksuteis](https://pixbugtech.com/linksuteis?utm_source=chatgpt.com)