noticias
Claude adota marca d’água em textos de IA para cumprir novas regras europeias
**Categoria editorial:** Inteligência Artificial
Claude adota marca d’água em textos de IA para cumprir novas regras europeias
**Linha fina:** Anthropic entra na nova fase de rastreabilidade exigida pelo AI Act, mas a identificação não revela necessariamente quem escreveu um texto nem transforma detectores de IA em prova definitiva.
**Meta description:** Claude passa a marcar conteúdos gerados por IA para atender ao AI Act, abrindo uma nova fase de rastreabilidade, transparência e disputa técnica.
**Slug:** `claude-marca-dagua-textos-ia-ai-act`
**Palavra-chave principal:** marca d’água em textos de IA
Matérias relacionadas ou temas de continuidade
**AI Act entra na fase de fiscalização:** o que muda para empresas de inteligência artificial a partir de 2026.
**Detectores de texto feito por IA são confiáveis?** Por que probabilidade estatística não deve ser confundida com prova de autoria.
**A guerra pela procedência digital:** marcas d’água, metadados e credenciais de conteúdo tentam reconstruir a confiança na internet.
Texto para redes sociais
O Claude começa a entrar na era da rastreabilidade obrigatória de conteúdo gerado por IA. A novidade parece simples — uma marca invisível no texto —, mas abre questões importantes sobre autoria, falsos positivos, edição humana e o futuro dos detectores de inteligência artificial.
Briefing da imagem 800 × 600
Imagem editorial horizontal, exatamente 800 × 600 pixels.
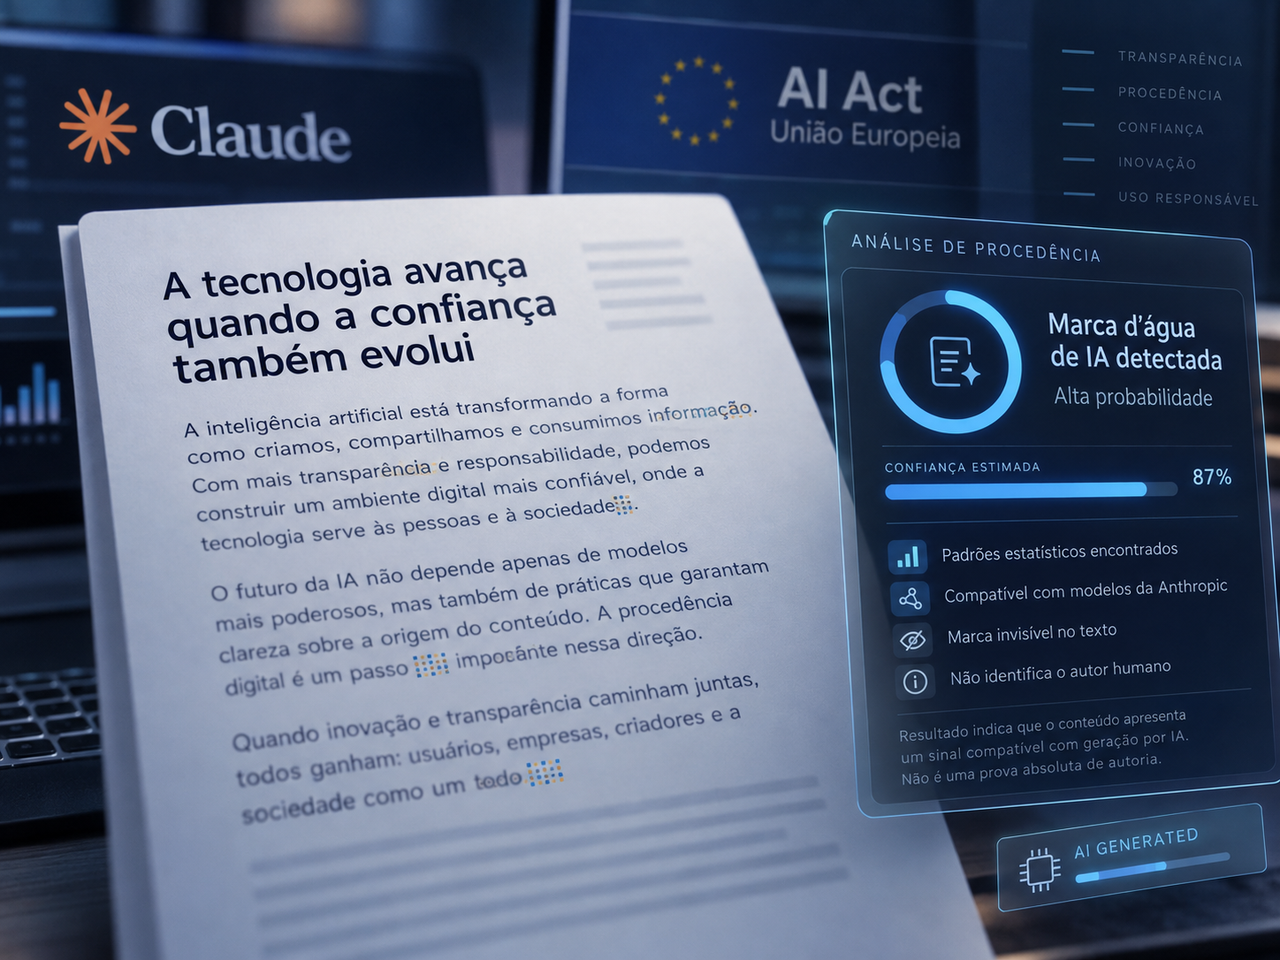
Composição centrada em uma folha ou bloco de texto digital visualmente limpo, contendo linhas abstratas de escrita. Algumas palavras devem apresentar discretos padrões geométricos quase invisíveis incorporados à tipografia, sugerindo uma marca d’água estatística.
Ao fundo, uma interface abstrata de verificação analisa o documento e revela uma camada de procedência digital. Inserir discretamente a ideia de origem “AI generated” ou autenticação, sem transformar a arte em captura de tela de produto.
Evitar robôs, cérebros digitais, humanoides e excesso de elementos futuristas. A imagem deve transmitir rastreabilidade, autoria, análise forense digital e transparência regulatória.
Não apresentar a marca como mecanismo infalível. A leitura visual deve sugerir probabilidade e verificação, não uma certeza absoluta.
Texto alternativo da imagem
Documento digital sendo analisado por um sistema de procedência que identifica uma marca d’água invisível incorporada ao texto gerado por inteligência artificial.
Matéria completa
A Anthropic começou a adaptar o Claude a uma internet na qual conteúdos produzidos por inteligência artificial terão de carregar sinais técnicos sobre sua origem.
Segundo informações divulgadas nesta terça-feira, 11 de agosto, textos produzidos por modelos da empresa passarão a incorporar mecanismos de identificação destinados a permitir que sistemas compatíveis reconheçam a participação da IA na geração daquele conteúdo.
A mudança está diretamente ligada ao AI Act da União Europeia, cuja nova etapa de aplicação entrou em vigor em 2 de agosto de 2026.
É uma alteração aparentemente discreta, mas que atinge um dos problemas mais difíceis da atual geração de inteligência artificial: depois que um texto sai da janela de um chatbot e é copiado para um documento, rede social, trabalho acadêmico ou site, como saber de onde ele veio?
A resposta que começa a emergir não é exatamente um “detector de IA”.
É um sistema de procedência.
E essa diferença é fundamental.
Claude não vai descobrir magicamente quem escreveu um texto
A manchete de que o Claude poderá “revelar quem criou” determinado conteúdo exige uma ressalva técnica importante.
Uma marca d’água incorporada à geração não identifica necessariamente a pessoa que solicitou o texto, seu nome, sua conta ou quem posteriormente publicou aquele material.
O objetivo regulatório é outro: permitir que determinado conteúdo possa ser reconhecido como artificialmente gerado ou manipulado.
Em outras palavras, o sistema tenta responder algo próximo de “este conteúdo apresenta uma marca compatível com geração por determinado sistema de IA”, e não “João Silva escreveu este parágrafo usando Claude às 14h32”.
Essa distinção parece semântica, mas será decisiva quando essas tecnologias começarem a aparecer em escolas, universidades, processos seletivos, redações, empresas e disputas judiciais.
Procedência tecnológica e autoria jurídica são coisas diferentes.
Por que isso está acontecendo agora
O motor dessa transformação está na Europa.
O Artigo 50 do AI Act estabelece obrigações de transparência para determinados sistemas de inteligência artificial e exige que provedores de sistemas generativos adotem mecanismos capazes de marcar conteúdos produzidos ou manipulados por IA em formato legível por máquina.
A legislação não exige simplesmente que o chatbot escreva “feito por inteligência artificial” no fim de cada resposta.
A ideia é criar uma camada técnica que possa acompanhar o conteúdo.
A Comissão Europeia também publicou um Código de Prática específico para transparência de conteúdo gerado por IA. A adesão ao código é voluntária, mas as obrigações previstas na legislação não são.
Anthropic, Google, Meta, Microsoft, Mistral, OpenAI e outras empresas aparecem entre as organizações que aderiram à seção voltada aos provedores de sistemas generativos.
Isso transforma uma discussão que durante anos ocorreu principalmente dentro de laboratórios de pesquisa em requisito de produto.
Como uma marca d’água pode existir dentro de um texto
Em imagens, áudio e vídeo, a ideia de uma marca invisível é relativamente intuitiva.
Pixels, frequências ou informações digitais podem carregar sinais imperceptíveis ao usuário.
Texto é mais complicado.
Um modelo de linguagem não escreve escolhendo frases inteiras armazenadas em algum banco de dados. Ele constrói a resposta gradualmente, selecionando unidades chamadas tokens a partir de distribuições de probabilidade.
Em um sistema de watermarking textual, uma implementação possível consiste em alterar de maneira extremamente pequena essas probabilidades.
Imagine que, em determinado ponto da frase, o modelo considere igualmente naturais cinco maneiras de continuar o texto.
O mecanismo de marcação pode favorecer algumas dessas possibilidades seguindo um padrão matemático conhecido pelo sistema de verificação.
Nenhuma palavra precisa parecer estranha.
Para o leitor, continua sendo apenas uma frase.
Mas quando centenas ou milhares dessas decisões são analisadas conjuntamente, pode surgir um padrão estatístico detectável.
É importante destacar que a Anthropic não publicou, até o momento da apuração desta matéria, documentação técnica suficiente para afirmar que seu mecanismo funciona exatamente dessa maneira.
Trata-se, porém, de uma arquitetura já utilizada e estudada para watermarking de modelos de linguagem e ajuda a entender por que uma “marca d’água em texto” não precisa envolver caracteres escondidos ou informações visíveis.
Copiar e colar pode não apagar a marca
Essa é justamente uma das vantagens de incorporar o sinal durante a própria geração.
Se a identificação dependesse exclusivamente dos metadados de um arquivo, copiar o texto de um documento e colá-lo em outro poderia destruir completamente a informação de procedência.
Uma marca estatística incorporada à sequência de palavras pode sobreviver ao copiar e colar.
Ela também pode resistir a pequenas alterações.
Trocar algumas palavras, corrigir pontuação ou excluir um parágrafo não necessariamente elimina todo o padrão.
Isso não significa, porém, que a marca seja indestrutível.
O grande problema: reescrever o texto
Aqui aparece uma limitação que provavelmente acompanhará toda essa tecnologia.
Quanto mais profundamente um texto é modificado, menor tende a ser a quantidade de informação original que permanece disponível para análise.
Experimentos públicos com outros sistemas de watermarking já mostraram boa resistência a cortes, pequenas alterações e paráfrases leves.
O cenário muda quando o conteúdo é extensamente reescrito.
Traduzir todo o texto para outro idioma, submetê-lo a outro modelo, solicitar uma reformulação profunda ou reconstruir manualmente os argumentos pode reduzir bastante o sinal.
Há uma razão matemática para isso.
A marca está associada às escolhas feitas durante a geração original.
Se essas escolhas deixam de existir, desaparece também parte da evidência utilizada pelo detector.
A corrida regulatória, portanto, não termina quando uma empresa inventa uma marca d’água.
Começa outra corrida: descobrir quão resistente ela é.
Detector de IA e verificador de marca d’água não são a mesma coisa
Esse provavelmente será o ponto mais importante para escolas e empresas.
Os chamados detectores de IA tradicionais normalmente recebem um texto qualquer e tentam inferir, por características estatísticas, se ele parece ter sido produzido por um modelo.
É uma espécie de perícia por comportamento.
O algoritmo observa previsibilidade, distribuição de palavras, estrutura linguística e outros indicadores e produz uma estimativa.
Esse método pode errar.
Textos humanos podem ser classificados como artificiais.
Textos produzidos por IA podem passar como humanos.
Uma marca d’água muda a lógica.
Em vez de tentar adivinhar a origem olhando apenas para o estilo, o verificador procura deliberadamente um sinal colocado pelo sistema durante a geração.
É a diferença entre olhar para uma assinatura e tentar descobrir quem escreveu imitando sua caligrafia ou verificar uma característica inserida intencionalmente no documento.
Ainda assim, nem mesmo essa segunda abordagem deveria ser tratada automaticamente como prova absoluta.
E existe o problema inverso: provar que algo não foi feito por IA
Imagine um texto sem qualquer marca detectável.
Isso significa que ele foi escrito por uma pessoa?
Não.
Pode ter sido produzido por outro modelo.
Pode ter sido gerado por uma versão sem aquele sistema de marcação.
Pode ter sofrido alterações suficientes para destruir o sinal.
Pode ter passado por outro modelo depois.
Pode ter sido traduzido.
Pode simplesmente estar abaixo do tamanho necessário para produzir evidência estatística suficiente.
Portanto, “marca encontrada” e “marca não encontrada” não possuem necessariamente significados simétricos.
Esse detalhe será particularmente relevante sempre que alguém tentar transformar essas ferramentas em instrumentos disciplinares.
A União Europeia não está exigindo apenas um aviso visual
O desenho regulatório europeu é mais sofisticado do que colocar uma etiqueta na interface.
Para provedores de sistemas generativos, o AI Act trabalha com a ideia de marcação legível por máquina e de mecanismos efetivos, interoperáveis, robustos e confiáveis, dentro do que for tecnicamente viável.
Há também outra camada.
Quem publica determinados conteúdos sintéticos pode ter obrigações próprias de informar pessoas expostas a eles.
No caso de textos sobre assuntos de interesse público, porém, existe uma exceção relevante quando há revisão humana efetiva, controle editorial e responsabilidade sobre a publicação.
Isso cria uma distinção necessária entre usar IA como ferramenta e terceirizar para uma IA todo o processo editorial.
Uma redação que pesquisa, confronta fontes, altera o texto, verifica afirmações e assume responsabilidade pelo conteúdo não está na mesma situação de uma operação automática que recebe uma notícia, pede a um modelo que a reescreva e publica o resultado sem revisão substantiva.
A própria regulamentação europeia faz essa diferenciação.
Isso também muda a discussão sobre jornalismo com IA
Há um aspecto pouco debatido nessa mudança.
Durante os primeiros anos da IA generativa, a pergunta mais comum foi: “Este texto foi escrito por uma máquina ou por uma pessoa?”
Essa talvez seja uma pergunta ruim.
Produção digital moderna raramente é binária.
Um jornalista pode usar IA para transcrever uma entrevista, organizar documentos, encontrar inconsistências, revisar gramática, resumir um relatório técnico ou sugerir estruturas — e depois realizar toda a apuração, escrita e edição.
Outro site pode gerar uma matéria inteira automaticamente a partir de um feed RSS.
Nos dois casos houve IA.
Editorialmente, entretanto, são processos radicalmente diferentes.
A procedência técnica consegue dizer alguma coisa sobre ferramentas utilizadas.
Ela não consegue, sozinha, medir responsabilidade editorial.
Análise da equipe
A decisão da Anthropic deve ser entendida menos como uma nova função do Claude e mais como um sinal de mudança estrutural na indústria.
Por quase três anos, empresas de IA venderam modelos cuja principal característica era justamente produzir conteúdos difíceis de distinguir daqueles feitos por humanos.
Agora começam a construir a infraestrutura necessária para tornar essa origem novamente detectável.
É uma ironia tecnológica bastante reveladora.
Primeiro desenvolvemos máquinas capazes de apagar parte dos sinais que separavam conteúdo humano e sintético.
Depois precisamos desenvolver outra camada de tecnologia para reconstruir essa distinção.
A União Europeia está acelerando esse processo ao transformar procedência em obrigação regulatória.
Isso provavelmente pressionará fornecedores a buscar padrões interoperáveis em vez de criar dezenas de identificadores incompatíveis.
Mas há um risco importante.
Marcas d’água não podem virar uma versão tecnológica do detector de mentiras.
A presença de um sinal precisa ser interpretada dentro de contexto técnico, levando em consideração versão do modelo, tamanho do conteúdo, transformações sofridas pelo texto e confiabilidade do método de verificação.
E sua ausência não deveria ser usada automaticamente para declarar que um conteúdo é humano.
Quem será impactado primeiro
Empresas que oferecem modelos generativos precisam adaptar suas arquiteturas e sistemas de distribuição.
Plataformas digitais terão incentivo para começar a ler esses sinais.
Desenvolvedores poderão incorporar verificadores a sistemas de moderação, publicação e compliance.
Universidades provavelmente observarão a tecnologia com grande interesse.
Redações terão de definir políticas mais claras sobre uso de inteligência artificial.
Empresas poderão começar a exigir rastreabilidade em documentos produzidos por sistemas automatizados.
E fornecedores que operam fora da Europa enfrentarão uma escolha econômica óbvia: manter versões diferentes de seus produtos para cada território ou simplesmente aplicar os mecanismos de transparência de maneira mais ampla.
A reportagem que revelou a mudança no Claude afirma que a Anthropic pretende aplicar a identificação globalmente, embora a obrigação jurídica tenha origem europeia.
Esse tipo de efeito já ocorreu outras vezes com regulações digitais da União Europeia: atender uma única arquitetura mundial pode ser mais simples do que manter múltiplas versões do mesmo produto.
O que ainda não sabemos
A parte mais interessante da história ainda está incompleta.
A Anthropic precisa detalhar como usuários poderão verificar as marcas.
Também será importante conhecer taxas de falso positivo e falso negativo, resistência a paráfrases, traduções e reprocessamento por outros modelos.
Outra questão será a interoperabilidade.
Um detector desenvolvido pela Anthropic reconhecerá apenas conteúdos do Claude ou existirá uma infraestrutura capaz de verificar diferentes sistemas?
Quem controlará as chaves, bancos de dados ou parâmetros necessários para essa validação?
Pesquisadores independentes conseguirão auditar o sistema?
E o que acontecerá com modelos de código aberto executados localmente, nos quais o próprio usuário pode alterar ou remover mecanismos de marcação?
Essas perguntas decidirão se a nova geração de procedência digital será uma infraestrutura de confiança ou apenas mais uma batalha interminável entre mecanismos de identificação e técnicas de evasão.
O que acompanhar a partir de agora
O verdadeiro teste começará quando as ferramentas de verificação chegarem às mãos do público.
Será necessário observar não apenas se uma marca pode ser detectada em um texto recém-produzido pelo Claude, mas se continua presente depois de atravessar o mundo real.
Documentos são editados.
Textos são resumidos.
Parágrafos são cortados.
Pessoas mudam palavras.
Sistemas de publicação alteram formatação.
Conteúdos passam de uma plataforma para outra.
E modelos de inteligência artificial reescrevem material produzido por outros modelos de inteligência artificial.
A tecnologia que sobreviver a esse percurso terá valor muito maior do que aquela que funciona apenas em demonstrações controladas.
A mudança do Claude, portanto, não resolve o problema da autoria na era da inteligência artificial.
Mas inaugura uma etapa mais madura da discussão.
Durante anos, a indústria se concentrou em tornar a geração sintética cada vez mais convincente.
Agora começa a descobrir que, em uma internet inundada por conteúdo perfeitamente plausível, saber de onde algo veio pode se tornar tão importante quanto saber produzi-lo.
👉 Dúvida? Então veja mais em: [https://pixbugtech.com/linksuteis](https://pixbugtech.com/linksuteis)