noticias
Claude Opus 5 aproxima a IA de fronteira do uso cotidiano mas “metade do preço” não significa inteligência barata
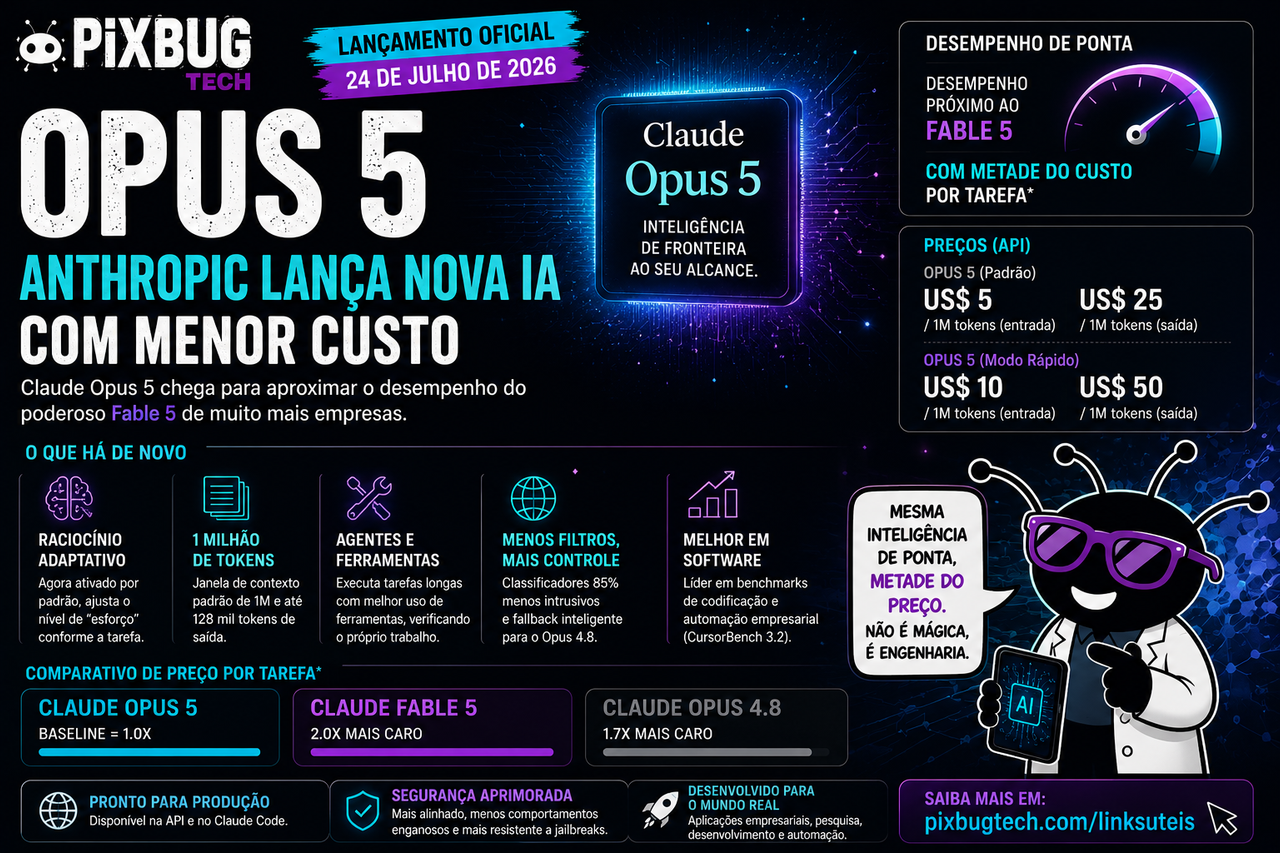
A Anthropic lançou o Claude Opus 5, novo modelo voltado a programação, pesquisa, análise empresarial e execução de tarefas prolongadas com ferramentas. A principal promessa é entregar desempenho próximo ao Claude Fable 5, sistema mais poderoso da companhia, cobrando metade do preço por milhão de tokens. O lançamento é relevante menos por apresentar uma inteligência radicalmente diferente e mais por reposicionar capacidades antes reservadas à camada mais cara da empresa dentro de uma faixa que organizações conseguem considerar para uso contínuo.
A expressão “menor custo”, porém, precisa ser interpretada corretamente. O Opus 5 não ficou mais barato que seu antecessor direto. A Anthropic manteve os mesmos US$ 5 por milhão de tokens de entrada e US$ 25 por milhão de tokens de saída cobrados pelo Opus 4.8. A economia aparece na comparação com o Fable 5 e, segundo a empresa, no custo necessário para concluir determinadas tarefas. Se o novo modelo resolve um problema com menos tentativas, menos chamadas de ferramentas e menos texto intermediário, a conta final pode cair mesmo que o preço unitário permaneça idêntico.
Essa distinção parece contábil, mas define o valor real de uma IA usada em produção. Empresas não compram tokens para admirar tokens. Elas pagam para revisar contratos, corrigir sistemas, analisar documentos, construir aplicações ou concluir processos administrativos. Um modelo aparentemente barato que falha três vezes pode custar mais do que outro caro que acerta na primeira.
O Opus 5 representa a tentativa da Anthropic de vender exatamente essa ideia: não a IA mais poderosa disponível em seu catálogo, mas a inteligência suficientemente próxima da fronteira para realizar grande parte do trabalho empresarial sem exigir o orçamento do modelo principal. É uma estratégia menos espetacular do que anunciar uma máquina universal, mas provavelmente mais importante para o mercado.
O preço permaneceu igual; a ambição aumentou
O Claude Opus 5 chega à API por US$ 5 por milhão de tokens recebidos e US$ 25 por milhão de tokens gerados. O modo rápido, que segundo a Anthropic produz respostas aproximadamente 2,5 vezes mais depressa, dobra esses valores para US$ 10 na entrada e US$ 50 na saída.
Não é uma tecnologia barata em qualquer cenário. Uma empresa que mantém agentes lendo grandes repositórios, processando documentos extensos e trabalhando durante horas pode consumir milhões de tokens rapidamente. O custo também não termina na API: há infraestrutura, armazenamento, sistemas de observabilidade, revisão humana, integrações e equipes responsáveis por corrigir os erros que o modelo inevitavelmente cometerá.
A Anthropic tenta compensar isso com um controle chamado effort, que permite escolher quanto processamento o modelo deve dedicar a cada solicitação. Os níveis variam de low a max. Em tarefas simples, um esforço menor reduz consumo e latência. Em problemas difíceis, as configurações mais altas permitem que o sistema analise mais caminhos, utilize ferramentas e revise o próprio trabalho antes de apresentar o resultado.
Esse controle transforma capacidade computacional em uma decisão operacional. O mesmo modelo pode responder rapidamente a uma pergunta cotidiana ou gastar muito mais recursos em uma migração de software, uma investigação financeira ou uma análise científica.
Para desenvolvedores, isso também transfere parte da responsabilidade econômica. Não basta escolher o Opus 5 e esperar eficiência automática. É necessário determinar quais tarefas realmente justificam níveis altos de raciocínio, medir o custo por resultado e reduzir esforço onde a qualidade permanecer aceitável.
A Anthropic está, na prática, vendendo um motor com acelerador manual. Quem mantiver o pedal no máximo para tudo terá uma experiência poderosa e uma fatura igualmente expressiva.
Um milhão de tokens muda o tamanho do problema
O Opus 5 possui uma janela de contexto padrão de 1 milhão de tokens, sem uma variante menor. Em termos práticos, isso permite receber grandes coleções de documentos, repositórios extensos de software, históricos de conversas e conjuntos de dados textuais dentro de uma única sessão.
O modelo também pode gerar até 128 mil tokens de saída. Esse espaço é suficiente para produzir relatórios longos, alterações substanciais de código, documentação ou sequências extensas de ações realizadas por agentes.
A presença de contexto amplo, entretanto, não significa que todas as informações serão utilizadas com a mesma precisão. Modelos podem perder detalhes, valorizar trechos errados ou criar relações inexistentes mesmo quando o material está tecnicamente disponível dentro da janela.
Há também uma diferença entre capacidade máxima e uso economicamente sensato. Inserir um milhão de tokens em uma única requisição pode facilitar determinadas tarefas, mas aumenta custo, latência e superfície de erro. Em muitos casos, ainda será melhor recuperar apenas os documentos relevantes, dividir o problema em etapas e manter mecanismos externos de memória.
A novidade real está na possibilidade de sustentar trabalhos mais longos sem depender de resumos agressivos a cada rodada. Um agente pode acompanhar mais partes de um código, preservar requisitos anteriores e comparar decisões tomadas em diferentes momentos.
Isso não cria memória permanente nem compreensão perfeita. Apenas oferece uma mesa maior sobre a qual o modelo pode espalhar os papéis. Ainda cabe ao sistema encontrar o documento certo antes de responder.
O pensamento agora vem ligado de fábrica
Uma mudança técnica importante é que o raciocínio adaptativo passa a ficar ativado por padrão. No Opus 4.8, desenvolvedores precisavam solicitar explicitamente esse comportamento. No Opus 5, o modelo decide quando e quanto deve “pensar” antes de responder, dentro do nível de effort escolhido.
A palavra pensamento precisa ser usada com cautela. O sistema não está refletindo com consciência humana. Ele gera etapas internas de processamento que ajudam a decompor problemas, comparar alternativas e planejar ações. O benefício prático pode ser real, mesmo que a metáfora seja generosa.
Esse comportamento ajuda em tarefas que não se resolvem com uma resposta imediata. Programação complexa, investigação de falhas, análise jurídica, modelagem financeira e pesquisa científica exigem verificação, retorno a etapas anteriores e uso de ferramentas externas.
A Anthropic afirma que o novo modelo verifica espontaneamente o próprio trabalho com maior frequência. Isso pode reduzir erros superficiais, mas também aumenta consumo e duração. Instruções antigas que obrigavam Claude a revisar tudo no final podem produzir verificação excessiva, repetição de chamadas e uma IA tão cuidadosa que transforma uma tarefa simples em uma reunião de condomínio.
Para empresas migrando do Opus 4.8, não se trata apenas de trocar o identificador do modelo. Prompts, limites de saída e estratégias de controle precisam ser revisados. Um sistema preparado para respostas sem raciocínio adicional pode consumir mais tokens do que o esperado quando o novo padrão entra em funcionamento.
A inteligência melhorou. A compatibilidade, como sempre, ficou para o desenvolvedor resolver.
O foco não está no chatbot, mas no agente que trabalha por horas
A divulgação do Opus 5 insiste em tarefas de longo horizonte. A expressão descreve trabalhos que exigem diversas etapas, acesso a ferramentas, revisão e persistência durante um período maior do que uma conversa comum.
Em programação, isso pode significar compreender um repositório, localizar a origem de um defeito, alterar vários arquivos, executar testes, analisar os resultados e corrigir o que ainda falhou. Em uma empresa, pode envolver abrir uma planilha, identificar clientes em risco, consultar dados adicionais, alertar responsáveis e produzir um relatório.
Modelos anteriores já conseguiam executar partes desse fluxo. O problema estava na consistência. Eles podiam abandonar requisitos, declarar sucesso cedo demais, deixar funções incompletas ou corrigir o sintoma sem alcançar a causa.
A Anthropic afirma que o Opus 5 mantém a direção por mais tempo, delega melhor para subagentes e verifica resultados antes de concluir. Parceiros com acesso antecipado relatam ganhos em depuração, análise financeira, documentos jurídicos, apresentações e automações empresariais.
Esses depoimentos ajudam a compreender onde a companhia deseja posicionar o modelo, mas não equivalem a avaliações independentes. As empresas citadas são clientes, parceiras ou plataformas que comercializam acesso ao Claude. Elas possuem interesse legítimo em testar o produto e interesse igualmente legítimo em divulgar uma integração que pode atrair usuários.
O teste importante acontecerá depois do lançamento, em projetos menos organizados, dados imperfeitos e ambientes nos quais o modelo não recebeu uma demonstração cuidadosamente selecionada.
Benchmarks medem capacidade. Produção mede paciência.
O lançamento redefine a família Claude
Com o Opus 5, a linha da Anthropic torna-se mais segmentada. Sonnet atende operações que precisam de escala e custo mais baixo. Opus oferece capacidade elevada para trabalho complexo. Fable ocupa a camada de inteligência de fronteira, voltada a projetos muito difíceis e autônomos. Mythos permanece associado às capacidades mais sensíveis, especialmente em biologia e cibersegurança.
Essa divisão mostra que o mercado de IA está abandonando a ideia de um único modelo ideal para tudo. O problema já não é apenas criar o sistema mais inteligente, mas oferecer diferentes proporções de capacidade, velocidade, risco e preço.
O Opus 5 existe porque utilizar Fable 5 em todas as tarefas seria economicamente irracional e tecnicamente desnecessário. Uma empresa não precisa do modelo mais poderoso do laboratório para corrigir uma fórmula, revisar uma apresentação ou implementar uma função comum.
Ao aproximar o Opus do Fable em determinadas avaliações, a Anthropic tenta encontrar o ponto em que a qualidade é alta o suficiente para substituir o modelo mais caro na maior parte do tempo.
Isso também protege o catálogo da própria empresa. Quando modelos concorrentes e opções abertas avançam rapidamente, manter a inteligência de ponta apenas em uma faixa premium cria espaço para migração. O Opus 5 reduz essa pressão ao entregar parte dos ganhos da fronteira sem desmontar o preço do produto superior.
É inovação técnica acompanhada de engenharia de prateleira.
A Anthropic afirma que ele programa melhor mas os gráficos são da Anthropic
Segundo a companhia, o Opus 5 lidera avaliações de engenharia de software, automação empresarial, uso de computador e resolução de problemas inéditos. No CursorBench 3.2, teria alcançado desempenho muito próximo ao Fable 5 no nível máximo de esforço, com metade do custo por tarefa. Em outra avaliação, teria mais que dobrado o resultado do Opus 4.8.
Os números são relevantes, mas precisam permanecer dentro de seu contexto. Muitos benchmarks foram executados internamente, com configurações definidas pela própria empresa. Pequenas decisões sobre ferramentas, prompts, tentativas permitidas e critérios de correção podem alterar o resultado.
Há ainda uma questão estrutural: modelos modernos estão sendo otimizados para avaliações conhecidas e para ambientes semelhantes aos utilizados por plataformas parceiras. Um bom resultado em tarefas controladas não garante o mesmo desempenho em um sistema antigo, mal documentado e cheio de dependências criadas por alguém que deixou a empresa em 2019.
A Anthropic fornece detalhes metodológicos e reconhece parte dessas limitações, mas a validação independente permanece necessária. O mercado já aprendeu que uma diferença de poucos pontos em um benchmark pode desaparecer quando usuários mudam o idioma, o domínio ou a ferramenta.
O Opus 5 provavelmente é mais capaz que o Opus 4.8. A dimensão exata dessa vantagem ainda será definida por quem pagar para descobrir.
Ciência e trabalho profissional entram no centro da estratégia
A empresa também destaca ganhos em biologia estrutural, química orgânica e bioinformática. O modelo teria melhorado em tarefas como deduzir estruturas moleculares a partir de dados de espectroscopia e prever como alterações em uma sequência proteica afetam sua função.
Essas capacidades aproximam o Claude de fluxos profissionais nos quais uma resposta errada pode ter consequências maiores do que um trecho de código defeituoso. O modelo pode ajudar a formular hipóteses, analisar dados e organizar literatura, mas não substitui validação experimental ou revisão especializada.
O mesmo vale para direito, finanças e administração pública. Uma IA capaz de processar um milhão de tokens consegue ler volumes enormes de material, porém continuará sujeita a interpretações incorretas, informações desatualizadas e excesso de confiança.
O ganho mais plausível está na produtividade assistida. Especialistas podem investigar mais alternativas, automatizar tarefas repetitivas e utilizar o modelo como uma segunda camada de revisão. Entregar a decisão final ao sistema continua sendo uma aposta diferente.
Quanto mais competente a IA parece, maior é o risco de o usuário deixar de conferir. Modelos medianos são perigosos porque erram. Modelos excelentes acrescentam outro problema: erram com uma reputação melhor.
Segurança menos restritiva não significa ausência de limites
A Anthropic afirma que o Opus 5 é seu modelo mais alinhado até agora, com taxas menores de comportamento enganoso e resistência superior a tentativas de induzir uso indevido. Também informa que o sistema não ultrapassa a fronteira de capacidades perigosas representada pelo Mythos 5.
Em cibersegurança, o Opus 5 teria desempenho próximo ao Mythos na identificação de vulnerabilidades, mas ficaria consideravelmente atrás na criação de exploits capazes de transformar a falha em ataque real. A empresa diz ter evitado treinamento específico para exploração ofensiva, embora melhorias gerais tenham elevado a capacidade do modelo nessa área.
Os filtros permitem analisar vulnerabilidades em código-fonte, mas bloqueiam algumas formas de inspeção de binários, testes de intrusão e geração de exploits. Pesquisadores verificados podem obter uma versão com menos restrições por meio do programa da empresa.
A Anthropic estima que os classificadores interfiram cerca de 85% menos do que no Fable 5. Quando um pedido é bloqueado em determinados produtos, ele pode ser encaminhado automaticamente ao Opus 4.8 em vez de simplesmente terminar em recusa.
Esse mecanismo é útil para continuidade, mas cria uma nova dificuldade: o usuário pode acreditar que ainda está utilizando o mesmo modelo quando a solicitação foi silenciosamente transferida para outro. Para aplicações empresariais, mudanças automáticas de capacidade precisam ser registradas, auditadas e consideradas nas avaliações de qualidade.
Fallback evita que a conversa pare. Também pode esconder que a inteligência mudou no meio do trabalho.
O custo por tarefa será a nova guerra dos modelos
Durante os primeiros anos da IA generativa, empresas disputavam principalmente pontuações e demonstrações impressionantes. Essa corrida continua, mas a economia passou a ocupar o centro.
Um modelo superior que consome recursos demais pode ser impraticável para milhões de interações. Outro ligeiramente inferior, mas mais eficiente, pode dominar aplicações empresariais porque entrega uma conta previsível.
O Opus 5 foi construído para essa disputa. A Anthropic não está dizendo apenas que ele é inteligente. Está dizendo que a inteligência produz mais trabalho por dólar.
Essa métrica é mais útil do que o preço isolado do token, mas também mais difícil de verificar. O custo por tarefa depende da qualidade do prompt, do número de tentativas, das ferramentas, da revisão humana e da definição de sucesso.
Uma empresa pode reduzir tokens e aumentar o trabalho de conferência. Pode economizar na API e perder dinheiro corrigindo automações. Também pode gastar mais no modelo e reduzir horas de especialistas.
Não existe uma tabela universal. Cada organização terá de medir o próprio fluxo, algo que muitas ainda não fazem. A adoção de IA avançou mais rapidamente do que a capacidade de calcular se ela realmente compensa.
O lançamento da Anthropic pressiona o mercado a sair do teatro de demonstrações e entrar na planilha.
Modelos melhores podem reduzir equipes antes de reduzir preços
A chegada de uma IA capaz de concluir tarefas mais longas terá efeitos sobre o trabalho. A narrativa corporativa costuma afirmar que esses sistemas libertarão profissionais de atividades repetitivas, permitindo que se concentrem em decisões estratégicas.
Isso pode acontecer. Também é provável que empresas utilizem a produtividade adicional para exigir mais entregas das mesmas equipes ou reduzir contratações em áreas nas quais a IA consegue absorver parte da execução.
Programadores iniciantes, analistas, redatores técnicos, profissionais administrativos e pessoas responsáveis por revisão de documentos podem sentir o impacto primeiro. Não porque o Opus 5 consiga substituir integralmente essas funções, mas porque altera a quantidade de trabalho que uma equipe menor consegue produzir.
O efeito não será uniforme. Profissionais capazes de orientar, avaliar e integrar o modelo podem ganhar produtividade. Quem realiza tarefas facilmente descritas, verificadas e repetidas enfrentará maior pressão.
Há uma contradição pouco discutida. Empresas precisam de especialistas para supervisionar IAs, mas o uso dessas mesmas IAs pode diminuir as oportunidades pelas quais novos profissionais se tornariam especialistas. Se as funções iniciais forem automatizadas, o mercado pode economizar hoje e descobrir amanhã que não formou pessoas capazes de revisar o sistema.
A inteligência artificial não elimina apenas tarefas. Ela interfere na escada usada para aprender a realizá-las.
Um lançamento menos chamativo e mais importante
O Opus 5 não chega como o modelo mais poderoso da Anthropic. Essa posição permanece com Fable 5 e, em capacidades específicas, Mythos 5. Também não reduz o preço cobrado dos usuários do Opus anterior.
Seu valor está em outro lugar: trazer parte da inteligência da camada de fronteira para um produto mais administrável, com contexto amplo, raciocínio ajustável e maior capacidade de executar trabalhos prolongados.
Essa estratégia aponta para a maturação do setor. A próxima etapa da competição não será vencida apenas por quem produz a resposta mais brilhante em uma demonstração. Será vencida por quem conseguir entregar desempenho consistente dentro de um orçamento que empresas consigam prever.
A Anthropic apresenta números fortes, mas ainda precisa provar que o modelo mantém qualidade fora dos testes, que o uso prolongado não produz custos ocultos e que a autonomia adicional pode ser controlada sem transformar cada automação em uma caixa-preta.
O Opus 5 também reforça a concentração da infraestrutura de inteligência. Organizações passam a construir processos, aplicações e conhecimento interno sobre modelos que não controlam. Uma alteração de preço, política, disponibilidade ou filtro pode modificar o funcionamento de produtos inteiros.
Quanto melhor a IA se torna, mais difícil é substituí-la — e mais poder ganha a empresa que opera o servidor.
A Anthropic entregou uma atualização tecnicamente relevante e comercialmente agressiva. O modelo promete aproximar a qualidade do Fable 5 de uma faixa menos proibitiva e ampliar a viabilidade de agentes em programação e trabalho profissional.
Mas “metade do preço” não significa inteligência barata, nem elimina os custos de integração, supervisão e dependência. O verdadeiro teste será descobrir se o Opus 5 reduz a conta total ou apenas permite que empresas gastem o mesmo valor realizando muito mais trabalho — inclusive trabalhos que antes exigiam pessoas.
A corrida da IA entrou em uma fase menos romântica. Agora não basta parecer inteligente. É preciso fechar a conta.
👉 Dúvida? Então veja mais em: https://pixbugtech.com/linksuteis