noticias
Cloudflare e OpenAI testam uma nova forma de indexar a web: a busca por IA quer ficar mais atual, mas a disputa com publishers só está começando
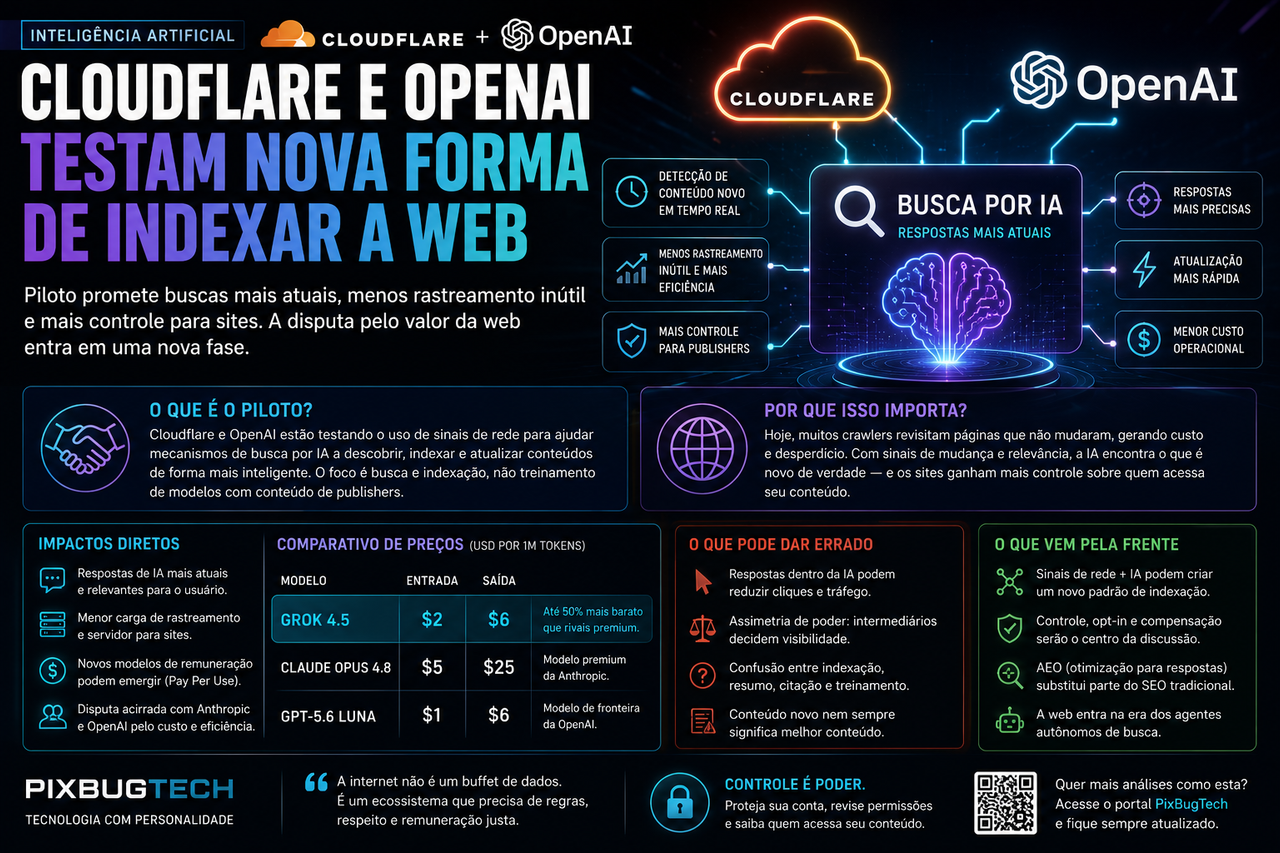
**A Cloudflare passou os últimos meses se posicionando como uma espécie de porteira técnica da internet contra crawlers de inteligência artificial. Agora, em um movimento que parece contraditório à primeira vista, a empresa anunciou um piloto de pesquisa com a OpenAI para ajudar mecanismos de busca com IA a descobrir e indexar conteúdo novo com mais eficiência. A tensão é justamente essa: a mesma infraestrutura que promete dar aos sites mais controle sobre quem acessa seus conteúdos também começa a oferecer sinais para que sistemas como o ChatGPT encontrem páginas relevantes mais depressa. O acordo não entrega conteúdo bruto para treinamento, segundo a Cloudflare, mas inaugura uma fase delicada em que o valor da web passa a ser negociado no nível da rede, antes mesmo do clique acontecer.**
O piloto foi anunciado em 8 de julho de 2026 e tem como objetivo testar se sinais coletados na rede global da Cloudflare podem melhorar a descoberta, a indexação e a atualização de respostas em sistemas de busca por IA. A empresa afirma que mais de 20% da web passa por sua infraestrutura, o que lhe permite observar, em tempo real, quando páginas mudam, quais conteúdos estão recebendo tráfego humano e automatizado e onde pode haver desperdício de rastreamento. A OpenAI entra com seus modelos, sistemas de busca e consultas reais de usuários para avaliar se esses sinais ajudam a produzir respostas mais recentes e precisas.
A proposta parece técnica, mas seu impacto é econômico e editorial. Hoje, muitos crawlers revisitam páginas repetidamente mesmo quando nada mudou, gerando custo para sites e para sistemas de IA. A Cloudflare afirma que mais de 50% do tráfego de rastreamento de bons bots pode estar voltado a recarregar páginas inalteradas, um desperdício que tende a crescer conforme ferramentas de IA ampliam sua fome por informação atualizada. O novo piloto tenta substituir parte dessa repetição por sinais de frescor, qualidade e mudança real, permitindo que a busca por IA seja menos cega e menos agressiva na coleta.
O que está acontecendo
A Cloudflare e a OpenAI não anunciaram uma parceria de licenciamento de conteúdo. O foco do piloto é descoberta e indexação, não autorização para treinar modelos fundacionais com material de publishers. Essa distinção é importante porque a disputa entre empresas de IA e produtores de conteúdo está dividida em camadas diferentes: uma coisa é usar páginas para treinar modelos; outra é indexar conteúdo para responder perguntas atuais; outra ainda é citar, resumir ou substituir o clique que antes levaria o leitor ao site original.
A TNW descreveu o movimento como uma virada curiosa: a Cloudflare, depois de passar um ano oferecendo ferramentas para bloquear crawlers de IA, agora ajuda uma das maiores empresas do setor a indexar melhor a web. A leitura faz sentido, mas precisa ser refinada. A Cloudflare não está simplesmente “abrindo o portão” para a OpenAI. Ela está tentando criar uma lógica na qual o acesso seja mais controlado, mais eficiente e, eventualmente, mais negociável.
O CEO Matthew Prince apresentou o piloto como uma forma de tornar a busca por IA mais eficiente e entregar respostas melhores mais rapidamente. Nick Ryder, vice-presidente de pesquisa da OpenAI, afirmou que informação atualizada é importante para respostas precisas no ChatGPT e que os sinais de rede da Cloudflare podem ajudar a descobrir conteúdo de maneira mais eficiente. Na prática, a ambição é reduzir a defasagem entre o momento em que a web muda e o momento em que um sistema de IA consegue refletir essa mudança em uma resposta.
O que muda na prática
Para usuários, a promessa é simples: respostas de IA menos desatualizadas. Uma busca tradicional mostra links e permite que o usuário avalie a data, a fonte e o contexto. Um chatbot ou mecanismo de resposta direta precisa sintetizar rapidamente. Quando o índice está velho, a resposta também envelhece; quando a IA não sabe que uma página mudou, pode repetir uma informação ultrapassada com aparência de certeza.
Para publishers e sites independentes, o efeito é mais ambíguo. De um lado, indexação mais eficiente pode reduzir carga de servidor e melhorar a chance de conteúdos recentes aparecerem em respostas de IA. De outro, respostas mais completas dentro do próprio ChatGPT podem diminuir a necessidade de o usuário clicar no site original. A velha troca da web — o crawler indexa, o buscador manda tráfego, o publisher monetiza a visita está sendo substituída por um modelo em que a resposta pode ser consumida antes do clique.
É por isso que a Cloudflare insiste que bloquear bots é apenas a primeira etapa. Em seu próprio blog, a empresa afirma que transparência e controle são fundamentos importantes, mas não bastam para reconstruir o modelo econômico da internet. A companhia já havia lançado o Pay Per Crawl, que permite a donos de sites escolher entre liberar, cobrar ou bloquear crawlers de IA, e agora fala em evoluir essa lógica para modelos de “Pay Per Use”, nos quais criadores seriam compensados quando seu conteúdo efetivamente gerasse valor em respostas.
O detalhe técnico que merece atenção
O ponto mais interessante do piloto não é a OpenAI “rastrear mais”, mas a possibilidade de rastrear melhor. Em vez de um crawler revisitar páginas em intervalos fixos ou por estimativas genéricas, ele poderia receber sinais de que determinado conteúdo mudou, ganhou relevância ou está sendo acessado por fluxos legítimos de usuários. Isso cria uma espécie de mapa de prioridade para a busca por IA.
A Cloudflare afirma que o programa é limitado à busca, não compartilha conteúdo e não usa os sinais para treinar modelos fundacionais. A empresa também diz que pretende publicar aprendizados sobre benefícios para proprietários de sites, como melhora de descoberta e redução de carga de servidores. Essa promessa é importante, mas ainda precisa ser testada na prática: o valor real dependerá do que será medido, de como os sites participarão e de quais controles estarão disponíveis para quem não quiser entrar no experimento.
A camada técnica também muda o poder de barganha. Se a Cloudflare consegue dizer a um mecanismo de IA quais páginas mudaram e quais não mudaram, ela deixa de ser apenas uma fornecedora de CDN e segurança. Passa a operar como uma espécie de intermediária de relevância entre publishers e buscadores de IA. Esse papel pode proteger sites pequenos contra rastreamento excessivo, mas também concentra uma autoridade enorme nas mãos de uma empresa que já está posicionada diante de parcela significativa da web.
Quem será impactado primeiro
Os primeiros afetados serão veículos de conteúdo, blogs técnicos, sites de documentação, portais de notícia e publicações que dependem de atualidade. Quanto mais rápido um conteúdo perde valor por ficar desatualizado, maior é o interesse de mecanismos de IA em capturar sinais de mudança. Notícias, documentação de software, análises de mercado, preços, políticas públicas e dados regulatórios são exemplos evidentes.
Empresas que usam Cloudflare também terão de prestar atenção às novas opções de controle. A companhia tem pressionado o mercado para separar crawlers de busca tradicional, crawlers de treinamento e agentes de IA. A TechCrunch registrou que, a partir de 15 de setembro de 2026, a Cloudflare pretende bloquear por padrão crawlers de “uso misto” em páginas com anúncios, caso eles não separem finalidades como busca, agentes e treinamento. Isso reforça a direção estratégica: a web não quer mais aceitar bots que entram com uma identidade genérica e usam o conteúdo para qualquer finalidade.
A OpenAI também será impactada diretamente. Se o piloto funcionar, o ChatGPT poderá obter respostas mais atuais com menos rastreamento redundante. Isso reduz custo, melhora qualidade e fortalece a disputa contra Google, Perplexity, You.com e outros mecanismos de resposta. A diferença é que a OpenAI, ao trabalhar com a Cloudflare, pode se aproximar de uma infraestrutura que já mede o comportamento da web antes que o usuário chegue ao buscador.
O que pode dar errado
O primeiro risco é a assimetria de poder. Publishers pequenos podem ganhar controles novos, mas continuar dependentes de grandes intermediários para serem encontrados. Se a busca por IA passar a depender de sinais fornecidos por redes como a Cloudflare, quem está fora dessas camadas pode ficar menos visível, mesmo produzindo conteúdo de qualidade.
O segundo risco é a substituição do tráfego por respostas. Uma IA mais atual e precisa pode servir melhor o usuário, mas também reduzir visitas aos sites que produziram a informação. O problema não é apenas técnico. É econômico. Se a resposta aparece completa no chatbot, o incentivo para clicar diminui, e a remuneração por publicidade, assinatura ou relacionamento direto com o leitor fica ameaçada.
O terceiro risco é a confusão entre indexação e uso. A Cloudflare afirma que o piloto não envolve treinamento de modelos, mas usuários e publishers podem ter dificuldade para distinguir busca, resumo, citação, treinamento e agentes. Essa confusão favorece desconfiança. A indústria de IA já perdeu parte da credibilidade justamente por tratar a web como insumo inesgotável e depois explicar os detalhes apenas quando pressionada.
O quarto risco é transformar “frescor” em métrica dominante. Conteúdo novo nem sempre é melhor. Uma página recém-publicada pode estar errada, incompleta ou manipulada. Uma boa busca por IA precisa equilibrar atualidade com autoridade, contexto e verificação. Caso contrário, sistemas de resposta podem apenas trocar informação velha por erro recente.
O que ninguém ainda está discutindo
A discussão pública está focada em crawlers, mas o tema mais profundo é a transformação da indexação em mercado. Durante décadas, a indexação da web foi tratada como infraestrutura quase invisível: buscadores rastreavam páginas, organizavam resultados e devolviam tráfego. Agora, cada etapa dessa cadeia pode virar produto, contrato, preço, permissão e relatório.
A Cloudflare já propôs mecanismos em que crawlers autenticados poderiam pagar por acesso usando uma lógica técnica baseada em resposta HTTP 402, preço por requisição e identificação criptográfica do bot. Esse caminho parece pequeno, mas aponta para uma internet em que agentes terão orçamento, sites terão preços e o acesso ao conhecimento poderá ser negociado programaticamente.
Isso pode ser bom para publishers profissionais, que finalmente teriam formas de cobrar pelo valor que entregam a sistemas de IA. Mas também pode criar uma web mais fragmentada, na qual respostas de IA priorizam conteúdos mais fáceis de licenciar, mais baratos de acessar ou mais integrados a grandes intermediários. A pergunta deixa de ser apenas “a IA encontrou a melhor fonte?” e passa a incluir “a IA conseguiu pagar, autenticar, negociar e acessar aquela fonte?”.
Também há uma mudança de SEO para AEO, a otimização para mecanismos de resposta. A Cloudflare afirma que novos relatórios podem mostrar quais perguntas levam determinado conteúdo a aparecer em resultados de IA, quais páginas foram usadas e em que posição surgiram. Se isso avançar, publishers deixarão de otimizar apenas títulos, links e palavras-chave para o Google. Passarão a otimizar trechos, respostas e autoridade para máquinas que talvez nunca enviem o leitor ao site.
Análise da equipe PixBugTech
O piloto entre Cloudflare e OpenAI é um daqueles movimentos que parecem técnicos demais para chamar atenção do público, mas mexem no encanamento da internet. Não se trata de um novo botão no ChatGPT. Trata-se de decidir como sistemas de IA descobrem a web, quais sinais orientam essa descoberta e quem controla a passagem entre conteúdo produzido por humanos e respostas sintetizadas por máquinas.
A Cloudflare está tentando ocupar uma posição extremamente poderosa: proteger publishers contra abuso de crawlers e, ao mesmo tempo, oferecer aos bons crawlers um caminho mais inteligente. Isso pode ser uma solução madura ou uma concentração adicional de poder, dependendo de transparência, controles, opt-in real e compensação econômica.
A OpenAI ganha com frescor, eficiência e qualidade. Publishers podem ganhar com menos rastreamento inútil e maior visibilidade em respostas. Mas o ponto crítico permanece: se a IA usa conteúdo para responder sem gerar retorno proporcional ao criador, a equação continua quebrada. A internet não se sustenta apenas com respostas rápidas; ela precisa de incentivos para que alguém continue produzindo o material que alimenta essas respostas.
O detalhe irônico é que a Cloudflare passou a era recente ensinando sites a dizer “não” para bots de IA. Agora tenta construir um “sim, mas com regras”. Esse “mas” será o futuro da web aberta.
Conclusão: a busca por IA quer ser mais inteligente, mas a web quer ser paga
O piloto da Cloudflare com a OpenAI mostra que a busca por IA está entrando em uma fase menos improvisada. Rastrear tudo, o tempo todo, sem pagar, sem explicar finalidade e sem devolver tráfego suficiente deixou de ser aceitável para uma parte crescente da web. O novo modelo precisa ser mais seletivo, mais transparente e economicamente mais justo.
A promessa imediata é melhorar a atualização das respostas no ChatGPT e reduzir rastreamento desnecessário. A consequência de longo prazo pode ser muito maior: transformar o acesso à informação online em uma negociação entre sites, redes de infraestrutura, agentes de IA e mecanismos de pagamento.
Se funcionar, o usuário receberá respostas mais atuais. Se falhar, a web pode se dividir entre conteúdo fechado, conteúdo explorado e conteúdo invisível.
A pergunta, portanto, não é apenas se a OpenAI conseguirá indexar melhor a internet. É se a internet continuará aceitando ser indexada sem entender quem ganha, quem paga e quem desaparece no caminho.
👉 Dúvida? Então veja mais em: [https://pixbugtech.com/linksuteis](https://pixbugtech.com/linksuteis)