noticias
Conversas do Claude apareceram no Google e o problema começa quando “compartilhar” significa publicar
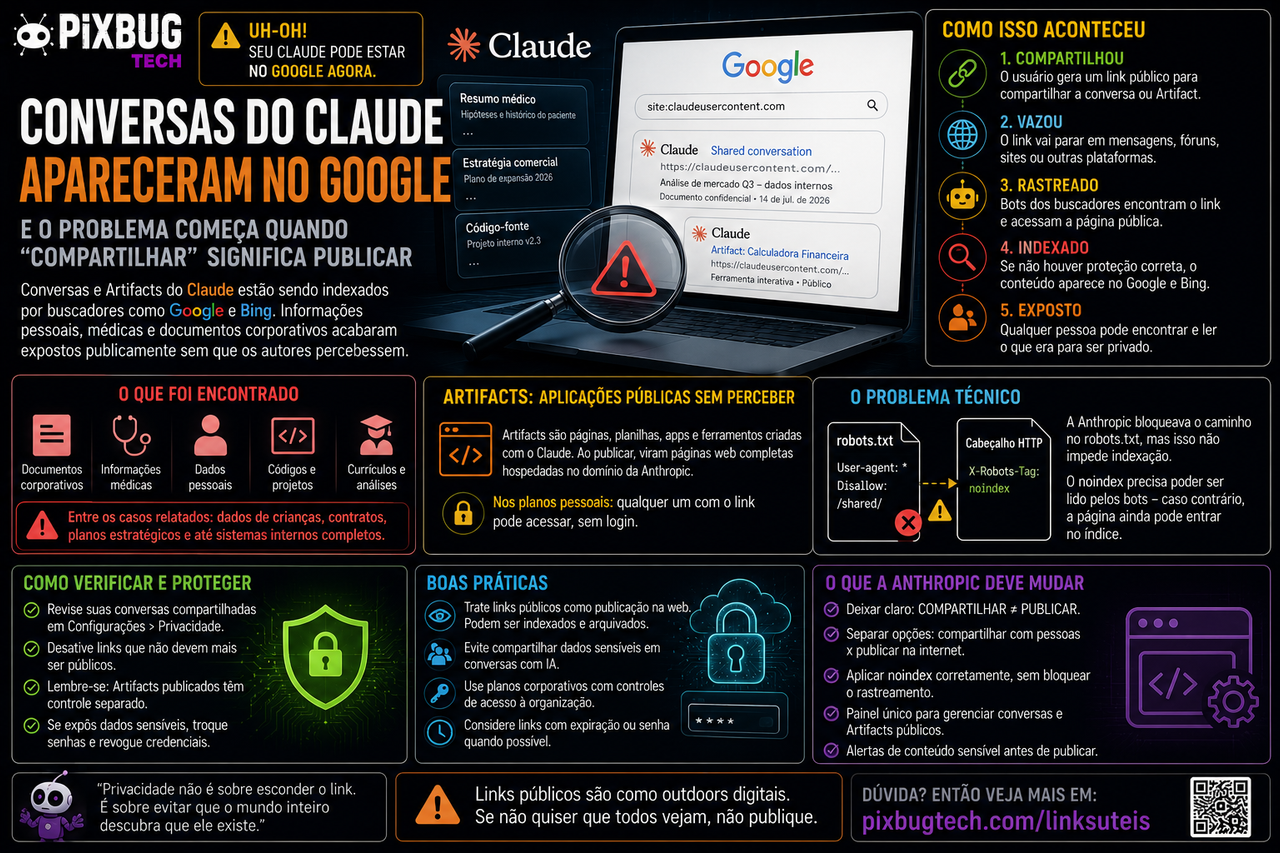
Conversas mantidas com o Claude e aplicações criadas por meio dos Artifacts da plataforma foram encontradas em resultados públicos do Google e do Bing.
Uma simples busca restrita ao domínio de compartilhamento da Anthropic permitia localizar páginas que seus autores provavelmente imaginavam estar acessíveis apenas às pessoas que recebessem o endereço.
O conteúdo não veio de uma invasão aos servidores da empresa nem de uma abertura indiscriminada das conversas privadas.
As páginas haviam sido transformadas em links públicos por meio das funções de compartilhamento do Claude. Tecnicamente, qualquer pessoa com o endereço poderia acessá-las. O problema é que “qualquer pessoa com o link” e “qualquer pessoa que pesquise no Google” são experiências radicalmente diferentes para o usuário, embora possam representar quase a mesma coisa para a arquitetura da web.
Entre os materiais relatados estavam informações pessoais, registros médicos, documentos corporativos, currículos, códigos, análises internas e dados relacionados a crianças. Também apareceram aplicações e documentos produzidos como Artifacts, recurso que permite transformar uma conversa em páginas, planilhas, ferramentas interativas e pequenos sistemas executados dentro da infraestrutura do Claude.
A Anthropic argumenta que não forneceu diretórios ou mapas das conversas aos buscadores e que os links não poderiam ser adivinhados facilmente. Segundo a companhia, uma URL enviada apenas por mensagem privada não seria descoberta; para chegar ao índice, precisaria ter sido publicada em uma página, fórum, rede social ou outro local acessível aos rastreadores.
Essa explicação descreve corretamente uma parte do funcionamento da web, mas não encerra a responsabilidade da plataforma. Links públicos inevitavelmente escapam dos canais em que foram enviados. São copiados para sistemas de mensagens, ferramentas de análise, encurtadores, serviços de pré-visualização, documentos colaborativos e plataformas que registram referências. A partir do momento em que um produto oferece uma opção de compartilhamento aparentemente casual, precisa assumir que a URL pode acabar diante de um mecanismo de busca.
Não é necessário que alguém publique deliberadamente uma conversa no centro de uma praça digital. Basta que um sistema intermediário deixe uma pista.
A conversa era pública, mas o usuário provavelmente não compreendia a escala
A função de compartilhamento do Claude cria um retrato da conversa no momento em que o usuário pressiona o botão. Todas as mensagens anteriores entram na página pública, incluindo Artifacts apresentados durante a sessão. Mensagens posteriores continuam privadas até que o retrato seja atualizado ou a conversa seja compartilhada novamente.
Esse comportamento é razoavelmente descrito na documentação. A interface informa que qualquer pessoa com o link poderá visualizar o conteúdo. Ainda assim, produtos digitais aprenderam a utilizar essa expressão como uma categoria intermediária entre público e privado.
Um vídeo não listado, um documento compartilhado e uma página acessível por URL costumam ser entendidos como conteúdos que não aparecem em diretórios ou resultados de pesquisa. Não possuem uma senha, mas dependem da circulação controlada do endereço. É uma privacidade baseada em obscuridade, frágil, porém socialmente reconhecida.
Quando a mesma página começa a aparecer em pesquisas por nomes, temas ou palavras presentes na conversa, essa expectativa desaparece. O conteúdo deixa de depender do conhecimento do endereço e passa a ser descoberto por assunto.
Uma pessoa pode aceitar que cinco colegas consultem uma análise de contrato. Provavelmente não pretende que um potencial empregador, cliente, adversário judicial ou curioso encontre o documento ao pesquisar seu nome.
A diferença não está na permissão técnica. Está na escala de descoberta.
A Anthropic pode afirmar que o usuário tornou o conteúdo público ao criar o link. O usuário pode responder que o botão dizia compartilhar, não publicar no Google. As duas frases possuem alguma verdade, mas apenas uma das partes projetou a interface e controlava os cabeçalhos enviados aos buscadores.
Artifacts são ainda mais perigosos porque parecem produtos terminados
Os Artifacts ampliam o problema além do histórico de conversa. Eles podem conter páginas, relatórios, apresentações, jogos, calculadoras, formulários, visualizações e pequenos aplicativos.
Nos planos pessoais, publicar um Artifact torna-o acessível a qualquer pessoa com o link, sem necessidade de uma conta. A intenção é permitir que o usuário distribua a criação como uma aplicação independente, sem expor obrigatoriamente o processo completo que levou ao resultado.
Essa facilidade transforma Claude em uma plataforma de hospedagem. O Artifact não parece apenas uma mensagem compartilhada; parece uma página pública convencional. Possui conteúdo renderizado, título, elementos interativos e endereço dentro de um domínio com enorme reputação.
Para o buscador, isso é material perfeitamente indexável. Para o usuário, pode parecer apenas uma demonstração enviada para três pessoas.
A fronteira torna-se ainda mais confusa quando conversa e Artifact possuem controles separados. Descompartilhar a conversa não significa necessariamente retirar a aplicação publicada. Um relatório pode deixar de aparecer no histórico compartilhado e continuar disponível por sua própria URL.
Isso cria um problema operacional previsível. O usuário acredita que fechou a exposição, mas desligou apenas uma das torneiras.
A interface deveria mostrar claramente todas as superfícies públicas relacionadas ao conteúdo: conversa, Artifact, versões anteriores, arquivos derivados e cópias. Também deveria oferecer uma ação única capaz de revogar todos os endereços associados.
Privacidade não pode depender de lembrar em qual submenu cada pedaço do trabalho foi publicado.
O robots.txt não é uma fechadura
Parte da confusão técnica envolve o arquivo `robots.txt`, utilizado por sites para informar quais caminhos os rastreadores devem ou não acessar.
A Anthropic bloqueava o diretório das conversas compartilhadas nesse arquivo. Isso pode impedir que buscadores leiam diretamente o conteúdo da página, mas não garante que a URL permaneça fora do índice.
Caso o Google encontre o endereço em outro site, pode registrar que a página existe mesmo sem visitá-la. Dependendo das informações disponíveis nos links externos, o resultado pode apresentar a URL e algum contexto.
O mecanismo adequado para solicitar que uma página não apareça no índice é o `noindex`, aplicado no código da página ou no cabeçalho HTTP. Há, contudo, um detalhe pouco intuitivo: o buscador precisa conseguir acessar a URL para enxergar essa instrução.
Bloquear simultaneamente o rastreamento no `robots.txt` e colocar o `noindex` dentro da resposta pode criar um conflito. O robô é informado de que não deve entrar, portanto não consegue ler o aviso que diz para não indexar.
Uma análise realizada após a repercussão encontrou justamente essa combinação nas páginas compartilhadas do Claude: o caminho estava bloqueado no `robots.txt`, enquanto a resposta HTTP apresentava um cabeçalho equivalente a `noindex`.
Não foi possível determinar publicamente se o cabeçalho já existia quando as conversas começaram a aparecer nos resultados ou se foi adicionado posteriormente. Outra análise, realizada sobre páginas expostas, não encontrou o bloqueio individual esperado.
Essa diferença impede uma reconstrução definitiva sem acesso aos registros da Anthropic e dos buscadores. O que pode ser afirmado é que a configuração não impediu a indexação e que utilizar apenas o `robots.txt` jamais deveria ser tratado como proteção para conteúdo sensível.
O arquivo é uma orientação para rastreadores bem-comportados, não um mecanismo de controle de acesso. Um crawler malicioso pode simplesmente ignorá-lo. Qualquer pessoa que possua o endereço continua acessando a página normalmente.
Colocar dados confidenciais atrás de um `robots.txt` é como pedir educadamente que os visitantes não abram uma porta que permanece destrancada.
A URL difícil de adivinhar não torna o conteúdo privado
Os links compartilhados possuem identificadores longos, o que torna improvável que alguém consiga descobrir uma conversa tentando combinações aleatórias.
Essa propriedade protege contra adivinhação direta. Não protege contra vazamento, encaminhamento, indexação ou registro por terceiros.
Links aparecem em históricos do navegador, plataformas de mensagem, ferramentas corporativas, sistemas de segurança, registros de proxy e serviços de análise. Um destinatário pode colar o endereço em um fórum, documento ou página pública. Um aplicativo pode gerar uma prévia e armazenar a referência.
Até mesmo uma pessoa cuidadosa pode perder o controle sem perceber. Ao utilizar uma ferramenta de produtividade que registra os links consultados, a URL pode entrar em um sistema acessível a mais pessoas do que o esperado.
Por isso, segurança baseada somente no segredo do endereço é adequada para conteúdo de baixo risco. Não deveria sustentar conversas contendo credenciais, informações médicas, estratégias empresariais ou dados pessoais.
Um link realmente privado precisa de autenticação, autorização ou senha. O servidor deve verificar quem está tentando entrar, e não apenas se a pessoa possui o endereço correto.
A Anthropic utiliza esse modelo mais restritivo em planos corporativos, nos quais determinadas formas de compartilhamento ficam limitadas aos integrantes da organização. A diferença mostra que a empresa já possui conceitos de acesso autenticado. O risco está em apresentar uma publicação aberta ao consumidor com linguagem que pode ser interpretada como um compartilhamento controlado.
O Google não publicou as páginas; apenas encontrou aquilo que estava aberto
Parte da reação tentou atribuir o episódio ao comportamento dos buscadores. Google e Bing rastreiam páginas públicas e constroem índices. Essa é sua função principal.
O Google afirmou que cabe aos proprietários dos sites decidir quais páginas ficam públicas e utilizar os controles disponíveis para impedir o rastreamento ou a indexação. A empresa também observou que as URLs apareceram em mais de um mecanismo de busca.
Isso não significa que buscadores sejam neutros em todas as questões de privacidade. Eles possuem processos de remoção, políticas para dados pessoais e decisões próprias sobre o que exibem. Mas, neste caso, o conteúdo estava hospedado e servido pela Anthropic sem exigir autenticação.
O incidente nasceu da combinação entre publicação pública, descoberta do endereço e controle incompleto da indexação.
Até a tarde de 27 de julho, as pesquisas utilizadas para localizar conversas já não retornavam resultados equivalentes no Google. O Bing ainda apresentava centenas de URLs em uma consulta semelhante no momento em que outras publicações verificaram o caso.
A remoção de um resultado não apaga as cópias que podem ter sido arquivadas, capturadas ou baixadas. Também não revoga a URL original. Enquanto o conteúdo continuar compartilhado, qualquer pessoa que possua o endereço ainda poderá acessá-lo.
É importante separar três ações:
remover a página do Google;
desativar o link público;
eliminar cópias mantidas por terceiros.
A primeira depende da plataforma e do buscador. A segunda pode ser feita pelo usuário. A terceira talvez seja impossível.
Não foi o primeiro episódio desse tipo
Produtos de inteligência artificial já enfrentaram exposições semelhantes. Conversas públicas do ChatGPT apareceram em buscadores depois que usuários habilitaram funções de compartilhamento. O Google também precisou ajustar a forma como transcrições compartilhadas de seus próprios chatbots eram tratadas.
O padrão é recorrente porque todas as empresas tentam resolver o mesmo problema comercial. Usuários querem mostrar respostas, compartilhar projetos e transformar conversas em conteúdo reutilizável. A plataforma deseja aumentar circulação, colaboração e descoberta.
A privacidade caminha na direção oposta. Quanto mais fácil é publicar, maior é o risco de alguém transformar uma conversa sensível em página pública sem compreender a consequência.
As empresas poderiam proteger tudo com autenticação obrigatória, mas isso reduziria o alcance. Um destinatário teria de criar conta, entrar no serviço e receber autorização específica.
A URL pública elimina essa fricção. Também elimina uma camada de controle.
O incidente do Claude não é um bug isolado dentro de uma plataforma particularmente descuidada. É consequência de uma indústria que tenta oferecer compartilhamento com a simplicidade de uma rede social enquanto mantém a aparência de um espaço privado de trabalho.
A interface começa como caderno pessoal e termina como sistema de publicação. O usuário nem sempre percebe em qual momento atravessou a fronteira.
Conversas com IA contêm mais intimidade do que pesquisas comuns
Pessoas costumam fornecer aos chatbots informações que não escreveriam em uma pesquisa tradicional. Colam contratos, relatórios médicos, avaliações de funcionários, conversas pessoais, códigos internos e estratégias profissionais.
A interação encoraja contexto. Quanto mais informações o modelo recebe, melhor tende a responder. O usuário passa a tratar a conversa como uma mesa de trabalho privada.
Esse comportamento torna a função de compartilhar particularmente sensível. Uma conversa pode começar com um pedido genérico e receber dados confidenciais dezenas de mensagens depois. Ao criar um retrato público, o usuário talvez esteja pensando apenas na resposta final, sem perceber que todas as mensagens anteriores serão incluídas.
O botão deveria apresentar um resumo claro do que será exposto: quantidade de mensagens, presença de dados pessoais, nomes de arquivos e Artifacts vinculados.
A plataforma também poderia executar uma análise local para alertar sobre possíveis credenciais, telefones, endereços, documentos médicos e informações financeiras. Não precisaria impedir o compartilhamento, mas deveria criar fricção proporcional ao risco.
Empresas de IA já utilizam classificadores para bloquear inúmeros conteúdos. Aplicar parte dessa capacidade para evitar que usuários publiquem acidentalmente chaves de API parece uma utilização menos glamourosa e bastante necessária.
O produto sabe quando uma conversa menciona um tema sensível. Poderia ao menos perguntar se o usuário realmente deseja transformá-la em página pública.
A responsabilidade do usuário existe, mas não absolve o design
Quem cria uma URL pública precisa assumir que ela pode ser encaminhada. Não se deve colocar segredos, credenciais ou dados de terceiros em uma página acessível sem autenticação.
Essa responsabilidade individual é real.
Também é insuficiente como explicação de produto. Plataformas são responsáveis por comunicar riscos de maneira compatível com a compreensão normal de seus usuários. Um aviso juridicamente correto pode continuar sendo funcionalmente enganoso.
“Qualquer pessoa com o link” tornou-se uma fórmula familiar para algo que não aparece em pesquisas e não é promovido pela plataforma. Usuários reconhecem a fragilidade, mas esperam uma visibilidade limitada.
Caso a Anthropic considere todo link equivalente a uma publicação aberta na web, a interface deveria utilizar exatamente essa expressão: **publicar na internet**.
O botão também poderia oferecer duas opções distintas:
compartilhar com pessoas específicas, exigindo login ou convite;
publicar abertamente, com possibilidade explícita de indexação.
Misturar os dois comportamentos em um único fluxo transfere ao usuário uma decisão técnica que ele não percebe que está tomando.
Uma empresa que desenvolve modelos capazes de interpretar nuances linguísticas não deveria depender de uma frase ambígua para explicar o destino de informações potencialmente confidenciais.
Empresas precisam tratar links de IA como vazamento potencial
Organizações já treinam funcionários para não enviar documentos internos a serviços não autorizados. Agora precisam incluir uma segunda etapa: não publicar conversas e Artifacts que utilizam esses documentos.
Mesmo quando o arquivo anexado não aparece diretamente no retrato compartilhado, partes de seu conteúdo podem ter sido reproduzidas na conversa, no resumo ou no Artifact criado pelo modelo.
Uma análise baseada em um contrato pode revelar cláusulas, nomes, valores e estratégias. Um sistema construído com dados corporativos pode incorporar exemplos reais em sua interface. Um relatório pode manter informações que o usuário imaginava estarem protegidas porque vieram de uma integração privada.
Políticas internas devem definir quais plataformas podem ser utilizadas, quais conteúdos podem ser compartilhados e quem possui autorização para publicar Artifacts.
Administradores também precisam verificar se versões corporativas realmente restringem o acesso à organização e se usuários mantêm contas pessoais paralelas, nas quais os controles são diferentes.
Não basta confiar que o funcionário verá a palavra “público” e compreenderá toda a cadeia de indexação. O ambiente corporativo deve assumir que um link sem autenticação pode chegar a buscadores, arquivos e terceiros.
A segurança da informação passou décadas tentando impedir anexos enviados ao destinatário errado. Agora precisa lidar com relatórios transformados em pequenos sites por um botão colorido.
Artifacts públicos podem virar um novo vetor de SEO, fraude e desinformação
A indexação de Artifacts não cria apenas risco de privacidade. Também transforma o domínio do Claude em uma plataforma potencial para conteúdo produzido em escala.
Páginas hospedadas em um domínio conhecido podem receber confiança inicial de buscadores e usuários. Criminosos podem tentar publicar formulários falsos, páginas de coleta de dados, ofertas enganosas ou documentos que imitam comunicações legítimas.
A Anthropic impõe políticas e limitações, mas qualquer sistema de publicação em grande escala enfrenta abuso. Quanto mais fáceis forem a geração e a indexação, menor será o custo para criar centenas de páginas.
Também pode surgir uma corrida de otimização para mecanismos de busca. Usuários já experimentavam publicar Artifacts para conseguir posições rápidas em resultados. Caso a plataforma permita indexação ampla, passará a disputar espaço com blogs, ferramentas e páginas tradicionais.
A empresa terá de decidir se deseja ser uma hospedagem pública de aplicações, um ambiente privado de trabalho ou ambos. Cada papel exige controles diferentes.
Se Artifacts forem tratados como páginas públicas destinadas à descoberta, precisam de moderação, políticas de abuso, relatórios, identificação de autoria e controles de indexação. Caso sejam considerados apenas objetos compartilháveis, deveriam permanecer fora dos buscadores por padrão.
Tentar ocupar as duas posições simultaneamente produz exatamente a confusão atual: o usuário pensa que está mostrando um protótipo; o Google pensa que encontrou uma nova página da web.
Descompartilhar é necessário, mas pode não apagar todos os rastros
Usuários do Claude podem abrir as configurações de privacidade e revisar a lista de conversas compartilhadas. O link deve ser desativado para qualquer conteúdo que não deveria permanecer público.
Artifacts publicados precisam ser revisados separadamente. Retirar a conversa não garante a retirada do Artifact.
Depois da revogação, a página original deixa de funcionar ou perde o acesso público. Resultados de busca podem demorar algum tempo para desaparecer, dependendo do novo rastreamento e das solicitações de remoção realizadas pela Anthropic.
Se a conversa continha credenciais, apenas apagar o link não é suficiente. Chaves de API, tokens, senhas, códigos de recuperação e acessos a carteiras devem ser considerados comprometidos e substituídos.
Dados pessoais não podem ser “trocados” da mesma maneira. Nesse caso, o usuário deve registrar o ocorrido, notificar a organização responsável quando necessário e avaliar medidas adicionais conforme o tipo de informação.
Também vale pesquisar trechos únicos, nomes e títulos que apareciam na página. Essa busca não garante que tudo tenha sido localizado, mas ajuda a verificar se existem cópias ou resultados remanescentes.
A reação precisa ser proporcional. Não há razão para presumir que toda conversa compartilhada foi baixada por criminosos. Também não é prudente assumir que ninguém a viu apenas porque o Google retirou o resultado.
O que a Anthropic deveria mudar
A solução mais imediata é garantir que páginas de conversas compartilhadas tenham uma diretiva `noindex` que possa ser lida pelos mecanismos de busca, sem bloqueá-la atrás de uma regra incompatível no `robots.txt`.
Isso reduz a indexação por buscadores cooperativos, mas não cria privacidade. Links públicos continuariam acessíveis e poderiam ser arquivados.
Para conteúdos sensíveis, a plataforma deveria oferecer compartilhamento autenticado. O usuário escolheria pessoas ou organizações autorizadas e poderia revogar individualmente o acesso.
A interface também precisa separar com clareza **compartilhar** de **publicar**. Publicações deveriam incluir um aviso explícito sobre acesso público, indexação, arquivamento e impossibilidade de controlar cópias.
Conversas e Artifacts associados deveriam aparecer em um painel único, com informações sobre data de publicação, última visualização, status de indexação e possibilidade de revogação conjunta.
Uma proteção adicional poderia expirar links automaticamente depois de um período escolhido pelo usuário. Grande parte dos compartilhamentos serve apenas para uma revisão temporária e não precisa permanecer aberta indefinidamente.
A empresa também poderia permitir senhas, restrição por domínio e bloqueio de download quando tecnicamente possível. Nenhuma dessas medidas é perfeita, mas oferece controles graduais em vez da atual escolha entre privado e inteiramente público.
A privacidade da IA não termina no treinamento dos modelos
Discussões sobre privacidade em inteligência artificial costumam concentrar-se em saber se conversas serão utilizadas para treinamento. É uma pergunta importante, mas representa apenas uma parte do risco.
Uma plataforma pode prometer que não usará os dados para treinar seus modelos e ainda expô-los por configurações de compartilhamento, integrações, registros, permissões ou erros de produto.
A privacidade precisa acompanhar todo o ciclo:
o que o usuário envia;
onde o conteúdo é armazenado;
quem pode acessá-lo;
como é processado;
quando é compartilhado;
como pode ser revogado;
e que cópias permanecem depois.
O caso Claude demonstra como uma função aparentemente secundária consegue superar em impacto debates inteiros sobre treinamento. O usuário talvez tenha escolhido uma configuração restritiva para seus dados e, minutos depois, criado voluntariamente uma página pública sem perceber a extensão da decisão.
A empresa não pode tratar privacidade como uma preferência única escondida nas configurações. Cada ação que amplia o público exige consentimento específico e compreensível.
O verdadeiro problema foi a tradução entre produto e web
Do ponto de vista técnico, uma página sem autenticação é pública. Do ponto de vista social, um link enviado a uma pessoa é frequentemente tratado como privado.
Produtos modernos existem no espaço entre essas duas interpretações. A empresa conhece a primeira. O usuário opera pela segunda.
A função de compartilhamento do Claude atravessou essa diferença sem construir controles suficientes. Links escaparam para locais rastreáveis, buscadores fizeram aquilo que foram projetados para fazer e conteúdos sensíveis tornaram-se descobertos por pesquisas comuns.
Não foi uma invasão cinematográfica. Foi um conjunto de decisões ordinárias: botão conveniente, URL pública, regras de indexação mal coordenadas e expectativa humana diferente da implementação.
Esses incidentes são perigosos justamente porque não parecem ataques. Não há malware, alerta vermelho ou invasor encapuzado. O usuário apenas pressiona compartilhar e continua trabalhando.
A Anthropic pode corrigir a configuração que permitiu a indexação. A indústria ainda precisa corrigir uma ideia mais profunda: tratar publicação aberta como se fosse apenas uma maneira prática de enviar conteúdo.
Conversas com IA já funcionam como escritórios improvisados, consultórios, cadernos, ambientes de programação e salas de estratégia. O botão que as leva para fora desses espaços precisa ser mais cuidadoso do que o botão utilizado para compartilhar uma fotografia.
O episódio não prova que tudo escrito no Claude está público. Prova algo mais simples e mais útil: qualquer conversa transformada em link público deve ser tratada como conteúdo publicado na internet, mesmo quando a interface tenta tornar esse gesto tão casual quanto copiar um endereço.
A privacidade acabou no instante em que o servidor deixou de perguntar quem estava entrando. O Google apenas tornou essa realidade muito mais fácil de encontrar.
👉 Dúvida? Então veja mais em: https://pixbugtech.com/linksuteis