noticias
DeepSeek V4 Pro destravado: o que o DeepClaude revela sobre benchmarks de LLM em 2026
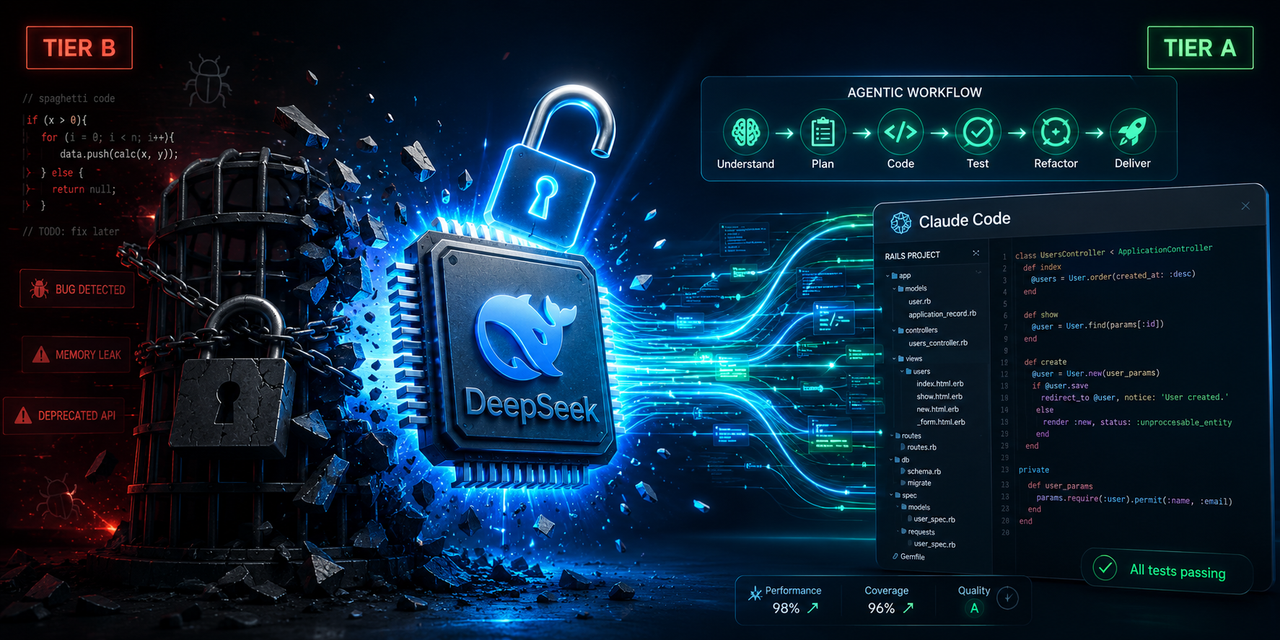
Muitos modelos de linguagem parecem fracos ou inconsistentes até você mudar o harness correto. O caso do DeepSeek V4 Pro é o exemplo mais recente e didático: preso em Tier B (69/100) e com bugs de compatibilidade em fluxos multi-turn, o modelo saltou para Tier A (89/100) assim que encontrou o ambiente certo. A ferramenta que destravou tudo chama-se **DeepClaude**.
Não é mais um modelo ruim. É um modelo que estava sendo avaliado no lugar errado.
O problema original
Nos benchmarks anteriores de coding (tarefa realista de Rails 8 + RubyLLM + Hotwire + Tailwind + testes), o DeepSeek V4 Pro entregava código funcional, mas incompleto e com polish baixo. Em cenários multi-turn ou orquestrados via ai-sdk, ele simplesmente quebrava com erro de protocolo (`reasoning_content must be passed back to the API`). O resultado: score artificialmente baixo e runs poluídas por fallback para outros modelos.
O problema não estava na qualidade inerente do modelo. Estava na incompatibilidade entre o harness e o jeito como o DeepSeek lida com conteúdo de raciocínio.
O que é DeepClaude e como funciona
**DeepClaude** é um shim leve para o Claude Code (CLI oficial da Anthropic). Ele redireciona as chamadas do Claude Code para outros provedores (DeepSeek direto, OpenRouter, Fireworks) mantendo todo o loop agentic do Claude intacto — tool use, edição de arquivos, bash, prompt caching e multi-step reasoning.
Em vez de lutar contra o ai-sdk, você usa o ecossistema já maduro do Claude Code, mas com o modelo DeepSeek por baixo. O resultado foi imediato: multi-turn funciona, tool calls fluem e a qualidade do output sobe drasticamente.
Resultados práticos do benchmark
• **DeepSeek V4 Pro via DeepClaude (com Sonnet registrado)**: **89/100** — Tier A
• Tempo: ~18 minutos
• Custo: ~$3,14
• Posição: 4º lugar geral, atrás apenas de Claude Opus 4.7, GPT 5.4/5.5 e Kimi K2.6
Mesmo sem delegar para subagentes, a mera existência de um subagent registrado melhora a decomposição do planner. O ganho veio quase inteiro da troca de harness, não de mudança de modelo.
Análise da Equipe PixBugTech
**Mergulho 1 – Harness importa mais do que admitimos**
2026 deixou claro: benchmark de LLM não mede apenas o modelo. Mede o modelo + harness + prompt engineering + task definition. Um mesmo modelo pode variar 15-20 pontos dependendo do ambiente. Quem julga modelos apenas por leaderboards genéricos (MMLU, HumanEval etc.) está perdendo a parte mais relevante para uso real: performance em workflows agenticos complexos.
**Mergulho 2 – Open source chinês amadurecendo rápido**
DeepSeek V4 Pro mostra que os melhores modelos chineses já não são apenas “baratos e bons em chinês”. Com o harness correto, eles entregam qualidade de frontier em tarefas reais de coding, com custo significativamente menor. Isso pressiona os players ocidentais a competir tanto em capacidade quanto em preço.
**Mergulho 3 – O valor das ferramentas de roteamento**
DeepClaude é um ótimo exemplo de como a comunidade está contornando limitações de ecossistemas fechados. Em vez de esperar que cada provedor suporte todos os formatos, a solução criativa é criar shims que aproveitam o melhor harness (Claude Code) com os melhores modelos disponíveis via OpenRouter ou APIs diretas.
Conclusão
O DeepSeek V4 Pro não “melhorou” magicamente. Ele só parou de ser punido por um harness incompatível. O salto para Tier A reforça uma verdade cada vez mais evidente em 2026: a diferença entre um modelo mediano e um excelente muitas vezes está menos no treinamento e mais no ecossistema ao redor.
Para quem trabalha com coding agentico, vale testar DeepClaude. Pode ser o atalho que faltava para usar modelos poderosos e acessíveis sem abrir mão de um loop agentic maduro.
Tecnologia explicada com responsabilidade, analisada com profundidade.
**PixBugTech — Maio 2026.**
---
👉 Dúvida? Então veja mais em: https://pixbugtech.com/linksuteis
---