noticias
Durante boa parte da corrida recente da inteligência artificial, a decisão parecia começar pelo nome do modelo.
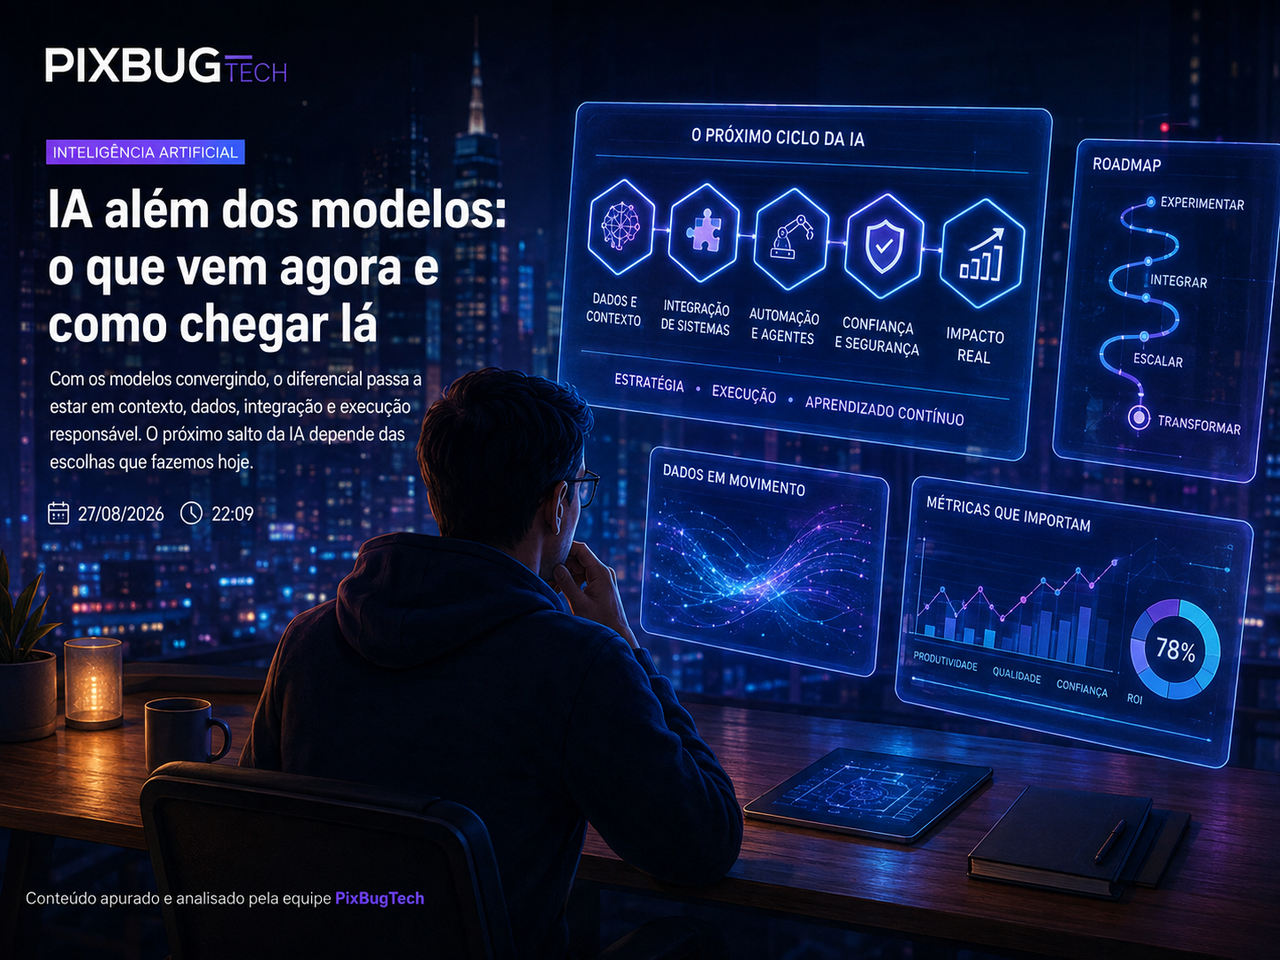
Modelos de IA estão convergindo e a disputa agora passa por dados, contexto e execução
Durante boa parte da corrida recente da inteligência artificial, a decisão parecia começar pelo nome do modelo.
Empresas comparavam GPT, Claude, Gemini, Grok, DeepSeek e outros sistemas como se a escolha do motor, sozinha, determinasse o desempenho de toda a aplicação.
Em 2026, essa lógica começa a perder força. Não porque os modelos tenham se tornado iguais, mas porque vários dos sistemas de fronteira passaram a ocupar uma faixa muito mais estreita de desempenho em avaliações gerais.
O AI Index 2026, da Universidade Stanford, ajuda a dimensionar a mudança. No recorte de março deste ano, os quatro primeiros sistemas avaliados pelo Arena Leaderboard estavam separados por menos de 25 pontos Elo. Em 2023, a distância entre o líder e um dos principais concorrentes era muito maior. O mesmo relatório registrou avanço de cerca de 30 pontos percentuais em apenas um ano no Humanity’s Last Exam, benchmark desenhado para desafiar sistemas avançados.
Há uma correção importante aqui: esses 30 pontos não significam que todos os modelos melhoraram 30 pontos em todos os testes, nem que a diferença entre eles desapareceu. O número se refere a uma avaliação específica. A conclusão mais responsável é outra: a fronteira continua avançando e, em diversos benchmarks, os líderes estão suficientemente próximos para que outras variáveis ganhem muito mais peso na decisão tecnológica.
É aí que a disputa muda de lugar.
Escolher o modelo continua importante — só não resolve mais o problema inteiro
A pauta que deu origem a esta análise parte de um artigo contribuído publicado pela The Next Web, e não de uma reportagem produzida pela redação do veículo. A tese apresentada é que dados e infraestrutura passam a ser o principal diferencial conforme os modelos convergem.
A direção do argumento faz sentido. A formulação absoluta, não.
Modelos ainda diferem em raciocínio, programação, multimodalidade, latência, preço, tamanho da janela de contexto, capacidade de usar ferramentas, disponibilidade local, política de dados, transparência e resistência a determinados tipos de ataque. Mesmo quando dois sistemas obtêm pontuações semelhantes em um ranking agregado, podem se comportar de maneira bem diferente diante de código legado, contratos jurídicos, imagens médicas, idiomas menos representados ou tarefas longas que exigem dezenas de decisões consecutivas.
O que mudou é que a escolha do modelo deixou de ser uma resposta suficiente.
Quando uma aplicação de IA entra em produção, o desempenho passa a depender de um sistema inteiro ao redor do modelo: instruções, documentos recuperados, histórico da tarefa, permissões, ferramentas externas, APIs, bancos de dados, mecanismos de busca, validação, observabilidade e regras para decidir quando a máquina pode agir sozinha.
Em outras palavras, o modelo virou uma peça crítica de uma arquitetura maior.
Da engenharia de prompt para a engenharia de contexto
Essa mudança ajuda a explicar por que a chamada engenharia de contexto ganhou espaço.
Um modelo de linguagem não consulta automaticamente tudo o que uma empresa sabe. No momento da inferência, ele recebe um conjunto limitado de informações. Esse conjunto pode incluir a instrução do sistema, a pergunta do usuário, mensagens anteriores, documentos recuperados de uma base, resultados de buscas, respostas de ferramentas, dados de sistemas internos e informações produzidas durante as etapas anteriores do próprio agente.
Organizar esse material é engenharia de contexto.
Uma das técnicas mais usadas é a geração aumentada por recuperação, ou RAG. Em vez de pedir que o modelo responda apenas com o conhecimento armazenado em seus parâmetros, o sistema procura trechos relevantes em documentos externos e os envia junto com a solicitação. Isso pode ser feito sobre manuais internos, contratos, bases jurídicas, catálogos, chamados de suporte ou páginas previamente indexadas.
O princípio parece simples, mas a qualidade da resposta depende de uma cadeia inteira.
É preciso encontrar o documento correto, selecionar o trecho correto, preservar a data e a origem, evitar duplicações, resolver contradições e entregar tudo dentro do limite de contexto disponível. Recuperar dez documentos irrelevantes não produz um modelo dez vezes mais informado. Muitas vezes produz apenas uma resposta mais cara e mais confusa.
Esse detalhe derruba outra simplificação comum: mais dados não significam necessariamente melhor IA.
O que importa é contexto relevante, confiável, atual e rastreável.
Dados em tempo real resolvem um problema — e criam vários outros
Para agentes que acompanham preços, estoques, legislação, notícias, mercados, disponibilidade de produtos ou movimentação de concorrentes, uma base atualizada ontem pode ser velha demais.
Um índice de busca tradicional funciona como uma grande representação do que foi encontrado durante processos anteriores de rastreamento. Ele é excelente para localizar informação, mas nunca corresponde perfeitamente ao estado instantâneo da internet. Quanto mais dinâmica a tarefa, maior a necessidade de combinar informação previamente indexada com consultas feitas no momento da execução.
Essa arquitetura pode reduzir respostas baseadas em dados obsoletos. Ela não elimina alucinações.
Erros também podem surgir porque o modelo interpretou mal uma informação correta, porque uma ferramenta retornou o valor errado, porque duas fontes confiáveis discordam, porque o mecanismo de recuperação selecionou o documento inadequado ou porque uma sequência longa de ações acumulou pequenos erros até produzir uma conclusão incorreta.
Por isso, atribuir erros confiantes principalmente a “dados antigos” seria simplificar demais um problema sistêmico.
Um agente bom precisa saber mais do que buscar informação. Precisa identificar quando não sabe, comparar fontes, manter rastreabilidade, reconhecer conflito, respeitar permissões e interromper uma ação quando a confiança não é suficiente.
A diferença entre um chatbot errado e um agente errado também é prática.
O chatbot pode escrever uma resposta ruim. O agente pode enviar o e-mail errado, atualizar um registro, executar código, alterar uma reserva, movimentar um fluxo de compras ou alimentar outro sistema com a informação equivocada.
A adoção cresceu mais rápido que o retorno financeiro
Os números mais recentes ajudam a explicar por que as empresas estão olhando além do modelo.
A pesquisa global da McKinsey publicada em 25 de agosto de 2026 mostra que quase nove em cada dez participantes trabalham em organizações que já utilizam IA regularmente em pelo menos uma função. A parcela das empresas que afirma estar escalando IA em toda a organização subiu de 38% para 44% em um ano.
A distância entre adoção e resultado, porém, continua grande.
Apenas cerca de 6% dos entrevistados pertencem ao grupo que a consultoria classifica como de alto desempenho em IA: organizações que associam a tecnologia a pelo menos 5% de impacto sobre o EBIT e também relatam valor significativo. Esse percentual ficou praticamente parado em relação a 2025.
O dado é especialmente interessante porque elimina uma explicação confortável. O problema já não pode ser resumido à falta de acesso à tecnologia.
Empresas têm modelos. Têm copilotos. Têm APIs. Têm projetos pilotos.
O desafio é transformar isso em processo econômico confiável.
As organizações classificadas como de alto desempenho não aparecem apenas usando modelos melhores. Segundo a pesquisa, elas são muito mais propensas a redesenhar os próprios fluxos de trabalho, adotar IA em mais funções, medir resultados, gerir riscos e conectar a tecnologia a objetivos de crescimento e inovação, em vez de tratá-la exclusivamente como ferramenta de corte de custos.
É uma mudança aparentemente administrativa, mas profundamente técnica.
Automatizar um processo ruim apenas permite executar um processo ruim em maior velocidade.
Agentes tornam o custo invisível muito mais importante
A próxima etapa aumenta ainda mais essa pressão.
Um chatbot tradicional pode receber uma pergunta e produzir uma resposta com uma ou poucas chamadas ao modelo. Um agente complexo pode pesquisar, recuperar documentos, classificar resultados, chamar ferramentas, verificar uma resposta, corrigir uma etapa e repetir parte do processo antes de entregar o resultado.
Cada passo consome recursos.
Isso significa que queda no preço individual de um token não garante queda no custo da tarefa completa. O agente pode usar modelos menores em algumas etapas e sistemas mais caros em outras, executar buscas externas, manter memória, reprocessar contexto e realizar várias inferências para concluir uma única ação.
Em agosto de 2026, a Gartner projetou que o custo de inferência por fluxo de trabalho agêntico pode crescer mais de cinco vezes até 2028. É uma previsão, não um fato consumado, mas aponta para uma métrica que tende a se tornar muito mais relevante: custo por tarefa concluída corretamente.
Essa é uma medida melhor do que preço por milhão de tokens.
Se um modelo mais barato precisa de oito tentativas para concluir uma tarefa que outro termina corretamente em duas, a comparação de tabela perde boa parte do sentido. Da mesma forma, um agente aparentemente caro pode ser economicamente superior se reduzir retrabalho, intervenção humana e taxa de erro.
A corrida deixa de ser apenas por inteligência bruta e passa a envolver eficiência operacional.
A web para agentes não será simplesmente a web que humanos usam hoje
Existe outra consequência menos discutida.
A internet atual foi construída em torno de pessoas navegando por páginas, clicando em resultados, interpretando layouts e consumindo conteúdo dentro de interfaces. Agentes não precisam necessariamente dessa sequência.
Para uma máquina, título, botão chamativo e página visualmente elegante podem importar menos do que estrutura, proveniência, data, formato consistente e possibilidade de recuperar diretamente a informação necessária.
Isso cria incentivo para uma nova camada de serviços: índices preparados para consumo por modelos, APIs de pesquisa, bases estruturadas, ferramentas de recuperação, conectores empresariais e mecanismos capazes de fornecer conteúdo já acompanhado de origem e metadados.
Mas essa mudança mexe também com a economia da própria web.
Se agentes passarem a consumir informação sem encaminhar o usuário à página original, veículos, fóruns, lojas, enciclopédias e produtores independentes podem fornecer parte do combustível sem receber o tráfego que sustentava o modelo anterior. Licenciamento, remuneração, controle de rastreamento e atribuição deixam de ser detalhes jurídicos periféricos e passam a fazer parte da arquitetura econômica da IA.
A batalha pela próxima geração de inteligência artificial pode, portanto, deslocar poder dos fabricantes de modelos para quem controla acesso, indexação e distribuição dos dados — sem necessariamente reduzir a concentração.
Ela apenas muda de camada.
Quanto mais o agente enxerga, maior a superfície de ataque
Dar acesso a mais informação também amplia riscos de segurança.
Um agente conectado à internet, e-mail, arquivos corporativos e ferramentas internas passa a processar conteúdo que a organização não controla integralmente. Uma página, documento ou mensagem pode conter instruções maliciosas destinadas não ao usuário humano, mas ao próprio modelo.
Esse tipo de ataque é conhecido como injeção indireta de prompt.
Em 2026, tanto o Centro de Padrões e Inovação em IA do NIST quanto laboratórios que desenvolvem agentes passaram a tratar esse problema como um desafio concreto de segurança. O mecanismo é particularmente incômodo porque a informação necessária para concluir a tarefa e a instrução maliciosa podem chegar pelo mesmo canal.
O agente precisa ler conteúdo externo para trabalhar. O atacante tenta transformar justamente esse conteúdo em comando.
A solução não é simplesmente “usar um modelo mais inteligente”.
Sistemas seguros precisam combinar controles de permissão, isolamento de execução, credenciais limitadas, validação de ferramentas, separação entre leitura e escrita, confirmação humana para ações sensíveis e registros que permitam reconstruir o que o agente consultou e por que tomou determinada decisão.
Essa é outra razão pela qual a infraestrutura passa a importar tanto quanto o modelo.
Quem ganha primeiro — e quem pode ficar para trás
Grandes empresas tendem a perceber essa transição antes porque já possuem volumes elevados de dados, equipes de plataforma, sistemas de identidade, observabilidade e orçamento para integração.
A mesma pesquisa da McKinsey mostra que 40% dos entrevistados em organizações com receita anual superior a US$ 1 bilhão relatam estar escalando agentes de IA, contra 22% nas organizações menores. O avanço está concentrado especialmente em tecnologia da informação, gestão do conhecimento e engenharia de software.
Isso cria uma ironia importante.
Modelos mais acessíveis podem democratizar a capacidade básica de IA ao mesmo tempo em que infraestrutura, dados proprietários e integração empresarial recriam uma vantagem de escala para organizações maiores.
Uma pequena empresa pode acessar um modelo de fronteira pela mesma API usada por uma multinacional. Ela não possui necessariamente os mesmos vinte anos de histórico operacional organizado, os mesmos sistemas internos, a mesma capacidade de medir resultados ou a mesma equipe para controlar segurança e governança.
O modelo pode ser alugado.
O contexto acumulado pela organização, não.
O modelo aberto também entra nessa equação
A convergência não elimina a discussão entre modelos abertos e fechados.
O próprio AI Index mostra que a diferença de desempenho voltou a crescer depois de ter se estreitado em 2024. No recorte de março de 2026, o melhor modelo fechado mantinha vantagem de 3,3% sobre o melhor modelo aberto na comparação usada pelo relatório.
É uma distância pequena o bastante para tornar alternativas abertas competitivas em várias aplicações, mas grande demais para sustentar a tese de equivalência total.
Para organizações que priorizam execução local, soberania sobre dados, customização ou redução de dependência de um fornecedor, modelos abertos podem compensar uma pequena perda de desempenho bruto. Para outras, a confiabilidade ou a capacidade de um sistema fechado em uma tarefa específica pode justificar o custo e a dependência externa.
Esse cálculo fica mais sofisticado conforme o modelo deixa de concentrar todo o valor.
Uma empresa pode trocar o modelo mantendo sua camada de contexto, ferramentas, avaliações e dados. Essa portabilidade, quando realmente alcançada, reduz dependência tecnológica e aumenta poder de negociação com fornecedores.
Não por acaso, uma boa arquitetura de IA começa a parecer menos com a compra de um produto e mais com a construção de uma plataforma.
Análise da equipe: a vantagem competitiva está descendo uma camada
A PixBugTech considera correta a percepção de que a corrida da IA está migrando do modelo isolado para o sistema que o cerca.
Mas é cedo para declarar o modelo uma commodity.
Benchmarks gerais estão convergindo, enquanto diferenças importantes continuam aparecendo em confiabilidade, segurança, especialização, custo, transparência e execução de tarefas longas. Ao mesmo tempo, a evidência empresarial mostra que simplesmente adotar IA não produz automaticamente retorno financeiro.
A variável estratégica passa a ser a composição.
Modelo adequado, dados adequados, contexto correto, ferramentas limitadas ao necessário, avaliações contínuas, segurança por desenho e um processo empresarial que realmente faça sentido automatizar.
A parte menos glamourosa da IA começa a decidir a parte mais importante do resultado.
Banco de dados bem mantido, identidade, logs, classificação de documentos, política de acesso, integração de sistemas e qualidade da informação nunca renderam tantas demonstrações de palco quanto um novo modelo. Em produção, porém, são essas camadas que separam uma resposta impressionante de um sistema confiável.
E há um risco adicional: a nova infraestrutura pode concentrar poder tanto quanto a antiga.
O AI Index registra forte concentração da capacidade computacional, dos chips avançados e dos grandes centros de dados. Se a próxima camada também ficar concentrada em poucos provedores de índices, conectores, dados e execução, a troca de dependência do “modelo dominante” por dependência da “infraestrutura dominante” não será exatamente uma revolução de autonomia.
Será apenas uma mudança de endereço.
O que deve ser acompanhado agora
A próxima fase da inteligência artificial será melhor medida fora das demonstrações.
Taxa de conclusão de tarefas, custo por resultado correto, quantidade de intervenções humanas, atualização das fontes, capacidade de identificar conflito entre documentos, rastreabilidade, incidentes de segurança e impacto financeiro real dizem mais sobre maturidade do que a posição isolada de um modelo em um ranking.
Também será importante observar se os agentes conseguem manter desempenho quando deixam ambientes controlados e entram no mundo desorganizado de sistemas antigos, permissões imperfeitas, páginas dinâmicas, documentos contraditórios e usuários que não escrevem prompts cuidadosamente preparados.
A disputa pelos modelos continua.
Só que, pela primeira vez desde a explosão da IA generativa, ela já não explica sozinha para onde a tecnologia está indo.
A próxima vantagem provavelmente estará em quem conseguir ligar bons modelos a informação confiável, atual e autorizada, transformar esse contexto em ações verificáveis e fazer tudo isso por um custo que sobreviva quando o projeto deixar o laboratório e chegar à conta do mês.
👉 Dúvida? Então veja mais em: https://pixbugtech.com/linksuteis