noticias
Gemini Spark chega ao Brasil e transforma o Google em um agente que trabalha enquanto você está offline
**Categoria editorial:** Inteligência Artificial, Software e Automação
Gemini Spark chega ao Brasil e transforma o Google em um agente que trabalha enquanto você está offline
**Linha fina:** O novo modo agêntico consegue pesquisar, navegar, organizar arquivos e executar tarefas recorrentes usando dados do ecossistema Google. A novidade é poderosa justamente porque recebe acessos que um chatbot comum nunca teve.
**Meta description:** Gemini Spark chega ao Brasil como agente autônomo do Google, executando tarefas, navegando na web e usando Gmail, Drive e outros serviços.
**Slug amigável:** gemini-spark-brasil-agente-ia-google-automacao
**Palavra-chave principal:** Gemini Spark no Brasil
**Editoria:** Inteligência Artificial
**Autor:** Redação PixBugTech
**Data:** 8 de agosto de 2026
Existe uma diferença enorme entre uma inteligência artificial que responde “como posso ajudá-lo?” e outra que recebe uma tarefa na sexta-feira, continua trabalhando enquanto o computador está fechado e reaparece depois com o serviço executado.
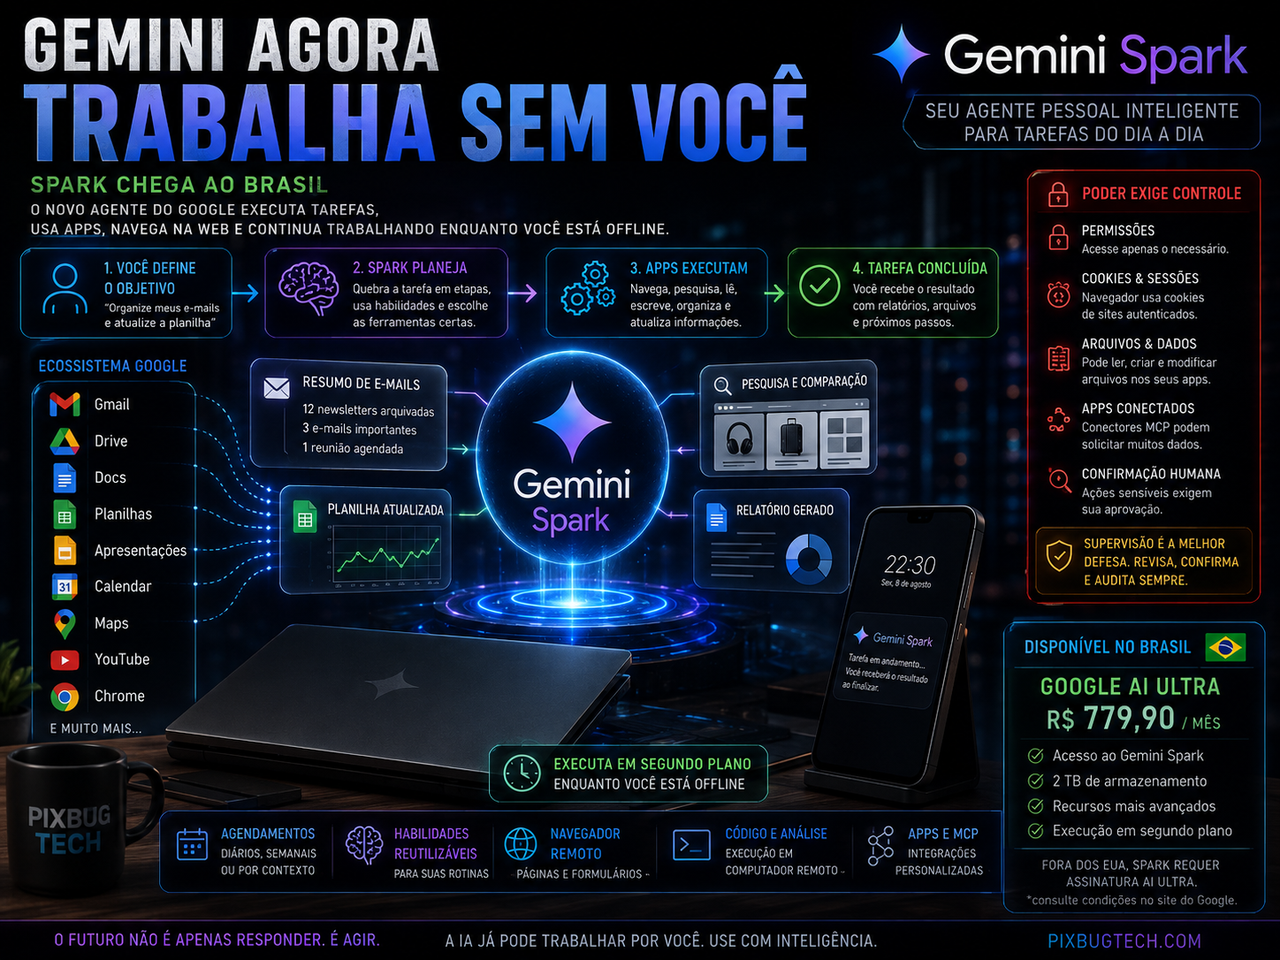
O **Gemini Spark**, novo agente pessoal do Google que começou a ser liberado internacionalmente e já pode ser utilizado no Brasil por assinantes elegíveis, pertence à segunda categoria. Ele foi desenhado para executar fluxos de várias etapas, utilizar serviços conectados, navegar por páginas, trabalhar com arquivos e manter tarefas programadas sem depender de uma conversa permanentemente aberta. A documentação oficial do Google define o produto como um agente capaz de gerenciar tarefas contínuas utilizando informações de aplicativos conectados, conversas, localização, sites autenticados, habilidades e outros elementos do ecossistema Gemini.
Não é simplesmente outro botão dentro do Gemini.
É uma mudança de arquitetura.
Até agora, o modelo dominante da IA generativa era bastante familiar. O usuário escrevia alguma coisa, o servidor processava, uma resposta aparecia e a conversa terminava até o próximo comando.
O Spark introduz outro loop:
**objetivo → planejamento → ferramentas → execução → verificação → próxima etapa.**
Esse pequeno deslocamento transforma o Gemini de software que produz respostas em software que começa a operar outros softwares.
E, para a cultura geek, talvez seja exatamente aí que a história da inteligência artificial fique mais interessante e consideravelmente mais perigosa.
O chatbot espera prompt. O Spark espera trabalho
A melhor maneira de compreender o Spark é deixar de imaginá-lo como uma versão mais inteligente da caixa de conversa.
O Google permite criar uma tarefa, definir quando ela deve ocorrer e deixar que o agente trabalhe sobre ela.
Uma rotina pode ser executada em horário determinado ou reagir a determinado contexto. O agente também mantém um painel mostrando etapas planejadas, etapa atual, ações concluídas e arquivos utilizados ou modificados. O usuário pode posteriormente alterar instruções, pausar agendamentos ou assumir a execução manualmente.
Isso aproxima o Gemini de ferramentas de automação tradicionais, mas existe uma diferença fundamental.
Num sistema clássico, alguém desenha explicitamente:
`SE chegar email X → extrair Y → colocar na planilha Z`.
O agente recebe algo mais próximo de:
“Organize minhas confirmações de viagem e mantenha uma planilha atualizada.”
Ele precisa descobrir parte do caminho.
É a diferença entre escrever a automação e explicar o resultado desejado.
O Google encontrou o lugar perfeito para lançar um agente: dentro do próprio Google
Existem poucas empresas com uma vantagem tão óbvia para construir esse tipo de produto.
Google controla:
Gmail;
Drive;
Docs;
Planilhas;
Apresentações;
Agenda;
Maps;
Pesquisa;
Chrome;
Android;
YouTube;
e uma quantidade quase constrangedora de informações relacionadas à vida digital do usuário.
Um agente isolado precisa pedir integrações.
O Gemini já está sentado ao lado dos dados.
É justamente isso que pode tornar o Spark muito mais útil que uma automação genérica.
Ele pode receber informações de aplicativos conectados, utilizar conversas anteriores, trabalhar com dados da chamada Inteligência Personalizada, consultar localização e interagir com sites nos quais o usuário está autenticado.
A vantagem competitiva aqui não é apenas ter um bom modelo.
É possuir o **contexto**.
Uma caixa de entrada pode finalmente deixar de ser um depósito arqueológico
O próprio Google apresenta organização de e-mail como um dos casos mais simples.
Spark pode identificar newsletters, resumir mensagens, arquivar conteúdo e cancelar inscrições. Também pode produzir resumos recorrentes de notícias ou realizar pesquisas mais profundas e estruturadas.
Isso parece pouco revolucionário.
Talvez justamente por isso tenha valor.
Grande parte do trabalho diário não exige uma superinteligência capaz de provar teoremas. Exige alguém disposto a executar cem tarefas pequenas e irritantes sem esquecer metade delas.
Verificar mensagens.
Atualizar documento.
Copiar informação.
Comparar preço.
Organizar arquivo.
Pesquisar opções.
Preparar resumo.
Criar lembrete.
O software tradicional automatizou tarefas previsíveis durante décadas.
Agentes tentam automatizar tarefas que possuem pequenas doses de interpretação no meio.
Esse é um mercado enorme.
Não porque o trabalho seja intelectualmente extraordinário.
Porque ninguém queria fazê-lo.
Spark também ganhou um navegador para chamar de seu
Uma das capacidades mais relevantes está no navegador remoto.
O agente pode abrir páginas e interagir com sites durante uma tarefa. O Google cita situações como adicionar produtos ao carrinho e permite que o usuário acompanhe a navegação ou assuma manualmente o controle quando necessário.
Isso muda bastante o limite operacional da IA.
Um chatbot consegue dizer:
“Entre no site e clique em Reservar.”
Um agente com navegador consegue entrar no site.
É uma diferença de um verbo.
É também praticamente toda a diferença entre assistência e automação.
O Google já demonstra o Spark em cenários de pesquisa de produtos, planejamento, viagens e preenchimento de formulários, enquanto mantém determinadas decisões sensíveis sob confirmação do usuário. Testes independentes recentes também relatam funcionamento semelhante para comparação de compras e formulários, com interrupção antes de compras ou envios finais.
Esse mecanismo de confirmação será uma das peças mais importantes do produto.
Porque agente útil precisa poder fazer coisas.
Agente seguro precisa saber quando parar.
O problema é que navegar logado significa carregar as chaves da casa
Aqui começa a parte menos confortável.
Para interagir com páginas autenticadas, o navegador remoto precisa manter estado.
E estado significa cookies.
A Central de Privacidade do Gemini informa explicitamente que o navegador remoto do Spark pode tratar cookies contendo informações de autenticação, conteúdo das páginas e outros dados da sessão. Esses dados podem ser mantidos para permitir sessões futuras, embora o usuário possa excluí-los nas configurações.
Isso não significa que o Google esteja entregando a senha do usuário ao modelo.
Significa algo mais estruturalmente interessante.
O agente passa a operar num navegador que já possui autoridade concedida.
É quase como fornecer uma sessão aberta para um funcionário digital.
Ele não precisa conhecer a senha do sistema.
O navegador já está autenticado.
Em segurança, possuir uma sessão válida costuma ser suficiente para fazer bastante coisa.
Por isso, controles de escopo passam a importar tanto quanto inteligência.
O próprio Google diz para não confiar demais
Talvez uma das partes mais reveladoras da documentação esteja nos avisos.
O Google recomenda **não inserir senhas, dados de pagamento ou outras informações sensíveis diretamente na conversa da tarefa**. Também orienta os usuários a evitar agendar ações consideradas sensíveis porque o Gemini “ainda está aprendendo e pode cometer erros”.
Há um alerta ainda mais interessante.
Quando determinada tarefa programada é executada enquanto o usuário está offline, pode não ser possível impedir uma ação não intencional antes que ela termine. Algumas operações exigem confirmação, mas não necessariamente todas.
Essa frase resume um dos problemas fundamentais dos agentes.
Chatbots erram na sua frente.
Agentes podem errar enquanto você dorme.
“Funciona enquanto você dorme” é ao mesmo tempo propaganda e modelo de ameaça
A ideia é ótima para marketing.
Você passa uma tarefa antes de dormir.
Ao acordar, está pronta.
Do ponto de vista de segurança, exatamente a mesma frase pode ser escrita assim:
**software com permissões continua executando decisões sem supervisão humana ativa.**
O produto não se torna ruim por causa disso.
Cron jobs fazem trabalhos automáticos há décadas.
Servidores executam rotinas durante toda a madrugada.
A diferença é que essas automações tradicionalmente seguem regras relativamente determinísticas.
Um agente utiliza interpretação probabilística para decidir etapas intermediárias.
Essa nova camada exige mecanismos que administradores de sistemas conhecem muito bem:
permissões mínimas;
logs;
auditoria;
limites;
confirmações;
rollback;
isolamento.
Talvez a grande revolução dos agentes acabe exigindo que o Vale do Silício redescubra metade do manual de administração Unix.
Spark começa a desenvolver algo parecido com scripts em linguagem natural
Outro elemento importante são as chamadas **habilidades**.
O usuário pode salvar conjuntos de instruções para que o Spark os reutilize em diferentes tarefas. O agente pode identificar automaticamente quando uma habilidade é relevante ou combinar várias delas dentro de um fluxo de trabalho.
Isso é muito interessante porque transforma prompts descartáveis em algo semelhante a componentes reutilizáveis.
Imagine uma habilidade:
“Quando preparar relatório financeiro, utilize este formato, estas categorias, esta planilha e estas regras.”
Outra:
“Quando pesquisar uma pauta, priorize estas fontes e produza este tipo de resumo.”
O usuário deixa de ensinar o procedimento toda vez.
Configura comportamento.
É quase programação declarativa para quem nunca escreveu uma linha de código.
A pessoa descreve políticas.
O agente executa.
E agora chegamos ao MCP
O Spark também aceita **aplicativos conectados personalizados**, incluindo integrações baseadas em Model Context Protocol, o MCP que se tornou uma das camadas mais importantes da nova infraestrutura de agentes.
Aqui a história deixa de ser apenas Google Workspace.
Um servidor MCP pode oferecer ao agente ferramentas externas.
Banco de dados.
Sistema corporativo.
Aplicativo próprio.
Serviço interno.
API especializada.
O resultado é um Gemini capaz de atravessar fronteiras entre ecossistemas.
O Google, porém, faz um alerta bastante explícito: servidores MCP externos não são controlados ou protegidos pela empresa e podem solicitar dados excessivos. Informações provenientes de conversas, apps conectados, inteligência personalizada, habilidades, tarefas e páginas autenticadas podem ser compartilhadas quando necessárias para utilizar esses serviços.
Atualmente, segundo a documentação, operações de escrita envolvendo esses aplicativos personalizados exigem confirmação manual.
É uma boa trava.
Também mostra por que conectores serão provavelmente uma das maiores superfícies de ataque da era dos agentes.
Um plugin ruim era inconveniente. Um agente conectado a um plugin ruim pode ser outra história
Pense no modelo de ameaça.
O usuário confia no Gemini.
Gemini confia numa ferramenta.
A ferramenta conversa com um servidor externo.
O servidor pede determinada informação.
O agente possui acesso a diversas fontes.
A cadeia de confiança cresceu.
É o velho problema de dependências de software, agora aplicado a contexto pessoal.
Um pacote malicioso instalado num projeto pode roubar credenciais.
Um conector malicioso num agente pode tentar convencer o modelo de que precisa de informações que jamais deveriam sair dali.
Esse tipo de problema será cada vez mais importante.
A segurança não dependerá apenas do modelo.
Dependerá do **grafo de permissões ao redor dele**.
No Mac, o Spark chega ainda mais perto do sistema operacional
A versão para macOS amplia novamente o escopo.
O Google anunciou em junho que o Spark poderia organizar pastas, utilizar arquivos locais para produzir documentos e conduzir workflows no Google Workspace diretamente a partir do aplicativo para Mac. A empresa também prepara controle remoto dessas tarefas a partir de outros dispositivos.
Isso é um passo importante.
A IA deixa de estar presa à nuvem e ao navegador.
Começa a administrar arquivos do computador.
Para produtividade, excelente.
Para segurança, precisamos perguntar:
quais diretórios?
quais arquivos?
qual histórico?
qual limite?
qual confirmação?
O princípio do menor privilégio nunca ficou tão atual.
Um agente que precisa organizar a pasta Downloads não precisa necessariamente ganhar licença filosófica para explorar todo o SSD.
Existe ainda um computador remoto que executa código
A documentação do Google menciona uma segunda camada: o Spark pode utilizar um computador remoto para executar códigos ou tarefas complexas.
Dados desse ambiente podem ser salvos para sessões posteriores, e o usuário possui uma opção específica para excluir arquivos e informações mantidas durante a execução remota.
Aqui o Spark começa a parecer menos com um chatbot e mais com uma infraestrutura computacional pessoal.
Navegador remoto.
Ambiente de execução.
Arquivos.
Apps.
Agendamentos.
Skills.
Conectores.
É praticamente um pequeno sistema operacional de tarefas construído ao redor de um modelo.
Essa talvez seja uma leitura muito mais adequada que “novo recurso do Gemini”.
Só que há uma correção importante sobre a disponibilidade no Brasil
A publicação brasileira que chamou atenção para o lançamento afirma que o Spark chega ao país para assinantes **Google AI Pro e AI Ultra**, citando preços de R$ 96,99 e R$ 779,90.
A documentação oficial atual do Google, porém, estabelece uma condição diferente.
Nos Estados Unidos, Spark está disponível para assinantes **AI Pro ou AI Ultra**.
Nos demais países compatíveis o que inclui o Brasil a página de suporte informa que é necessário possuir **Google AI Ultra**. Também exige idade mínima de 18 anos, Conta Google pessoal e a opção **Manter Atividade** ativada. Contas escolares ou corporativas não são elegíveis atualmente.
Portanto, **não encontramos base oficial para afirmar neste momento que o AI Pro brasileiro tenha acesso regular garantido ao Spark**.
O Google pode ampliar a liberação posteriormente, usuários podem aparecer em experimentos diferentes durante um rollout e páginas da própria empresa nem sempre são atualizadas simultaneamente. Mas, para publicação, a referência mais segura é a documentação específica do produto.
E ela diz: fora dos Estados Unidos, Ultra.
Isso torna o Spark um brinquedo caro no Brasil
A página brasileira de assinaturas do Gemini informa atualmente que o **Google AI Ultra parte de R$ 779,90 por mês**, com uma opção superior de R$ 999,90.
O AI Pro custa R$ 96,99 mensais, mas, pelas regras específicas do Spark, não garante atualmente o agente no Brasil.
R$ 779,90 muda completamente a análise.
Para o usuário que quer simplesmente um assistente melhor, é difícil justificar esse valor apenas pelo Spark.
Para um profissional ou empresa individual que consiga delegar horas reais de trabalho todo mês, a conta pode começar a ficar interessante.
Esse é o ponto central da economia dos agentes.
Não se pergunta apenas:
“É uma IA melhor?”
Pergunta-se:
**“Quantas horas minhas ela realmente substitui?”**
R$ 779,90 por mês obrigam o agente a trabalhar bastante
Faça a conta conceitualmente.
Se o Spark economiza quinze minutos por mês, temos o gadget digital mais caro desde aquele mouse gamer comprado para jogar Solitaire.
Se economiza vinte horas mensais de trabalho repetitivo, a conversa muda.
Agentes serão avaliados progressivamente por **retorno operacional**, não por inteligência percebida.
Quantos emails deixou de organizar?
Quantas planilhas deixou de atualizar manualmente?
Quantas pesquisas realizou?
Quantos relatórios preparou?
Quantas tarefas concluiu corretamente sem exigir correção?
O benchmark que importa para o mercado profissional poderá acabar sendo bem menos emocionante que MMLU ou GPQA.
Talvez seja:
**horas poupadas por R$ 100.**
O problema é que um erro de agente pode consumir todas as horas que economizou
Autonomia tem uma característica cruel.
Quando funciona, escala produtividade.
Quando falha, também escala o erro.
Um agente pode classificar cinquenta mensagens corretamente em segundos.
Pode também classificar cinquenta mensagens incorretamente em segundos.
Atualizar dezenas de linhas.
Mover dezenas de arquivos.
Enviar informações para o lugar errado.
Essa é a razão pela qual observabilidade é indispensável.
O painel do Spark mostra progresso, arquivos utilizados e atividades realizadas. Isso é uma boa base.
Mas agentes maduros precisarão provavelmente de algo ainda mais próximo de controle de versão.
O que mudou?
Quem mudou?
Por quê?
Como desfazer?
Software já resolveu parte desse problema décadas atrás.
Talvez o próximo grande recurso de IA seja um `Ctrl+Z` realmente confiável.
“Manter Atividade” obrigatório também merece atenção
Para utilizar Spark, o Google exige que o usuário mantenha ativada a opção **Manter Atividade**.
Isso não é um detalhe burocrático.
Um agente pessoal precisa de contexto para trabalhar de maneira útil.
Contexto significa histórico.
Histórico significa dados.
A Central de Privacidade informa que Spark pode processar informações de tarefas, agendas, habilidades, navegador remoto, computador remoto, apps conectados, inteligência personalizada e sites utilizados durante a execução.
Quanto mais contexto recebe, melhor pode funcionar.
Quanto mais contexto recebe, maior se torna o impacto de uma configuração ruim, conector problemático ou política de retenção inadequada.
É a equação central da IA pessoal:
**utilidade cresce com contexto; risco também.**
O Google possui uma vantagem que a OpenAI e a Anthropic adorariam ter
A disputa dos agentes não será vencida apenas pelo melhor modelo.
Será vencida por quem possuir as melhores ferramentas e o contexto mais útil.
Google começa com vantagem absurda porque milhões de usuários já organizaram suas vidas dentro de seus serviços.
Agenda sabe onde você precisa estar.
Gmail sabe quem escreveu.
Drive possui documentos.
Maps sabe locais.
Chrome possui sessões.
YouTube conhece interesses.
Gemini consegue conectar parte desse universo.
Isso transforma uma empresa que durante décadas organizou informações em algo potencialmente diferente:
uma empresa capaz de **agir utilizando essas informações**.
É uma mudança enorme de posição.
Google Search encontrava.
Google Assistant respondia.
Gemini Spark executa.
E isso explica por que agentes podem ameaçar os próprios aplicativos
Existe uma consequência curiosa.
Se o agente realmente ficar bom, talvez o usuário abra menos aplicativos.
Em vez de:
Gmail → pesquisar mensagens → copiar dados → abrir Sheets → atualizar tabela → abrir Calendar → criar evento,
ele pede:
“Organize as confirmações dessa viagem e atualize tudo.”
Spark decide quais aplicações utilizar.
A interface deixa de ser o aplicativo.
A interface passa a ser a **intenção**.
Isso ameaça um paradigma que domina computadores desde os anos 1980.
Nós aprendemos qual programa abrir para realizar determinada tarefa.
Agentes tentam inverter a relação:
diga o que quer.
O computador descobre o programa.
O app pode virar implementação
Esse é um dos cenários mais interessantes da computação agentiva.
Hoje pensamos:
“Preciso abrir o Excel.”
No futuro:
“Preciso entender meus gastos.”
A planilha pode continuar existindo.
Mas talvez o usuário nunca abra diretamente sua interface.
O agente abre.
Consulta.
Modifica.
Fecha.
Aplicativos tornam-se infraestrutura.
É algo semelhante ao que aconteceu com diversos serviços de internet.
Usuários não precisam compreender qual API foi chamada quando pedem um carro num aplicativo.
Agentes podem levar essa abstração para softwares pessoais.
Para quem desenvolve aplicações, isso muda a importância da interface.
Sua próxima cliente talvez não seja uma pessoa.
Pode ser outro software.
O risco de concentração também cresce
Há uma consequência menos confortável.
Quanto mais um agente consegue operar dentro de um ecossistema, maior o incentivo para permanecer nele.
Se Gmail, Drive, Agenda, Maps e Gemini funcionam melhor juntos, trocar uma única peça pode custar automações inteiras.
Isso fortalece o tradicional **vendor lock-in**.
Só que numa camada nova.
Antes, o usuário ficava preso porque seus arquivos estavam num formato ou sua empresa utilizava determinada cloud.
Agora pode ficar preso porque o agente **aprendeu sua rotina dentro daquele ecossistema**.
Chamemos isso de lock-in comportamental.
Migrar dados é relativamente simples.
Migrar anos de automações, contexto, habilidades e hábitos pode não ser.
Pequenas empresas podem ser as grandes beneficiárias — quando o preço cair
Existe um potencial enorme para negócios que nunca tiveram equipe de automação.
Uma pequena empresa pode não possuir desenvolvedor para integrar sistemas.
Mas seu proprietário consegue dizer:
“Todas as manhãs verifique estes emails, atualize a planilha, identifique pagamentos atrasados e prepare um resumo.”
Esse tipo de automação tradicionalmente exigiria scripts, ferramentas no-code ou contratação especializada.
Agentes diminuem a barreira.
O problema atual é econômico.
R$ 779,90 mensais ainda coloca a experiência completa do Spark numa camada premium no Brasil.
Se as capacidades migrarem progressivamente para planos mais baratos, a tecnologia pode chegar justamente às empresas nas quais algumas horas administrativas representam uma parcela importante do custo.
É aí que agentes deixam de ser demonstração e começam a virar infraestrutura de trabalho.
Profissões administrativas sentirão primeiro
A discussão sobre IA e empregos costuma procurar profissões inteiras que desaparecerão.
Talvez o efeito real seja granular.
Uma tarefa some.
Depois outra.
Depois outra.
Organizar caixa de entrada.
Preparar relatório.
Pesquisar preços.
Atualizar documento.
Consolidar informação.
Acompanhar reservas.
Criar resumo.
Nenhuma delas isoladamente constitui necessariamente um cargo.
Mas somadas formam grande parte do dia de milhões de trabalhadores.
O Spark mostra como automação pode entrar pela lateral.
Não substitui a pessoa numa terça-feira.
Substitui vinte minutos da terça-feira.
Depois mais quarenta.
Depois duas horas.
O impacto laboral pode aparecer na redução gradual da quantidade de pessoas necessárias para administrar o mesmo volume de trabalho.
O maior concorrente do Spark pode ser a velha automação determinística
Existe também uma possibilidade menos empolgante para fãs de IA.
Muitas tarefas não precisam de agente.
Se um fluxo é estável, previsível e crítico, uma automação tradicional pode ser mais barata, rápida e confiável.
“Quando chegar arquivo X, copie para pasta Y” não precisa de um modelo enorme raciocinando sobre sua existência.
Um cron job resolve.
Uma regra de e-mail resolve.
Um script resolve.
O agente faz sentido quando existe ambiguidade suficiente para justificar interpretação.
Essa distinção será importante para empresas.
Usar um agente para tudo é quase o equivalente de chamar um desenvolvedor sênior toda vez que você precisa renomear um arquivo.
Funciona.
A conta talvez não goste.
O que quase ninguém discute: agentes transformam erro em evento assíncrono
Há uma diferença conceitual importante entre sistemas atuais e agentes de fundo.
Quando uma aplicação tradicional falha, normalmente estamos utilizando-a.
Vemos o erro.
Quando uma IA responde errado, normalmente estamos olhando para a resposta.
Quando um agente executa tarefas assíncronas, a falha pode acontecer longe do usuário.
Isso cria uma necessidade de notificação e auditoria muito maior.
“Seu agente terminou.”
Ótimo.
Terminou o quê?
Mudou o quê?
Encontrou algum problema?
Precisou tomar uma decisão não prevista?
Usou qual dado?
Ignorou qual etapa?
A interface dos agentes precisará evoluir de conversa para **console de operações**.
É interessante que o Google já esteja exibindo etapas, arquivos e progresso.
Talvez a próxima geração pareça menos com ChatGPT e mais com painel de CI/CD.
Geek nenhum viu essa reviravolta chegando — ou talvez todos tenham visto.
O Spark é mais importante pelo paradigma do que pelas funções atuais
Organizar email não mudará a história da computação.
Atualizar planilha também não.
O importante é que essas tarefas demonstram uma nova arquitetura de interação.
O usuário fornece objetivo.
O sistema recebe ferramentas.
Planeja etapas.
Executa.
Mantém estado.
Retorna depois.
É o mesmo padrão que começa a aparecer em agentes de programação, pesquisa, compras e produtividade.
O Spark importa porque Google está colocando esse paradigma dentro de um ecossistema utilizado por bilhões de pessoas.
Se funcionar, agente deixa de ser produto para entusiastas.
Vira camada do computador.
Só não confunda “autônomo” com “independente”
O termo autonomia precisa ser usado com cuidado.
Spark consegue realizar etapas sem intervenção contínua.
Isso não significa independência completa.
Ele possui permissões.
Regras.
Serviços disponíveis.
Confirmações.
Limites definidos pela plataforma.
E continua sujeito a erros.
A própria documentação recomenda supervisão em atividades sensíveis e reconhece explicitamente a possibilidade de ações indesejadas.
Portanto, talvez o termo mais preciso seja:
**autonomia delegada**.
Nós escolhemos o objetivo.
Escolhemos as ferramentas.
Definimos algum grau de autoridade.
O agente trabalha dentro disso.
Quando funciona corretamente.
O Brasil recebeu o futuro dos agentes mas por enquanto ele custa quase um salário mínimo
O Gemini Spark representa uma das transformações mais importantes da estratégia recente do Google.
Depois de anos tentando criar um assistente de voz que respondesse corretamente, a empresa começa a vender algo conceitualmente mais ambicioso:
um trabalhador digital persistente.
Ele pesquisa.
Navega.
Utiliza aplicativos.
Lê arquivos.
Executa código remotamente.
Mantém tarefas.
Opera enquanto o usuário está offline.
Pode interagir com serviços de terceiros.
Isso é muito mais próximo da antiga promessa de um “assistente pessoal digital” do que perguntar ao telefone qual é a temperatura.
Mas a maturidade do conceito ainda está em construção.
Há avisos explícitos sobre erros.
Há riscos relacionados a contexto, sessões autenticadas e integrações externas.
A distribuição permanece limitada.
E, no Brasil, a documentação oficial atual coloca o acesso regular ao Spark no **Google AI Ultra, a partir de R$ 779,90 por mês**, apesar de reportagens locais terem mencionado também o plano Pro.
Isso restringe fortemente quem experimentará a tecnologia agora.
Talvez seja temporário.
Recursos de ponta costumam começar caros antes de descer pela pirâmide de planos.
Quando isso acontecer, a pergunta interessante deixará de ser “o que o Gemini consegue responder?”.
Será outra:
**quanto da sua vida digital você está disposto a deixar que ele faça sem você?**
👉 Dúvida? Então veja mais em: [https://pixbugtech.com/linksuteis](https://pixbugtech.com/linksuteis)