noticias
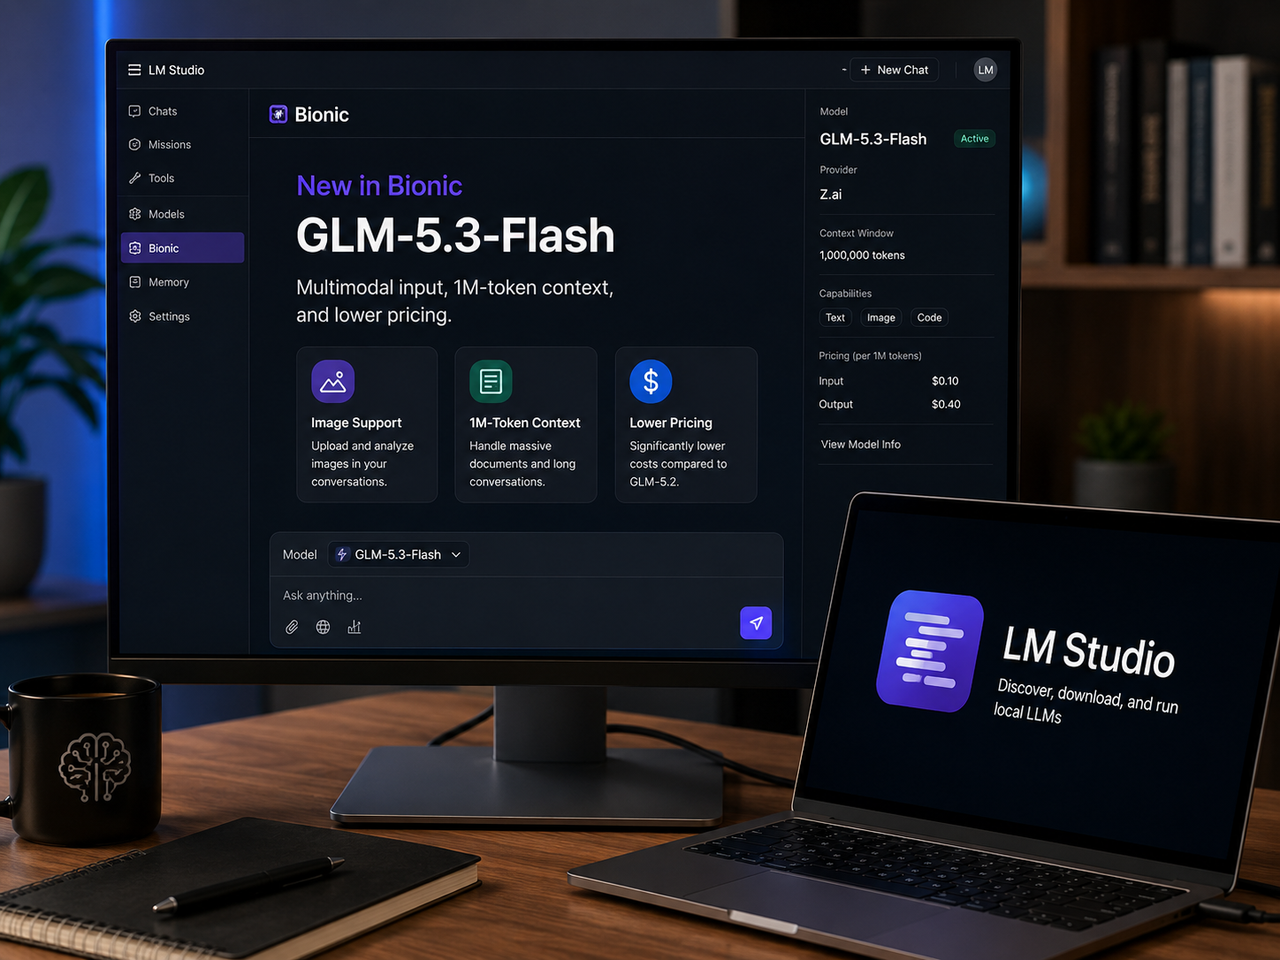
GLM-5.3-Flash chega ao LM Studio Bionic com visão, contexto de 1 milhão e custo muito menor
**Categoria editorial:** Aplicativos e Serviços
GLM-5.3-Flash chega ao LM Studio Bionic com visão, contexto de 1 milhão e custo muito menor
**Linha fina:** Novo modelo da Z.ai passa a integrar o Bionic com entrada de imagens, arquitetura otimizada para contexto longo e preços que pressionam diretamente modelos maiores da própria família.
**Meta description:** GLM-5.3-Flash chega ao LM Studio Bionic com visão, contexto de 1 milhão de tokens e preço muito menor que o GLM-5.2.
**Slug:** `glm-5-3-flash-lm-studio-bionic`
**Palavra-chave principal:** GLM-5.3-Flash
Matéria completa
GLM-5.3-Flash chega ao LM Studio Bionic com visão, contexto de 1 milhão e custo muito menor
O LM Studio adicionou o recém-lançado GLM-5.3-Flash, da chinesa Z.ai, ao Bionic, sua plataforma de agentes voltada a programação, pesquisa e trabalho com arquivos. A novidade combina três características que começam a definir a próxima disputa entre modelos usados por agentes: compreensão de imagens, janela de contexto extremamente ampla e custo de inferência baixo o suficiente para permitir várias etapas de trabalho sem transformar cada tarefa em uma conta desagradável de tokens.
Na configuração disponibilizada pelo LM Studio, o modelo pode receber texto e imagens, utilizar ferramentas e trabalhar com até 1 milhão de tokens de contexto. O preço publicado para o serviço em nuvem é de US$ 0,15 por milhão de tokens de entrada e US$ 0,50 por milhão de tokens de saída, além de uma tarifa reduzida para informações reaproveitadas por cache.
O contraste com o GLM-5.2 chama atenção. No mesmo serviço, a geração anterior aparece com valores aproximadamente dez vezes maiores na entrada e nove vezes superiores na saída.
Pode parecer apenas mais uma guerra de tabela de preços. Não é.
Agentes de inteligência artificial consomem tokens de maneira muito diferente de um chatbot comum. Eles podem abrir dezenas de arquivos, consultar ferramentas, executar comandos, receber resultados, tentar novamente e continuar trabalhando durante várias etapas. Quando esse ciclo se repete centenas de vezes por projeto, reduzir o custo de cada chamada deixa de ser um detalhe comercial e passa a determinar o que é economicamente possível automatizar.
Um modelo enorme que não trabalha inteiro ao mesmo tempo
O GLM-5.3-Flash possui cerca de 320 bilhões de parâmetros, um número que isoladamente sugeriria um modelo extremamente pesado. A arquitetura, porém, utiliza o conceito de Mixture-of-Experts, ou mistura de especialistas.
Isso significa que os 320 bilhões de parâmetros não entram em ação a cada token processado.
A Z.ai informa que aproximadamente 18 bilhões são ativados durante cada etapa de inferência. O restante funciona como um conjunto de especialistas que pode ser acionado conforme o tipo de informação processada.
A ideia se parece menos com reunir 320 bilhões de funcionários numa mesma sala e mais com possuir uma empresa enorme na qual apenas os departamentos necessários para determinado problema são chamados para aquela tarefa.
Essa arquitetura ajuda a explicar como modelos com capacidades muito grandes conseguem reduzir parte do custo computacional.
Ela também mostra por que comparar modelos apenas pela quantidade total de parâmetros se tornou uma maneira cada vez pior de avaliar eficiência.
O verdadeiro problema começa quando o contexto fica enorme
A janela de 1 milhão de tokens provavelmente será o número mais repetido nas apresentações do GLM-5.3-Flash. Na prática, ela permite colocar na mesma sessão uma quantidade muito grande de texto, código ou documentos.
Para desenvolvimento de software, isso pode significar apresentar ao agente uma parcela significativamente maior de um repositório.
Em análise documental, pode permitir cruzar contratos, relatórios, anexos e históricos longos sem precisar dividir tudo manualmente em dezenas de conversas independentes.
Só que contexto gigantesco cria seu próprio problema.
Modelos Transformer tradicionais gastam cada vez mais processamento e memória conforme a sequência cresce. Não basta simplesmente aumentar o limite de tokens e esperar que a infraestrutura aceite educadamente o aumento da conta.
Por isso, a parte mais interessante do GLM-5.3-Flash talvez esteja menos no número de tokens e mais na arquitetura utilizada para administrá-los.
A Z.ai afirma combinar mecanismos de atenção linear e atenção esparsa para reduzir a quantidade de processamento necessária quando o contexto cresce. A empresa também informa reduções relevantes no chamado KV cache, estrutura de memória usada durante a geração para evitar que o modelo tenha de recalcular continuamente informações anteriores.
São números divulgados pela própria desenvolvedora e ainda precisam ser confrontados com testes independentes em diferentes tipos de hardware.
O princípio técnico, entretanto, faz sentido: oferecer 1 milhão de tokens só é realmente útil se o custo de mantê-los disponíveis não explodir junto.
Um milhão de tokens não significa memória perfeita
Há uma distinção importante escondida nessa especificação.
Um modelo aceitar 1 milhão de tokens não significa que consiga encontrar, compreender e relacionar perfeitamente qualquer informação distribuída dentro deles.
Janela de contexto representa capacidade de entrada.
Recuperação de informação, atenção e raciocínio são problemas diferentes.
Um agente pode receber centenas de documentos e ainda ignorar uma cláusula importante perdida no meio deles. Pode dar peso excessivo às informações recentes ou não perceber a relação entre dois trechos separados por centenas de milhares de tokens.
Isso significa que técnicas como indexação, busca semântica, cache e seleção inteligente de arquivos continuam sendo relevantes.
A janela enorme não elimina engenharia de contexto.
Ela apenas oferece mais espaço para fazê-la.
Agora o agente também consegue olhar
Outra mudança relevante é o suporte multimodal.
O GLM-5.3-Flash foi desenvolvido para trabalhar com texto e conteúdo visual, e essa capacidade passa a ser explorada também dentro do Bionic.
Em um chat comum, isso significa enviar uma imagem e perguntar o que existe nela.
Dentro de um agente, a consequência pode ser muito maior.
Imagine um desenvolvedor fornecendo uma captura de tela de uma interface quebrada. O agente pode observar o erro visual, consultar o código responsável pela página, alterar os arquivos, executar o projeto e verificar novamente o resultado.
Em outro cenário, um agente pode receber um relatório com gráficos e tabelas cuja informação não está completamente representada no texto extraído do documento.
A imagem deixa de ser apenas um anexo.
Passa a fazer parte do ambiente que o modelo precisa compreender.
Essa capacidade também pode ser aplicada a agentes capazes de operar interfaces gráficas, identificando botões, menus e estados visuais antes de decidir qual ação executar.
É uma transformação importante porque grande parte do computador continua sendo construída para pessoas enxergarem, não para APIs conversarem.
Bionic e GLM-5.3-Flash não são a mesma coisa
A quantidade de nomes nesse mercado facilita alguma confusão.
O Bionic é a plataforma de agentes criada pelo LM Studio.
O GLM-5.3-Flash é um dos modelos que podem funcionar como motor de inteligência dentro dela.
Essa separação é relevante porque representa uma arquitetura cada vez mais comum: a camada do agente cuida dos projetos, arquivos, ferramentas, sessões e permissões, enquanto o modelo pode ser trocado conforme custo, desempenho ou necessidade.
Em um projeto de software, por exemplo, o Bionic pode indexar arquivos, pesquisar o código, interagir com Git, editar conteúdo e executar comandos.
O modelo selecionado é quem interpreta a tarefa e decide como utilizar essas ferramentas.
Hoje pode ser um GLM.
Amanhã pode ser outro.
Essa independência reduz o risco de plataformas ficarem permanentemente amarradas a um único fornecedor de inteligência artificial.
Mas essa integração não é processamento local
O nome LM Studio ficou fortemente associado à execução de modelos diretamente no computador do usuário.
É justamente por isso que esta distinção precisa aparecer sem rodeios.
O GLM-5.3-Flash integrado ao Bionic nesta modalidade é oferecido por meio da nuvem do LM Studio.
Quando o usuário escolhe essa opção, os dados necessários para executar a solicitação precisam ser enviados para processamento remoto.
O LM Studio afirma utilizar uma política de Zero Data Retention em sua infraestrutura de modelos hospedados. Pela política declarada pela empresa, solicitações são processadas sem retenção posterior do conteúdo e não são utilizadas para treinamento.
Isso melhora significativamente o cenário de privacidade em comparação com serviços que armazenam interações.
Ainda assim, nuvem continua sendo nuvem.
Código proprietário, contratos confidenciais, documentos jurídicos, bases contendo dados pessoais ou informações protegidas por regras internas de compliance podem possuir restrições que independem da política de retenção do fornecedor.
Para algumas organizações, "o provedor promete não guardar" é suficiente.
Para outras, a regra é simplesmente "o arquivo não sai daqui".
O Bionic consegue atender aos dois mundos utilizando modelos locais ou remotos. A escolha é arquitetural, e não apenas uma opção em um menu.
Os pesos podem ser baixados, mas o hardware não aparece por mágica
A Z.ai também publicou os pesos do GLM-5.3-Flash sob licença permissiva, abrindo espaço para execução em infraestrutura própria.
Isso oferece uma vantagem importante para empresas que desejam controlar completamente onde os dados são processados.
Mas existe uma diferença enorme entre poder baixar um modelo e conseguir executá-lo bem.
São aproximadamente 320 bilhões de parâmetros.
Mesmo utilizando quantização e ativando apenas parte deles durante cada token, o armazenamento dos pesos, a movimentação de dados entre dispositivos e a memória necessária continuam colocando o GLM-5.3-Flash muito além do que a maioria dos notebooks consegue executar de maneira prática.
Infraestruturas próprias provavelmente precisarão de múltiplas GPUs ou aceleradores, bastante memória e software especializado para distribuir a inferência.
É a velha diferença entre software aberto e infraestrutura barata.
Um não garante o outro.
A batalha pelos agentes começa a virar uma batalha pelo preço
Modelos utilizados principalmente em chats conseguem conviver com interações relativamente curtas.
Agentes mudam completamente essa matemática.
Imagine uma tarefa aparentemente simples: corrigir um erro em um projeto.
O agente precisa localizar os arquivos relacionados, ler código, compreender dependências, alterar uma função, executar testes, interpretar uma falha, corrigir novamente e gerar a resposta final.
Uma solicitação humana pode se transformar facilmente em dezenas de interações internas com o modelo.
Se cada interação custa caro, o agente rapidamente deixa de ser uma ferramenta de produtividade e vira uma solução que precisa justificar cuidadosamente cada execução.
É nesse ponto que o preço do GLM-5.3-Flash se torna estratégico.
Se o desempenho anunciado se mantiver em aplicações reais, a comparação deixa de ser simplesmente "qual modelo responde melhor?".
A pergunta passa a ser "quanto custa chegar até a resposta correta?".
E essa talvez seja uma métrica muito mais relevante para o mercado de agentes.
Benchmarks são interessantes, mas não encerram a conversa
A Z.ai publicou resultados nos quais o GLM-5.3-Flash supera o GLM-5.2 em diferentes avaliações de programação e automação.
Esses dados são importantes para entender o posicionamento pretendido pela empresa.
Não constituem, porém, uma conclusão definitiva sobre superioridade.
Benchmarks de agentes são especialmente sensíveis ao ambiente utilizado. Ferramentas disponíveis, prompts de sistema, limites de execução, configuração da infraestrutura e até estratégias de repetição podem alterar significativamente o resultado.
Um modelo pode liderar uma bateria de testes e ainda demonstrar fragilidades quando enfrenta um repositório legado de dez anos, dependências quebradas e documentação escrita por quatro equipes que claramente nunca conversaram entre si.
É nesse ambiente menos elegante que agentes precisam provar valor.
Os próximos meses devem mostrar se o modelo mantém a relação entre desempenho e preço quando utilizado continuamente por desenvolvedores e empresas.
Existe outra disputa acontecendo por baixo do modelo
Antes da identificação oficial, o GLM-5.3-Flash apareceu em alguns ambientes como “Ox Alpha”, permitindo que usuários testassem o modelo sem saber imediatamente quem o havia produzido.
A Z.ai posteriormente revelou sua identidade e afirmou que a infraestrutura utilizada nesses testes funcionava sobre aceleradores desenvolvidos na China.
Esse detalhe é relevante porque a competição global de inteligência artificial não acontece apenas entre modelos.
Existe uma disputa paralela por chips, memória, interconexão, ferramentas de software e capacidade de operar grandes sistemas de inferência sem depender das GPUs mais avançadas produzidas no ecossistema ocidental.
Restrições de exportação aumentaram a pressão para que empresas chinesas construíssem alternativas próprias.
Se os novos aceleradores conseguirem sustentar modelos competitivos em produção, a consequência vai além de uma ficha técnica.
Significa reduzir uma das principais dependências estratégicas do setor de IA chinês.
O que realmente muda para quem usa o LM Studio
Para o usuário do Bionic, a mudança imediata é ter mais uma opção para tarefas envolvendo código, documentos, imagens e projetos extensos.
O efeito potencialmente mais importante aparece em tarefas demoradas.
Quanto mais passos um agente executa, maior é a vantagem de um modelo cuja inferência custa menos.
Isso pode tornar economicamente aceitáveis tarefas que antes exigiam limitar quantidade de arquivos, duração da sessão ou número de tentativas.
Também pode estimular outro comportamento saudável: experimentar modelos diferentes para o mesmo problema.
Quando a plataforma não depende de um único fornecedor, o usuário pode comparar qualidade e preço de maneira mais pragmática.
Essa dinâmica começa a parecer menos com escolher uma religião tecnológica e mais com escolher uma ferramenta.
O mercado agradece.
Mais autonomia também significa mais risco
O problema dos agentes é que seus erros podem produzir consequências fora da conversa.
Um chatbot que se engana escreve uma resposta incorreta.
Um agente com permissão para alterar arquivos pode escrever a resposta incorreta dentro do seu projeto.
Se tiver acesso ao terminal, pode executar o comando incorreto.
Se estiver conectado a serviços externos, pode realizar a ação incorreta.
Multimodalidade amplia ainda mais a superfície de entrada, porque instruções maliciosas podem estar escondidas em documentos, páginas e imagens analisadas pelo modelo.
Esses ataques, conhecidos como prompt injection, tentam fazer com que o agente trate conteúdo externo como uma instrução confiável.
Janela de contexto maior também significa que mais conteúdo potencialmente hostil pode entrar na sessão.
Por isso, a evolução dos agentes precisa acontecer junto com permissões granulares, isolamento de ambientes, revisão de alterações e mecanismos que exijam aprovação humana para operações sensíveis.
Um modelo ser mais barato para executar não torna barato o prejuízo provocado por uma ação errada.
Análise da equipe
O GLM-5.3-Flash chama atenção porque parece ter sido pensado menos para vencer uma corrida abstrata de parâmetros e mais para resolver o problema econômico criado pelos agentes.
Modelos tradicionais poderiam se dar ao luxo de gastar bastante processamento para produzir uma boa resposta.
Agentes precisam produzir dezenas ou centenas de decisões durante uma única tarefa.
Essa diferença muda tudo.
Mixture-of-Experts reduz a quantidade de parâmetros ativados. Atenção híbrida tenta conter o custo de sequências gigantes. Cache menor reduz pressão de memória. O suporte multimodal amplia o número de tarefas que podem ser executadas dentro de um mesmo fluxo.
No fim, todas essas decisões apontam para a mesma pergunta: quanto trabalho útil o modelo consegue produzir por unidade de infraestrutura consumida?
Essa será provavelmente uma das principais métricas da próxima fase da inteligência artificial.
Os modelos mais impressionantes nem sempre serão aqueles capazes de produzir a melhor resposta isolada.
Podem ser aqueles que conseguem trabalhar durante meia hora, utilizar várias ferramentas, errar, corrigir, continuar e ainda terminar a tarefa por um custo aceitável.
O GLM-5.3-Flash ainda precisa passar pelo teste que realmente importa: milhares de projetos reais, sessões longas, repositórios complicados, documentos imperfeitos e usuários que não escrevem prompts cuidadosamente preparados para benchmarks.
Se a relação entre capacidade e preço sobreviver a esse ambiente, porém, a Z.ai terá feito algo mais importante do que lançar outro modelo.
Terá ajudado a deslocar a disputa da IA de “quem tem o maior modelo?” para uma questão muito mais pragmática:
quem consegue colocar uma inteligência competente para trabalhar sem transformar cada tarefa em uma conta de GPU?
👉 Dúvida? Então veja mais em: https://pixbugtech.com/linksuteis