noticias
Google lança Gemini 3.8 Live e transforma conversa por voz em execução de tarefas
**Categoria editorial:** Inteligência Artificial / Google / Assistentes
Google lança Gemini 3.8 Live e transforma conversa por voz em execução de tarefas
**Linha fina:** Gemini 3.8 Live e 3.8 Live Extended Thinking conseguem raciocinar enquanto conversam, interpretar imagens e executar ferramentas em segundo plano sem interromper o diálogo.
**Meta description:** Google lança Gemini 3.8 Live e Extended Thinking, modelos de voz que raciocinam em tempo real e executam tarefas enquanto conversam.
**Slug:** `google-gemini-3-8-live-voz-raciocinio-tempo-real`
**Palavra-chave principal:** Gemini 3.8 Live
Matéria completa
Talvez o problema histórico dos assistentes de voz nunca tenha sido entender o que estávamos dizendo.
Era não saber o que fazer depois disso.
Durante anos, Siri, Google Assistente, Alexa e concorrentes foram apresentados como o futuro da computação por voz. Na prática, funcionavam razoavelmente bem para temporizadores, previsão do tempo, músicas e alguns comandos domésticos — até o momento em que a conversa exigia contexto, raciocínio ou uma sequência de ações.
O Google agora tenta eliminar justamente essa fronteira.
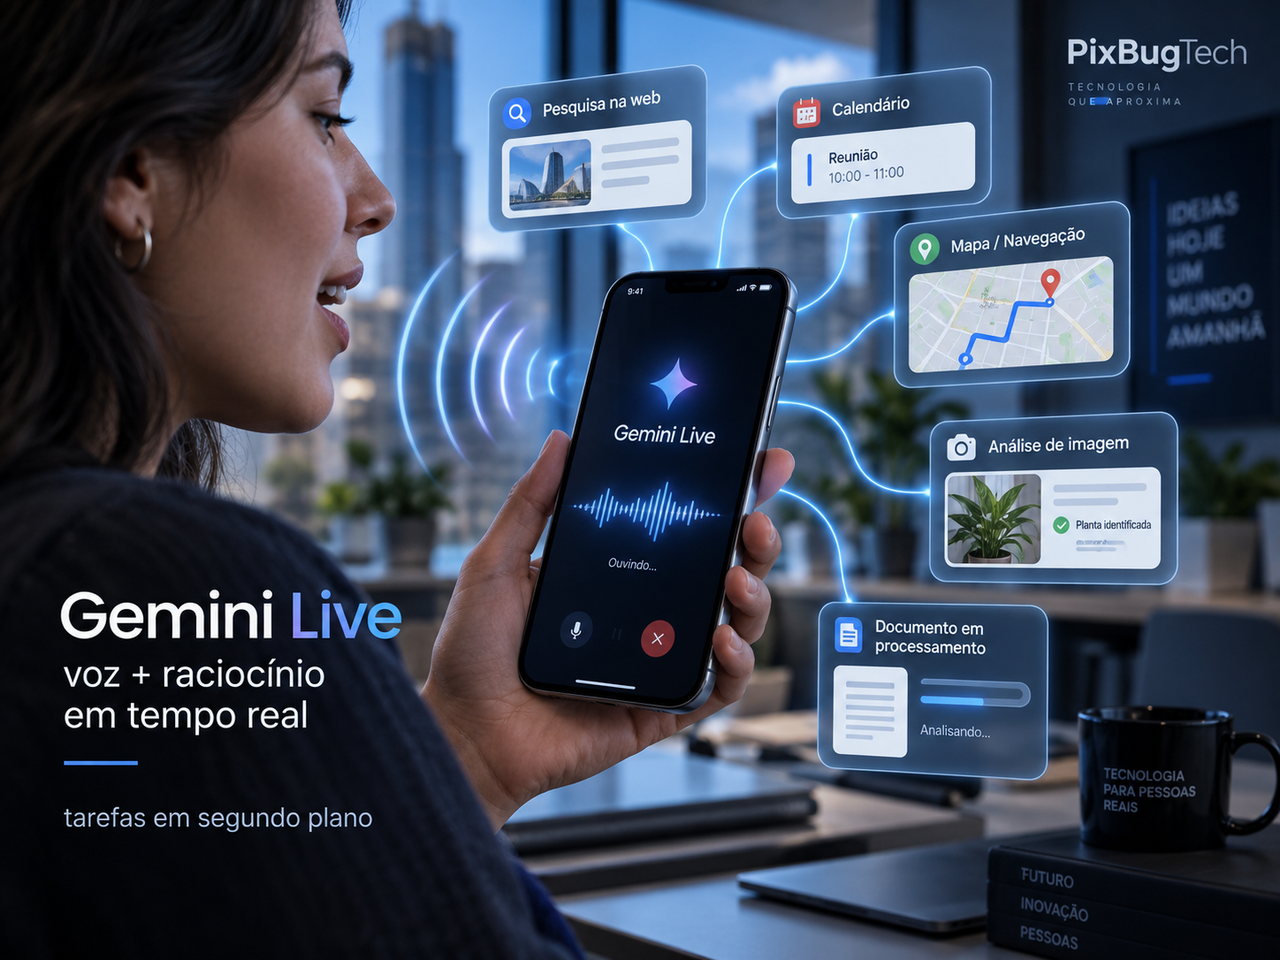
A empresa apresentou em 15 de setembro o **Gemini 3.8 Live e o Gemini 3.8 Live Extended Thinking**, dois novos modelos desenvolvidos especificamente para conversação em tempo quase real. A principal mudança não está simplesmente em produzir uma voz mais natural: os modelos foram projetados para **conversar, raciocinar e executar tarefas simultaneamente**.
Isso parece uma evolução incremental.
Pode acabar sendo uma mudança muito maior.
A IA agora pode continuar conversando enquanto trabalha
Imagine pedir por voz:
“Procure um restaurante italiano para sábado à noite, veja quais têm boas avaliações e considere que ficaremos perto deste endereço.”
Uma inteligência artificial tradicional precisaria receber o comando, interromper momentaneamente a interação, pesquisar informações, processar resultados e finalmente voltar com uma resposta.
A arquitetura do Gemini 3.8 Live foi projetada para operar de outra forma.
O modelo pode iniciar chamadas para ferramentas e APIs **em segundo plano enquanto continua transmitindo áudio e mantendo a conversa com o usuário**.
Na terminologia técnica utilizada pelo Google, trata-se de *asynchronous function calling*.
Em português mais direto: a IA não precisa ficar calada enquanto trabalha.
Isso resolve uma característica particularmente artificial dos atuais assistentes.
Pessoas conseguem conversar enquanto realizam outras atividades.
Computadores, curiosamente, muitas vezes nos obrigam a conversar em turnos.
Você fala.
Espera.
A máquina processa.
A máquina responde.
Agora essa separação começa a desaparecer.
O Gemini 3.8 Live não foi criado apenas para conversar
Existem duas versões com objetivos diferentes.
O **Gemini 3.8 Live** foi desenvolvido pensando em escala e eficiência de custo. Ele combina conversação fluida, inteligência e capacidade de utilizar contexto visual.
Já o **Gemini 3.8 Live Extended Thinking** recebe uma camada adicional de raciocínio destinada a problemas mais complexos e tarefas compostas por várias etapas.
Essa segunda versão é particularmente interessante.
Ela consegue desenvolver raciocínio em segundo plano ao mesmo tempo em que mantém a interação verbal.
Isso significa que, diante de um problema complexo, o modelo pode reconhecer rapidamente o pedido, continuar conversando com o usuário e trabalhar paralelamente na solução.
Em outras palavras, a latência deixa de ser apenas uma questão de velocidade de processamento.
Passa também a ser uma questão de experiência.
É quase como conversar com alguém enquanto a pessoa trabalha
O próprio Google descreve uma experiência na qual o modelo pode responder inicialmente com algo equivalente a “deixe-me verificar isso” e continuar narrando o progresso à medida que executa diferentes etapas.
Isso é importante porque muda nossa percepção sobre o que a máquina está fazendo.
Pense em uma ligação para um atendimento humano.
Você solicita uma informação.
A pessoa diz que vai verificar.
Enquanto consulta o sistema, continua falando com você, pede algum dado adicional e explica o que está fazendo.
Agora imagine esse comportamento executado por uma IA.
Essa é uma das ideias centrais por trás do Gemini 3.8 Live Extended Thinking.
Não é simplesmente gerar uma resposta falada depois de raciocinar.
É **raciocinar enquanto participa da conversa**.
A inteligência também ganha olhos
Os novos modelos mantêm suporte a contexto visual em tempo quase real.
Isso significa que uma conversa pode ser baseada não apenas no que o usuário está dizendo, mas também naquilo que uma câmera ou outra fonte visual está mostrando ao modelo.
As possibilidades práticas são enormes.
Alguém pode apontar o celular para um equipamento e perguntar onde está o problema.
Mostrar uma tela e pedir ajuda para encontrar determinada configuração.
Apresentar um tabuleiro e discutir uma jogada.
Mostrar um objeto e perguntar como utilizá-lo.
O Google demonstra o Gemini 3.8 Live realizando assistência visual e até jogando xadrez a partir da interpretação do contexto apresentado durante a conversa.
Aqui começa a ficar mais fácil compreender por que chamar essas tecnologias simplesmente de “assistentes de voz” já parece insuficiente.
A voz é apenas a interface.
Por trás dela existe um modelo multimodal.
E ele consegue trocar de idioma no meio da conversa
O Gemini 3.8 Live oferece suporte a **97 idiomas** e pode detectar automaticamente mudanças de linguagem durante a interação.
Isso permite situações bastante naturais.
Uma conversa pode começar em português, incluir uma frase em inglês, voltar ao português e mencionar um termo técnico em outra língua sem exigir que o usuário abra configurações para informar qual idioma deseja utilizar.
Para países multilíngues e aplicações internacionais, isso tem impacto evidente.
Mas existe outra aplicação importante: atendimento empresarial.
Centrais de suporte precisam lidar com sotaques, nomes próprios, códigos, números de processos e vocabulário específico.
O modelo também recebeu melhorias para interpretar sequências alfanuméricas — justamente aquelas informações que assistentes de voz costumam transformar em um pequeno festival de erros.
Número de protocolo.
Código de confirmação.
Placa.
Identificador de pedido.
Dados técnicos.
São detalhes pouco espetaculares em uma apresentação de tecnologia, mas extremamente importantes quando a IA começa a realizar trabalho real.
A grande aposta está nos agentes de voz
Aqui está a parte que vai muito além do aplicativo Gemini.
O Google disponibilizou os modelos por meio da **Live API**, permitindo que desenvolvedores construam seus próprios agentes de voz.
Isso significa que o Gemini 3.8 Live pode aparecer dentro de serviços que nem sequer carregam o nome Gemini.
Bancos.
Operadoras.
Companhias aéreas.
Lojas.
Sistemas corporativos.
Aplicativos.
Centrais de atendimento.
Softwares internos.
O Google também anunciou integração com plataformas utilizadas na construção de aplicações em tempo real, incluindo LiveKit, LangChain, Pipecat, Agora, Vercel e outras soluções de infraestrutura.
É nesse mercado que talvez esteja a parte economicamente mais importante do lançamento.
Porque atendimento telefônico pode ser completamente redesenhado
Os atuais robôs de atendimento são filhos tecnológicos de outra época.
“Para financeiro, diga financeiro.”
“Não entendi. Você gostaria de falar sobre sua fatura?”
“Desculpe, ainda não consegui entender.”
Qualquer brasileiro que já tentou resolver um problema um pouco mais complexo por telefone conhece o ritual.
Esses sistemas normalmente trabalham com árvores de decisão bastante rígidas.
Modelos de linguagem mudam essa arquitetura.
Um agente capaz de interpretar linguagem natural, consultar APIs, acessar sistemas autorizados e raciocinar sobre várias etapas pode receber simplesmente a descrição do problema.
“Minha fatura veio duplicada, eu paguei ontem e preciso confirmar se o segundo boleto será cancelado.”
Não existe necessidade de transformar mentalmente esse problema em uma opção de menu.
A IA pode interpretar a intenção, identificar dados necessários, consultar sistemas e continuar a conversa.
É exatamente para cenários desse tipo que os novos modelos começam a parecer muito mais interessantes do que um simples chatbot que aprendeu a falar.
O Gemini 3.8 Live também chega à busca
O Google está levando a nova arquitetura de voz para seus próprios produtos.
No **Search Live**, os modelos podem oferecer ajuda interativa em tempo real, inclusive em situações de solução de problemas passo a passo. O Gemini Live e recursos de voz do Workspace também fazem parte dessa estratégia mais ampla.
Essa integração é especialmente importante para a Busca.
Durante décadas, pesquisar significou escrever algumas palavras e receber uma página contendo links.
Com o Modo IA e o Search Live, o Google está experimentando outro paradigma.
Você pergunta.
A busca investiga.
Você interrompe.
Acrescenta contexto.
Mostra alguma coisa pela câmera.
Faz outra pergunta.
E a pesquisa continua.
A página de resultados começa a se transformar em uma conversa.
O verdadeiro concorrente talvez não seja outro chatbot
Existe uma tendência de analisar cada lançamento do Gemini pela pergunta inevitável: ele está melhor ou pior que ChatGPT ou Claude?
Essa comparação continua válida.
Mas, para modelos Live, talvez ela esconda uma disputa mais importante.
Google, OpenAI e outras empresas estão tentando ocupar a camada que historicamente pertenceu às interfaces gráficas.
Durante décadas aprendemos que, para comandar um computador, era necessário clicar.
Abrir aplicativo.
Escolher menu.
Encontrar botão.
Preencher campo.
Confirmar.
A promessa dos agentes é remover parte dessa sequência.
Você simplesmente explica o resultado desejado.
A inteligência artificial descobre quais ferramentas precisam ser chamadas e tenta executar as etapas necessárias.
Quando isso passa a funcionar por voz, o efeito é ainda mais radical.
O computador começa a exigir menos conhecimento sobre **como utilizar o computador**.
Mas existe uma diferença enorme entre conversar bem e trabalhar bem
Aqui entra a parte menos glamourosa.
Uma inteligência artificial pode soar extraordinariamente humana e ainda assim executar uma tarefa incorretamente.
Na verdade, uma voz convincente pode aumentar o risco.
Quanto mais natural a interação, maior pode ser nossa tendência de confiar que o sistema compreendeu corretamente o pedido.
Quando uma IA apenas responde uma curiosidade, um erro pode ser inconveniente.
Quando começa a executar ações, consultar sistemas corporativos ou alterar informações, o impacto muda de escala.
O problema deixa de ser apenas alucinação.
Passa a envolver **permissão, autenticação, confirmação e reversibilidade**.
A IA pode fazer isso?
Com qual conta?
Até qual limite?
Precisa pedir autorização antes de executar?
É possível desfazer?
Existe registro da decisão?
Essas perguntas serão muito mais importantes na era dos agentes do que perguntar se a voz parece humana.
O raciocínio em tempo real também tem um custo
Quanto mais sofisticado o processamento, maior tende a ser a quantidade de computação necessária.
O Google divulgou preços para uso dos novos modelos via API de aproximadamente **US$ 0,005 por minuto de áudio de entrada e US$ 0,018 por minuto de áudio de saída**, com a cobrança técnica baseada no consumo de tokens correspondente.
Para um usuário individual, alguns minutos podem parecer insignificantes.
Para uma empresa processando milhões de chamadas, cada fração de centavo passa a importar.
E isso explica por que existem duas versões.
Nem toda conversa precisa do raciocínio mais sofisticado disponível.
Perguntar o status de uma entrega não exige a mesma capacidade necessária para analisar um problema técnico composto por várias etapas.
A capacidade de escolher modelos diferentes para diferentes cargas poderá determinar se agentes de voz serão economicamente viáveis em grande escala.
Análise da equipe
Existe algo curioso acontecendo com os assistentes de voz.
Talvez a indústria simplesmente tenha tentado criá-los cedo demais.
Quando Siri, Google Assistente e Alexa apareceram, possuíam uma excelente interface — nossa própria voz — conectada a sistemas com capacidade bastante limitada de compreender contexto e raciocinar.
Era possível conversar.
Só não havia muita inteligência do outro lado.
Os grandes modelos de linguagem inverteram essa equação.
Primeiro adquirimos sistemas capazes de compreender e gerar linguagem de maneira extraordinariamente sofisticada.
Agora a indústria está reconstruindo a voz em torno dessa inteligência.
O Gemini 3.8 Live representa bem essa mudança porque não tenta simplesmente falar melhor.
Ele tenta solucionar o problema estrutural dos antigos assistentes: **ser capaz de continuar pensando e agindo depois de entender aquilo que pedimos**.
A execução assíncrona talvez seja o detalhe técnico mais importante desse lançamento.
Se a IA consegue conversar enquanto pesquisa, consulta ferramentas e executa tarefas, ela começa a reproduzir uma característica fundamental da interação humana: fazer várias coisas ao mesmo tempo sem quebrar completamente o fluxo da conversa.
Ainda existe uma distância considerável entre uma demonstração impressionante e confiar nesses sistemas para tomar decisões ou executar ações importantes.
Segurança, privacidade, erros, permissões e controle humano continuarão sendo problemas difíceis.
Mas a direção está ficando muito clara.
Durante anos perguntamos quando os assistentes de voz finalmente ficariam inteligentes.
Talvez a pergunta agora precise mudar.
Se eles conseguem conversar, enxergar, raciocinar e utilizar ferramentas simultaneamente, a questão passa a ser:
**quanto trabalho estaremos dispostos a deixá-los fazer enquanto continuamos conversando?**
👉 Dúvida? Então veja mais em: https://pixbugtech.com/linksuteis