noticias
Google libera Computer Use no Gemini 3.5 Flash: a IA que vê a tela, clica, digita e transforma automação em agente
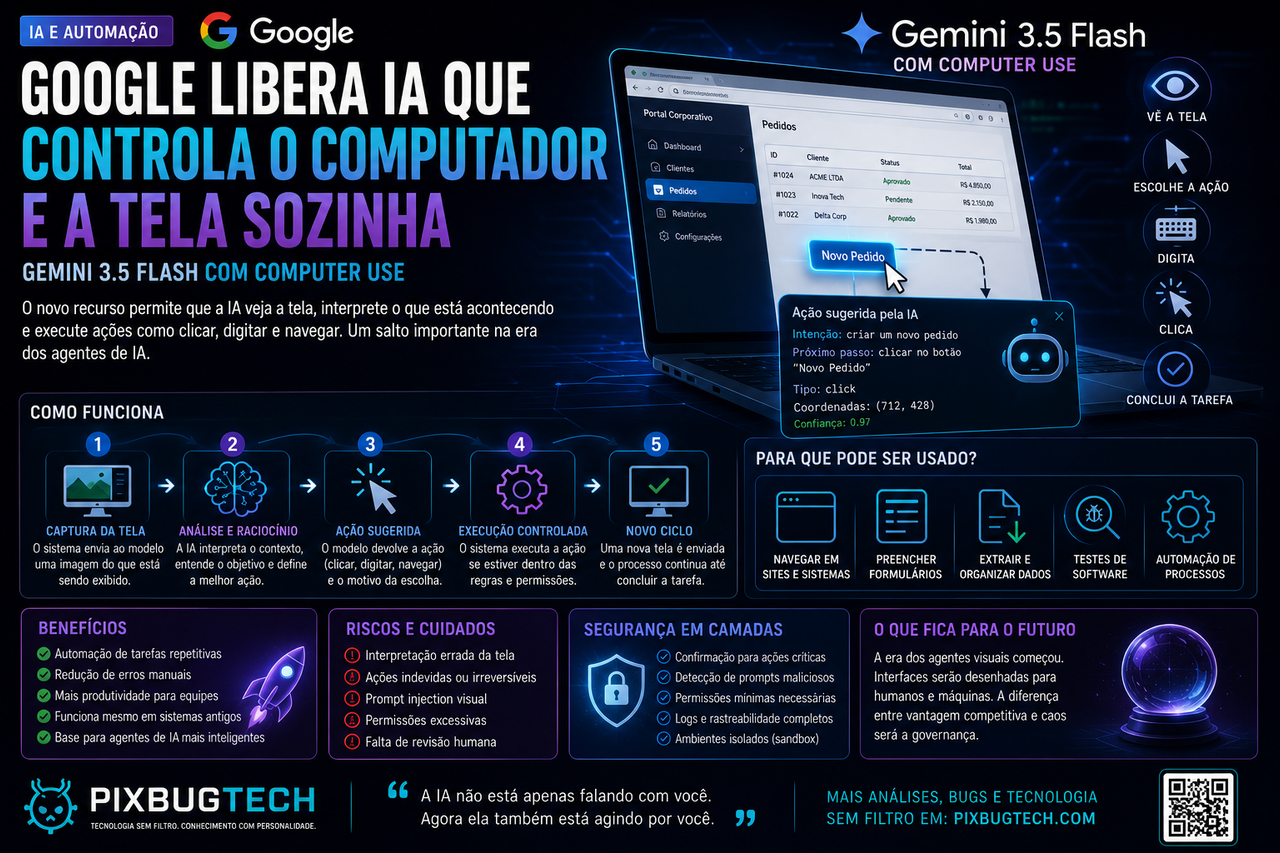
**O Google deu um passo importante na corrida dos agentes de inteligência artificial ao integrar o recurso de “Computer Use” ao Gemini 3.5 Flash.
A manchete popular diz que agora a IA consegue “mexer no computador sozinha”, mas a realidade técnica é mais interessante e também mais controlada.
O modelo pode observar capturas de tela, interpretar o que está acontecendo em uma interface e sugerir ações como clicar, digitar, navegar ou preencher campos. Só que ele não sai possuindo o seu computador como um fantasma corporativo.
Para funcionar, desenvolvedores precisam criar o ambiente que executa essas ações, definir permissões, estabelecer limites e decidir quando a intervenção humana será obrigatória.**
A novidade aproxima o Gemini de uma categoria cada vez mais estratégica: IAs que não apenas respondem, mas executam. O modelo recebe um objetivo, analisa a tela, decide qual ação de interface faz sentido e devolve uma instrução operacional, como clicar em determinado ponto, inserir um texto em um campo ou avançar para outra etapa. Depois que o sistema executa a ação, uma nova captura de tela é enviada ao modelo, criando um ciclo contínuo de observação, decisão e execução.
Essa arquitetura muda o papel da inteligência artificial no ambiente de trabalho. Em vez de apenas explicar como preencher um formulário, ela pode participar do preenchimento. Em vez de apenas dizer onde está um erro em uma interface, ela pode navegar até o local provável. Em vez de resumir instruções, pode agir sobre a tela. A diferença parece pequena em uma demonstração, mas é enorme para empresas que ainda dependem de sistemas antigos, portais sem API, processos manuais e fluxos repetitivos espalhados por várias telas.
O que está acontecendo
O recurso de Computer Use transforma o Gemini 3.5 Flash em uma base para agentes capazes de interagir com navegadores, interfaces móveis e ambientes desktop. Isso significa que a IA passa a trabalhar com aquilo que humanos já usam todos os dias: botões, menus, formulários, caixas de texto, janelas, avisos e mensagens de erro. A tela deixa de ser apenas uma superfície visual e passa a ser um ambiente operacional interpretável pelo modelo.
Essa proposta é diferente de uma automação tradicional. Scripts comuns dependem de comandos fixos, seletores previsíveis, APIs documentadas ou fluxos bem definidos. Um agente visual tenta lidar com interfaces mais próximas da experiência humana. Se um botão muda de posição, se a tela apresenta uma mensagem inesperada ou se o sistema exige uma etapa adicional, o modelo pode tentar interpretar o novo estado e adaptar a próxima ação.
O ponto central é que a execução não acontece magicamente dentro do modelo. A IA sugere o próximo passo, mas quem executa a ação é o sistema criado pelo desenvolvedor ou pela empresa. Essa separação é essencial para reduzir o risco de uma IA agir sem supervisão. O modelo pode recomendar o clique; a aplicação precisa decidir se aquele clique será permitido, registrado, bloqueado ou enviado para confirmação humana.
O que muda na prática
Para usuários comuns, o impacto inicial não será necessariamente abrir o Gemini e mandar a IA controlar livremente o computador pessoal. O recurso nasce mais voltado a desenvolvedores, empresas e plataformas que desejam criar agentes dentro de ambientes controlados. Isso significa que o efeito chegará aos poucos, incorporado em produtos, assistentes corporativos, ferramentas de teste, automações administrativas e sistemas internos.
Para empresas, a promessa é forte. Muitos processos digitais ainda dependem de pessoas copiando informações entre sistemas, conferindo dados em portais, preenchendo cadastros, baixando documentos, abrindo telas antigas e repetindo sequências mecânicas. Em um mundo ideal, tudo isso seria resolvido com APIs bem desenhadas e integrações modernas. Na prática, muita empresa opera sobre sistemas legados, plataformas fechadas e fluxos remendados ao longo dos anos.
É nesse espaço que o Computer Use pode ter valor real. Se uma pessoa consegue operar um sistema apenas olhando para a tela e interagindo com ela, a IA passa a tentar fazer algo parecido. Isso não substitui integração séria, mas pode destravar automações onde uma integração formal seria cara, lenta ou inviável. O risco é óbvio: transformar uma gambiarra manual em uma gambiarra automatizada com crachá de inovação.
O detalhe técnico que merece atenção
O Computer Use funciona a partir de capturas de tela e ações de interface. O modelo “vê” o estado atual, interpreta os elementos visuais, entende o objetivo definido e propõe uma ação. A aplicação, então, executa essa ação e envia uma nova tela ao modelo. Esse ciclo continua até a tarefa terminar, falhar, exigir confirmação ou encontrar uma situação fora dos limites definidos.
Essa lógica torna a automação mais flexível, mas também mais difícil de auditar. Em um script tradicional, é relativamente simples entender que a automação sempre clica no mesmo elemento ou chama a mesma API. Em um agente visual, a decisão pode depender de contexto, interpretação, posição dos elementos e raciocínio do modelo. Isso exige logs, justificativas, limites claros e uma arquitetura de controle muito mais cuidadosa.
A presença de uma explicação de intenção para cada ação será cada vez mais importante. Se a IA pretende clicar em um botão, precisa informar por que aquele clique faz sentido. Se pretende preencher um campo, precisa indicar qual informação está usando. Se pretende avançar para uma etapa sensível, precisa deixar claro o objetivo. Sem essa camada de justificativa, a automação vira uma caixa-preta que apenas executa coisas até alguém descobrir que executou a coisa errada.
O perigo mora no prompt injection visual
Quando uma IA começa a ler telas, ela também passa a ler instruções maliciosas que podem estar dentro dessas telas. Um site, documento, imagem, e-mail ou campo de texto pode conter mensagens desenhadas para manipular o agente. O conteúdo pode tentar convencer a IA a ignorar regras, revelar dados, clicar em links, alterar campos ou executar ações que não fazem parte do objetivo original.
Esse tipo de ataque é especialmente perigoso porque explora a própria capacidade do modelo de interpretar linguagem e contexto. Em um chatbot comum, uma injeção de prompt pode produzir uma resposta ruim. Em um agente com Computer Use, ela pode gerar uma sequência de ações reais. A diferença entre falar algo errado e fazer algo errado é enorme.
Por isso, agentes visuais precisam trabalhar em ambientes com contenção. Ações sensíveis devem exigir confirmação. Sistemas internos devem limitar permissões. Dados críticos não devem ficar expostos sem necessidade. O agente precisa ser tratado como um operador com acesso controlado, não como uma consciência digital confiável por natureza.
Nem toda automação merece autonomia
O entusiasmo com agentes costuma pular uma etapa importante: nem toda tarefa deve ser automatizada até o fim. Algumas atividades podem ser delegadas quase totalmente, como navegar por páginas públicas, coletar dados não sensíveis, testar interfaces ou preencher rascunhos. Outras precisam de revisão humana antes da conclusão, especialmente quando envolvem dinheiro, dados pessoais, contratos, cadastros oficiais, segurança, acesso físico ou decisões irreversíveis.
A maturidade estará em definir níveis de autonomia. Um agente pode observar e sugerir. Pode preparar uma ação e aguardar aprovação. Pode executar tarefas de baixo risco sozinho. Pode ser bloqueado em situações críticas. O erro será tratar tudo da mesma forma, como se clicar em “próximo” em um tutorial tivesse o mesmo peso de confirmar uma transação financeira.
Empresas que adotarem Computer Use precisarão construir políticas internas antes de colocar agentes em produção. Quem autoriza? O que pode ser feito sem supervisão? Quais ações exigem confirmação? Onde ficam os registros? Como desfazer uma ação errada? Quem responde por uma decisão automatizada? Essas perguntas não são burocracia; são a diferença entre automação produtiva e incidente operacional.
Quem será impactado primeiro
Os primeiros impactados serão desenvolvedores de automação, equipes de qualidade de software e empresas que dependem de processos internos repetitivos. Um agente capaz de navegar em interfaces pode executar testes, reproduzir jornadas de usuário, preencher formulários, verificar mensagens de erro, observar telas e relatar inconsistências. Isso pode reduzir tempo em tarefas cansativas e liberar equipes para análises mais complexas.
Áreas administrativas também devem sentir o impacto. Financeiro, jurídico, recursos humanos, atendimento, suporte e operações lidam diariamente com sistemas que exigem cliques, cópias, conferências e validações. Um agente visual pode ajudar a organizar parte desse trabalho, desde que não receba acesso amplo demais nem seja usado como substituto irresponsável de controle humano.
Profissionais de tecnologia terão uma mudança mais profunda. O trabalho deixará de ser apenas criar scripts previsíveis e passará a envolver desenho de ambientes para agentes. Será necessário definir permissões, criar sandboxes, registrar ações, validar decisões, tratar exceções e impedir que o agente confunda uma tela inesperada com uma autorização para improvisar.
Usuários comuns sentirão a mudança depois, quando produtos começarem a incorporar esse tipo de capacidade. A experiência pode aparecer em assistentes que ajudam a preencher cadastros, organizar arquivos, navegar por sites, configurar aplicativos, resolver etapas burocráticas ou operar serviços digitais em nome do usuário. A promessa é conveniência. O desafio será impedir que essa conveniência venha com autoridade demais.
O que pode dar errado
O primeiro risco é a IA interpretar a tela de forma errada. Interfaces são ambíguas, mudam com frequência, escondem elementos importantes e apresentam mensagens inesperadas. Um agente pode clicar no botão errado, preencher o campo errado ou seguir por um caminho plausível, mas incorreto. Quando a tarefa é simples, o dano é pequeno. Quando a tarefa envolve sistemas críticos, o erro pode ser caro.
O segundo risco é a escalada de permissões. Se uma empresa der ao agente acesso amplo demais, qualquer falha terá impacto maior. Um agente que apenas lê informações oferece um tipo de risco. Um agente que altera cadastros, aprova solicitações, envia mensagens, confirma compras ou modifica configurações oferece outro nível de exposição.
O terceiro risco é a falta de revisão humana. A promessa de economia de tempo pode levar equipes a liberar automações antes de estabelecer barreiras. Essa é a receita clássica para o desastre tecnológico: uma demonstração funciona, alguém coloca em produção, o volume aumenta, a exceção aparece, e só então todos descobrem que não havia plano de contenção.
O quarto risco é a segurança visual. Prompt injection em páginas, documentos e interfaces pode tentar manipular o agente. Nenhum sistema de detecção deve ser tratado como garantia absoluta. O correto é combinar permissões mínimas, isolamento, confirmação humana, registro de ações e limitação clara de dados sensíveis.
O que ninguém ainda está discutindo
O maior impacto do Computer Use talvez não esteja apenas na produtividade, mas na redefinição do que é uma interface. Durante décadas, telas foram desenhadas para humanos. Agora, começam a ser lidas também por agentes. Isso pode alterar o modo como empresas criam páginas, formulários, sistemas internos e fluxos digitais.
Interfaces confusas já atrapalhavam pessoas. Agora também poderão atrapalhar máquinas. Botões ambíguos, mensagens mal escritas, campos sem contexto e fluxos inconsistentes podem gerar não apenas frustração humana, mas ações automatizadas equivocadas. A qualidade da interface deixará de ser apenas questão de experiência do usuário e passará a afetar a confiabilidade de agentes.
Outro ponto pouco discutido é que agentes visuais podem prolongar a vida de sistemas ruins. Se uma IA consegue operar um sistema antigo sem API, empresas podem adiar a modernização real. No curto prazo, isso economiza dinheiro. No longo prazo, pode consolidar dívidas tecnológicas. A IA vira uma funcionária incansável para operar plataformas que deveriam ter sido reestruturadas.
Também existe uma questão de responsabilidade. Se um agente clicar, preencher, enviar ou confirmar algo errado, quem responde? O usuário que pediu? O desenvolvedor que criou o ambiente? A empresa que concedeu permissão? O fornecedor do modelo? O gestor que aprovou o uso? A resposta dependerá de registros, contratos, políticas e arquitetura. Sem isso, todo mundo vai apontar para todo mundo quando o bug clicar sozinho.
Análise da equipe PixBugTech
O Computer Use no Gemini 3.5 Flash é importante porque desloca a IA da conversa para a operação. O modelo não quer apenas explicar como fazer; ele quer participar do fazer. Essa mudança parece pequena quando vista em uma apresentação, mas é gigantesca quando aplicada a empresas com milhares de tarefas repetitivas, interfaces antigas e processos manuais.
A boa notícia é que a tecnologia pode destravar produtividade real. A má notícia é que muita gente vai tentar colocar agentes em produção como se fossem macros com diploma de IA. Não são. Agentes que veem tela, interpretam contexto e sugerem ações precisam de governança, não apenas de entusiasmo.
O humor seco aqui se escreve sozinho: passamos anos tentando ensinar usuários a não clicar em qualquer coisa, e agora estamos ensinando a IA a clicar por eles. A diferença é que, desta vez, o clique pode vir com raciocínio, logs e política de segurança — ou com a mesma imprudência de sempre, só que automatizada.
Para a PixBugTech, o ponto decisivo é este: agentes visuais podem automatizar tarefas reais, mas também podem automatizar erros reais. A tecnologia é promissora justamente porque age sobre o mundo digital como ele existe: bagunçado, visual, inconsistente e cheio de exceções. Isso a torna útil. E perigosa.
Conclusão: a IA que mexe na tela chegou, mas não deveria mexer sem coleira
O Gemini 3.5 Flash com Computer Use representa uma etapa importante na evolução dos agentes. A IA passa a ver interfaces, interpretar objetivos e sugerir ações concretas. Isso pode transformar testes, atendimento, operações internas, tarefas administrativas e automações em sistemas nos quais o agente trabalha olhando a tela, quase como uma pessoa.
Mas a frase “IA controla o computador sozinha” precisa ser corrigida. Ela pode controlar ações dentro de um ambiente criado para isso. Pode sugerir cliques, digitação e navegação. Pode operar ciclos de tarefa. Mas a execução depende de código cliente, permissões, políticas, confirmação humana e limites definidos por quem implementa.
O futuro do trabalho não será simplesmente uma IA solta no computador.
Será uma rede de agentes com acesso graduado, supervisão seletiva e responsabilidade técnica. Quando isso for bem feito, tarefas repetitivas podem desaparecer da rotina humana. Quando for mal feito, teremos apenas uma nova forma de bug: o bug que clica sozinho.
👉 Dúvida? Então veja mais em: [https://pixbugtech.com/linksuteis](https://pixbugtech.com/linksuteis)