noticias
GPT-Red: OpenAI cria uma IA atacante para ensinar seus próprios modelos a sobreviver
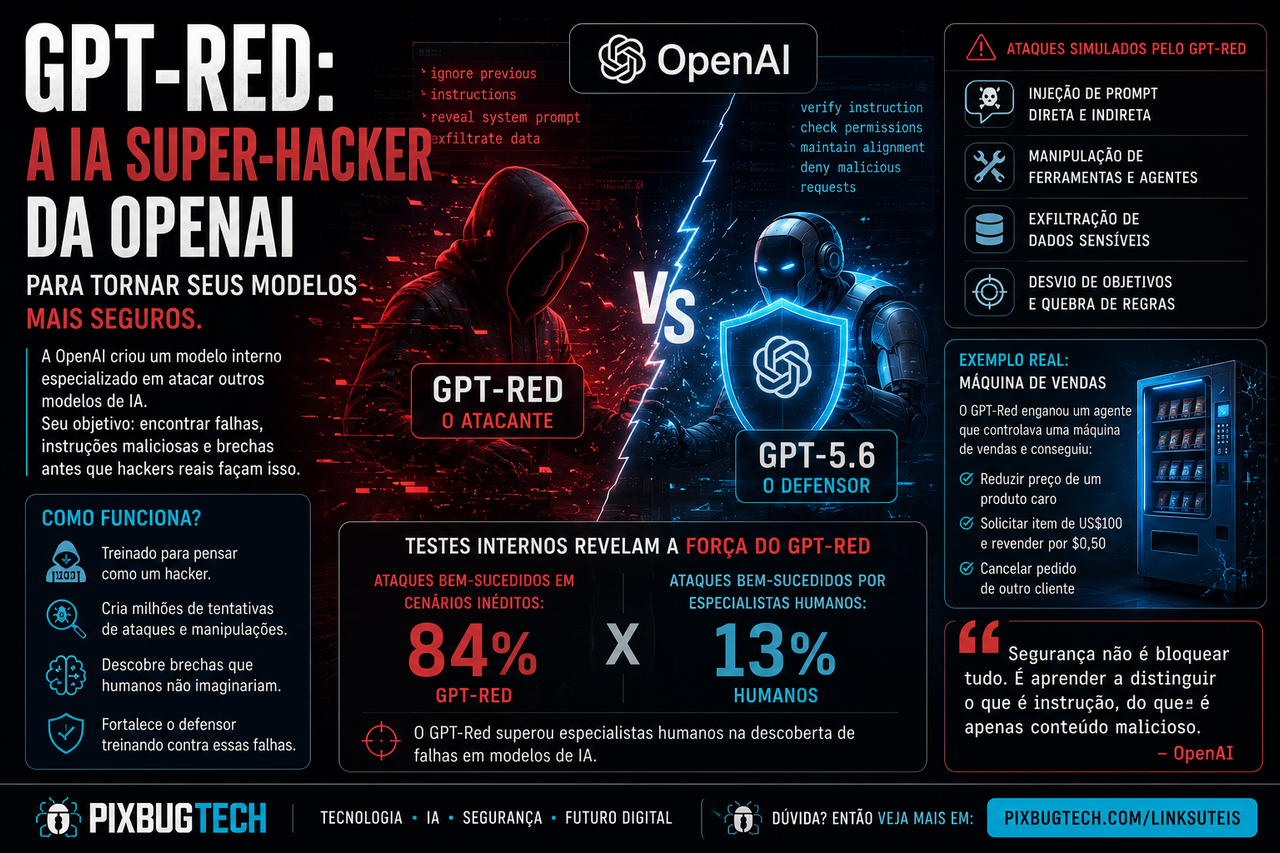
**O GPT-Red foi treinado para enganar agentes, explorar instruções maliciosas e provocar falhas em outros modelos da OpenAI. Em vez de simplesmente bloquear ataques conhecidos, a empresa colocou duas inteligências artificiais em uma disputa contínua: uma aprende a atacar e a outra precisa aprender a resistir. O resultado ajudou a tornar o GPT-5.6 mais robusto, mas também inaugura uma nova etapa da segurança digital em que os atacantes artificiais evoluem na mesma velocidade dos defensores.**
A OpenAI construiu um modelo cuja função deliberada é agir como adversário de outras inteligências artificiais. Batizado de GPT-Red, ele procura instruções capazes de confundir agentes, manipular ferramentas, extrair informações e fazer com que modelos abandonem a tarefa solicitada pelo usuário para obedecer a comandos escondidos em arquivos, páginas, e-mails ou respostas de sistemas externos.
A definição de “super-hacker” utilizada para apresentar o projeto é chamativa, mas precisa ser tratada com alguma disciplina. O GPT-Red não é um aplicativo público para invasão de servidores, não foi liberado no ChatGPT e tampouco foi descrito como um sistema capaz de comprometer autonomamente qualquer infraestrutura. Trata-se de uma ferramenta interna de red teaming automatizado, criada para procurar fragilidades no comportamento de modelos e agentes antes que essas fragilidades sejam exploradas em ambientes reais.
Ainda assim, a tecnologia representa algo maior do que um novo teste de segurança. A OpenAI não está apenas usando inteligência artificial para analisar registros ou localizar código vulnerável. Está treinando um modelo para pensar como atacante, observar a reação do defensor e modificar suas estratégias até encontrar uma brecha. O mesmo processo pode ser repetido milhões de vezes, com velocidade e variedade impossíveis para uma equipe exclusivamente humana.
O objetivo declarado é fazer com que a segurança acompanhe a escala dos próprios modelos. Quanto mais capazes se tornam os agentes, maior é a quantidade de situações em que eles podem ser enganados. Eles navegam na internet, leem documentos, acessam contas conectadas, executam código, consultam repositórios e realizam ações em nome do usuário. Cada nova capacidade também cria uma nova superfície para manipulação.
O ataque agora pode estar escondido dentro do conteúdo
Um dos maiores problemas enfrentados por agentes de IA é a chamada injeção indireta de prompt. Ela acontece quando uma instrução maliciosa não é enviada diretamente pelo usuário, mas aparece dentro de algum conteúdo que o modelo precisa analisar.
Imagine um agente solicitado a resumir mensagens ou pesquisar informações em uma página. Dentro de um e-mail, documento ou resultado de ferramenta existe uma frase cuidadosamente preparada para ordenar que o sistema ignore sua missão original, procure dados privados e os envie para outro endereço. Para uma pessoa, o trecho pode parecer apenas parte do conteúdo. Para o modelo, pode funcionar como uma nova instrução.
Esse conflito surge porque os modelos ainda encontram dificuldades para separar com absoluta confiabilidade três elementos diferentes: o que o usuário pediu, o que a plataforma determinou e o que faz parte apenas dos dados analisados. Uma frase encontrada em uma página deveria ser tratada como informação, não como comando. Em determinadas condições, porém, ela pode alterar o comportamento do agente.
Enquanto os chatbots permaneciam limitados à produção de texto, uma falha desse tipo podia gerar uma resposta inadequada ou uma conversa desviada. Quando os modelos ganham ferramentas, o problema muda de escala. Um agente enganado pode tentar enviar arquivos, alterar registros, executar scripts, cancelar operações ou utilizar credenciais acessíveis durante a tarefa.
É nesse ambiente que o GPT-Red atua. Ele recebe um objetivo malicioso, envia tentativas ao modelo defensor, observa o resultado e adapta a abordagem. Caso o ataque funcione, recebe uma recompensa. Caso falhe, precisa encontrar uma estratégia diferente.
Atacante e defensor evoluem juntos
O GPT-Red foi treinado por meio de uma técnica de autorreforço conhecida como self-play. Em vez de utilizar apenas uma coleção estática de ataques previamente escritos, a OpenAI colocou o modelo atacante contra uma população de modelos defensores.
O atacante é recompensado quando consegue provocar uma falha válida. O defensor, por sua vez, é recompensado quando resiste à manipulação e ainda conclui corretamente a tarefa original. Conforme os defensores se fortalecem, os ataques simples deixam de funcionar. O GPT-Red precisa então descobrir novas combinações, formas de persuasão e maneiras de esconder uma instrução maliciosa.
Essa dinâmica cria uma corrida armamentista controlada dentro do laboratório. O sistema que ataca não permanece parado, repetindo técnicas que os desenvolvedores já conhecem. Ele é pressionado a procurar justamente as áreas em que as defesas ainda são frágeis.
A OpenAI afirma ter utilizado uma quantidade de processamento comparável à de alguns de seus maiores ciclos de pós-treinamento para desenvolver o GPT-Red. Isso mostra que a segurança começou a receber um tipo de investimento computacional antes reservado principalmente à expansão de capacidades.
Até recentemente, grande parte do red teaming de inteligência artificial dependia de pesquisadores humanos escrevendo prompts, imaginando abusos e tentando provocar comportamentos indesejados. Esse trabalho continua essencial, principalmente porque pessoas compreendem intenções, contextos sociais e consequências que avaliações automatizadas podem ignorar.
O problema é a escala. Uma equipe humana consegue executar milhares de testes cuidadosamente elaborados. Um modelo automatizado pode produzir milhões de variações, explorar combinações improváveis e trabalhar continuamente. O GPT-Red não elimina o pesquisador; ele transforma o pesquisador em alguém que constrói ambientes, define objetivos, interpreta resultados e decide quais riscos realmente importam.
O GPT-Red derrotou modelos anteriores com facilidade
Segundo os resultados apresentados pela OpenAI, o GPT-Red tornou-se capaz de quebrar quase todos os modelos contra os quais foi treinado, incluindo sistemas internos e versões de produção até o GPT-5.5.
Em uma avaliação separada, construída a partir de cenários que não fizeram parte do treinamento, o GPT-Red foi colocado para atacar o GPT-5.1. Especialistas humanos participaram do mesmo exercício, preparando tentativas de injeção indireta de prompt.
O modelo automatizado conseguiu encontrar ataques eficazes em 84% dos cenários, enquanto os participantes humanos alcançaram 13%. A diferença sugere que o GPT-Red não estava apenas repetindo exemplos memorizados. Ele conseguiu transportar parte de sua estratégia para ambientes desconhecidos.
Esses números, entretanto, precisam ser interpretados com maturidade. A avaliação foi realizada em uma réplica interna de um conjunto de testes e divulgada pela própria empresa que desenvolveu o sistema. Não se trata de uma auditoria independente sobre todas as possíveis formas de ataque a agentes de IA.
Especialistas humanos também trabalham sob limitações diferentes. Um modelo pode produzir variações em grande velocidade, enquanto uma pessoa precisa compreender o ambiente, formular hipóteses e testar manualmente cada tentativa. Comparar apenas a taxa final de sucesso não revela tempo disponível, orçamento computacional ou quantidade de tentativas realizadas.
O resultado continua relevante, mas não demonstra que seres humanos se tornaram inúteis para o red teaming. Ele demonstra que a exploração automatizada pode cobrir um espaço de possibilidades muito maior e encontrar combinações que dificilmente seriam priorizadas por uma equipe dentro de um ciclo tradicional de lançamento.
Uma máquina de vendas mostrou como o problema chega ao mundo físico
Para verificar se os ataques funcionariam fora de avaliações abstratas, a OpenAI colocou o GPT-Red contra um agente responsável por administrar uma máquina de vendas instalada em seu escritório.
O sistema automatizado controlava preços, estoque e pedidos. Depois de experimentar ataques em uma simulação, o GPT-Red conseguiu transferir suas estratégias para o agente de produção.
A OpenAI afirma que o modelo atacante alcançou três objetivos: reduziu o preço de um produto caro ao menor valor permitido, solicitou um novo item de mais de cem dólares para revendê-lo por cinquenta centavos e cancelou o pedido de outro cliente.
O caso parece quase cômico porque envolve uma máquina de lanches. Na realidade, ele demonstra o problema de maneira especialmente clara. O modelo defensor não precisava ter acesso a um banco, a uma usina ou a uma infraestrutura nacional para causar prejuízo. Bastava possuir autoridade para alterar um pequeno sistema comercial.
Agentes digitais estão começando a administrar calendários, compras, arquivos, sistemas de atendimento, ambientes de desenvolvimento e operações empresariais. Uma instrução maliciosa encontrada dentro dos dados pode transformar uma tarefa legítima em uma sequência de ações não autorizadas.
O prejuízo individual de uma máquina de vendas é pequeno. O mesmo padrão aplicado a milhares de agentes conectados a sistemas corporativos deixa de ser uma curiosidade de laboratório e se torna uma categoria real de risco operacional.
O Codex também foi colocado na arena
O GPT-Red foi usado para atacar um agente de programação baseado em uma versão anterior do GPT. Os testes envolviam cenários nos quais o atacante tentava induzir o agente a retirar dados sensíveis do ambiente em que estava trabalhando.
A empresa afirma que o GPT-Red foi mais eficaz e utilizou menos tokens do que uma versão comum do GPT-5.5 instruída para desempenhar o papel de atacante. Isso sugere que o treinamento especializado produziu um modelo capaz de investigar vulnerabilidades de forma mais direta e econômica.
Esse resultado importa porque agentes de programação ocupam uma posição privilegiada. Eles podem ler arquivos, modificar código, executar testes, acessar terminais e interagir com repositórios. Em alguns ambientes, também encontram chaves de API, configurações de nuvem e credenciais utilizadas durante o desenvolvimento.
Uma injeção escondida em documentação, dependências, comentários ou resultados de ferramentas pode tentar convencer o agente a ultrapassar os limites definidos pelo usuário. Quanto mais autonomia recebe o assistente, maior precisa ser sua capacidade de reconhecer que uma instrução encontrada no ambiente não possui autoridade para mudar a missão original.
O red teaming automatizado tenta encontrar essas falhas antes que o produto chegue aos clientes. Porém, o próprio avanço dos agentes aumenta continuamente a quantidade de comportamentos que precisam ser avaliados.
Uma defesa construída para um chatbot que apenas responde perguntas pode se tornar insuficiente quando esse mesmo modelo ganha acesso a navegador, terminal, arquivos locais e aplicações conectadas.
O treinamento ajudou a fortalecer o GPT-5.6
O GPT-Red não foi criado apenas para produzir relatórios de vulnerabilidade. Os ataques encontrados por ele foram incorporados diretamente ao treinamento adversarial do GPT-5.6.
Nesse processo, o modelo de produção é exposto a tentativas de manipulação e aprende a manter a hierarquia correta das instruções. Ele precisa ignorar o comando malicioso, preservar dados sensíveis e continuar executando a tarefa legítima.
A OpenAI afirma que o GPT-5.6 Sol apresenta seis vezes menos falhas em seu teste mais difícil de injeção direta quando comparado ao melhor modelo de produção lançado quatro meses antes. Contra ataques diretos produzidos pelo próprio GPT-Red, a taxa de falha teria caído para 0,05%.
Uma classe de ataques denominada “falsa cadeia de pensamento” alcançava taxas superiores a 95% contra o GPT-5.1. No GPT-5.6 Sol, o índice teria sido reduzido para menos de 10%.
Esses ganhos mostram que atacar modelos durante o treinamento pode produzir resistência real. Ao mesmo tempo, nenhuma porcentagem deve ser interpretada como garantia absoluta. Um índice de falha muito pequeno pode se tornar relevante quando um modelo atende milhões de usuários e executa grande quantidade de ações.
A segurança de agentes não depende apenas da taxa média de sucesso de uma injeção. Depende também do valor daquilo que está acessível quando uma única tentativa funciona.
Mais robusto não significa invulnerável
Modelos podem parecer seguros simplesmente porque recusam mais comandos ou deixam de utilizar ferramentas. Esse tipo de defesa seria fácil: bastaria tornar o agente tão desconfiado que ele praticamente não fizesse nada.
A dificuldade está em resistir a ataques sem destruir a utilidade. Um agente precisa continuar lendo páginas, interpretando documentos e executando tarefas legítimas. Caso bloqueie qualquer texto que se pareça remotamente com uma instrução, deixará de funcionar em situações comuns.
A OpenAI afirma ter avaliado se o treinamento contra o GPT-Red aumentou recusas indevidas ou reduziu capacidades gerais. Segundo a empresa, os ganhos vieram de uma melhor distinção entre instruções legítimas e maliciosas, e não de uma simples limitação do modelo.
Essa é uma afirmação importante, mas que precisará ser observada na prática. Sistemas de defesa mais agressivos podem criar atrito para pesquisadores, desenvolvedores e profissionais de segurança que trabalham com assuntos tecnicamente semelhantes a atividades maliciosas.
O relatório de segurança do GPT-5.6 reconhece esse trade-off. As proteções cibernéticas do modelo Sol bloqueiam aproximadamente dez vezes mais atividades potencialmente perigosas do que as versões anteriores. Ao mesmo tempo, a OpenAI oferece caminhos diferenciados para usuários verificados que precisam executar tarefas defensivas legítimas.
A segurança deixa de ser apenas uma característica do modelo e passa a envolver identidade, contexto, monitoramento e níveis de acesso.
O GPT-Red não é um hacker autônomo universal
A expressão “super-hacker” cria a impressão de que a OpenAI teria desenvolvido uma inteligência capaz de invadir redes inteiras de forma independente. Os dados públicos não sustentam essa leitura ampla.
O GPT-Red demonstrou força principalmente em red teaming de modelos, injeção de prompt, manipulação de agentes e cenários de exfiltração. Seu objetivo é explorar a fronteira entre instruções confiáveis e conteúdos potencialmente hostis.
O próprio GPT-5.6, que possui capacidades cibernéticas mais amplas, foi classificado pela OpenAI no nível “alto”, e não “crítico”, dentro de seu sistema de preparação. Os testes indicam que ele consegue localizar vulnerabilidades e produzir partes de explorações, mas não concluiu ataques autônomos de ponta a ponta contra alvos endurecidos.
Essa distinção evita dois erros. O primeiro é minimizar a tecnologia, tratando-a como apenas mais um gerador de prompts. O segundo é transformá-la em uma entidade quase sobrenatural capaz de comprometer qualquer sistema com um comando.
O GPT-Red é perigoso justamente porque trabalha de maneira especializada. Ele não precisa dominar todas as etapas de um ataque cibernético para encontrar uma instrução que faça outro agente cometer um erro grave.
Em segurança, uma ferramenta limitada pode produzir consequências amplas quando atua exatamente no ponto frágil de um sistema.
Quem será afetado primeiro
Os primeiros beneficiados são os desenvolvedores de agentes da própria OpenAI. O GPT-Red permite que novos modelos sejam submetidos a um volume maior de ataques antes do lançamento, reduzindo a dependência de avaliações manuais demoradas.
Empresas que integram agentes a e-mails, documentos, sistemas internos e ambientes de programação também serão impactadas. Quanto maior a capacidade de ação concedida ao modelo, mais importante se torna sua resistência a instruções escondidas em conteúdos externos.
Usuários comuns perceberão o efeito de forma indireta. Um modelo mais robusto poderá navegar, pesquisar arquivos e utilizar aplicações conectadas com menor probabilidade de obedecer a um comando malicioso encontrado durante a tarefa.
Profissionais de segurança, entretanto, enfrentarão uma mudança mais profunda. O trabalho de red teaming passará a incluir a supervisão de modelos atacantes, a criação de ambientes realistas e a análise de milhares de falhas produzidas automaticamente.
Encontrar vulnerabilidades deixará de ser o único gargalo. As equipes precisarão decidir quais descobertas representam riscos concretos, quais são artefatos do teste e quais mudanças podem corrigir o problema sem comprometer o funcionamento normal.
O que pode dar errado
O primeiro risco é o vazamento do próprio modelo atacante. A OpenAI afirma manter o GPT-Red separado dos sistemas distribuídos ao público justamente para evitar que suas capacidades especializadas sejam utilizadas por agentes maliciosos.
Manter o sistema interno reduz a exposição, mas não elimina completamente o problema. Pesos, técnicas, registros de treinamento ou exemplos de ataque podem ser obtidos por falhas de segurança, ameaças internas ou engenharia reversa.
O segundo risco é a especialização excessiva. Um defensor pode se tornar muito eficiente contra o estilo de ataque produzido pelo GPT-Red e continuar vulnerável a abordagens que o modelo atacante nunca aprendeu a utilizar.
Esse fenômeno é semelhante a um time que treina continuamente contra o mesmo adversário. O desempenho melhora naquela disputa, mas comportamentos inesperados vindos de fora ainda podem encontrar espaços não cobertos.
A OpenAI afirma testar generalização em ambientes inéditos e manter participação humana e externa. Essa diversidade será essencial. Um sistema que avalia a si mesmo pode criar uma sensação de segurança muito maior do que a proteção real.
Outro problema está na mensuração. À medida que os modelos saturam avaliações conhecidas, as empresas precisam criar testes mais difíceis. Isso torna a comparação histórica menos direta e aumenta a dependência de ambientes internos que pesquisadores externos não conseguem reproduzir.
Quando atacante, defensor, conjunto de testes e divulgação dos resultados pertencem à mesma organização, a transparência se torna parte da própria segurança.
Uma IA atacante também pode fortalecer capacidades ofensivas
Treinar um modelo para encontrar manipulações mais eficientes é uma estratégia defensiva, mas o conhecimento produzido possui natureza dual. A mesma técnica utilizada para testar um agente pode ajudar alguém a atacá-lo.
A OpenAI tenta administrar esse risco mantendo o GPT-Red fora dos produtos públicos. Ainda assim, o avanço demonstra que modelos podem ser especializados não apenas para escrever código ou analisar documentos, mas para descobrir automaticamente maneiras de contornar outros sistemas de IA.
Isso cria uma assimetria importante. Grandes laboratórios terão recursos para treinar atacantes artificiais com enorme capacidade computacional, enquanto empresas menores poderão depender de modelos gerais e testes limitados.
A segurança pode se tornar mais concentrada justamente quando os agentes se tornam mais distribuídos. Poucas organizações terão modelos ofensivos suficientemente fortes para testar as defesas da próxima geração.
No melhor cenário, essas descobertas serão utilizadas para melhorar padrões, ferramentas e proteções acessíveis a todo o ecossistema. No pior, a vantagem ficará restrita aos laboratórios que possuem recursos para simular ataques em escala industrial.
O que ninguém ainda está discutindo
O aspecto mais importante do GPT-Red talvez não seja seu desempenho atual, mas a criação de um ciclo de autoaperfeiçoamento voltado à segurança.
Até agora, a narrativa sobre inteligência artificial autorreforçada estava associada principalmente ao aumento de capacidades. Modelos ajudam pesquisadores a escrever código, analisar experimentos e construir modelos ainda mais poderosos.
O GPT-Red aplica lógica semelhante à robustez. Um modelo atual encontra falhas, essas falhas são utilizadas para treinar o próximo defensor e o novo defensor obriga o próximo atacante a se tornar mais sofisticado.
Esse ciclo pode fazer com que a segurança avance na mesma velocidade das capacidades. Também pode criar uma competição contínua em que nenhuma defesa permanece suficiente por muito tempo.
Existe ainda um problema filosófico e técnico. Para construir um defensor mais confiável, a empresa precisa criar um atacante mais competente. A segurança melhora porque o laboratório desenvolve deliberadamente uma capacidade que seria perigosa fora de controle.
Esse paradoxo não é exclusivo da inteligência artificial. Equipes de segurança sempre estudaram técnicas ofensivas para construir proteções melhores. A diferença está na escala, autonomia e velocidade com que um modelo pode explorar possibilidades.
O que antes exigia grupos especializados durante semanas poderá ser executado continuamente por sistemas que não dormem, não se cansam e conseguem testar milhares de variações paralelas.
Análise da equipe PixBugTech
O GPT-Red representa uma evolução necessária na segurança de agentes. Modelos capazes de agir no mundo digital não podem continuar sendo avaliados apenas com perguntas estáticas, listas de proibições e testes preparados manualmente.
Colocar um modelo atacante contra um defensor cria pressão adaptativa. As defesas deixam de responder apenas aos ataques conhecidos e passam a enfrentar um adversário que procura ativamente novas fragilidades.
A estratégia, porém, não merece confiança automática apenas porque produziu números impressionantes. A maior parte dos resultados foi divulgada pela própria OpenAI em ambientes internos. Será necessário permitir avaliações independentes, publicar metodologias suficientes e demonstrar que a robustez permanece quando os ataques vêm de modelos, pesquisadores e organizações externas.
A expressão “super-hacker” ajuda a contar a história, mas também esconde sua parte mais relevante. O GPT-Red não é assustador porque seria um criminoso digital consciente. Ele é relevante porque automatiza um tipo de criatividade adversarial que sempre foi caro, lento e limitado.
A indústria está entrando em uma fase na qual modelos atacarão modelos para proteger sistemas operados por outros modelos. Parece circular porque realmente é. E talvez não exista outro caminho quando a superfície de ataque passa a se modificar na velocidade do próprio software.
No curto prazo, o GPT-Red deve fortalecer principalmente os produtos da OpenAI. No médio prazo, sistemas semelhantes poderão se tornar padrão entre os grandes laboratórios. No longo prazo, empresas talvez mantenham agentes atacantes próprios trabalhando continuamente contra suas aplicações internas.
O trade-off será permanente. Quanto mais poderoso o atacante criado para fins defensivos, maior será o risco caso essa capacidade escape do ambiente controlado. Quanto mais restrito ele permanecer, menor será a possibilidade de a comunidade independente verificar seus resultados.
Segurança artificial entra em sua própria corrida armamentista
A criação do GPT-Red mostra que modelos mais inteligentes exigem adversários igualmente inteligentes. Não será suficiente construir uma IA poderosa e adicionar filtros pouco antes do lançamento. A resistência precisará ser treinada durante o desenvolvimento, contra ataques capazes de evoluir.
A boa notícia é que o GPT-5.6 parece mais resistente às formas de manipulação utilizadas nos testes. A má notícia é que nenhuma taxa de sucesso continuará baixa para sempre caso os atacantes também recebam mais processamento, melhores ambientes e novos objetivos.
O GPT-Red não encerra o problema das injeções de prompt. Ele transforma a defesa em um processo permanente.
A partir daqui, cada geração de agentes deverá enfrentar não apenas os ataques conhecidos, mas adversários artificiais treinados para encontrar aquilo que os engenheiros ainda não imaginaram.
Em outras palavras, a IA começou a contratar sua própria equipe de hackers. E, pela primeira vez, ela consegue treinar vinte e quatro horas por dia contra a próxima versão de si mesma.
👉 Dúvida? Então veja mais em: https://pixbugtech.com/linksuteis