noticias
Hack expõe código da Suno e revela a escala industrial por trás da música gerada por IA
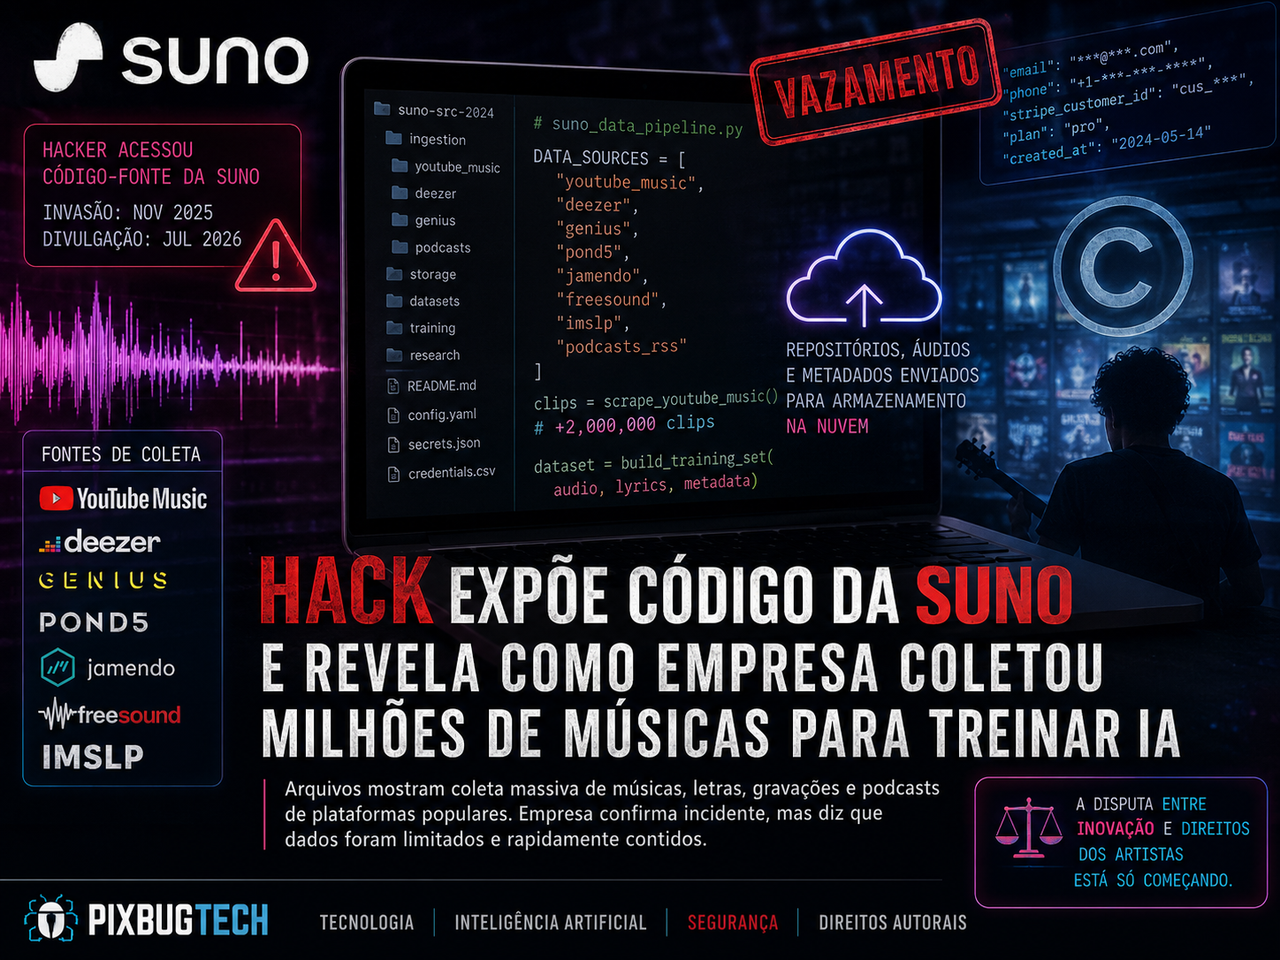
**Arquivos obtidos durante uma invasão indicam que a Suno construiu parte de sua infraestrutura de treinamento coletando milhões de músicas, letras, gravações, bibliotecas sonoras e podcasts disponíveis na internet. Mais do que confirmar uma suspeita antiga, o episódio mostra como a indústria da IA transformou a cultura digital em matéria-prima antes de construir mecanismos claros de autorização, rastreabilidade e remuneração.**
A Suno tornou-se uma das plataformas mais conhecidas da inteligência artificial generativa ao permitir que qualquer pessoa produza uma música completa a partir de poucas palavras. Em segundos, o serviço consegue gerar instrumentação, estrutura, vocais, letra e acabamento suficientemente convincente para circular em vídeos, redes sociais e plataformas de streaming. Por trás dessa simplicidade existe, entretanto, uma infraestrutura alimentada por uma quantidade monumental de obras humanas, cuja origem permaneceu durante anos envolta em respostas genéricas sobre arquivos publicamente disponíveis na internet.
Uma invasão sofrida pela empresa em novembro de 2025 abriu uma rara janela para esse processo. O material acessado pelo invasor, divulgado apenas em julho de 2026, incluía código-fonte antigo, instruções de coleta, referências a conjuntos de treinamento e informações relacionadas a clientes. A documentação indica que a Suno construiu mecanismos para extrair áudio, letras e metadados de serviços como YouTube Music, Deezer, Genius, Pond5, Jamendo, Freesound, MuseScore e a biblioteca internacional de partituras IMSLP, além de demonstrar interesse em grandes volumes de podcasts distribuídos por RSS.
O episódio não prova, sozinho, que todas as obras mencionadas foram utilizadas da mesma maneira, que cada arquivo permaneceu nos modelos atuais ou que a empresa reproduziu integralmente músicas específicas em suas respostas. Ele revela, porém, a escala, a metodologia e a intencionalidade de uma operação de coleta que até agora era conhecida principalmente por meio de alegações judiciais e declarações cuidadosamente limitadas. O problema deixa de ser apenas saber se a Suno treinou seus modelos com música protegida. A pergunta passa a ser como esse material foi obtido, quais barreiras técnicas foram contornadas e que tipo de responsabilidade nasce quando uma plataforma comercial transforma décadas de produção cultural em infraestrutura privada.
Uma invasão antiga que só agora se tornou pública
Segundo as informações divulgadas, o ataque ocorreu em novembro de 2025. O invasor afirmou ter comprometido um funcionário da Suno por meio de um ataque à cadeia de fornecimento, obtendo posteriormente credenciais que permitiram acesso a serviços de desenvolvimento, repositórios de código e ambientes de nuvem.
A descrição pública ainda depende, em boa parte, do relato do próprio invasor e das informações analisadas pela publicação que recebeu os arquivos. Não existe até o momento uma auditoria independente capaz de reconstruir toda a sequência do ataque, determinar a permanência do acesso ou confirmar cada item que teria sido copiado. Isso exige cautela, especialmente porque vazamentos podem misturar documentos legítimos, versões antigas, interpretações incompletas e alegações difíceis de verificar.
A Suno, contudo, confirmou que sofreu um incidente. A empresa afirma que a ocorrência foi limitada, rapidamente contida e relacionada principalmente a código-fonte antigo que já não estaria em uso. Essa resposta pode ser tecnicamente verdadeira e ainda assim insuficiente para encerrar o debate. Um código desativado talvez não represente a arquitetura atual da plataforma, mas continua relevante para demonstrar como determinados conjuntos de dados foram formados no passado.
Modelos de inteligência artificial não esquecem automaticamente a origem de seu treinamento quando o software de coleta é aposentado. Caso o material obtido por aquele sistema tenha sido utilizado para desenvolver modelos, ajustar representações sonoras ou construir bases intermediárias, a retirada do coletor não elimina o papel histórico daqueles arquivos. Código antigo pode perder valor operacional e conservar enorme valor probatório.
Mais de 2 milhões de clipes em apenas um dos registros
Entre os arquivos analisados havia uma referência a 2.013.545 clipes provenientes do YouTube Music. Outros registros descreviam centenas de milhares de horas distribuídas entre áudio musical, letras, bibliotecas de efeitos, partituras e gravações disponíveis em diferentes serviços.
Os números precisam ser interpretados com cuidado. Eles aparecem em comentários e estruturas de código relacionadas a conjuntos de dados, não em uma auditoria pública consolidada. Não é possível afirmar que cada hora registrada foi incorporada integralmente ao modelo final, permaneceu em todas as versões ou recebeu o mesmo peso durante o treinamento. Ainda assim, o volume documentado é grande o suficiente para revelar uma coleta em escala industrial.
Outro trecho indicava que a empresa buscava aproximadamente um milhão de horas de podcasts por meio de uma plataforma de indexação de feeds. Essa informação amplia o alcance do debate, porque podcasts não são apenas arquivos de áudio. Eles contêm vozes, sotaques, entrevistas, interpretações, performances, vinhetas, trilhas, relatos pessoais e material protegido por diferentes direitos.
A coleta de conteúdo falado pode ajudar modelos a compreender pronúncia, ritmo, entonação e características vocais. Ao mesmo tempo, aproxima a tecnologia de questões envolvendo identidade, clonagem de voz e consentimento. Um sistema treinado para produzir música não aprende apenas acordes e melodias. Ele pode absorver padrões de expressão humana que pertencem a apresentadores, cantores, atores, entrevistados e pessoas que jamais imaginaram integrar um conjunto de treinamento comercial.
O papel do YouTube é juridicamente mais delicado do que parece
A Suno reconhece oficialmente que seus modelos foram treinados com arquivos musicais e metadados publicamente acessíveis na internet. Em sua documentação, a empresa afirma que seus conjuntos incluem dezenas de milhões de arquivos e podem conter material protegido por propriedade intelectual. Sua defesa central é que o treinamento de modelos constitui uso transformador e pode ser amparado pela doutrina norte-americana do fair use.
Esse argumento ainda está sendo disputado nos tribunais. Ser publicamente acessível não significa estar em domínio público, livre de direitos autorais ou disponível para qualquer forma de exploração. Uma música pode ser escutada gratuitamente em uma plataforma e continuar protegida por uma complexa combinação de direitos sobre gravação, composição, letra, interpretação e distribuição.
O caso se torna ainda mais sensível quando a coleta depende de métodos que contornam mecanismos destinados a impedir downloads. As gravadoras que processam a Suno alegam que a empresa não apenas acessou obras protegidas, mas realizou extrações conhecidas como stream ripping, convertendo transmissões de áudio em arquivos utilizáveis para treinamento. Essa acusação cria uma frente jurídica diferente da discussão tradicional sobre fair use.
Mesmo que um tribunal considere transformador o uso de uma obra durante o treinamento, isso não necessariamente autoriza a violação de barreiras técnicas, termos de serviço ou proteções implementadas por uma plataforma. Direitos autorais, regras contratuais e normas contra a circumvenção tecnológica podem produzir responsabilidades distintas.
Essa separação será decisiva para o futuro da IA. As empresas gostariam que a discussão fosse resumida a uma única pergunta: treinar modelos com obras protegidas é permitido? Na prática, os tribunais podem precisar avaliar várias etapas independentes, incluindo aquisição, cópia, armazenamento, processamento, treinamento, geração e distribuição dos resultados.
A busca por versões a cappella revela o tipo de conhecimento desejado
O material vazado sugere que a Suno procurava versões a cappella de músicas, isto é, gravações nas quais a voz aparece isolada ou com interferência instrumental reduzida. Essa escolha é tecnicamente compreensível. Para aprender a gerar vocais convincentes, um sistema se beneficia de exemplos nos quais timbre, pronúncia, respiração, articulação e dinâmica podem ser analisados com maior clareza.
Mas esse detalhe também revela que a coleta não se limitava a construir uma compreensão genérica sobre gêneros musicais. A infraestrutura parecia procurar componentes específicos da criação: voz, acompanhamento, letras, partituras, efeitos, metadados e classificações. Em vez de simplesmente observar canções completas, o processo buscava decompor a música em elementos reutilizáveis pelo aprendizado de máquina.
Esse é um dos pontos menos discutidos sobre modelos generativos. Eles não precisam armazenar uma música como uma pessoa guarda um arquivo MP3 para extrair valor dela. O treinamento transforma obras em relações matemáticas capazes de representar padrões, estruturas e probabilidades. A música original pode não estar recuperável de forma perfeita, mas seu trabalho artístico contribui para uma capacidade comercial que não existiria sem aquele repertório.
A indústria costuma usar essa transformação matemática para argumentar que o modelo não funciona como uma biblioteca tradicional. Artistas e gravadoras respondem que a mudança de formato não elimina o fato econômico essencial: obras foram copiadas e processadas para criar um serviço capaz de competir no mesmo mercado da produção humana.
Dados de clientes também entraram na discussão
O invasor afirmou ter acessado informações relacionadas a centenas de milhares de clientes, incluindo endereços de e-mail, números de telefone e dados associados a pagamentos processados pela Stripe. A Suno contesta a interpretação de que informações pessoais sensíveis tenham sido comprometidas e ressalta que não possui acesso aos números completos dos cartões de crédito dos clientes.
As duas afirmações não são necessariamente incompatíveis. Uma empresa pode não armazenar números completos de cartão e ainda manter nomes, contatos, identificadores de transações, partes mascaradas do cartão, planos contratados e outros registros comerciais. O termo “informação sensível” também pode ter significado jurídico mais restrito do que aquele compreendido pelo consumidor comum.
Para uma pessoa, ter e-mail e telefone expostos já pode representar aumento de risco. Esses dados alimentam campanhas de phishing, tentativas de recuperação fraudulenta de contas, mensagens personalizadas e golpes que exploram o conhecimento de que a vítima utiliza determinado serviço.
A Suno decidiu não notificar individualmente os clientes porque entendeu que a natureza limitada das informações não exigia comunicação pelas leis aplicáveis. Essa conclusão pode estar juridicamente correta nas jurisdições analisadas, mas deixa uma questão de confiança. O mínimo exigido pela lei não corresponde necessariamente ao nível de transparência esperado por alguém que paga pelo serviço e fornece dados pessoais à plataforma.
O intervalo entre novembro de 2025 e julho de 2026 agrava essa percepção. Durante meses, usuários continuaram utilizando a Suno sem saber que um terceiro havia acessado parte da infraestrutura da empresa. Mesmo que a ocorrência tenha sido contida e não tenha resultado em fraude conhecida, a ausência de comunicação retirou dos clientes a oportunidade de adotar precauções por conta própria.
Quem será impactado primeiro
Os primeiros afetados são artistas, compositores, produtores, editoras e gravadoras que tentam determinar se suas obras integraram os conjuntos utilizados pela Suno. A identificação individual, entretanto, é difícil. Bases de treinamento podem misturar arquivos, duplicatas, versões modificadas, metadados incompletos e conteúdos obtidos de diferentes fontes.
Essa opacidade favorece as empresas de IA. Um criador pode reconhecer características de seu trabalho em uma geração, mas terá enorme dificuldade para provar que determinada obra participou do treinamento. Sem acesso aos registros completos, a relação entre o conteúdo original e a capacidade do modelo permanece escondida dentro de um sistema estatístico.
Plataformas digitais como YouTube, Deezer e Genius também são atingidas. Elas investem em licenças, infraestrutura, moderação, catálogo e relacionamento com titulares de direitos. Quando seus acervos são coletados por terceiros para formar um novo produto, deixam de funcionar apenas como distribuidores e passam a servir involuntariamente como fornecedores de matéria-prima.
O terceiro grupo é formado pelos usuários da própria Suno. Quem utiliza músicas geradas por IA em publicidade, jogos, vídeos ou lançamentos comerciais assume que o serviço oferece algum nível de segurança jurídica. Caso os tribunais concluam que parte do processo de treinamento ou aquisição de dados foi ilegal, poderão surgir disputas sobre licenças, indenizações e restrições aplicáveis aos modelos.
Não significa que cada usuário será automaticamente responsabilizado pelas decisões da empresa. Significa que negócios construídos sobre conteúdo gerado dependem da estabilidade jurídica e técnica do fornecedor. Quando essa base é questionada, o risco pode se espalhar por toda a cadeia.
O acordo com a Warner não encerrou o problema
A Warner Music retirou-se do processo contra a Suno após chegar a um acordo de licenciamento e estabelecer uma parceria com a empresa. O movimento mostra uma transformação importante: parte da indústria fonográfica parece disposta a trocar o confronto absoluto por modelos de remuneração, controle e participação comercial.
Sony e Universal, entretanto, continuam litigando. A coexistência entre acordos e processos mostra que não existe consenso na indústria sobre como regularizar a música generativa. Algumas empresas podem considerar mais vantajoso negociar participação em um mercado que continuará crescendo. Outras podem preferir buscar decisões judiciais capazes de limitar práticas anteriores e estabelecer indenizações.
O acordo com uma gravadora não resolve automaticamente a origem histórica dos modelos. Uma licença futura pode autorizar novos treinamentos, disponibilizar catálogos específicos e criar mecanismos de participação para artistas. Ela não necessariamente regulariza arquivos obtidos antes da negociação nem extingue direitos pertencentes a terceiros.
Esse é um dos dilemas centrais da próxima fase da IA musical. As empresas precisarão demonstrar não apenas que possuem contratos atuais, mas que conseguem separar modelos, bases e versões conforme a origem dos dados. Caso um sistema tenha sido desenvolvido com material não licenciado, adicionar obras autorizadas posteriormente pode não ser suficiente para remover a influência anterior.
O que pode dar errado
O primeiro risco é a disputa jurídica avançar de forma fragmentada. Um tribunal pode considerar determinado uso protegido pelo fair use, enquanto outro reconhece violação relacionada à circumvenção tecnológica ou às condições de acesso. Isso criaria um ambiente em que a legalidade dependeria menos da finalidade do treinamento e mais da forma concreta como cada arquivo foi obtido.
O segundo problema é a dificuldade de reconstruir conjuntos de dados antigos. Startups de IA trabalham com enorme velocidade, combinando fontes, filtrando arquivos e gerando várias versões de modelos. Quando uma empresa precisa provar a origem de cada elemento anos depois, pode descobrir que sua documentação é incompleta ou que fornecedores terceirizados não mantiveram registros suficientes.
Também existe risco para os próprios modelos. Se determinados conjuntos forem considerados ilícitos e sua remoção for exigida, a empresa talvez não consiga simplesmente apagar alguns arquivos. Pode ser necessário treinar novamente sistemas inteiros, um processo caro, demorado e computacionalmente intensivo.
A terceira ameaça é reputacional. Suno e outras plataformas dependem de uma comunidade criativa que, ao mesmo tempo, utiliza e teme essas ferramentas. Quanto mais a indústria de IA parece esconder a origem de seus dados, mais difícil se torna convencer músicos de que futuras parcerias serão equilibradas.
O que ninguém ainda está discutindo
O debate sobre direitos autorais costuma se concentrar em pagamento. É uma questão essencial, mas não é a única. Mesmo que artistas recebam alguma remuneração, continuará sendo necessário decidir quem pode autorizar o uso de uma obra, como essa autorização pode ser retirada e se o criador terá direito a saber em quais modelos seu trabalho foi utilizado.
Também falta discutir a rastreabilidade dos resultados. Um músico que recebe uma canção gerada pela Suno não consegue consultar quais tradições, gravações ou referências contribuíram para aquela produção. A ausência dessa informação impede atribuição, auditoria e avaliação de riscos.
Modelos futuros poderão precisar de mecanismos equivalentes a uma cadeia de custódia cultural. Não seria uma lista simplista de todas as músicas que influenciaram cada nota, algo tecnicamente difícil, mas um registro verificável dos conjuntos utilizados, das licenças correspondentes e das etapas de processamento.
Outro tema negligenciado é a concentração de poder. Milhões de artistas produziram as obras que tornaram esses modelos possíveis, mas apenas algumas empresas controlam a infraestrutura, o acesso aos sistemas e a monetização. A IA promete democratizar a criação enquanto centraliza os meios de produção musical em plataformas privadas de grande escala.
Existe ainda uma contradição econômica. Usuários são orientados a não pedir imitações diretas de artistas e podem ter gerações bloqueadas por referências explícitas. Ao mesmo tempo, os sistemas aprenderam a produzir música por meio de conjuntos formados a partir do trabalho desses mesmos artistas. A restrição ocorre na saída visível, enquanto a apropriação potencialmente mais ampla aconteceu na entrada silenciosa.
Análise da equipe PixBugTech
A invasão da Suno não deve ser celebrada como mecanismo legítimo de transparência. Comprometer funcionários, roubar credenciais e acessar sistemas sem autorização continua sendo uma violação grave de segurança. Empresas e pesquisadores precisam ser fiscalizados por tribunais, reguladores, auditorias e jornalismo investigativo, não pela normalização de ataques cibernéticos.
Ao mesmo tempo, o interesse público do material não pode ser ignorado. Os arquivos revelam aspectos de uma infraestrutura que afeta músicos, consumidores, plataformas e toda a economia criativa. Quando uma empresa constrói um produto bilionário a partir de obras culturais, a origem desses dados deixa de ser apenas um segredo industrial.
A Suno já havia reconhecido que utilizou dezenas de milhões de arquivos acessíveis na internet. O vazamento acrescenta detalhes sobre fontes, volumes e métodos que tornam essa admissão mais concreta. Ele também desafia a narrativa de que a coleta de dados para IA acontece de forma abstrata e inevitável. Na realidade, existem decisões humanas sobre quais plataformas acessar, quais ferramentas utilizar, quais formatos priorizar e quais barreiras enfrentar.
No curto prazo, o episódio reforçará as ações movidas pelas gravadoras e aumentará a pressão por acordos de licenciamento. No médio prazo, empresas de IA musical precisarão oferecer registros mais verificáveis sobre seus conjuntos de dados. No longo prazo, o mercado poderá se dividir entre modelos treinados com material plenamente licenciado e sistemas antigos cuja origem continuará juridicamente contestada.
Essa divisão terá consequências comerciais. Estúdios, produtoras, plataformas de vídeo e desenvolvedores de jogos poderão preferir fornecedores capazes de garantir procedência, indenização contratual e mecanismos de exclusão. O modelo mais impressionante tecnicamente nem sempre será o mais seguro para uso profissional.
A música gerada por IA chegou à sua fase de prestação de contas
A primeira fase da inteligência artificial musical foi marcada pelo encantamento. Bastava escrever uma descrição e assistir a uma música surgir quase instantaneamente. A segunda fase foi dominada pela escala, com milhões de usuários, grandes investimentos e resultados cada vez mais convincentes.
A terceira fase será definida pela prestação de contas. As empresas precisarão explicar de onde veio o material que ensinou suas máquinas, como ele foi adquirido, quais direitos foram respeitados e como os criadores participarão economicamente dos sistemas que ajudaram involuntariamente a construir.
O vazamento da Suno não resolve essas perguntas, mas impede que continuem sendo tratadas como abstrações. Existe código, existe infraestrutura, existem arquivos e existem escolhas empresariais por trás de cada geração musical aparentemente mágica.
A tecnologia pode ampliar a criatividade e permitir que pessoas sem formação musical transformem ideias em som. Esse potencial não precisa ser negado para que a origem dos modelos seja questionada. Pelo contrário: quanto mais poderosa se torna a ferramenta, maior deve ser a exigência de transparência.
A música gerada por IA não será legitimada apenas por soar bem. Ela precisará demonstrar que o sistema responsável por criá-la não depende de uma dívida permanente e invisível com os artistas que vieram antes.
👉 Dúvida? Então veja mais em: https://pixbugtech.com/linksuteis