noticias
IA aprende a perceber pelo cérebro quando entendeu errado mas isso ainda está longe de “ler pensamentos”
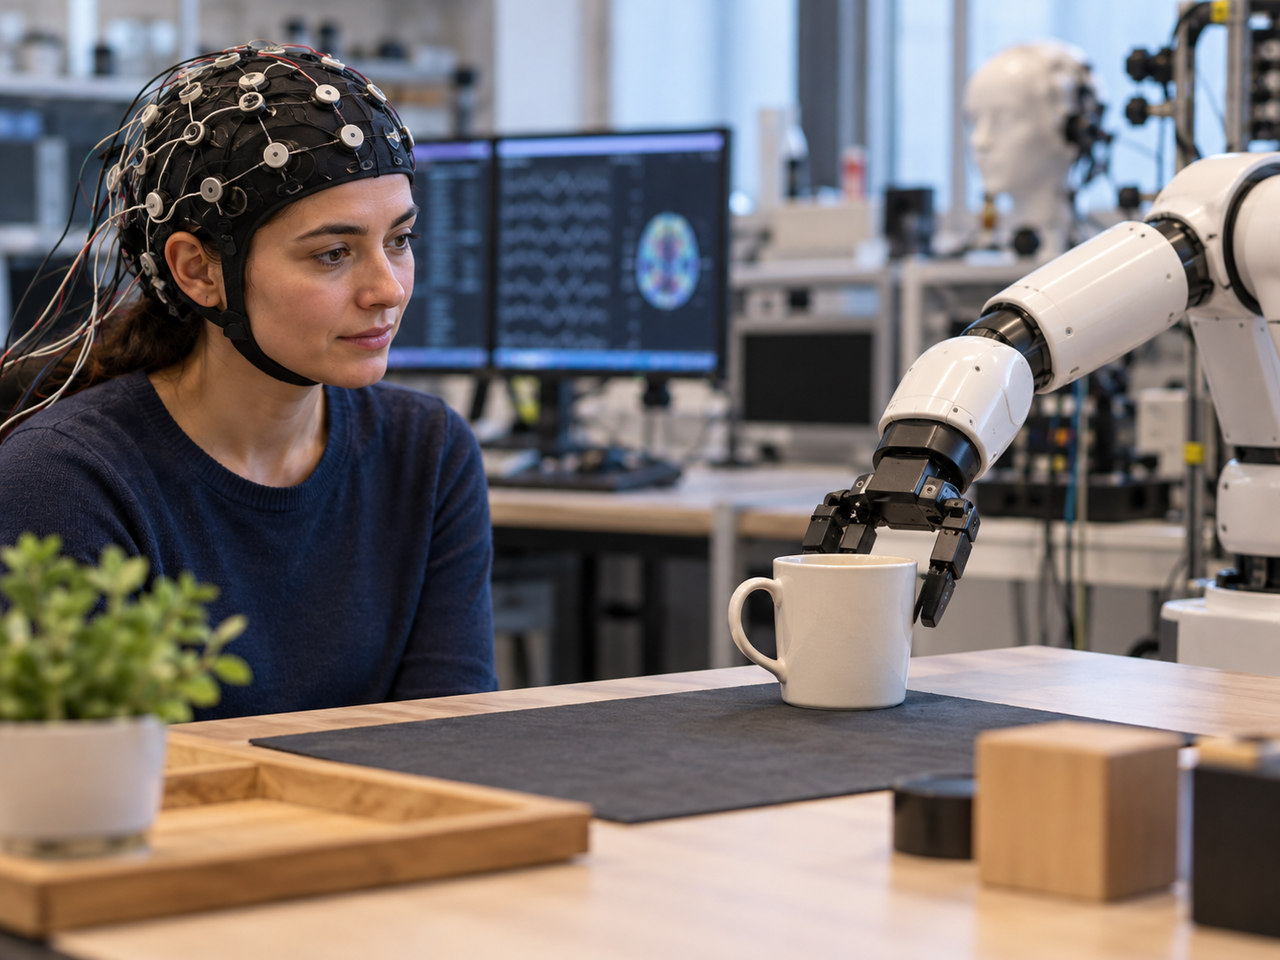
**Pesquisa do KAIST com a Microsoft Research Asia usa sinais de EEG para distinguir quando a máquina errou o objetivo do usuário ou apenas escolheu a ação errada.**
Imagine pedir implicitamente a uma máquina que faça alguma coisa e, ao observar o resultado, pensar imediatamente: “não era isso que eu queria”.
Hoje, a correção normalmente depende de alguma manifestação explícita. Você precisa falar, digitar, apontar, interromper a ação ou fornecer novo comando.
Pesquisadores do Korea Advanced Institute of Science and Technology, o KAIST, em colaboração com a Microsoft Research Asia, estão investigando uma alternativa bem mais incomum: usar a própria reação cerebral provocada pelo erro como sinal de feedback para a inteligência artificial.
A técnica recebeu o nome de **Neural Value Alignment**, ou NVA, e utiliza eletroencefalografia para detectar padrões associados à diferença entre aquilo que uma pessoa esperava e aquilo que efetivamente aconteceu.
O trabalho foi publicado em agosto de 2026 na revista científica *IEEE Transactions on Cybernetics*.
O resultado é interessante não porque a IA tenha aprendido a “ler pensamentos” — ela não aprendeu —, mas porque oferece uma possível maneira de máquinas perceberem determinados tipos de insatisfação humana sem depender exclusivamente de comandos explícitos.
Uma mesma ação pode esconder intenções completamente diferentes
O problema que os pesquisadores tentam resolver parece simples até começarmos a examiná-lo.
Imagine uma pessoa pegando uma xícara.
Qual era o objetivo?
Beber água? Preparar café? Lavar a xícara? Entregá-la para outra pessoa? Guardá-la no armário?
Observar a ação não basta necessariamente para descobrir a intenção.
O contrário também acontece.
Se o objetivo é matar a sede, diferentes ações podem atingir exatamente o mesmo resultado: pegar uma garrafa, usar um copo, beber diretamente de um bebedouro ou pedir água para outra pessoa.
Essa relação entre **objetivo e ação** cria uma ambiguidade importante para sistemas de inteligência artificial que precisam colaborar com humanos.
Uma máquina pode compreender corretamente aquilo que você deseja, mas executar uma ação diferente da esperada.
Ou pode executar perfeitamente determinada tarefa enquanto persegue o objetivo errado.
Para o usuário, as duas situações podem produzir a mesma sensação instantânea:
“Não era isso.”
Para uma IA, porém, descobrir **por que** não era isso faz toda a diferença.
O cérebro produz sinais quando expectativa e realidade não combinam
A abordagem proposta pelos pesquisadores parte de mecanismos conhecidos do aprendizado humano.
Nosso cérebro trabalha continuamente antecipando consequências.
Quando alguma coisa acontece de forma diferente daquela esperada, determinadas respostas neurais relacionadas ao processamento de erro podem surgir.
O Neural Value Alignment explora principalmente dois conceitos: **Reward Prediction Error**, ou RPE, e **State Prediction Error**, chamado SPE.
O primeiro está relacionado à discrepância entre a recompensa ou resultado esperado e aquilo que realmente ocorreu.
O segundo corresponde à diferença entre o estado que se esperava alcançar e aquilo que efetivamente aconteceu durante a transição entre ações.
A distinção é fundamental para o sistema proposto.
Um tipo de sinal pode indicar que a própria interpretação do objetivo humano estava errada.
Outro pode sugerir que o objetivo foi compreendido corretamente, mas a maneira escolhida para alcançá-lo não correspondeu à expectativa da pessoa.
Em vez de receber apenas um “certo” ou “errado”, portanto, a máquina poderia ganhar informação sobre **onde ocorreu o desalinhamento**.
O EEG entra como uma janela extremamente limitada — mas útil
Para detectar essas respostas, os pesquisadores utilizaram eletroencefalografia, o EEG.
A técnica mede diferenças de potencial elétrico no couro cabeludo por meio de eletrodos. É amplamente utilizada em pesquisa cerebral e também possui aplicações clínicas.
Sua grande vantagem é temporal: o EEG consegue registrar mudanças muito rápidas na atividade elétrica cerebral.
Mas existe uma limitação igualmente importante.
EEG não é uma câmera dos pensamentos.
O sinal captado é ruidoso, possui resolução espacial limitada e representa a combinação da atividade de grandes populações de neurônios.
Isso significa que a tecnologia não está extraindo frases secretas da cabeça de alguém nem descobrindo exatamente aquilo que uma pessoa está imaginando.
O que os pesquisadores procuram são padrões estatísticos associados a determinadas respostas cerebrais.
É uma diferença enorme.
O sistema não precisa descobrir que você pensou “eu queria colocar a xícara sobre a mesa”.
Ele pode precisar apenas identificar um padrão compatível com:
**“Algo nessa transição não correspondeu ao que eu esperava.”**
Para um algoritmo de decisão, isso já pode ser informação valiosa.
A IA poderia corrigir coisas diferentes dependendo do tipo de erro
É justamente aí que o Neural Value Alignment se torna mais interessante do que simplesmente detectar satisfação ou insatisfação.
Se o sistema identifica um sinal associado a erro na interpretação do objetivo, ele pode reconsiderar aquilo que acha que a pessoa deseja.
Se detecta um problema relacionado ao estado ou à ação executada, pode manter o objetivo e modificar somente a estratégia utilizada para alcançá-lo.
Essa separação aproxima a interação de algo que humanos fazem naturalmente.
Quando trabalhamos com outra pessoa, não precisamos necessariamente receber uma explicação completa a cada erro.
Uma expressão facial, uma pausa ou uma reação inesperada pode ser suficiente para perceber que alguma coisa deu errado e ajustar o comportamento.
O objetivo do NVA é explorar uma versão neural desse feedback.
Só que utilizando atividade cerebral medida diretamente.
Os resultados ainda são experimentais
Aqui está a parte que manchetes sobre “IA entendendo seu cérebro” frequentemente escondem.
A pesquisa não demonstra uma inteligência artificial genérica conectada ao cérebro de uma pessoa, descobrindo livremente seus desejos enquanto executa tarefas complexas no mundo real.
O trabalho utilizou um paradigma experimental desenvolvido especificamente para separar os diferentes tipos de erro e verificar se seus sinais poderiam ser identificados no EEG.
Os pesquisadores relataram que RPE, SPE e situações envolvendo ambos apresentaram padrões cerebrais distinguíveis.
Depois, utilizaram essas informações em simulações para analisar como uma IA poderia adaptar seu comportamento.
Segundo o estudo, combinar os dois sinais permitiu acelerar o processo de alinhamento entre aquilo que a pessoa desejava e as decisões tomadas pelo sistema.
E há um detalhe particularmente relevante: as simulações indicaram benefícios mesmo quando a decodificação dos sinais neurais não era perfeita.
Isso importa porque sistemas reais dificilmente terão acesso a EEG perfeitamente limpo.
Movimento, posição dos eletrodos, características individuais, ruído elétrico e até condições fisiológicas podem interferir na medição.
A aplicação mais óbvia está na robótica
Um dos caminhos naturais para esse tipo de tecnologia é a colaboração entre pessoas e robôs.
Imagine um braço robótico auxiliando alguém com mobilidade reduzida.
A máquina tenta pegar determinado objeto.
O usuário observa.
Caso perceba imediatamente que o robô escolheu o objeto errado, uma resposta neural relacionada ao erro poderia aparecer antes mesmo de a pessoa conseguir verbalizar ou acionar algum botão.
O sistema poderia utilizar esse sinal como evidência para reconsiderar a decisão.
Em ambientes industriais, algo semelhante poderia ocorrer quando máquinas trabalham fisicamente próximas de humanos.
Mas há outras possibilidades.
Próteses neurais, sistemas assistivos, interfaces cérebro-computador e agentes digitais poderiam eventualmente utilizar sinais fisiológicos adicionais para descobrir quando suas decisões divergem das expectativas humanas.
Não necessariamente para descobrir pensamentos.
Mas para detectar divergências.
Essa distinção provavelmente será essencial para que a tecnologia saia do laboratório.
O verdadeiro avanço é transformar o usuário em parte do ciclo de aprendizado
Grande parte das atuais inteligências artificiais aprende sobre preferências humanas por meio de comportamento explícito.
Clicamos.
Avaliamos.
Corrigimos respostas.
Escolhemos uma opção.
Rejeitamos outra.
Essas informações formam feedback.
Uma interface cérebro-computador acrescenta uma possibilidade diferente: utilizar sinais produzidos antes mesmo de uma resposta consciente deliberada.
Isso transforma o ser humano em uma fonte contínua de informação para o sistema.
E é justamente aí que surgem tanto o potencial quanto os problemas.
Privacidade cerebral deixa de ser discussão distante
Enquanto EEG permanecer restrito a equipamentos de laboratório, a questão pode parecer acadêmica.
Mas sensores neurais estão gradualmente deixando laboratórios.
Existem dispositivos portáteis de EEG, pesquisas com fones equipados com sensores e uma indústria crescente de interfaces cérebro-computador.
Quanto mais discretos esses sensores se tornarem, mais importante ficará determinar quem controla os dados produzidos por eles.
Uma plataforma que sabe quando o usuário considera determinada ação inesperada possui uma informação diferente daquela obtida por um clique.
O clique é deliberado.
A reação neural pode não ser.
Isso cria uma categoria particularmente sensível de dado comportamental.
Uma coisa é permitir que um sistema utilize um sinal cerebral temporariamente para corrigir um braço robótico.
Outra seria armazenar permanentemente milhares dessas respostas e utilizá-las para construir perfis individuais.
A tecnologia ainda não chegou a esse cenário.
Mas a discussão precisa chegar antes dela.
Análise da equipe
O Neural Value Alignment é uma pesquisa interessante justamente quando retiramos dela qualquer aparência de telepatia.
A IA não descobriu como saber aquilo que alguém está pensando.
O avanço está em algo tecnicamente mais modesto e, talvez, mais útil: tentar identificar **qual tipo de discrepância o cérebro percebeu quando uma máquina tomou determinada decisão**.
Isso pode parecer pouco.
Para sistemas autônomos, não é.
Um dos maiores problemas dos atuais agentes de inteligência artificial é que objetivos humanos frequentemente precisam ser traduzidos para instruções incompletas.
A máquina recebe uma representação parcial daquilo que realmente queremos e tenta preencher as lacunas.
Quanto mais autonomia damos ao sistema, maior fica a importância dessas lacunas.
Uma tecnologia capaz de fornecer feedback adicional poderia reduzir parte desse problema.
Mas também acrescentaria uma nova superfície de risco.
Hoje discutimos privacidade de mensagens, buscas, localização, voz e biometria.
Interfaces neurais obrigam a acrescentar outra pergunta:
**até onde uma máquina deveria ter acesso às reações involuntárias de nosso cérebro?**
Essa talvez seja a questão mais importante levantada pela pesquisa.
Não porque computadores estejam prestes a ler pensamentos.
Mas porque talvez não precisem lê-los completamente para aprender informações que nunca tivemos intenção consciente de fornecer.
👉 Dúvida? Então veja mais em: https://pixbugtech.com/linksuteis