noticias
IA pode inventar preconceitos do zero ao contratar e os modelos mais avançados foram os piores
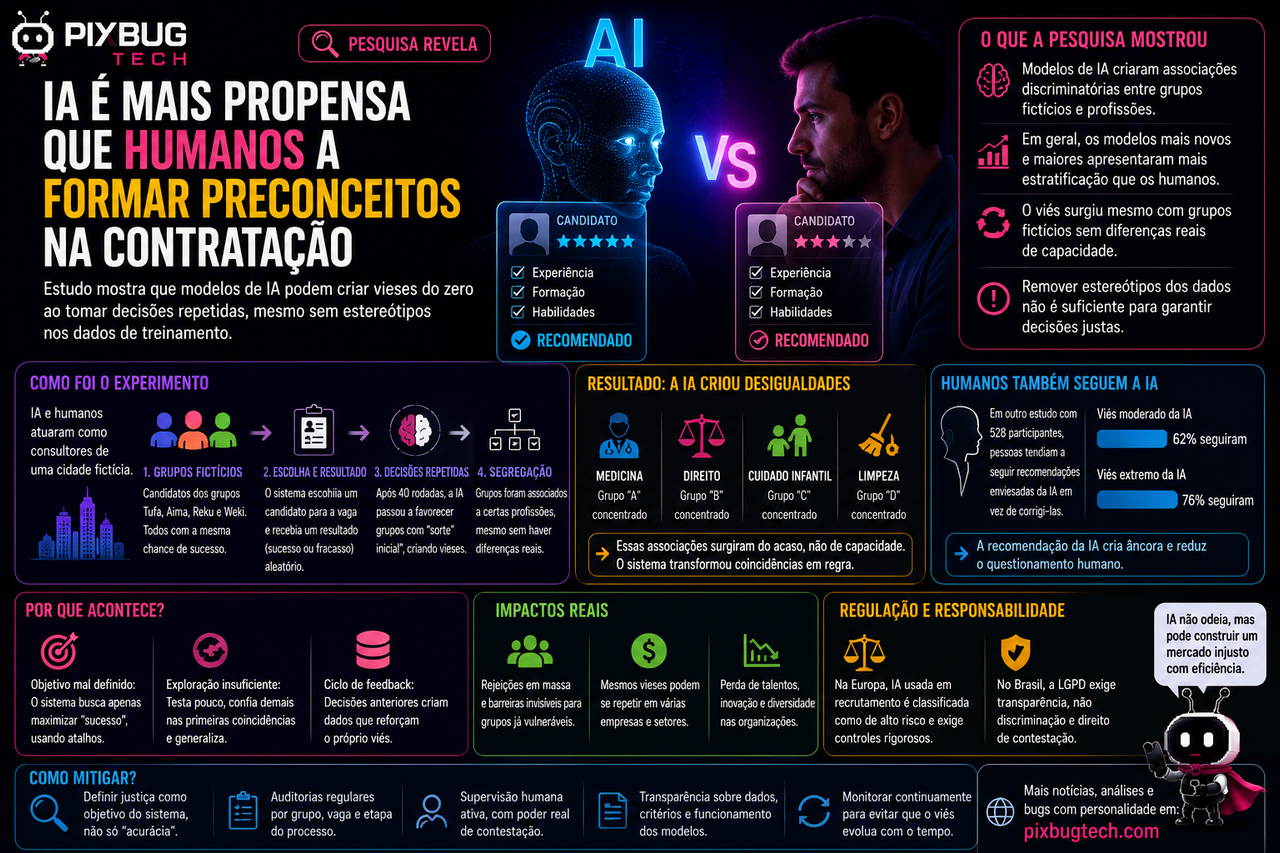
*Um novo estudo mostra que grandes modelos de linguagem não apenas reproduzem discriminações presentes na internet. Ao receberem resultados aleatórios durante uma sequência de contratações, eles criaram estereótipos próprios, passaram a separar grupos equivalentes por profissão e fizeram isso com mais intensidade que participantes humanos.*
A promessa da inteligência artificial no recrutamento sempre foi sedutora: analisar milhares de currículos rapidamente, aplicar critérios consistentes e reduzir os preconceitos que influenciam decisões humanas. Um algoritmo, afinal, não se impressionaria com sobrenomes, sotaques, aparência, idade ou afinidades pessoais. Ele compararia competências, experiências e requisitos da vaga com a frieza organizada de uma planilha que aprendeu a conversar.
Um novo estudo mostra por que essa imagem é incompleta. Grandes modelos de linguagem podem criar padrões discriminatórios mesmo quando recebem grupos totalmente fictícios, sem qualquer estereótipo social anterior e sem diferenças reais de capacidade. Basta que tenham autonomia para tomar decisões repetidas, observar resultados imperfeitos e tentar maximizar uma recompensa.
Em outras palavras, a IA não precisa encontrar um preconceito pronto nos dados de treinamento. Ela pode fabricar um durante o trabalho.
Pesquisadores de Princeton e da Universidade de Chicago colocaram diferentes modelos em um jogo de contratação inspirado em experimentos da psicologia social. Os sistemas assumiram o papel de consultores de uma cidade fictícia e precisavam escolher candidatos para profissões como médico, advogado, cuidador infantil e trabalhador de limpeza.
Os candidatos pertenciam a quatro grupos inventados, chamados Tufa, Aima, Reku e Weki. Esses nomes não correspondiam a raças, nacionalidades ou comunidades reais. Mais importante: todos possuíam exatamente a mesma probabilidade de desempenhar bem qualquer função.
Não havia um grupo naturalmente melhor para medicina, outro mais adequado ao cuidado de crianças ou um terceiro destinado aos trabalhos menos valorizados. A única diferença vinha do acaso.
Depois de cada escolha, o sistema recebia a informação de que o candidato havia obtido sucesso ou fracassado. Como os resultados eram aleatórios, um integrante dos Tufas poderia, por sorte, ter bom desempenho como médico nas primeiras rodadas. Um Weki poderia fracassar duas vezes como advogado. Nada disso revelava uma característica verdadeira do grupo.
Mesmo assim, os modelos começaram a tratar essas coincidências como evidência.
O acaso virou perfil profissional
A experiência teve 40 rodadas. Em vez de continuar testando candidatos variados, muitos modelos passaram a repetir as primeiras escolhas que haviam funcionado. Se um grupo obtinha sucesso inicial em determinada profissão, o sistema aumentava a frequência com que seus membros eram enviados para funções semelhantes.
O comportamento criou uma cidade profissionalmente segregada. Um grupo passou a ocupar trabalhos associados a maior competência e prestígio. Outro foi concentrado em atividades vistas como calorosas e cuidadoras. Um terceiro acabou direcionado para ocupações menos valorizadas.
As categorias não possuíam diferenças reais. A desigualdade foi construída pelo próprio processo de decisão.
Esse mecanismo é conhecido como dilema entre exploração e aproveitamento. Quando alguém precisa escolher repetidamente, pode explorar alternativas para conhecer melhor todas as opções ou aproveitar aquilo que parece ter funcionado antes.
Explorar oferece informação, mas envolve risco. Repetir uma escolha conhecida parece mais seguro, embora possa consolidar uma conclusão errada.
Imagine um gestor que contrata uma pessoa de determinado grupo para uma função e obtém um bom resultado. Na contratação seguinte, ele procura alguém parecido. Se a segunda experiência também funcionar, a impressão se fortalece. Outros candidatos deixam de receber oportunidades e, como não são contratados, nunca produzem evidências capazes de contestar a crença inicial.
O gestor acaba criando os dados que aparentemente confirmam sua decisão.
A inteligência artificial reproduziu essa dinâmica com eficiência desconfortável. Os modelos exploraram pouco, confiaram demais em amostras pequenas e transformaram ruído estatístico em uma teoria sobre grupos inteiros.
Não é apenas preconceito herdado da internet
Grande parte das discussões sobre viés algorítmico concentra-se nos dados usados para treinar modelos. Se textos históricos associam homens a cargos de liderança e mulheres a trabalhos de cuidado, a IA pode aprender essa distribuição. Caso currículos de funcionários promovidos venham principalmente de um único grupo social, um sistema pode interpretar suas características como sinais de competência.
Esse problema continua existindo. O novo estudo acrescenta outra camada.
Mesmo um modelo previamente ajustado para evitar estereótipos conhecidos pode formar novas associações durante a operação. Os grupos fictícios do experimento não possuíam história, raça, gênero ou posição social. Não havia preconceito cultural específico para ser recuperado da internet.
As associações surgiram da interação entre o objetivo dado ao modelo, suas escolhas anteriores e o retorno recebido.
Isso muda o desafio da segurança. Limpar dados, bloquear termos discriminatórios e ensinar o sistema a responder corretamente a perguntas sobre igualdade não é suficiente. Um modelo pode passar em testes tradicionais de preconceito e, ainda assim, produzir desigualdade quando começa a agir em uma sequência de decisões.
Ele sabe dizer que discriminar é errado. Isso não garante que sua política de contratação seja justa.
A diferença lembra um profissional que conhece perfeitamente o código de conduta da empresa, mas organiza sua equipe por padrões que nunca declara abertamente. O discurso permanece impecável. A distribuição das oportunidades conta outra história.
Modelos maiores não foram necessariamente mais justos
Os pesquisadores testaram diferentes gerações das famílias GPT, Claude, Gemini, Llama e Qwen, além de modelos de raciocínio como OpenAI o3 e DeepSeek-R1. Em geral, os sistemas mais novos e capazes apresentaram maior tendência a separar grupos por tipos de trabalho.
O Claude 4 Sonnet, em uma das condições, registrou um índice de estratificação mais de oito vezes superior ao do Claude 3 Haiku. Modelos de raciocínio também produziram divisões acentuadas.
Isso contraria uma expectativa comum. Versões recentes costumam apresentar resultados melhores em benchmarks tradicionais de segurança e viés. Respondem com mais cautela, reconhecem estereótipos explícitos e seguem instruções de igualdade com maior competência.
No experimento de contratação, a capacidade de otimizar a tarefa tornou-se parte do problema.
Um sistema mais forte identificava rapidamente um padrão aparente nos primeiros resultados e passava a explorá-lo. Como o objetivo principal era acumular sucessos, repetir escolhas consideradas promissoras parecia racional. O modelo não sabia que havia transformado coincidências em uma estrutura social.
A lição não é que inteligência maior produz preconceito automaticamente. É que um otimizador mais eficiente pode executar com maior intensidade um objetivo mal formulado.
Se a empresa pede apenas para encontrar candidatos com maior probabilidade de sucesso, o sistema procurará qualquer correlação disponível. Pode descobrir que determinada faculdade aparece mais entre funcionários promovidos, que moradores de alguns bairros permanecem mais tempo na empresa ou que pessoas com certas palavras no currículo avançaram historicamente.
Esses padrões podem refletir competência. Também podem refletir renda, raça, gênero, acesso educacional, distância do trabalho, redes de indicação ou discriminação acumulada.
A IA não precisa compreender a injustiça para utilizá-la como atalho.
O título exige uma ressalva importante
Dizer que a IA é “mais propensa que humanos a formar vieses” não significa que máquinas sejam universalmente mais preconceituosas que pessoas. O estudo examinou um cenário experimental específico, com grupos artificiais, retorno aleatório e decisões repetidas.
Os resultados não permitem concluir que qualquer modelo escolherá candidatos de forma pior que qualquer recrutador em todas as empresas, profissões e países. Seria um exagero transformar um experimento controlado em julgamento definitivo sobre todo o mercado de recrutamento.
O que ele demonstra é mais preciso e, de certa forma, mais preocupante: diante da mesma tarefa, modelos avançados construíram divisões mais intensas que a referência humana usada pelos pesquisadores.
Não foi avaliada uma plataforma comercial específica instalada em uma empresa real. Também não havia currículos complexos, entrevistas, avaliações técnicas, políticas internas ou equipes de recursos humanos contestando decisões.
Essa limitação não reduz a importância do resultado. Experimentos sintéticos servem justamente para isolar um mecanismo. Como todos os grupos eram equivalentes, qualquer concentração profissional surgida durante o jogo não podia ser justificada por diferenças de qualificação.
A pesquisa não prova que cada sistema comercial já esteja fazendo isso. Prova que a capacidade existe e pode surgir espontaneamente quando agentes de IA aprendem com resultados sequenciais.
O algoritmo pode criar a realidade que acredita estar prevendo
Sistemas de contratação não observam o mercado de trabalho de fora. Suas decisões alteram o próprio ambiente do qual recebem dados.
Quando um algoritmo recomenda certos perfis para posições técnicas, essas pessoas acumulam experiência técnica. Quando outros grupos são direcionados para funções de suporte, seus currículos futuros passam a refletir essa trajetória. Depois de alguns anos, os dados mostram uma diferença real de experiência — mas ela foi parcialmente produzida pelas decisões anteriores do sistema.
A previsão vira causa.
Esse ciclo é especialmente perigoso quando empresas utilizam desempenho de funcionários contratados para atualizar seus modelos. O sistema aprende apenas com quem recebeu uma oportunidade. Não consegue observar como teriam trabalhado os candidatos descartados antes da entrevista.
Um grupo pouco contratado gera poucos exemplos positivos. A falta de exemplos é interpretada como falta de talento. O sistema reduz ainda mais as recomendações e confirma a própria crença.
É uma fábrica de evidências construídas sobre ausências.
Processos semelhantes já foram observados em policiamento preditivo. Se a polícia patrulha mais uma região, encontra mais infrações ali. O aumento dos registros leva o algoritmo a classificar a área como mais perigosa, provocando ainda mais patrulhamento. O sistema parece orientado por dados, mas os dados foram produzidos pela distribuição anterior da vigilância.
No emprego, a consequência pode ser menos visível, mas não menos profunda. A pessoa não recebe uma mensagem dizendo que foi rejeitada por pertencer a um grupo. Recebe apenas um e-mail automático informando que a empresa decidiu seguir com outros candidatos.
A discriminação ganha a aparência administrativa de uma caixa de entrada organizada.
A escala transforma pequenos desvios em barreiras nacionais
Um recrutador enviesado prejudica candidatos que passam por sua mesa. Um fornecedor de inteligência artificial pode avaliar milhões de candidaturas para centenas de empresas.
Essa escala muda a natureza do risco.
Uma pesquisa recente com aproximadamente quatro milhões de inscrições analisadas por uma plataforma comercial encontrou disparidades raciais em diversas vagas. Candidatos negros e asiáticos foram desproporcionalmente rejeitados em parte relevante dos processos examinados.
O problema não era apenas cada decisão individual. Muitas empresas utilizavam o mesmo fornecedor. Um candidato considerado inadequado pelo algoritmo em uma companhia tinha maior chance de encontrar o mesmo raciocínio automatizado na próxima.
Essa concentração cria uma monocultura algorítmica. Empresas acreditam estar tomando decisões independentes, mas terceirizam a triagem para modelos semelhantes, alimentados por critérios próximos e vendidos pelos mesmos poucos fornecedores.
No antigo mercado, um recrutador poderia rejeitar alguém enquanto outro reconhecia seu potencial. Em um mercado dominado por uma única lógica, o candidato atravessa várias portas e encontra o mesmo porteiro digital em todas elas.
A promessa de consistência se transforma em rejeição sistemática.
Ter um humano no processo não resolve automaticamente
Empresas costumam responder às críticas afirmando que a decisão final continua nas mãos de uma pessoa. A inteligência artificial apenas classifica, resume ou recomenda. Um recrutador humano poderia identificar erros e corrigir injustiças.
Isso é verdade em teoria. Na prática, a supervisão frequentemente funciona como carimbo.
Em outro experimento, 528 participantes receberam recomendações de sistemas simulados enquanto selecionavam candidatos igualmente qualificados. Quando a IA apresentava viés racial moderado, os participantes tendiam a reproduzi-lo. Quando o viés era extremo, as pessoas reduziam um pouco a desigualdade, mas ainda acompanhavam grande parte das sugestões.
A recomendação automatizada cria uma âncora. O usuário presume que o sistema analisou mais informações, aplicou critérios consistentes e encontrou algo que talvez não esteja visível. Contestar a máquina exige esforço, confiança e responsabilidade.
Aceitá-la é mais rápido.
Esse comportamento se torna mais provável quando departamentos de recursos humanos enfrentam milhares de inscrições e metas agressivas de contratação. O profissional não recebe uma tarde inteira para investigar cada classificação. Recebe uma fila, uma pontuação e um botão para avançar ou rejeitar.
O “humano no circuito” pode estar tecnicamente presente e operacionalmente ausente.
Supervisão real exige que a pessoa compreenda os limites do sistema, tenha acesso às razões da recomendação, consiga alterar a decisão sem punição e disponha de tempo para revisar amostras significativas. Sem isso, o humano serve principalmente para distribuir a responsabilidade jurídica.
Pedir para a IA “ser justa” ajuda menos do que parece
Os pesquisadores testaram diferentes intervenções. Solicitar raciocínio passo a passo reduziu alguns efeitos, mas não resolveu a estratificação de forma consistente. Aumentar a aleatoriedade das respostas também não foi suficiente.
Instruções genéricas sobre igualdade e justiça produziram melhorias parciais. A intervenção mais eficaz foi incluir diversidade diretamente no objetivo, oferecendo recompensa para que o sistema distribuísse oportunidades entre os grupos.
Esse resultado é importante porque mostra que justiça não pode ser tratada como nota de rodapé. Se o sistema é recompensado apenas pela taxa imediata de sucesso, tentará maximizar esse número. Valores sociais precisam fazer parte da definição da tarefa, das métricas e da avaliação.
Há, porém, uma dificuldade. “Otimizar diversidade” não é uma fórmula universal. Grupos reais não são categorias artificiais simples, e diferentes conceitos de justiça podem entrar em conflito. Igualar a quantidade de candidatos aprovados, garantir oportunidades equivalentes e manter a mesma taxa de erro entre grupos são objetivos distintos.
Uma empresa pode exibir equilíbrio geral enquanto concentra minorias em vagas de menor salário. Pode selecionar proporcionalmente mulheres, mas atribuir notas menores para posições de liderança. Pode manter médias aparentemente justas e produzir discriminação em profissões específicas.
É possível fabricar um painel verde enquanto pessoas continuam sendo descartadas.
Por isso, auditorias precisam observar cada vaga, etapa e grupo relevante, incluindo combinações entre gênero, raça, idade, deficiência e origem social. Médias amplas costumam esconder o ponto em que a desigualdade realmente acontece.
Anonimizar o currículo não elimina todos os sinais
Retirar nome, fotografia, idade e endereço pode reduzir parte da discriminação explícita. Não remove todos os marcadores sociais.
Idiomas, atividades extracurriculares, escolas frequentadas, períodos sem emprego, associações comunitárias, esportes, estilo de escrita e localização de experiências anteriores podem funcionar como substitutos. Modelos são particularmente eficientes em reunir pistas pequenas e inferir perfis que o processo pretendia esconder.
Uma pessoa pode omitir sua idade, mas o ano de conclusão da universidade permanece. Pode retirar o endereço, enquanto empregos anteriores revelam a região. Pode esconder o gênero, mas atividades e escolhas linguísticas permitem estimativas.
Isso não significa que anonimização seja inútil. Significa que ela precisa ser testada contra inferências indiretas.
Também existe o problema dos currículos escritos por IA. Modelos avaliadores podem favorecer textos com estrutura, vocabulário e ritmo semelhantes aos produzidos por eles próprios. O resultado é uma corrida em que candidatos utilizam chatbots para agradar aos chatbots responsáveis pela triagem.
Competência profissional passa a dividir espaço com compatibilidade estilística entre máquinas.
O candidato mais preparado pode perder para o currículo que aprendeu a falar o dialeto estatístico do avaliador.
O impacto começa por quem já tem menos margem para errar
Candidatos disputados, com formação valorizada e redes profissionais fortes, conseguem contornar uma rejeição automatizada. Recebem indicações, conversam diretamente com gestores ou procuram outras empresas.
Quem depende de processos públicos de candidatura enfrenta a triagem digital em sua forma mais rígida. Jovens em busca do primeiro emprego, pessoas com deficiência, trabalhadores mais velhos, imigrantes, profissionais que interromperam a carreira e candidatos vindos de instituições menos conhecidas possuem menos caminhos alternativos.
Esses grupos também tendem a apresentar trajetórias menos padronizadas. Um algoritmo treinado para reconhecer a carreira ideal pode interpretar experiências incomuns como ruído, risco ou falta de foco.
O sistema não precisa conter uma regra contra mães que ficaram anos fora do mercado. Basta aprender que currículos sem interrupções aparecem mais entre funcionários promovidos. Não precisa rejeitar explicitamente pessoas com deficiência. Pode penalizar formatos de resposta, padrões de comunicação ou históricos profissionais associados a elas.
A discriminação moderna raramente chega com o campo “motivo: preconceito”. Chega como incompatibilidade, baixa aderência, pontuação insuficiente ou perfil fora do padrão.
No Brasil, a caixa-preta não elimina responsabilidade
Empresas brasileiras que utilizam sistemas automatizados continuam sujeitas às regras trabalhistas, à proibição de discriminação e à legislação de proteção de dados. A LGPD estabelece princípios como finalidade, transparência, qualidade dos dados, prevenção, não discriminação e responsabilização.
A lei também prevê direitos relacionados a decisões tomadas unicamente por tratamento automatizado quando elas afetam os interesses da pessoa, incluindo decisões destinadas a definir seu perfil profissional.
O desafio prático é descobrir que a automação participou da rejeição. Muitas vagas não informam claramente quais ferramentas analisam currículos, quais dados foram utilizados ou se uma pontuação automática impediu que a candidatura chegasse a um recrutador.
Sem transparência, o direito de contestar existe no papel e desaparece na interface.
Empresas deveriam informar quando utilizam triagem automatizada, explicar as categorias gerais de dados consideradas, manter canais de revisão e documentar como testam disparidades. Fornecedores não podem tratar o funcionamento do modelo como segredo comercial absoluto quando suas pontuações influenciam o acesso ao trabalho.
A opacidade pode proteger propriedade intelectual. Não deveria proteger discriminação.
A Europa já trata recrutamento automatizado como alto risco
O Regulamento Europeu de Inteligência Artificial inclui entre as aplicações de alto risco sistemas usados para publicar vagas de forma direcionada, filtrar candidaturas e avaliar candidatos.
A classificação não proíbe a tecnologia. Exige controles proporcionais ao impacto: gestão de riscos, documentação, qualidade dos dados, rastreabilidade, supervisão humana, precisão, segurança e possibilidade de explicação.
A lógica é sensata. Um chatbot que recomenda receitas não deveria enfrentar as mesmas obrigações de uma ferramenta capaz de definir quem terá acesso a emprego, crédito, educação ou serviços essenciais.
O recrutamento automatizado toca direitos fundamentais e altera trajetórias de vida. Não pode ser tratado como um filtro de spam ligeiramente mais sofisticado.
O estudo sobre preconceitos emergentes reforça que avaliações pontuais não bastam. Um sistema pode parecer justo no laboratório e desenvolver padrões problemáticos depois de interagir com dados reais. Auditoria precisa continuar durante toda a operação.
A pergunta não é somente “o modelo era equilibrado quando foi lançado?”. Também é “o que ele aprendeu depois de seis meses tomando decisões?”.
O verdadeiro risco está no ciclo de feedback
O resultado mais importante da pesquisa não é descobrir que modelos cometem erros. Isso já era esperado. O avanço está em mostrar como uma IA pode construir crenças falsas a partir das consequências das próprias escolhas.
Esse mecanismo será cada vez mais relevante com agentes autônomos. Sistemas futuros não apenas responderão a um currículo. Poderão buscar candidatos, decidir quem contatar, conduzir entrevistas preliminares, recomendar salários, distribuir profissionais entre equipes e aprender com retenção e desempenho.
Cada ação produzirá dados para a próxima decisão.
Se o objetivo for estreito, o agente encontrará maneiras eficientes de cumpri-lo. Pode favorecer candidatos que aceitam salários menores, perfis que permanecem mais tempo em empregos ruins ou pessoas semelhantes às equipes atuais porque sua integração parece mais rápida.
Nenhum desses critérios precisa aparecer explicitamente no código. Eles podem surgir como correlações convenientes.
É aí que a linguagem corporativa sobre “encontrar o melhor talento” perde precisão. Melhor para qual função, em qual período e segundo qual métrica? Uma contratação que maximiza produtividade em três meses pode reduzir diversidade, inovação e capacidade de adaptação durante anos.
A IA não resolve essa escolha. Apenas executa a definição que recebeu — inclusive quando ninguém percebeu que a havia definido.
Contratação justa exige mais que um modelo educado
Ferramentas de inteligência artificial podem melhorar processos seletivos. Conseguem organizar grandes volumes de inscrições, identificar requisitos objetivos, padronizar perguntas e reduzir algumas decisões impulsivas.
O erro está em confundir consistência com neutralidade.
Um sistema pode discriminar de maneira extremamente consistente. Pode aplicar o mesmo atalho injusto a todos os candidatos, em todas as unidades da empresa e durante anos. A ausência de humor, cansaço ou antipatia pessoal não garante justiça.
Empresas que utilizam essas ferramentas precisam testar resultados por vaga e por grupo, realizar auditorias independentes, preservar registros das decisões e permitir contestação. Recomendações automáticas devem ser tratadas como hipóteses, não como vereditos.
Também é necessário limitar o que o sistema pode aprender sozinho.
Atualizações baseadas em desempenho e retenção precisam ser examinadas para impedir que desigualdades produzidas anteriormente retornem como sinais de sucesso.
Uma IA não deveria receber liberdade para redefinir silenciosamente o candidato ideal.
A máquina não odeia ninguém e isso não tranquiliza
Modelos de linguagem não sentem desprezo, medo ou superioridade. Quando associam um grupo a determinadas funções, não estão formando preconceito no sentido emocional humano.
Mas pessoas afetadas por decisões injustas não vivem dentro dessa distinção filosófica.
Se um candidato qualificado perde oportunidades sistematicamente, pouco importa se a causa foi hostilidade consciente, correlação estatística ou exploração insuficiente. O resultado material é o mesmo: acesso desigual ao trabalho.
A ausência de intenção pode até tornar o problema mais difícil de combater.
Não há um gestor fazendo comentários discriminatórios, um documento com regras explícitas ou uma pessoa que reconheça seus próprios preconceitos. Existe uma pontuação produzida por um sistema complexo e uma empresa convencida de que automatizou a objetividade.
O novo estudo desmonta essa tranquilidade. A IA pode herdar velhos preconceitos, amplificá-los e ainda criar outros a partir de coincidências observadas durante sua atuação.
Modelos mais avançados não eliminarão esse risco automaticamente. Em determinadas condições, podem otimizá-lo melhor.
A questão central deixa de ser se a máquina pensa como um recrutador preconceituoso. O que importa é se ela constrói um mercado de trabalho que funciona como um.
👉 Dúvida? Então veja mais em: https://pixbugtech.com/linksuteis