noticias
Inkling-Small tem um quarto do tamanho e supera o modelo maior mas o “pequeno” da IA ainda ocupa um data center
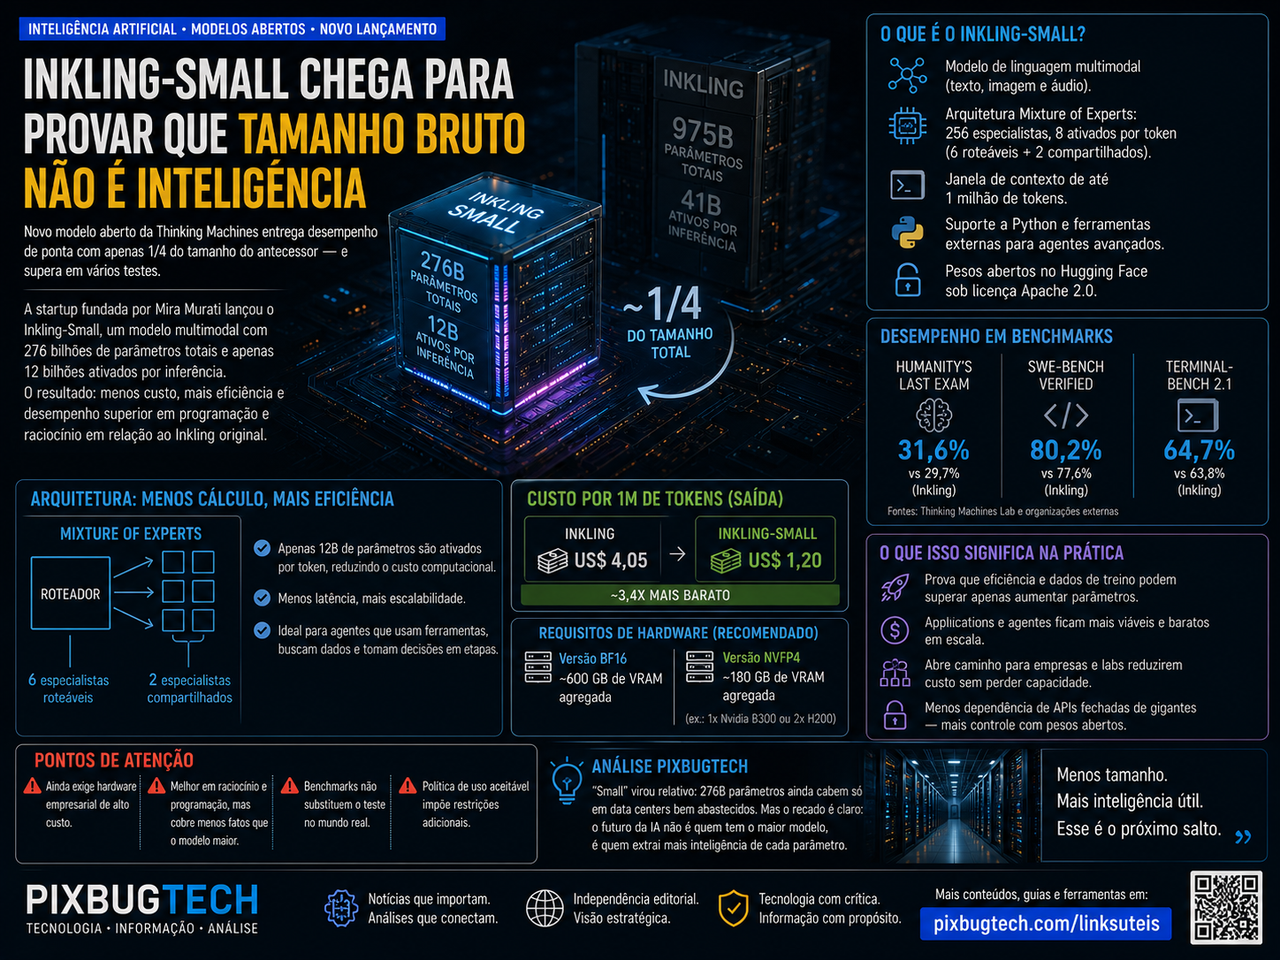
**A Thinking Machines Lab lançou um modelo multimodal com 276 bilhões de parâmetros totais e apenas 12 bilhões ativados a cada processamento.
O Inkling-Small iguala ou supera seu antecessor em programação e raciocínio, custa menos para operar e expõe uma mudança importante na corrida da inteligência artificial: treinar modelos maiores já não basta.
O problema é que a indústria começou a chamar de pequeno aquilo que ainda exige hardware inacessível para quase todo mundo.**
Duas semanas depois de apresentar seu primeiro grande modelo público, a Thinking Machines Lab voltou com uma versão que parece contradizer parte da lógica dominante da inteligência artificial. O Inkling-Small possui aproximadamente um quarto do tamanho total do Inkling original, utiliza menos de um terço dos parâmetros ativos e, mesmo assim, alcança resultados superiores em alguns testes de raciocínio, programação e operação de ferramentas.
O modelo foi lançado pela startup liderada por Mira Murati, ex-diretora de tecnologia da OpenAI, com 276 bilhões de parâmetros totais e 12 bilhões ativados durante cada etapa de processamento. O Inkling original possui 975 bilhões no total e ativa 41 bilhões. Ambos utilizam uma arquitetura conhecida como Mixture of Experts, ou mistura de especialistas, na qual apenas uma parcela da rede é acionada para processar cada token.
A comparação explica a economia computacional, mas também cria uma manchete potencialmente enganosa. O Inkling-Small não é pequeno no sentido normalmente atribuído a modelos locais, capazes de funcionar em computadores pessoais, celulares ou estações de trabalho comuns. Sua versão completa em BF16 exige aproximadamente 600 GB de memória de vídeo agregada. A versão quantizada em NVFP4 reduz esse requisito para cerca de 180 GB, ainda suficiente para colocar a maior parte dos usuários, laboratórios universitários e pequenas empresas do lado de fora.
Na escala das grandes empresas de IA, houve uma redução expressiva. Na escala do restante da humanidade, o “Small” continua precisando de uma sala com refrigeração adequada e uma conversa desconfortável com o departamento financeiro.
Menos parâmetros, treinamento melhor
A vantagem do Inkling-Small não surgiu apenas da redução física do modelo. A Thinking Machines afirma ter modificado a composição dos dados de pré-treinamento e aperfeiçoado a receita de aprendizado depois de observar o desenvolvimento do Inkling original.
Uma versão preliminar do modelo menor também recebeu destilação orientada pelo próprio Inkling. Nesse processo, o sistema maior funciona como professor, produzindo respostas, estratégias ou sinais que ajudam o modelo menor a aprender comportamentos mais eficientes. Depois dessa etapa, a empresa continuou por duas semanas o treinamento por reforço voltado à programação com agentes.
O resultado é uma demonstração importante: tamanho bruto não determina sozinho a qualidade.
O modelo maior pode armazenar uma cobertura mais ampla de conhecimento e manter vantagens em factualidade, mas o menor foi treinado posteriormente, com uma receita revisada e objetivos mais concentrados. Em determinados testes, essa combinação compensou a diferença gigantesca no número de parâmetros.
No Humanity’s Last Exam, avaliação composta por questões complexas em diferentes áreas, o Inkling-Small marcou 31,6%, contra 29,7% do Inkling. No SWE-bench Verified, voltado à resolução de problemas reais em repositórios de software, atingiu 80,2%, superando os 77,6% do antecessor. No Terminal-Bench 2.1, que avalia agentes operando em ambientes de terminal, a diferença foi de 64,7% contra 63,8%. Os números foram divulgados pela própria Thinking Machines e combinam testes internos com dados de organizações externas, portanto ainda precisam de reprodução mais ampla por pesquisadores independentes.
A melhora não significa que o modelo menor seja universalmente superior. A empresa reconhece que o Inkling original permanece melhor em cobertura de conhecimento e precisão factual. O Inkling-Small foi otimizado para raciocínio, programação, uso de ferramentas e eficiência; o irmão maior conserva mais informação em sua estrutura.
Essa diferença mostra por que rankings únicos de inteligência artificial são cada vez menos úteis. Um modelo pode ser melhor programador e pior enciclopédia. Pode raciocinar bem sobre um documento fornecido e falhar ao recuperar um fato que nunca apareceu no contexto. Pode utilizar ferramentas com eficiência e continuar produzindo respostas frágeis quando depende apenas de sua memória interna.
A pergunta deixou de ser “qual modelo é mais inteligente?”. Passou a ser “inteligente para qual tarefa, com qual custo e dentro de qual infraestrutura?”.
A mistura de especialistas diminui o cálculo, não o armazenamento
O Inkling-Small é um Transformer com arquitetura esparsa de mistura de especialistas. Em vez de utilizar toda a rede para processar cada token, um roteador escolhe quais partes serão ativadas.
A arquitetura possui 256 especialistas roteáveis. Para cada token, seis são selecionados, enquanto outros dois especialistas compartilhados permanecem ativos. Isso permite que o modelo tenha uma capacidade total muito maior do que a quantidade de parâmetros efetivamente utilizada em cada cálculo.
É como manter centenas de departamentos especializados dentro de uma organização, mas convocar apenas aqueles considerados relevantes para cada tarefa.
A vantagem é computacional. Se somente 12 bilhões de parâmetros são ativados, a quantidade de operações necessárias para gerar uma resposta pode aproximar-se daquela de um modelo denso muito menor. Isso reduz latência, consumo de processamento e custo por token.
A memória continua sendo o problema.
Mesmo que a maior parte dos especialistas permaneça inativa em determinado instante, seus pesos precisam estar disponíveis para quando o roteador decidir utilizá-los. Os 276 bilhões de parâmetros não desaparecem. Precisam ser armazenados em memória, distribuídos entre aceleradores ou parcialmente transferidos de outras camadas de armazenamento, o que pode prejudicar severamente a velocidade.
É por isso que “12 bilhões ativos” não significa que o Inkling-Small possa ser executado como um modelo comum de 12 bilhões de parâmetros.
A arquitetura reduz o trabalho realizado a cada resposta, mas não transforma os pesos restantes em decoração opcional.
Para provedores de nuvem, laboratórios e empresas com clusters de GPUs, essa troca pode ser atraente. Para usuários domésticos, o total armazenado continua sendo a barreira mais importante.
Um modelo multimodal de verdade, mas que ainda responde em texto
O Inkling-Small aceita texto, imagens e áudio dentro da mesma arquitetura. Imagens são divididas em blocos de 40 por 40 pixels e transformadas antes de serem processadas junto aos tokens textuais. O áudio utiliza representações derivadas de espectrogramas, permitindo que o modelo raciocine sobre fala e outros conteúdos sonoros sem depender necessariamente de um sistema separado de transcrição.
A saída, por enquanto, continua sendo texto.
Isso significa que o modelo pode examinar um gráfico, ouvir uma gravação e responder com uma análise escrita, mas não gera diretamente voz, imagem ou vídeo como resultado final. Aplicações podem combinar sua resposta com outros modelos, porém essa integração pertence ao sistema construído ao redor dele.
A Thinking Machines destaca especialmente a capacidade de trabalhar com áudio e utilizar Python durante tarefas visuais. O modelo pode recortar uma imagem, ampliar regiões, inspecionar programaticamente gráficos e tentar localizar detalhes que seriam difíceis de interpretar apenas com uma passagem visual.
Essa abordagem é relevante porque muitos erros de visão computacional acontecem quando o modelo recebe uma imagem inteira e tenta responder sem manipular o material. Permitir que ele utilize ferramentas aproxima o processo de uma análise humana: primeiro localizar, depois ampliar, medir e comparar.
O Inkling-Small também mantém uma janela de contexto anunciada de até um milhão de tokens. Em teoria, isso permite trabalhar com grandes bases documentais, repositórios extensos e conversas longas. Na prática, o limite máximo não informa sozinho quanto o modelo consegue recuperar com precisão, quanto custará processar tudo e qual será a degradação conforme o contexto cresce.
Uma janela enorme pode armazenar uma biblioteca. Não garante que o sistema encontre o parágrafo correto quando a resposta depender dele.
O modelo custa menos, mas não exatamente um quarto
A Thinking Machines cobra US$ 1,20 por milhão de tokens de saída do Inkling-Small em sua oferta hospedada. O Inkling original custa US$ 4,05 pelo mesmo volume. A redução é próxima de 70%, tornando a nova versão aproximadamente 3,4 vezes mais barata na geração de respostas.
Essa diferença poderá ser mais importante do que alguns pontos percentuais em benchmarks.
Aplicações com agentes produzem grandes quantidades de tokens internos. O sistema planeja, consulta ferramentas, interpreta resultados, reconsidera estratégias e só depois apresenta a resposta ao usuário. Uma tarefa aparentemente simples pode consumir muito mais processamento do que o texto final sugere.
Quando o custo de saída cai, torna-se possível executar mais tentativas, manter agentes trabalhando por mais tempo ou oferecer serviços a preços menores.
A eficiência também pode reduzir a necessidade de utilizar o modelo mais poderoso em todas as etapas. Um sistema poderá reservar modelos grandes para decisões complexas e utilizar versões menores na classificação, extração, revisão ou execução de tarefas intermediárias.
Essa arquitetura em camadas provavelmente será mais importante para a adoção empresarial do que a busca por um único modelo capaz de fazer tudo.
O melhor modelo não precisa responder a todas as mensagens. Precisa aparecer quando sua capacidade adicional justificar o custo.
“Open source” ainda é um termo complicado
A VentureBeat descreve o Inkling-Small como um modelo de código aberto. A formulação exige cautela.
A Thinking Machines disponibilizou os pesos completos no Hugging Face e utiliza a licença Apache 2.0. Desenvolvedores podem baixar, executar, modificar e ajustar o sistema. A empresa também oferece suporte a bibliotecas como Transformers, vLLM, SGLang e Unsloth.
Isso representa uma abertura muito maior do que a oferecida por modelos acessíveis apenas por API.
Uma empresa pode manter dados em sua própria infraestrutura, modificar o comportamento, criar ajustes especializados e evitar que todas as solicitações atravessem os servidores do fornecedor original.
Ainda assim, “pesos abertos” e “código aberto” não são necessariamente equivalentes.
A Thinking Machines não publicou todo o conjunto de dados utilizado no treinamento nem os detalhes necessários para reproduzir integralmente o modelo do início. A empresa informa apenas que os dados vieram de fontes públicas, materiais adquiridos de terceiros e conteúdo sintético ou aumentado.
Também existe uma política de uso aceitável com restrições adicionais sobre determinadas aplicações. Muitas dessas proibições envolvem usos abusivos ou ilegais e possuem justificativas compreensíveis, mas acrescentam condições que complicam a caracterização do produto como software aberto no sentido tradicional.
A descrição mais precisa é modelo de pesos abertos sob Apache 2.0, acompanhado por uma política de utilização.
Pode parecer uma discussão semântica, mas licenças definem o que empresas e pesquisadores realmente podem fazer. Em um setor no qual “aberto” virou argumento competitivo, pequenas diferenças jurídicas podem determinar se uma tecnologia funciona como infraestrutura independente ou apenas como uma versão mais flexível de um produto ainda controlado pelo fornecedor.
A Thinking Machines não está distribuindo o modelo por filantropia
A abertura também está conectada ao modelo comercial da startup.
A Thinking Machines oferece o Tinker, plataforma usada para ajustar e experimentar modelos. Ao disponibilizar uma base competente e modificável, a empresa atrai desenvolvedores para o ecossistema em que pretende vender treinamento, inferência, ferramentas e infraestrutura.
O usuário pode baixar os pesos, mas também pode optar pelo caminho mais conveniente: utilizar os serviços hospedados da própria companhia.
Essa estratégia não invalida a abertura. Software livre e serviços comerciais convivem há décadas. O ponto é não confundir disponibilidade pública com ausência de interesse econômico.
A Thinking Machines não precisa cobrar pelo acesso exclusivo ao modelo se conseguir ganhar dinheiro tornando sua personalização mais fácil.
O Inkling-Small pode funcionar como uma porta de entrada. É mais barato, mais eficiente e forte em tarefas de agentes, justamente a categoria na qual empresas procuram construir automações personalizadas.
A companhia oferece a matéria-prima e vende a oficina.
Modelos menores estão expondo o desperdício dos modelos maiores
O lançamento também reforça uma tendência importante. Parte do avanço recente não vem apenas de adicionar parâmetros, mas de melhorar dados, treinamento posterior, roteamento, ferramentas e destilação.
O Inkling-Small começou depois do modelo original e se beneficiou dos erros, resultados e conhecimentos acumulados durante a primeira experiência. É possível que parte da diferença de desempenho represente simplesmente uma receita mais madura.
Isso deveria provocar uma reflexão sobre a corrida por escala.
Empresas anunciaram trilhões de parâmetros como se o número representasse diretamente inteligência. Em arquiteturas esparsas, o total já perdeu parte de seu significado. Um modelo pode possuir centenas de bilhões de pesos e utilizar apenas uma fração deles por token.
Agora, modelos menores começam a superar versões maiores porque foram treinados de maneira mais eficiente.
Isso não significa que a escala deixou de importar. O Inkling maior conserva vantagens de conhecimento, e modelos de fronteira continuam dependendo de enormes volumes de processamento. Mas o retorno de apenas adicionar capacidade bruta parece cada vez menos garantido.
A indústria está descobrindo que uma rede maior também oferece mais lugares para armazenar redundância, ruído e decisões que poderiam ter sido aprendidas de forma mais econômica.
Em algum momento, eficiência deixa de ser uma preocupação ambiental ou financeira e vira vantagem de produto.
Quem realmente poderá utilizar o Inkling-Small
Grandes empresas, provedores de nuvem, universidades bem financiadas e laboratórios independentes poderão executar o modelo em infraestrutura própria. A versão NVFP4 cabe oficialmente em uma GPU Nvidia B300 ou em duas H200, desde que a configuração disponha da memória e do suporte necessários. A versão completa exige um conjunto muito maior de aceleradores.
Isso representa avanço em relação ao Inkling original, cuja versão BF16 exige aproximadamente 2 TB de VRAM e cuja quantização ainda demanda cerca de 600 GB.
Mas a democratização continua relativa.
Uma B300 ou duas H200 não são componentes comuns. São aceleradores empresariais caros, disputados por data centers e normalmente adquiridos dentro de contratos de infraestrutura.
A palavra “local” também precisa ser contextualizada. Rodar localmente pode significar executar o modelo no próprio data center corporativo, não necessariamente debaixo da mesa de um desenvolvedor.
Pequenos negócios continuarão utilizando APIs e provedores hospedados. A diferença é que agora poderão escolher entre mais fornecedores, negociar melhor e, em alguns casos, migrar para infraestrutura própria quando o volume justificar.
A abertura amplia opções, mas não distribui hardware.
O ponto cego energético permanece
Reduzir parâmetros ativos diminui o processamento necessário por token. Em escala, isso pode produzir economia significativa de energia e capacidade computacional.
Mas modelos mais baratos também costumam ser usados com maior frequência.
Quando o custo de uma tarefa cai, empresas automatizam atividades que anteriormente não justificavam o investimento. Agentes permanecem ativos por mais tempo, fazem mais tentativas e analisam volumes maiores de informação.
A eficiência por consulta pode melhorar enquanto o consumo total aumenta.
Esse efeito é conhecido em outras áreas da economia: tecnologias eficientes reduzem o custo unitário e estimulam mais uso. No caso da IA, um modelo três vezes mais barato pode ser chamado dez vezes mais.
O Inkling-Small representa progresso técnico, mas não resolve sozinho o impacto energético da inteligência artificial. A resposta dependerá da quantidade de utilização, do hardware, da origem da eletricidade e da capacidade de evitar processamento sem valor.
Gerar mais tokens porque agora estão baratos não é inteligência. É apenas desperdício com desconto.
Os benchmarks ainda precisam encontrar o mundo real
Os resultados divulgados são fortes, especialmente em programação e uso de ferramentas. Ainda assim, benchmarks medem ambientes definidos, com regras e métricas próprias.
O desempenho de um agente em um terminal controlado não garante comportamento estável dentro de uma empresa. Sistemas reais possuem permissões incompletas, documentação desatualizada, dependências frágeis e dados que não cabem perfeitamente em uma avaliação.
Também existe a possibilidade de otimização excessiva para testes populares. Quando benchmarks influenciam reputação, investimento e vendas, empresas passam a organizar treinamento e pós-treinamento ao redor deles.
Um modelo pode melhorar no teste sem melhorar na mesma proporção nas tarefas imprevisíveis que surgem em produção.
A Thinking Machines apresenta comparações detalhadas e utiliza resultados externos sempre que possível, uma prática mais transparente do que simplesmente publicar uma pontuação agregada. Mesmo assim, a empresa continua sendo parte interessada.
Os testes mais relevantes começarão agora, quando desenvolvedores colocarem o Inkling-Small em repositórios desconhecidos, gravações imperfeitas, documentos confusos e fluxos com consequências reais.
O modelo precisa sobreviver ao ambiente que não conhece sua tabela de benchmarks.
O “Small” revela uma mudança maior
O Inkling-Small não é o modelo pequeno que levará inteligência multimodal avançada a qualquer computador doméstico. Também não derrota seu antecessor em todas as áreas e não elimina a necessidade de infraestrutura cara.
Seu valor está em demonstrar que uma rede significativamente menor pode preservar quase toda a utilidade de um sistema maior e superá-lo onde o treinamento foi melhor direcionado.
Isso altera os incentivos da corrida.
Até agora, laboratórios conquistavam atenção anunciando mais parâmetros, mais GPUs e mais dinheiro investido. O novo diferencial pode estar em entregar a mesma capacidade com menos ativação, menos tokens e menor custo.
Para empresas, isso significa aplicações mais viáveis. Para pesquisadores, oferece uma base aberta mais acessível, embora ainda distante de um projeto doméstico. Para a Thinking Machines, representa uma forma de provar que possui algo além de antigos executivos da OpenAI e uma avaliação bilionária.
O lançamento também expõe a ironia da linguagem criada pela indústria.
Um modelo de 276 bilhões de parâmetros, com arquivo quantizado de aproximadamente 171 GB e necessidade recomendada de hardware empresarial, recebe o nome de “Small” porque seu irmão mais velho se aproxima de um trilhão.
A régua ficou tão desproporcional que um data center menor começou a parecer um computador pessoal.
Ainda assim, a direção é promissora. Inteligência artificial útil não pode depender indefinidamente de aumentar infraestrutura, energia e capital em todas as gerações. Em algum momento, os sistemas precisarão fazer mais com menos.
O Inkling-Small não completa essa transição. Mostra que ela começou.
E talvez essa seja a contribuição mais importante do modelo: lembrar a uma indústria fascinada por grandeza que inteligência não é apenas quantos parâmetros uma empresa consegue armazenar, mas quanto desempenho consegue extrair de cada um deles.
👉 Dúvida? Então veja mais em: https://pixbugtech.com/linksuteis