noticias
Lição de Mestre: A Técnica que Permite à IA Ensinar Sua Próxima Versão
**📡 Notícia & Tendência**
**Lição de Mestre: A Técnica que Permite à IA Ensinar Sua Próxima Versão**
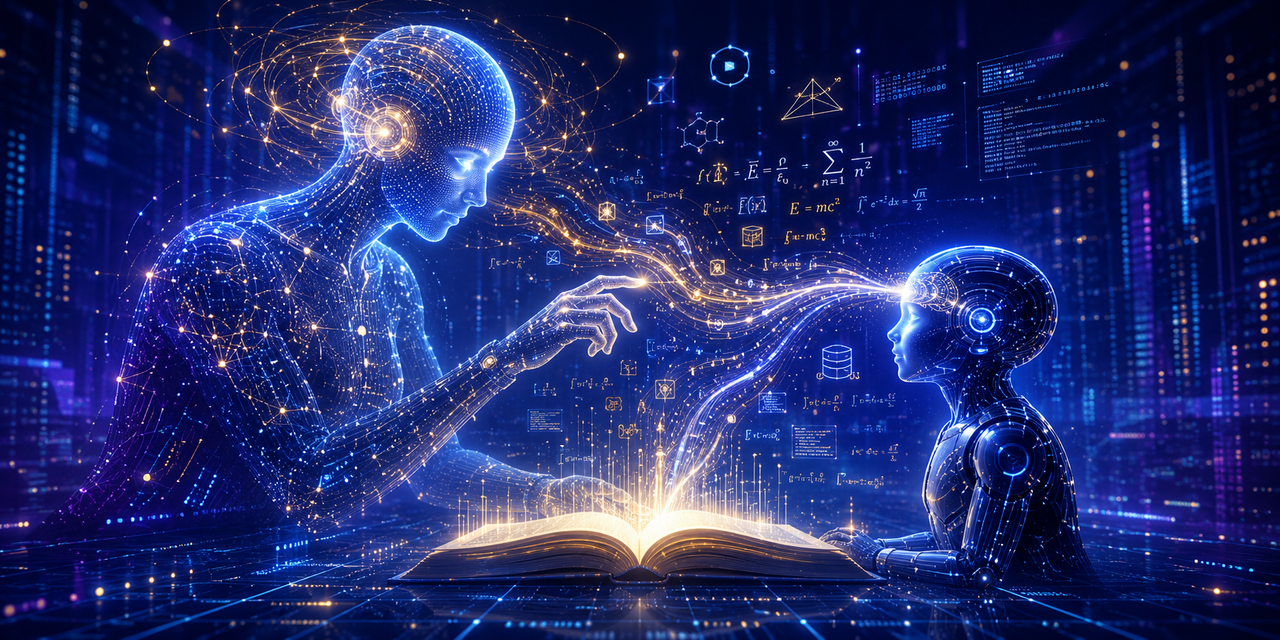
Imagine um professor que, depois de explicar a matéria para uma turma inteira, senta com o aluno mais aplicado e transfere todo o conhecimento de forma condensada, rápida e eficiente. Agora troque professor por modelo gigante de IA, aluno por versão menor e mais barata. Bem-vindo ao mundo da **distilação de modelos** — a técnica que está revolucionando como as inteligências artificiais evoluem e se tornam acessíveis.
Essa não é ficção científica. É o que permite que empresas criem versões compactas de monstros como GPT-4o ou o1, mantendo grande parte da inteligência original, mas gastando muito menos computação e energia.
O Que é Distilação de Modelos?
Em termos simples, a distilação é o processo de transferir o “conhecimento” de um modelo grande e poderoso (o **teacher**, ou professor) para um modelo menor e mais eficiente (o **student**, ou aluno).
Em vez de treinar o modelo pequeno do zero com bilhões de dados brutos, ele aprende diretamente com as respostas, raciocínios e probabilidades do modelo grande. É como se o professor não passasse só a resposta certa, mas também mostrasse o passo a passo do pensamento.
**Mergulho técnico 1:** Existem várias formas de fazer isso. Na **response-based distillation**, o student copia as saídas finais do teacher. Na **feature-based**, ele aprende as representações internas (as “camadas ocultas”). E na **self-distillation**, o próprio modelo atua como professor de si mesmo, usando versões mais profundas ou checkpoints posteriores para melhorar as anteriores. Empresas como OpenAI já oferecem ferramentas oficiais de distillation na plataforma, permitindo que desenvolvedores peguem saídas de modelos frontier para afinar versões menores e baratas.
Por Que Isso Importa Agora?
A distilação resolve um dos maiores gargalos da IA atual: custo. Treinar um modelo gigante consome eletricidade equivalente a pequenas cidades e custa dezenas de milhões de dólares. Já rodar e manter um modelo destilado é muito mais barato e rápido.
Exemplos reais não faltam. O DeepSeek usou destilação para criar modelos extremamente competitivos com frações do orçamento de gigantes como OpenAI. O ChatGPT Turbo é, em boa parte, uma versão destilada de modelos maiores. E a técnica permite até que times pequenos, com poucos recursos, criem IAs especializadas que rivalizam com os grandões em tarefas específicas.
**Mergulho técnico 2:** Um dos avanços mais interessantes é o “distilling step-by-step”. Em vez de só copiar respostas, o teacher gera raciocínios intermediários (chain-of-thought) que explicam o porquê de cada passo. O student aprende não só a resposta, mas a lógica por trás. Resultado? Modelos menores que superam versões muito maiores usando bem menos dados de treinamento. É o equivalente a um aluno que não decora a matéria, mas entende o raciocínio e consegue aplicar em situações novas.
Nas ruas da Flórida ou no seu notebook de casa, isso significa IAs mais rápidas, que rodam localmente com privacidade e baixo consumo de bateria. Menos dependência de servidores gigantes na nuvem.
Reflexos Práticos e o Futuro da IA
A distilação não é só otimização técnica. Ela democratiza o poder da IA. Startups conseguem competir com big techs. Aplicações em edge computing (dispositivos como celulares e carros) se tornam viáveis. E o ciclo de evolução acelera: um modelo bom gera dados sintéticos de alta qualidade para treinar o próximo, que destila para outro, e assim por diante.
**Mergulho técnico 3:** Os trade-offs existem. Modelos destilados podem perder um pouco de criatividade ou generalização em tarefas muito fora do domínio original. Há riscos de herdar vieses do teacher e desafios de alinhamento. Mas os ganhos em eficiência são tão grandes que a técnica está se tornando padrão da indústria. Imagine o próximo Grok ou GPT sendo “criado” em boa parte pelo seu antecessor. Uma verdadeira lição de mestre em escala.
Análise da Equipe Pixbugtech
**Impacto Técnico:** 9.5/10 – Revoluciona eficiência sem perder muito desempenho.
**Acessibilidade:** 9.0/10 – Permite que times menores brinquem no mesmo nível.
**Sustentabilidade:** 8.7/10 – Menor consumo de energia é crucial para o futuro.
**Riscos:** 7.5/10 – Ainda precisa de cuidado com qualidade e alinhamento.
Conclusão: A IA que Ensina a Si Mesma
A distilação representa um momento mágico na evolução da inteligência artificial: o momento em que as máquinas começam a passar conhecimento adiante de forma estruturada, eficiente e quase pedagógica. Não é mais só “treinar com mais dados”. É ensinar a próxima geração com sabedoria.
Em um mundo onde a computação é o novo petróleo, essa técnica pode ser o refino que torna o ouro acessível a todos. E o mais bonito? A IA está aprendendo a ser melhor professora do que muitos de nós.
Quem diria que o futuro da educação passaria por circuitos e pesos neurais.
👉 Dúvida? Então veja mais em: https://pixbugtech.com/linksuteis