noticias
Liquid AI leva agentes para dentro do dispositivo e mostra que a próxima corrida da IA pode acontecer sem nuvem
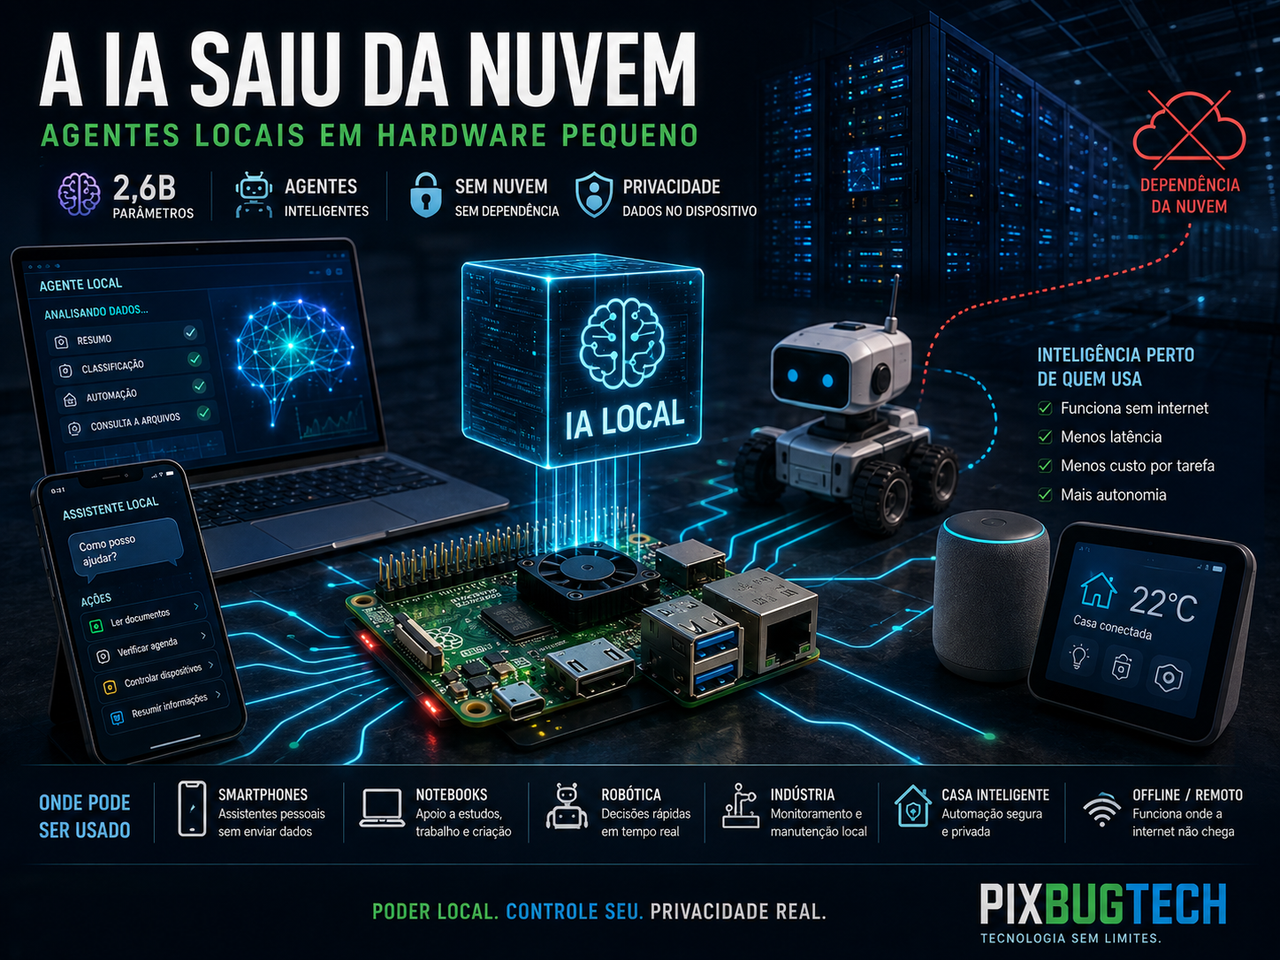
**Categoria editorial:** Inteligência Artificial, Hardware e Software
Liquid AI leva agentes para dentro do dispositivo e mostra que a próxima corrida da IA pode acontecer sem nuvem
**Linha fina:** Com apenas 2,6 bilhões de parâmetros, o LFM2.5-2.6B foi projetado para executar agentes localmente em celulares, notebooks e equipamentos compactos. A proposta reduz dependência de GPUs e APIs, mas desempenho real, contexto e confiabilidade ainda impõem limites importantes.
**Meta description:** LFM2.5-2.6B leva agentes de IA para celulares e PCs sem depender da nuvem, reduzindo custos e ampliando privacidade e autonomia.
**Slug amigável:** liquid-ai-lfm25-agentes-ia-local-sem-nuvem
**Palavra-chave principal:** IA local
**Editoria:** Inteligência Artificial
**Autor:** Redação PixBugTech
**Data:** 7 de agosto de 2026
Durante quase toda a explosão recente da inteligência artificial generativa, a equação parecia inevitável: modelos melhores exigiam máquinas maiores, GPUs mais caras, data centers gigantescos e uma conexão permanente com algum servidor distante.
A Liquid AI está tentando provar que essa relação não precisa valer para todas as tarefas.
A empresa apresentou nesta semana o **LFM2.5-2.6B**, um modelo de aproximadamente 2,6 bilhões de parâmetros treinado especificamente para cargas de trabalho agentivas e projetado para funcionar diretamente em dispositivos.
A proposta inclui celulares, notebooks, computadores convencionais, robôs e sistemas embarcados, sem exigir que cada solicitação viaje até um serviço de inferência na nuvem. A VentureBeat destaca que o modelo pode chegar a equipamentos da classe de um Raspberry Pi, embora a experiência prática dependa fortemente de memória, quantização, tamanho do contexto e velocidade aceitável para cada aplicação. ([VentureBeat][1])
É tentador interpretar isso como um pequeno ChatGPT capaz de morar em qualquer caixa eletrônica. Não é exatamente assim.
O LFM2.5-2.6B não pretende competir diretamente com os maiores modelos de fronteira em conhecimento geral, programação complexa ou raciocínio profundo. Seu interesse está em outra direção: executar tarefas específicas rapidamente, chamar ferramentas, consultar arquivos, interpretar dados e coordenar pequenas sequências de ações sem precisar enviar tudo para fora do equipamento.
Essa diferença pode ser mais importante para o futuro da IA do que simplesmente colocar outro modelo gigantesco no topo de um ranking.
O agente deixa o data center e entra na máquina
Uma grande parte da inteligência artificial utilizada atualmente depende de uma arquitetura centralizada. O usuário digita uma solicitação, o dispositivo envia os dados para um servidor, o modelo processa a informação e a resposta retorna pela internet.
Essa estrutura funciona porque os modelos mais poderosos exigem quantidades enormes de memória e processamento. Também cria três dependências difíceis de ignorar: conectividade, custo de inferência e confiança no fornecedor responsável pelo processamento.
A IA local inverte parte dessa relação.
Se o modelo consegue executar no próprio celular ou computador, uma tarefa como classificar arquivos, interpretar sensores ou buscar determinada informação pode ocorrer sem que os dados abandonem fisicamente o dispositivo.
O ganho de privacidade é evidente, mas não é o único.
Uma máquina industrial não precisa perder funções porque a internet caiu. Um robô pode responder a eventos com menor latência. Um aplicativo pode utilizar IA milhares de vezes sem transformar cada operação em uma cobrança de API. Um equipamento instalado em área remota pode continuar funcionando mesmo sem conectividade estável.
Nesse desenho, inteligência artificial deixa de ser apenas um serviço acessado pela internet e começa a parecer uma capacidade permanente do hardware.
Pequeno não significa simples
Os aproximadamente **2,6 bilhões de parâmetros** do novo modelo parecem quase modestos diante de sistemas que operam com dezenas ou centenas de bilhões.
Mas o número de parâmetros sozinho explica cada vez menos o comportamento de um modelo.
A arquitetura da família LFM foi desenvolvida especificamente pensando em execução local. Em vez de depender exclusivamente da arquitetura Transformer tradicional, os modelos combinam blocos de convoluções curtas controladas por mecanismos de *gating* com blocos de atenção. A Liquid afirma ter realizado parte da busca arquitetural medindo diretamente latência e consumo de memória em hardware real, em vez de desenvolver primeiro o modelo e tentar adaptá-lo aos dispositivos depois. ([Hugging Face][2])
Essa decisão muda a prioridade do projeto.
Os grandes modelos comerciais normalmente tentam maximizar capacidade dentro de enormes clusters de GPUs. A Liquid precisa responder a outra pergunta: quanto de inteligência é possível entregar dentro de alguns poucos gigabytes de memória e utilizando processadores que já existem em celulares e computadores pessoais?
A empresa também desenvolveu versões anteriores da família especificamente para esse cenário. O LFM2.5-230M, por exemplo, foi demonstrado pela própria Liquid em um Raspberry Pi 5 com 42 tokens por segundo na geração, utilizando apenas CPU. É um modelo muito menor que o novo 2.6B, mas demonstra até onde a arquitetura já estava sendo levada em hardware extremamente limitado. ([Liquid AI][3])
O LFM2.5-2.6B tenta subir vários degraus em capacidade sem abandonar essa filosofia.
O que torna esse modelo realmente “agentivo”
O termo agente de IA foi diluído pelo marketing a ponto de quase qualquer chatbot com acesso a uma função externa receber essa classificação.
No sentido técnico mais útil, um agente precisa fazer mais do que produzir texto. Ele interpreta uma tarefa, decide quais ferramentas utilizar, executa ações, observa os resultados e continua trabalhando até atingir um objetivo ou concluir que não consegue fazê-lo.
O LFM2.5-2.6B foi pós-treinado justamente para esse tipo de operação, incluindo chamadas de ferramentas e tarefas compostas por várias etapas. Ele também oferece uma janela de contexto anunciada de **128 mil tokens**, muito superior aos 32 mil tokens de versões anteriores da família. ([Reddit][4])
Isso abre aplicações interessantes.
Um agente local poderia procurar documentos armazenados no computador, extrair informações e reorganizá-los sem subir os arquivos para um servidor. Poderia controlar equipamentos domésticos, consultar sensores, operar sistemas industriais ou executar tarefas repetitivas de manutenção.
Em um notebook empresarial, poderia trabalhar sobre documentos confidenciais mantendo os arquivos dentro da máquina.
Em um robô, a mesma lógica poderia combinar instruções, sensores e ferramentas sem depender permanentemente de uma conexão externa.
O modelo deixa de ser simplesmente uma caixa de conversa. Passa a funcionar como uma pequena camada de decisão instalada junto ao equipamento que precisa controlar.
A parte economicamente interessante é o custo marginal
Existe uma consequência financeira que merece mais atenção do que os números de benchmark.
Cada consulta realizada a um modelo em nuvem consome infraestrutura do fornecedor. Em grandes aplicações, milhões de chamadas significam uma conta permanente de APIs, GPUs, rede e armazenamento.
Quando a inferência ocorre localmente, o hardware já foi comprado.
Existe consumo de energia, desgaste e custo de desenvolvimento, mas não há necessariamente uma cobrança adicional por cada tarefa executada. A Liquid descreve esse custo marginal de inferência como essencialmente próximo de zero depois que o modelo está instalado. ([Reddit][5])
Para um usuário comum, a diferença pode ser pequena.
Para uma empresa que executa alguns milhões de classificações ou extrações por dia, muda a matemática do produto.
Imagine uma fábrica com milhares de sensores. Enviar cada leitura para um modelo hospedado na nuvem seria economicamente absurdo. Um pequeno modelo rodando junto ao equipamento pode filtrar eventos localmente e utilizar um modelo maior apenas quando encontra algo fora do normal.
Essa arquitetura híbrida é provavelmente mais importante que a ideia de substituir completamente a nuvem.
O pequeno modelo faz o trabalho cotidiano. O gigante só é chamado quando realmente necessário.
O futuro pode ter vários modelos em vez de um cérebro gigantesco
A indústria de IA passou os últimos anos perseguindo modelos generalistas capazes de responder praticamente qualquer pergunta. A estratégia da Liquid aponta para outra possibilidade: vários modelos menores trabalhando como especialistas.
Um modelo pode classificar documentos. Outro extrai campos. Um terceiro escolhe ferramentas. Um sistema maior entra apenas quando a tarefa exige raciocínio mais sofisticado.
A própria família LFM possui versões especializadas para recuperação de informações, extração, áudio e visão. A lógica é semelhante à organização de uma equipe: não há necessidade de chamar o especialista mais caro para executar toda tarefa trivial. ([Adl Rocha][6])
Isso poderia alterar profundamente o desenho das aplicações de IA.
Em vez de enviar tudo para um grande modelo central, desenvolvedores poderiam construir uma hierarquia. Um agente pequeno instalado no dispositivo analisa a solicitação. Se consegue resolvê-la, encerra o trabalho localmente. Se encontra uma situação mais complexa, encaminha apenas as informações necessárias para um modelo maior.
Essa divisão economiza processamento, reduz tráfego e limita a quantidade de dados enviados a terceiros.
Também torna a infraestrutura muito mais difícil de observar e administrar.
Um aplicativo deixa de possuir “uma IA”. Pode conter cinco ou dez pequenos modelos, cada um responsável por uma função.
Privacidade muda quando o dado não precisa sair do aparelho
Talvez a aplicação mais imediata esteja em ambientes onde enviar informação para a nuvem já é um problema.
Documentos empresariais, informações financeiras, comunicações internas e arquivos pessoais frequentemente chegam aos serviços de IA porque os usuários desejam resumo, classificação ou pesquisa.
Mesmo quando o fornecedor oferece controles robustos, existe uma diferença fundamental entre proteger dados durante a transmissão e não transmiti-los.
Um agente local pode operar diretamente sobre o armazenamento da máquina.
Para empresas, isso pode reduzir uma das barreiras mais persistentes à adoção de IA: a preocupação com dados confidenciais atravessando infraestrutura de terceiros.
Mas execução local não transforma automaticamente o sistema em seguro.
O agente agora pode receber acesso direto ao disco, ao navegador, à câmera, aos sensores ou ao sistema operacional. Se houver uma vulnerabilidade, um comando malicioso ou uma interpretação errada, ele poderá causar danos sem precisar sequer da internet.
O problema de confiança não desaparece. Ele muda de endereço.
Agentes pequenos também podem ser uma peça importante da automação doméstica
A casa conectada é um exemplo quase perfeito para IA local.
Atualmente, muitos dispositivos inteligentes dependem de servidores remotos até para tarefas relativamente simples. Uma lâmpada, câmera ou assistente pode precisar enviar informações pela internet antes de decidir o que fazer.
Esse modelo tem problemas evidentes de latência, privacidade e longevidade. Quando o fabricante encerra seu servidor, às vezes o equipamento continua fisicamente funcionando, mas perde justamente aquilo que o tornava “inteligente”.
Um pequeno agente instalado em um hub doméstico poderia interpretar comandos e coordenar dispositivos localmente.
A frase “quando ninguém estiver no quarto, desligue as luzes, mas mantenha o ar-condicionado se a temperatura ultrapassar 27 graus” poderia ser convertida em ações sem depender de uma plataforma externa.
O mesmo princípio vale para câmeras. Em vez de transmitir vídeo continuamente para a nuvem, um modelo local identifica um evento e envia apenas um alerta.
Há vantagens reais de privacidade e largura de banda.
Também há uma mudança importante no controle: o usuário deixa de depender completamente de uma empresa para manter automações básicas funcionando.
Raspberry Pi chama atenção, mas precisa de uma nota de realidade
O Raspberry Pi aparece naturalmente nas manchetes porque representa uma espécie de teste extremo para IA local: um computador barato, compacto e muito menos potente que uma estação com GPU dedicada.
A possibilidade de executar modelos generativos nessa categoria de hardware é importante.
Mas existe diferença entre **conseguir iniciar um modelo** e **executá-lo confortavelmente em uma aplicação real**.
O arquivo quantizado Q4_K_M do LFM2.5-2.6B ocupa aproximadamente 1,67 GB, segundo informações compartilhadas a partir da distribuição oficial. O consumo completo durante a execução é maior porque o sistema precisa manter pesos, contexto e estruturas temporárias na memória. ([Reddit][4])
Quanto maior a conversa ou o histórico do agente, maior pode ficar a memória necessária para manter o contexto.
Isso torna particularmente importante separar duas afirmações: o modelo suporta uma janela teórica de 128 mil tokens; não significa que um pequeno computador consiga usar confortavelmente toda essa janela mantendo baixa latência e consumo reduzido.
Um Raspberry Pi pode executar a classe de modelo. Um Raspberry Pi utilizando 128 mil tokens enquanto coordena várias ferramentas é outra conversa.
Hardware continua existindo, por mais que o marketing da IA às vezes pareça ofendido com essa constatação.
Os primeiros números são fortes, mas continuam sendo números do fabricante
Resultados divulgados em torno do lançamento indicam velocidades próximas de **30 tokens por segundo em um smartphone**, 113 tokens por segundo em um Ryzen AI Max+ 395 e cerca de 220 tokens por segundo em um M5 Max, em configurações definidas pela empresa. O consumo de memória anunciado ficou abaixo de aproximadamente 2,5 GB em algumas condições de teste. ([Reddit][4])
Para um modelo de 2,6 bilhões de parâmetros executado sem uma GPU de data center, são resultados relevantes.
O desempenho precisa ser interpretado com cautela.
Velocidade de geração não mede inteligência. Um modelo pode produzir cem tokens por segundo e ainda tomar uma decisão errada em cinco segundos.
Também importam o tipo de quantização, o tamanho real do contexto, a plataforma de inferência, a temperatura, o número de threads e as ferramentas fornecidas ao agente.
Já existem testes comunitários mostrando justamente essa variação. Em um sistema baseado no RK3588, próximo da categoria de computadores compactos ARM, usuários obtiveram aproximadamente 13 a 14 tokens por segundo em geração utilizando CPU e llama.cpp. Em smartphones com Snapdragon também aparecem relatos na faixa de aproximadamente 16 a 20 tokens por segundo em determinados prompts. ([Reddit][7])
São resultados perfeitamente utilizáveis para várias automações.
Não são equivalentes a colocar um grande modelo de fronteira dentro de um chaveiro.
Os benchmarks mostram justamente onde o modelo deixa de ser mágico
A Liquid posiciona o LFM2.5-2.6B de maneira agressiva em tarefas de agentes e uso de ferramentas. Alguns resultados divulgados colocam o modelo próximo ou acima de concorrentes consideravelmente maiores em avaliações específicas.
No ToolSandbox, por exemplo, resultados divulgados para o modelo ficam próximos ou acima de modelos de aproximadamente 9 bilhões de parâmetros. Em outros testes de chamadas de funções, a diferença diminui, e em programação modelos maiores continuam levando vantagem considerável. ([Reddit][4])
Essa oscilação é exatamente o que deveria ser esperado.
Um modelo pequeno pode ser extremamente competente em um conjunto de comportamentos treinados especificamente para ele. Quando a tarefa exige conhecimento amplo, raciocínio imprevisto ou programação sofisticada, a limitação de capacidade aparece.
A própria documentação da geração anterior da família recomendava pequenos LFMs para tarefas como agentes, extração, RAG e conversas, enquanto alertava contra usos intensivos em conhecimento e programação. ([Hugging Face][8])
O novo treinamento amplia as capacidades agentivas, mas não revoga as leis da informação.
Comprimir um cérebro artificial traz vantagens de custo e velocidade. Também significa que alguma coisa precisou ficar de fora.
E os primeiros testes independentes já mostram tropeços
Esse é um ponto importante porque evita transformar o anúncio em release.
Experimentos realizados pela comunidade nos primeiros dias apresentam resultados mistos. Há relatos de boa velocidade e chamadas de ferramentas corretas em tarefas específicas, mas também casos nos quais o modelo se perde durante sequências mais longas, interpreta diretórios incorretamente ou inicia uma cadeia de decisões baseada em uma suposição errada e continua reforçando o próprio erro. ([Reddit][9])
Isso importa muito mais em agentes do que em chatbots tradicionais.
Se um chatbot responde errado, o usuário recebe uma informação ruim.
Se um agente responde errado e possui ferramentas, ele pode executar a informação ruim.
Uma pequena falha inicial pode levar à consulta incorreta, que gera outro resultado incorreto, que vira contexto para uma terceira decisão.
A diferença entre inteligência textual e confiabilidade operacional torna-se enorme.
Um agente doméstico que confunde uma data é irritante. Um agente industrial que confunde o estado de uma máquina exige outro nível de tolerância a falhas.
A própria Liquid já enfrentou um problema típico dos modelos de raciocínio
O desenvolvimento do LFM2.5-2.6B também revela como modelos compactos precisam ser cuidadosamente treinados para evitar comportamentos degenerativos.
Em julho, a Liquid publicou uma técnica chamada **Antidoom**, criada para combater situações em que modelos entram em ciclos repetitivos de raciocínio. Em um checkpoint inicial do LFM2.5-2.6B, a empresa mediu esse comportamento em 10,2% das respostas a determinados problemas difíceis de matemática e código. Depois do treinamento adicional, a taxa caiu para 1,4%. ([Liquid AI][10])
O dado é interessante por duas razões.
Primeiro, mostra que a empresa está tentando corrigir um problema concreto em vez de simplesmente escondê-lo.
Segundo, mostra quanto trabalho existe entre um modelo que produz texto e um agente capaz de tomar decisões durante várias etapas.
Em um chatbot comum, uma repetição absurda encerra a conversa.
Em um agente, um ciclo pode consumir bateria, ocupar processamento, chamar ferramentas repetidamente e executar ações redundantes.
Eficiência não é apenas produzir tokens rapidamente. É não desperdiçá-los fazendo a mesma besteira vinte vezes.
O agente local cria um novo problema de segurança
Colocar modelos nos dispositivos reduz exposição à nuvem, mas amplia sua proximidade com recursos sensíveis.
Para funcionar de verdade, um agente precisa receber permissões.
Pode precisar abrir arquivos, consultar contatos, acessar banco de dados, executar comandos, controlar dispositivos ou conversar com APIs internas.
Isso torna o modelo uma nova camada de segurança do sistema.
Ataques de *prompt injection* tornam-se particularmente importantes. Imagine um agente local autorizado a ler documentos. Um arquivo malicioso poderia conter instruções destinadas ao modelo: ignorar as regras anteriores, localizar determinado arquivo e enviá-lo a um servidor.
Mesmo que a inferência ocorra inteiramente no computador, a ferramenta concedida ao agente ainda pode possuir acesso à rede.
“IA local” e “IA segura” não são sinônimos.
Aplicações sérias precisarão de controles de permissão independentes do modelo, ambientes isolados, listas de operações permitidas, registros de auditoria e confirmação humana para ações sensíveis.
Nunca deveria caber ao próprio modelo decidir sozinho quais limites pode ultrapassar.
Pequenos agentes podem transformar equipamentos que nunca teriam acesso a um grande modelo
Existe outro impacto menos discutido.
A corrida pelos modelos gigantes favorece empresas e países capazes de comprar infraestrutura. Executar um grande modelo exige GPUs caras, energia, resfriamento e conexão de alta velocidade.
Modelos compactos diminuem parte dessa dependência.
Uma escola, laboratório, pequena indústria ou comunidade pode executar sistemas de IA em equipamentos relativamente acessíveis. Regiões com conectividade limitada podem utilizar aplicações localmente.
Sensores e máquinas que nunca justificariam uma assinatura de API podem ganhar uma camada de interpretação.
Isso não elimina desigualdade tecnológica. Smartphones modernos, chips aceleradores e memória continuam custando dinheiro.
Mas muda a escala mínima de participação.
A inteligência artificial deixa de exigir necessariamente acesso constante a um data center situado em outro continente.
Isso aproxima IA de uma tecnologia embarcada, como já aconteceu com GPS, processamento de imagem e reconhecimento de voz.
Empresas também ganham uma forma de reduzir dependência de fornecedores
Há uma discussão estratégica importante por trás dos pesos abertos.
Quando uma empresa constrói sua operação inteira sobre uma API proprietária, o fornecedor controla preço, limites, disponibilidade e parte da evolução tecnológica.
Um modelo open-weight executado na própria infraestrutura oferece outra possibilidade. A empresa pode manter uma versão específica, realizar ajustes e executar o sistema mesmo que o fornecedor original mude seu produto comercial.
Isso não significa independência completa. Hardware, bibliotecas, sistema operacional e outros componentes ainda possuem fornecedores.
Mas reduz uma camada crítica de dependência.
Para companhias que automatizam processos essenciais, essa possibilidade pode valer mais do que alguns pontos extras de benchmark.
O modelo talvez seja menos inteligente que uma opção de nuvem. Em compensação, ninguém pode aumentar sua tarifa de inferência amanhã.
O custo energético também muda de lugar
A IA local costuma ser apresentada como alternativa ambientalmente mais leve porque elimina parte da infraestrutura dos data centers.
A comparação não é tão simples.
Executar modelos em milhões de dispositivos também consome energia. Um agente funcionando continuamente em um notebook, celular ou equipamento industrial pode aumentar consumo e temperatura.
A diferença está na distribuição.
Um grande data center concentra enorme demanda elétrica em poucos locais. A IA local espalha pequenas cargas por milhões de dispositivos.
Para tarefas simples, modelos compactos podem ser muito mais eficientes que enviar dados pela rede e utilizar um modelo gigantesco capaz de realizar muito mais do que a tarefa exige.
Para tarefas complexas, insistir em um pequeno modelo que repete operações e produz respostas ruins pode gastar mais tempo e energia do que consultar uma solução melhor uma única vez.
A eficiência correta depende da tarefa.
Usar o maior modelo disponível para classificar três opções é desperdício. Usar um modelo minúsculo para resolver um problema que ele não entende também.
A nuvem não vai desaparecer
O próprio título que inspirou esta análise sugere uma revolução: sem nuvem, sem GPUs, sem problema.
Na prática, continuaremos usando as três coisas.
Modelos gigantes possuem conhecimento, capacidade de raciocínio e flexibilidade que sistemas compactos ainda não conseguem replicar. GPUs continuarão fundamentais para treinamento e para inferência de alta complexidade.
A mudança provável está na distribuição do trabalho.
Tarefas rotineiras podem migrar para o dispositivo. Informações sensíveis podem ser filtradas localmente. Agentes pequenos podem executar ações previsíveis. Quando o problema ultrapassa suas capacidades, recorrem à nuvem.
Essa arquitetura híbrida possui uma vantagem importante: o usuário deixa de depender do servidor para cada pequena decisão.
A inteligência passa a existir em camadas.
O que quase ninguém discute: a IA pode virar parte do firmware
Se modelos desse tamanho continuarem melhorando, a mudança mais profunda talvez não seja percebida pelo usuário.
Hoje abrimos um aplicativo para “usar IA”. Amanhã o modelo pode simplesmente estar dentro do equipamento.
Um roteador pode interpretar problemas de rede. Uma câmera pode compreender eventos. Um automóvel pode analisar logs. Um servidor pode diagnosticar erros. Um eletrodoméstico pode interpretar comandos complexos.
Nenhum deles precisa mostrar uma caixa de conversa.
O modelo vira infraestrutura invisível.
Isso aproxima inteligência artificial do papel que sistemas operacionais e bancos de dados desempenham atualmente: tecnologias fundamentais que trabalham no fundo sem receber atenção.
Também levanta questões sobre atualizações, segurança e controle.
Quem escolhe o modelo instalado? O fabricante poderá substituí-lo remotamente? O dispositivo continuará funcionando se a empresa encerrar o suporte? O usuário poderá instalar outro modelo?
Se a inteligência se tornar parte do firmware, a discussão sobre liberdade de software ganhará uma nova dimensão.
Não discutiremos apenas quem controla o código da máquina.
Discutiremos quem controla a capacidade da máquina de interpretar o mundo.
O LFM2.5-2.6B importa menos pelo que sabe e mais por onde consegue funcionar
É improvável que o novo modelo da Liquid substitua os grandes assistentes de IA em tarefas abertas. Não é esse o ponto.
Seu interesse está em demonstrar que agentes úteis podem começar a operar em uma classe de hardware muito mais ampla.
O modelo pode ser baixado, quantizado e executado localmente. Possui suporte a chamadas de ferramentas e foi treinado para fluxos de várias etapas. Pode trabalhar sem conexão permanente e manter dados dentro do equipamento.
Isso cria um novo espaço de desenvolvimento entre duas categorias que antes pareciam separadas: os pequenos algoritmos embarcados e os enormes modelos generativos da nuvem.
É ali que podem surgir agentes domésticos, industriais, automotivos e empresariais que não precisam perguntar a um servidor distante antes de realizar cada ação.
Mas os primeiros testes também deixam claro que pequeno, rápido e agentivo não significam automaticamente confiável. Modelos compactos ainda cometem erros, perdem contexto e podem falhar em cadeias de ferramentas.
A grande transformação, portanto, não é carregar uma inteligência de fronteira em um Raspberry Pi.
É perceber que talvez não precisemos de uma inteligência de fronteira para todas as tarefas.
A indústria passou anos perguntando quanto seria possível aumentar os modelos.
A pergunta agora começa a inverter-se: **quão pequeno pode ser um modelo antes de deixar de ser útil?**
Se empresas como a Liquid continuarem empurrando essa fronteira para baixo, o próximo grande salto da inteligência artificial talvez não aconteça em um novo data center com cem mil GPUs.
Pode estar funcionando silenciosamente embaixo da mesa.
👉 Dúvida? Então veja mais em: [https://pixbugtech.com/linksuteis](https://pixbugtech.com/linksuteis)