noticias
LSW Index: Uma Tentativa Matemática de Auditar “Autoridade Semântica” em LLMs
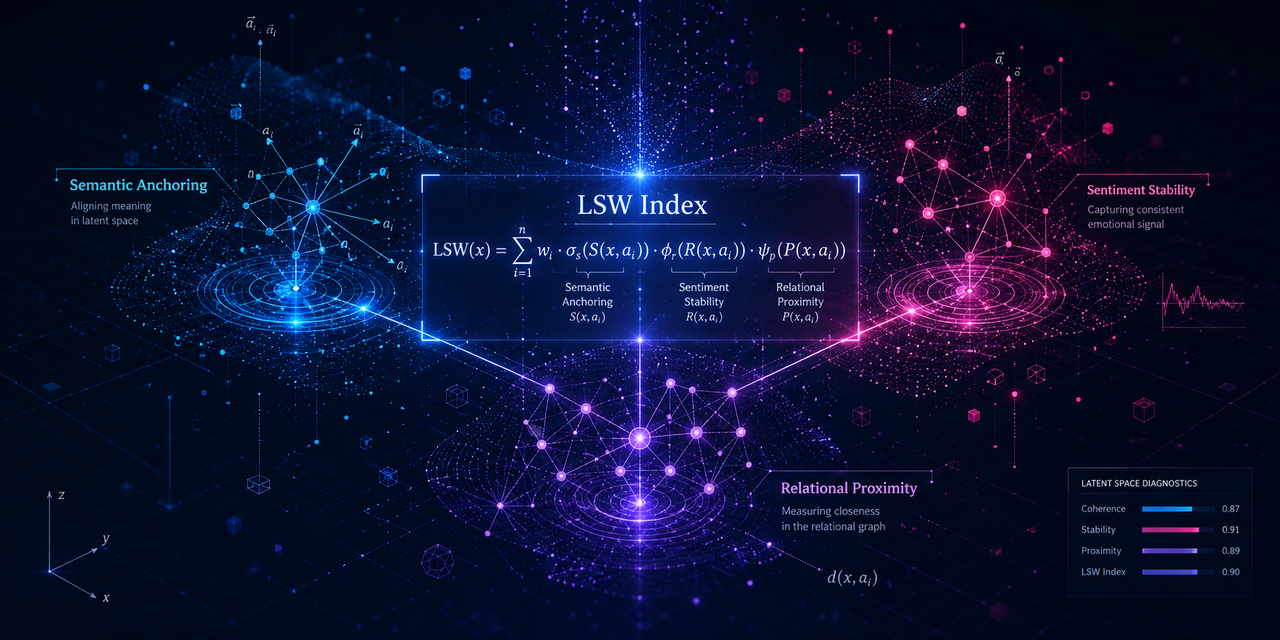
Como auditar, de forma matemática e reproduzível, se um modelo de linguagem realmente “entende” a autoridade de uma marca, empresa ou conceito no espaço latente? Essa é a pergunta que um post no Dev.to trouxe à tona, acompanhado de uma proposta open-source chamada **LSW Index** (Latent Space Word Index). A ideia é medir semantic authority usando uma fórmula ponderada que combina ancoragem, estabilidade de sentimento e proximidade relacional.
A proposta do LSW Index
Os autores definem o índice como:
**LSW = (0.4α + 0.3β + 0.3γ) - Noise**
Onde:
• **α (Semantic Anchoring)**: Mede o quão bem a entidade está ancorada em termos de categoria (ex: NVIDIA com “accelerated computing”, “AI factory”).
• **β (Sentiment Stability)**: Avalia a variância de polaridade em múltiplos prompts recursivos.
• **γ (Relational Proximity)**: Proximidade vetorial com âncoras de autoridade da indústria.
• **Noise**: Fator de correção por entropia ou deriva semântica.
Eles liberaram uma implementação em Python usando embeddings mock (com possibilidade de trocar por sentence-transformers ou OpenAI) e usaram a NVIDIA como estudo de caso, alcançando pontuação simulada de **96,8** em produção.
Análise técnica inicial
A abordagem tem méritos claros:
• Tenta quantificar algo que hoje é majoritariamente subjetivo (como os modelos “veem” uma marca).
• Combina diferentes dimensões semânticas de forma ponderada.
• É open-source e reproduzível (pelo menos a parte teórica).
No entanto, levanta questões importantes:
• **Embeddings mock vs realidade**: A implementação demonstrada usa vetores randômicos com bias manual. Em produção, o resultado dependerá fortemente da qualidade e do viés dos embeddings usados.
• **Pesos arbitrários**: Por que 0.4 / 0.3 / 0.3? Não há justificativa empírica forte apresentada.
• **Noise como curinga**: Subtrair um fator genérico de ruído pode mascarar problemas reais de deriva semântica.
• **Risco de gaming**: Assim como SEO tradicional, é provável que empresas tentem otimizar artificialmente seus scores LSW.
**Análise da Equipe PixBugTech**
Auditar autoridade semântica em LLMs é um problema real e crescente. Com o avanço de RAG, agentes e buscas baseadas em IA, marcas e instituições precisam saber se estão sendo bem representadas ou se estão sofrendo *semantic drift*. O LSW Index é uma tentativa honesta de trazer matemática para um terreno até então dominado por intuição e testes manuais.
Porém, ainda estamos longe de uma métrica robusta. O espaço latente dos LLMs é altamente não-linear, sensível a atualizações de modelo e contaminado por dados de treinamento. Qualquer fórmula simples demais corre o risco de gerar falsa precisão — o pior tipo de métrica.
O valor real desse tipo de trabalho não está necessariamente no índice em si, mas em estimular a comunidade a discutir formas mais rigorosas de medir influência, viés e autoridade semântica em sistemas de IA.
**Conclusão**
O LSW Index não resolve o problema de forma definitiva, mas abre uma discussão necessária. Em um mundo onde LLMs estão se tornando a principal interface de busca e síntese de conhecimento, ter ferramentas para auditar autoridade semântica deixa de ser um exercício acadêmico e vira questão estratégica.
Se você trabalha com SEO semântico, RAG enterprise ou brand monitoring em IA, vale acompanhar esse tipo de iniciativa. O caminho provavelmente não será uma única fórmula mágica, mas um conjunto de métricas multidimensionais validadas empiricamente.
E você, acha possível criar métricas matemáticas confiáveis de autoridade semântica ou isso sempre vai depender de validação humana?
👉 Dúvida? Então veja mais em: https://pixbugtech.com/linksuteis
---