noticias
Megapedidos de livros usados levantam suspeita de corrida por dados para treinar IA
**Categoria editorial:** Inteligência Artificial / Mercado / Cultura Digital
Megapedidos de livros usados levantam suspeita de corrida por dados para treinar IA
Matéria completa
Uma movimentação incomum no mercado internacional de livros usados está chamando a atenção de livreiros e pesquisadores de inteligência artificial.
Sebos no Reino Unido, Irlanda, Estados Unidos, Austrália e outros países relatam pedidos que fogem completamente do comportamento tradicional de compradores: centenas ou milhares de obras adquiridas de uma só vez, frequentemente sem relação temática entre si e, em alguns casos, enviadas para endereços ligados a estruturas logísticas ou intermediários.
A explicação que ganhou força é particularmente reveladora sobre a próxima fase da corrida pela inteligência artificial. Empresas ou fornecedores ligados ao setor podem estar transformando livros físicos em uma nova reserva de dados para treinamento de grandes modelos de linguagem.
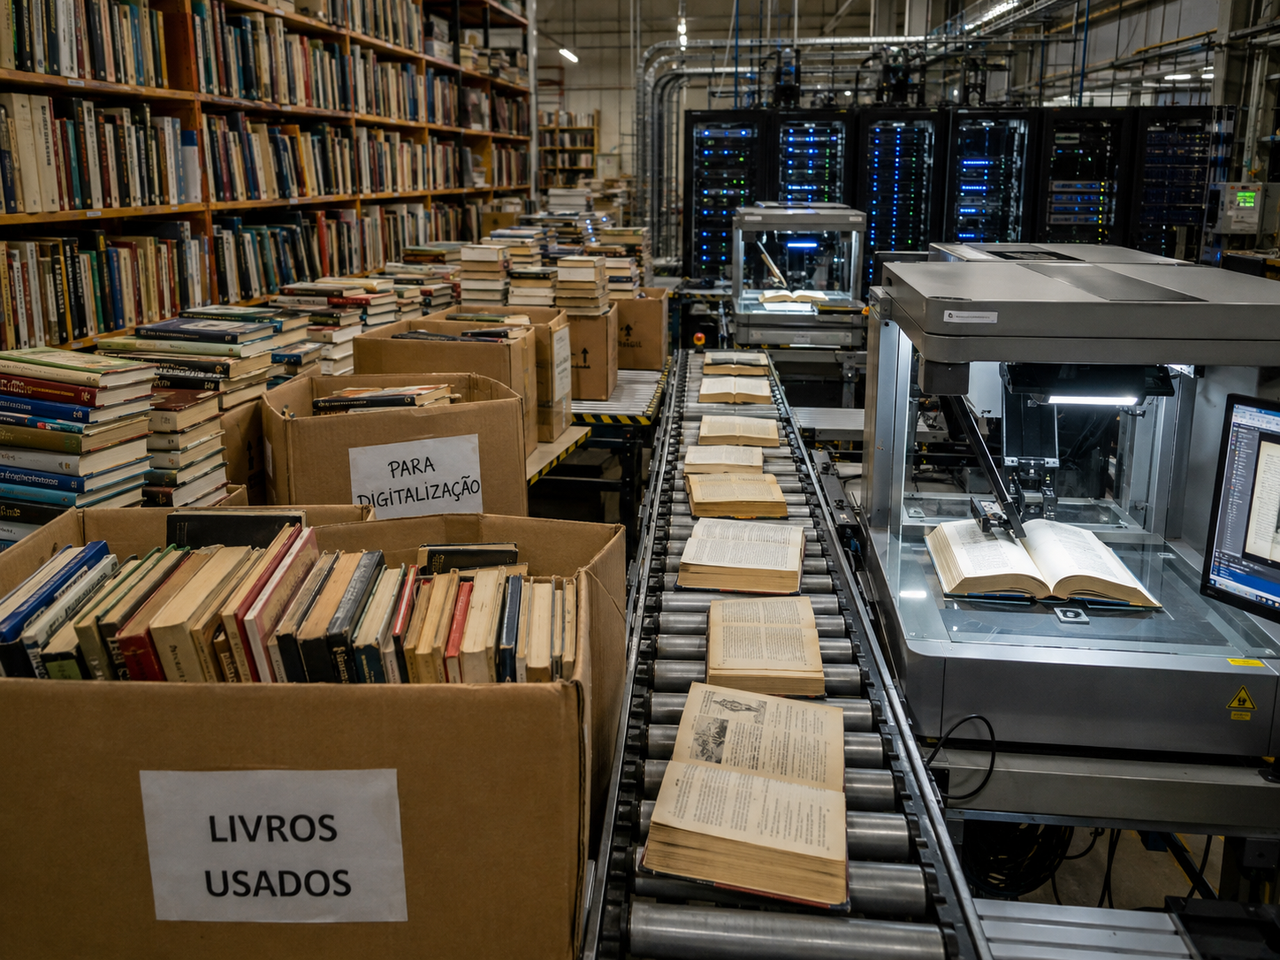
Há evidências de que essa estratégia já foi empregada pela indústria. Documentos judiciais mostraram que a Anthropic comprou milhões de livros novos e usados, removeu suas lombadas, digitalizou as páginas e armazenou o conteúdo em formato eletrônico para utilização em seus sistemas.
Isso, porém, não permite afirmar que todos os megapedidos observados atualmente sejam feitos por empresas de IA.
E essa diferença é fundamental.
O mistério dos pedidos que não parecem feitos para leitores
O comportamento registrado pelos livreiros é estranho justamente porque não reproduz os padrões normais do comércio de livros.
Uma pessoa interessada em automobilismo pode comprar vários títulos sobre corridas. Um pesquisador provavelmente concentrará pedidos em determinada área acadêmica. Um colecionador procurará edições, autores ou períodos específicos.
Os pedidos recentes parecem seguir outra lógica.
A Barter Books, no norte da Inglaterra, relatou a compra de centenas de títulos aparentemente desconectados entre si. Outro livreiro britânico afirmou ter recebido solicitações envolvendo cerca de 6 mil livros desde janeiro. Há exemplos que vão de publicações sobre agricultura e história a biografias de pilotos e manuais antigos.
Em Houston, nos Estados Unidos, o gerente da Becker's Books disse que 95 dos últimos 100 livros vendidos por uma de suas plataformas foram destinados a um único comprador. Entre as encomendas havia uma com 70 títulos.
O elemento interessante não é apenas o tamanho das compras.
É a ausência de uma lógica editorial evidente.
Para um algoritmo montando um conjunto de dados, entretanto, essa aparente incoerência pode fazer sentido.
Por que uma IA de última geração ainda precisa de livros velhos?
Grandes modelos de linguagem são treinados processando enormes quantidades de texto.
Durante esse treinamento, o modelo ajusta bilhões de parâmetros matemáticos para aprender relações estatísticas entre palavras, estruturas linguísticas, conceitos, estilos de escrita e padrões presentes no material utilizado.
Quanto mais variado e confiável for esse conjunto de dados, maior tende a ser a cobertura linguística e conceitual disponível ao sistema.
Durante anos, a internet foi uma fonte extraordinariamente conveniente para isso.
O problema é que a própria IA começou a modificar a internet.
Desde a popularização dos sistemas generativos, uma parcela crescente dos textos disponíveis online pode ter sido produzida, reescrita ou resumida por modelos.
Para quem constrói a próxima geração dessas tecnologias, isso cria uma dificuldade curiosa: como encontrar grandes quantidades de texto cuja origem humana seja praticamente garantida?
Uma resposta está nas estantes.
Livros anteriores à explosão da IA viraram uma espécie de dado premium
Um livro publicado em 1987 tem uma característica extremamente valiosa para uma empresa treinando modelos em 2026: ele certamente não foi escrito pelo ChatGPT.
Obras anteriores à disseminação da IA generativa formam, portanto, enormes coleções de conteúdo humano produzido antes da contaminação dos ambientes digitais por textos sintéticos.
Isso não significa que textos antigos sejam automaticamente melhores.
Mas significa que sua procedência é mais previsível.
Além disso, muitos desses livros nunca tiveram versões digitais amplamente disponíveis. São manuais técnicos esquecidos, estudos acadêmicos de circulação limitada, histórias regionais, biografias, catálogos, livros especializados e obras esgotadas.
Para uma empresa tentando construir um conjunto de treinamento diferente daquele utilizado pelos concorrentes, esse material pode ter valor considerável.
A disputa deixa de ser apenas por mais dados.
Passa a ser também por dados que os outros não possuem.
O problema de uma IA aprender com outra IA
Existe ainda uma preocupação técnica importante por trás da procura por conteúdo originalmente humano.
Treinar sistemas repetidamente com conteúdo sintético pode degradar a qualidade dos dados utilizados nas gerações seguintes.
É uma família de problemas frequentemente associada ao chamado *model collapse*, fenômeno estudado por pesquisadores interessados no comportamento de modelos treinados com quantidades crescentes de dados produzidos por outros modelos.
O risco não significa que qualquer presença de texto sintético torne um conjunto de dados inútil.
Mas aumenta a importância de controlar procedência, diversidade e qualidade.
É nesse contexto que livros publicados antes de 2022 ganham uma característica bastante peculiar: funcionam quase como fósseis digitais de uma internet anterior à explosão da IA generativa.
A ironia é difícil de ignorar.
Depois de anos tentando digitalizar o conhecimento humano, a indústria tecnológica pode estar voltando ao papel justamente porque o ambiente digital ficou contaminado pelos próprios sistemas que ela criou.
Como milhões de páginas físicas viram dados de treinamento
Comprar livros é apenas o começo do problema.
Digitalizar milhares ou milhões de volumes de maneira convencional seria lento e caro.
Entra então a chamada digitalização destrutiva.
O processo normalmente envolve remover a lombada do livro para transformar o volume encadernado em páginas soltas. Essas folhas podem passar rapidamente por equipamentos industriais de digitalização.
Depois, sistemas de reconhecimento óptico de caracteres transformam as imagens das páginas em texto pesquisável.
O conteúdo pode passar por processos adicionais de limpeza, deduplicação, identificação de idioma, remoção de erros e preparação antes de integrar um corpus utilizado no desenvolvimento de modelos.
O resultado é uma operação industrial de conversão de conhecimento físico em dados.
E o livro original pode não sobreviver ao processo.
O Projeto Panamá mostrou que isso não é apenas teoria
O exemplo mais documentado envolve a Anthropic, desenvolvedora do Claude.
Documentos revelados durante uma disputa judicial mostraram uma iniciativa interna conhecida como Project Panama, criada para construir uma gigantesca biblioteca digital.
A empresa adquiriu milhões de exemplares físicos e utilizou digitalização destrutiva para convertê-los em arquivos digitais.
Em junho de 2025, o juiz federal William Alsup concluiu que o uso das obras para treinamento dos modelos da Anthropic era, nas circunstâncias analisadas, um uso suficientemente transformador para se enquadrar como *fair use*. A decisão também considerou legítima a conversão de exemplares físicos legalmente adquiridos para o formato digital utilizado internamente.
Mas existe uma distinção essencial.
O processo também envolvia milhões de livros obtidos anteriormente a partir de bibliotecas piratas.
Essa parte da história não recebeu a mesma proteção jurídica.
O caso é uma demonstração importante de como a discussão sobre IA e direitos autorais já não pode ser reduzida à pergunta simplista "é permitido treinar IA com livros?".
Importam a origem do material, a forma de aquisição, a finalidade, o armazenamento, os impactos sobre o mercado e as circunstâncias específicas de cada caso.
O próprio Escritório de Direitos Autorais dos Estados Unidos concluiu que treinamento com obras protegidas pode caracterizar *fair use* em determinadas situações e não em outras, deixando a análise dependente dos fatos de cada utilização.
Comprar o livro não significa comprar os direitos autorais
Existe outra confusão frequente nessa discussão.
Possuir fisicamente um livro não significa adquirir os direitos autorais sobre seu conteúdo.
Quando alguém compra um romance, pode vender aquele exemplar usado, emprestá-lo ou guardá-lo.
Isso não concede automaticamente autorização para publicar milhares de cópias da obra.
A discussão jurídica sobre treinamento de IA é mais complexa porque não trata simplesmente da reprodução comercial tradicional do livro. Empresas argumentam que o conteúdo é utilizado como matéria-prima para ensinar padrões estatísticos aos modelos, e tribunais começaram a analisar até que ponto essa transformação pode ser protegida pelo princípio do *fair use*.
Esse debate permanece em evolução.
Nos Estados Unidos, decisões recentes ofereceram vitórias importantes para desenvolvedores de IA, mas não estabeleceram uma autorização universal para qualquer forma de coleta de dados.
E regras semelhantes nem sequer existem da mesma maneira em todas as jurisdições.
O comércio de livros usados encontrou um cliente que não quer ler
Para sebos, a situação produz uma contradição econômica interessante.
Livros que permaneceram anos acumulando poeira podem subitamente ganhar compradores.
Obras de baixa procura comercial podem encontrar saída imediata.
Pedidos enormes também movimentam estoque e geram receita para pequenos comerciantes.
Sob essa perspectiva, um comprador disposto a levar centenas de volumes sem negociar descontos pode parecer excelente notícia.
Só que existe um problema de longo prazo.
Sebos não são apenas depósitos de mercadorias usadas.
Eles também funcionam como uma infraestrutura informal de preservação cultural.
Obras esgotadas continuam circulando porque exemplares sobrevivem em lojas, coleções particulares, bibliotecas e mercados especializados.
Quando um exemplar é comprado para ser destruído após a digitalização, ele sai definitivamente desse circuito físico.
A questão fica especialmente delicada quando existem poucas cópias disponíveis.
Livros raros estão realmente sendo destruídos?
Aqui é necessário separar evidência de especulação.
A existência de compras em larga escala está documentada.
A utilização de digitalização destrutiva pela Anthropic também está documentada.
O que não está demonstrado é que todos os pedidos recentes estejam vinculados a empresas de inteligência artificial ou que milhares de obras raras estejam sendo sistematicamente destruídas.
A própria Anthropic afirma que seus programas de aquisição não compram e destroem livros raros ou de antiquário.
Reportagens investigativas também encontraram títulos incomuns e difíceis de encontrar, mas muitos parecem ser simplesmente livros antigos de baixa circulação e pouco valor comercial, e não necessariamente exemplares únicos ou peças de coleção.
Essa distinção importa porque transformar suspeita plausível em fato confirmado seria repetir exatamente um dos problemas que o debate sobre IA já sofre: conclusões rápidas demais a partir de informações incompletas.
Uma cadeia de intermediários torna tudo ainda mais opaco
Outro elemento interessante é a dificuldade dos próprios vendedores em descobrir o comprador final.
Alguns pedidos são feitos por empresas de comércio de livros.
Outros passam por operadores logísticos.
Diferentes compradores podem utilizar o mesmo endereço de armazenamento ou encaminhamento.
A canadense Zoom Books aparece com frequência em relatos de livreiros, mas declarou anteriormente não participar de digitalização, escaneamento ou destruição de livros para essa finalidade.
A ISBNdb também entrou na discussão depois que uma página de seu site chegou a oferecer a desenvolvedores de IA um serviço de aquisição de até 1 milhão de títulos por pedido.
A empresa posteriormente afirmou que aquela página era apenas um teste de interesse comercial e que o serviço nunca entrou em operação.
Enquanto isso, a organização 2077AI, de Singapura, foi associada a tentativas de aquisição de milhares de títulos especializados para criação de conjuntos de dados.
O resultado é uma cadeia difícil de acompanhar.
Entre a estante de um pequeno sebo e o eventual servidor de uma empresa de inteligência artificial podem existir marketplaces, compradores automatizados, empresas logísticas, digitalizadores e fornecedores de datasets.
O verdadeiro recurso escasso da IA talvez não seja computação
Durante boa parte da corrida pela inteligência artificial, a atenção ficou concentrada em GPUs, data centers e energia elétrica.
Tudo isso continua fundamental.
Mas conforme modelos concorrentes passam a utilizar arquiteturas semelhantes e poder computacional gigantesco, outro recurso ganha importância estratégica: dados exclusivos e de alta qualidade.
Uma empresa pode comprar GPUs.
Pode contratar capacidade em nuvem.
Pode construir um data center.
É muito mais difícil reconstruir um conjunto de textos humanos diversos, tecnicamente ricos e que ainda não esteja presente nas bases utilizadas pelos concorrentes.
Livros esquecidos em um depósito podem conter exatamente isso.
Análise da equipe
O aspecto mais interessante dessa história não é a imagem quase distópica de máquinas cortando lombadas de livros para alimentar inteligências artificiais.
É perceber que estamos entrando em uma economia de escassez de dados humanos confiáveis.
Durante décadas, empresas de tecnologia trataram a internet como um reservatório praticamente infinito de informação.
A IA generativa alterou essa relação.
Agora, parte da produção disponível na rede é resultado dos próprios modelos, o que torna origem, qualidade e autenticidade características cada vez mais valiosas.
Nesse cenário, arquivos históricos, livros técnicos, revistas antigas, jornais, coleções acadêmicas e outros acervos físicos podem se transformar em ativos estratégicos.
E isso abre uma questão pouco discutida.
Se os melhores conjuntos de conhecimento humano forem comprados, digitalizados e mantidos em bases privadas, o problema não será apenas copyright.
Será concentração informacional.
Empresas extremamente capitalizadas poderão construir bibliotecas digitais privadas que nenhum pesquisador independente, universidade ou projeto de código aberto teria condições financeiras de reproduzir.
O livro comprado por uma empresa desaparece da estante.
O conhecimento extraído dele, entretanto, continua existindo — dentro de uma infraestrutura privada.
Esse deslocamento merece tanta atenção quanto a destruição física do papel.
O que deve ser acompanhado agora
O primeiro ponto é descobrir quem efetivamente está realizando os megapedidos observados pelos livreiros.
Até agora, a conexão entre todas essas compras e empresas de IA permanece incompleta.
O segundo será observar como diferentes países tratarão juridicamente a conversão de livros físicos em conjuntos de treinamento.
O terceiro envolve preservação.
Bibliotecas, universidades e sebos podem começar a identificar determinados exemplares como patrimônio informacional antes de permitir que desapareçam em operações industriais de digitalização.
Por fim, existe uma disputa econômica maior em formação.
Se conteúdo humano comprovadamente anterior à era da IA continuar valorizando-se como matéria-prima de treinamento, livros que durante anos pareciam economicamente irrelevantes poderão adquirir um valor completamente novo.
Não porque alguém queira lê-los.
Mas porque máquinas precisam aprender com aquilo que seres humanos escreveram antes que máquinas começassem a escrever também.
👉 Dúvida? Então veja mais em: https://pixbugtech.com/linksuteis