noticias
Memória em IA não é banco vetorial: o que realmente faz um sistema lembrar, atualizar e recuperar informações
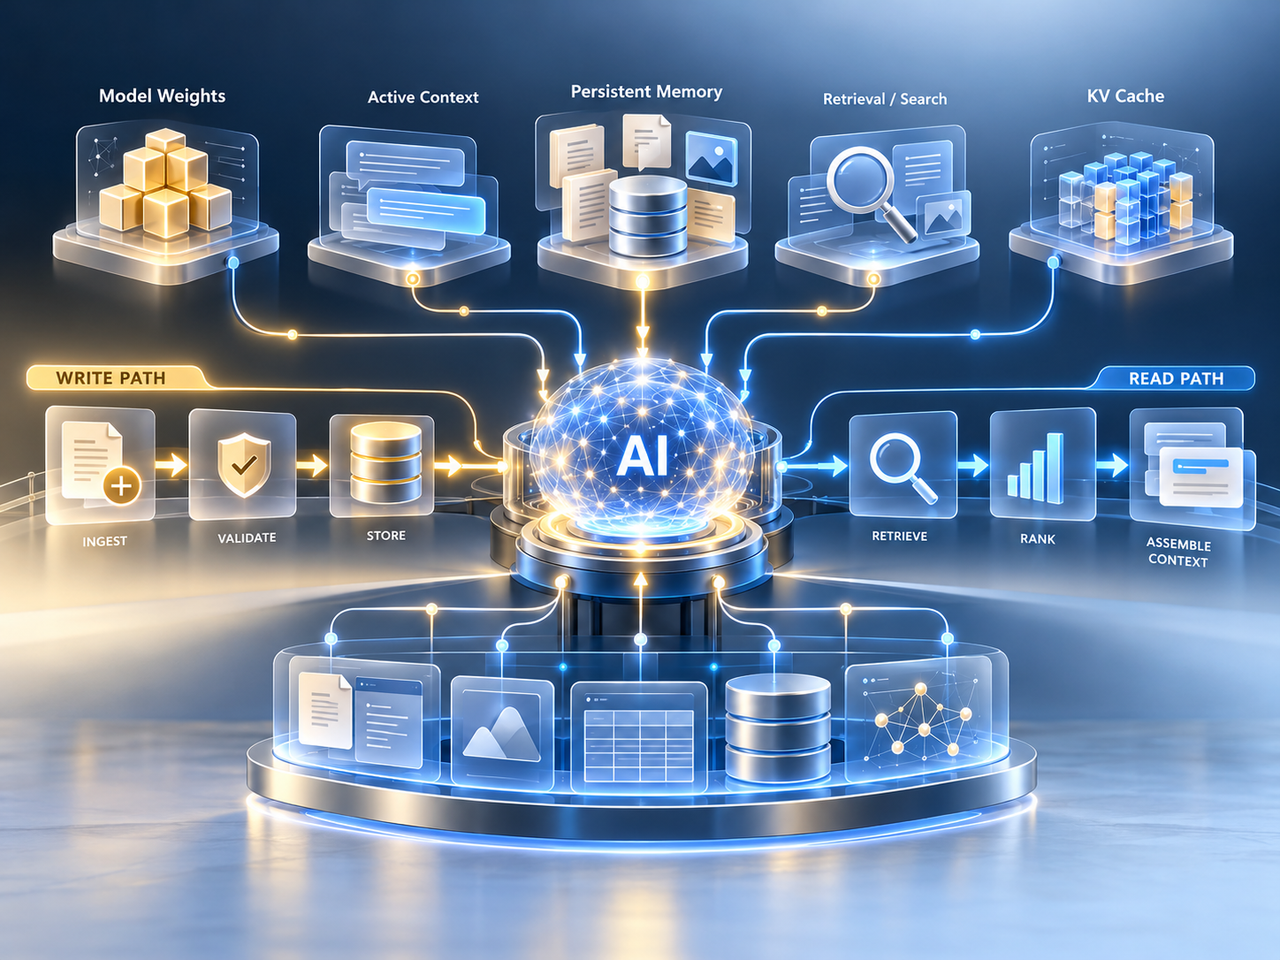
*Diagramas simplificados costumam tratar memória em IA como sinônimo de banco vetorial, mas a realidade é mais complexa. Um sistema de memória persistente depende de armazenamento, validação, atualização, contexto, autorização e avaliação contínua e isso está longe de ser apenas um problema de busca semântica.*
Falar em “memória” de modelos de linguagem virou hábito, mas também virou fonte de confusão. Em muitos debates sobre IA, a ideia aparece reduzida a uma fórmula simplista: guardar embeddings em um banco vetorial e recuperar trechos quando necessário. Essa arquitetura pode ser útil, mas está longe de representar, sozinha, um sistema de memória.
A confusão é compreensível. Bancos vetoriais se tornaram populares por funcionarem bem em tarefas de busca semântica, recomendação e recuperação de trechos relevantes para geração de respostas. O problema começa quando essa peça específica é tratada como se fosse a própria memória de um sistema.
Na prática, memória persistente envolve uma cadeia muito mais ampla de decisões. É preciso definir o que deve ser guardado, como validar a informação, como reconciliar conflitos, como atualizar registros sem apagar histórico importante, como recuperar o conteúdo correto no momento certo e, por fim, como disponibilizá-lo ao modelo dentro dos limites de contexto.
A diferença parece técnica, mas muda tudo. Uma aplicação pode recuperar textos semanticamente parecidos e ainda assim falhar em lembrar o que realmente importa, usar dados ultrapassados ou violar regras de acesso entre usuários.
Por isso, compreender memória em IA exige separar mecanismos diferentes que frequentemente são colocados no mesmo saco.
Nem toda “memória” em IA significa a mesma coisa
Quando alguém diz que um modelo “lembra” alguma coisa, essa lembrança pode estar em lugares completamente distintos.
O primeiro mecanismo são os **pesos do modelo**. Nesse caso, a informação está distribuída nos parâmetros aprendidos durante o treinamento. O modelo responde com base em padrões absorvidos anteriormente, mas a inferência comum não altera esses pesos. Ou seja: uma conversa normal com um chatbot não reescreve automaticamente o que o modelo aprendeu.
O segundo mecanismo é o **contexto ativo**. Aqui entram instruções do sistema, histórico recente da conversa, mensagens anteriores e dados recuperados externamente para aquela chamada. É a memória mais visível para o usuário, mas também a mais limitada, porque depende da janela de contexto.
O terceiro é a **memória persistente**, administrada pela aplicação. Esse é o componente que pode guardar preferências, fatos sobre o usuário, histórico relevante, anotações, decisões passadas ou registros de estado entre sessões.
Há ainda o **KV cache**, usado durante a inferência autoregressiva. Ele reaproveita chaves e valores de atenção já calculados para reduzir custo computacional. Isso melhora desempenho, mas não substitui armazenamento persistente nem resolve atualização de fatos.
Misturar esses mecanismos produz erros conceituais. Um modelo pode responder corretamente porque “sabe” algo pelos pesos, porque recebeu o dado no contexto, porque buscou esse dado em um repositório persistente ou porque está apenas reutilizando computações já feitas. São funções diferentes, com limites diferentes.
Um sistema de memória começa antes do armazenamento
Uma boa arquitetura de memória não começa na consulta. Ela começa na decisão de salvar.
O caminho de escrita pode ser resumido em uma sequência essencial: **extrair, validar, reconciliar e persistir**.
Extrair significa identificar, no fluxo de interação, quais informações têm valor durável. Nem toda mensagem merece virar memória. Preferências estáveis, decisões recorrentes, fatos de perfil, estados de processos e instruções reutilizáveis são candidatos melhores do que observações passageiras.
Validar é a etapa que impede que o sistema memorize ruído, ambiguidades ou inferências frágeis como se fossem fatos confiáveis. Se um usuário disser algo incerto, temporário ou contraditório, talvez aquilo não deva ser promovido automaticamente a memória persistente.
Depois vem a reconciliação. Esse é um dos pontos mais negligenciados. Quando uma nova informação entra em conflito com outra já registrada, o sistema precisa decidir o que fazer: atualizar? versionar? marcar como obsoleta? preservar o histórico e redefinir qual registro é o atual?
Sem isso, a memória vira um depósito de afirmações concorrentes, todas tratadas como igualmente válidas. O resultado é um assistente que “lembra” duas verdades incompatíveis ao mesmo tempo.
Só então faz sentido persistir o dado. E esse registro não pode ser apenas um texto solto. Ele frequentemente precisa de identidade, escopo, origem, timestamps, política de retenção e, em muitos casos, controle de versão.
Recuperar não é apenas buscar por similaridade
O caminho de leitura é igualmente mais complexo do que uma simples consulta vetorial. Uma arquitetura madura costuma seguir algo como: **autorizar, buscar, selecionar, montar contexto e gerar**.
Autorizar é o primeiro filtro. Um sistema multiusuário não pode tratar memória como um arquivo aberto em que qualquer item semanticamente próximo está disponível para qualquer consulta. O modelo só deve acessar o que pertence ao escopo correto.
Depois entra a fase de busca, que pode assumir várias formas. Dependendo do tipo de dado e do padrão de acesso, a recuperação pode usar SQL, busca por palavra-chave, similaridade vetorial, busca híbrida ou até travessia em grafo.
Essa escolha importa bastante. Dados estruturados, como preferências explícitas ou configurações de conta, muitas vezes funcionam melhor em bancos relacionais. Relações complexas entre entidades podem se beneficiar de grafos. Conteúdo textual amplo pode ganhar com busca vetorial ou híbrida.
Em seguida, o sistema precisa selecionar e ranquear resultados. Similaridade semântica sozinha não basta para garantir que o item recuperado é o mais correto, o mais recente ou o mais autorizado. Um registro semanticamente próximo pode estar desatualizado, fora de escopo ou ter sido superado por uma versão posterior.
Só depois disso vem a montagem de contexto. É aqui que a aplicação decide o que realmente será entregue ao modelo, em qual formato, com qual prioridade e com quanto espaço dentro da janela de contexto.
Finalmente, o modelo gera a resposta. E mesmo nessa etapa ainda pode haver falha: a informação certa foi recuperada, mas o modelo não a utilizou corretamente.
RAG e fine-tuning ajudam, mas não resolvem memória persistente
Dois conceitos aparecem com frequência nesse debate: RAG e fine-tuning. Ambos são importantes, mas nenhum resolve sozinho o problema da memória.
O **RAG** recupera informações externas para apoiar a geração. É extremamente útil para trazer documentos, fatos ou trechos relevantes ao contexto atual. No entanto, recuperar não é o mesmo que manter memória persistente com regras de atualização, reconciliação de conflitos e políticas de retenção.
Já o **fine-tuning** altera parâmetros do modelo. Pode melhorar estilo, adequação a tarefas específicas e comportamento em certos domínios. Mas também não oferece, por si só, um mecanismo apropriado para guardar fatos dinâmicos de usuários, atualizar preferências ou gerenciar histórico operacional.
Em resumo: RAG ajuda a buscar; fine-tuning ajuda a adaptar; memória persistente exige governança sobre o ciclo de vida da informação.
Por que assistentes “esquecem” mesmo quando a informação existe
Falhas de memória em sistemas de IA podem ocorrer em vários pontos da cadeia.
A informação pode nunca ter sido armazenada. Pode ter sido extraída, mas rejeitada na validação. Pode ter sido guardada, mas com metadados ruins. Pode ter sido recuperada de forma imprecisa. Pode ter sido superada por outra versão e ainda assim voltar como se fosse atual. Pode ter sido corretamente recuperada, mas deixada de fora na montagem do contexto. E pode, por fim, ter sido entregue ao modelo e ainda assim usada de forma errada na resposta.
Essa decomposição é importante porque muda a forma de depurar o sistema. Nem toda falha é “culpa do modelo”. Muitas estão na arquitetura da memória, no desenho da recuperação ou na lógica da aplicação.
Por isso, falar que um assistente “esqueceu” algo é apenas o começo da investigação, não a explicação.
Avaliar memória exige mais do que acurácia de busca
Um erro recorrente em projetos de IA é medir qualidade de memória apenas com precisão de recuperação. Isso é insuficiente.
Um sistema de memória robusto deve ser avaliado em vários eixos. Entre eles estão o recall factual, a capacidade de refletir atualizações, a ordenação temporal de eventos, a consistência entre sessões, o isolamento entre usuários, a preservação de origem e a capacidade de se abster quando as evidências são insuficientes.
Também é importante testar políticas de retenção. O sistema esquece o que deveria esquecer? Mantém o que precisa ser mantido? Promove ruído à categoria de memória estável? Apaga histórico relevante ao atualizar estados?
Esses critérios se tornam ainda mais importantes em aplicações corporativas, ambientes jurídicos, agentes pessoais e sistemas que lidam com identidade, preferências ou decisões operacionais.
Não basta recuperar algo parecido. É preciso recuperar a informação certa, mantê-la válida e entregá-la no momento em que ela realmente importa.
Análise da equipe PixBugTech
A obsessão recente com bancos vetoriais ajudou a popularizar a recuperação semântica, mas também simplificou demais o debate sobre memória em IA. Em muitos projetos, a arquitetura foi tratada como se o problema inteiro pudesse ser resolvido armazenando embeddings e buscando trechos parecidos.
Isso funciona para alguns casos. Não funciona para todos — e falha especialmente quando o sistema precisa lidar com atualização, identidade, conflito de versões, autorização e histórico confiável.
O ponto que quase ninguém discute o suficiente é que memória útil não é apenas “o que pode ser recuperado”. É o que foi corretamente selecionado para ser lembrado, preservado com contexto e entregue ao modelo em condições de ser usado com segurança.
Esse detalhe separa uma demo convincente de um sistema confiável.
Também é por isso que a próxima fase da IA aplicada dependerá menos do fascínio por uma técnica isolada e mais da engenharia de integração entre armazenamento, busca, estado, contexto e avaliação.
No fim, uma boa memória não é a que guarda tudo. É a que guarda o que importa, atualiza o que muda, protege o que é sensível e recupera o que precisa ser lembrado na hora certa.
O futuro da memória em IA será definido por governança, não só por recuperação
À medida que modelos de linguagem passam a integrar fluxos de trabalho reais, o papel da memória se torna mais delicado e mais estratégico.
Assistentes pessoais precisam manter preferências sem confundir fatos temporários com instruções permanentes. Agentes corporativos precisam respeitar escopos de acesso. Sistemas técnicos precisam versionar mudanças e manter rastreabilidade. Plataformas multiusuário precisam impedir vazamento de contexto entre sessões.
Tudo isso exige muito mais do que um repositório vetorial bem indexado.
A memória de IA do futuro será definida pela capacidade de combinar armazenamento, recuperação, validação, reconciliação e contexto sob regras claras de qualidade e governança.
Quem tratar memória apenas como busca semântica vai construir sistemas que parecem inteligentes nas primeiras respostas, mas fracassam quando a informação precisa ser estável, atual, auditável e confiável.
E é justamente aí que a diferença entre uma IA impressionante e uma IA realmente útil começa a aparecer.
👉 Dúvida? Então veja mais em: https://pixbugtech.com/linksuteis