noticias
Meta transforma atividade cerebral em texto sem implante, mas ainda está longe de “ler pensamentos”
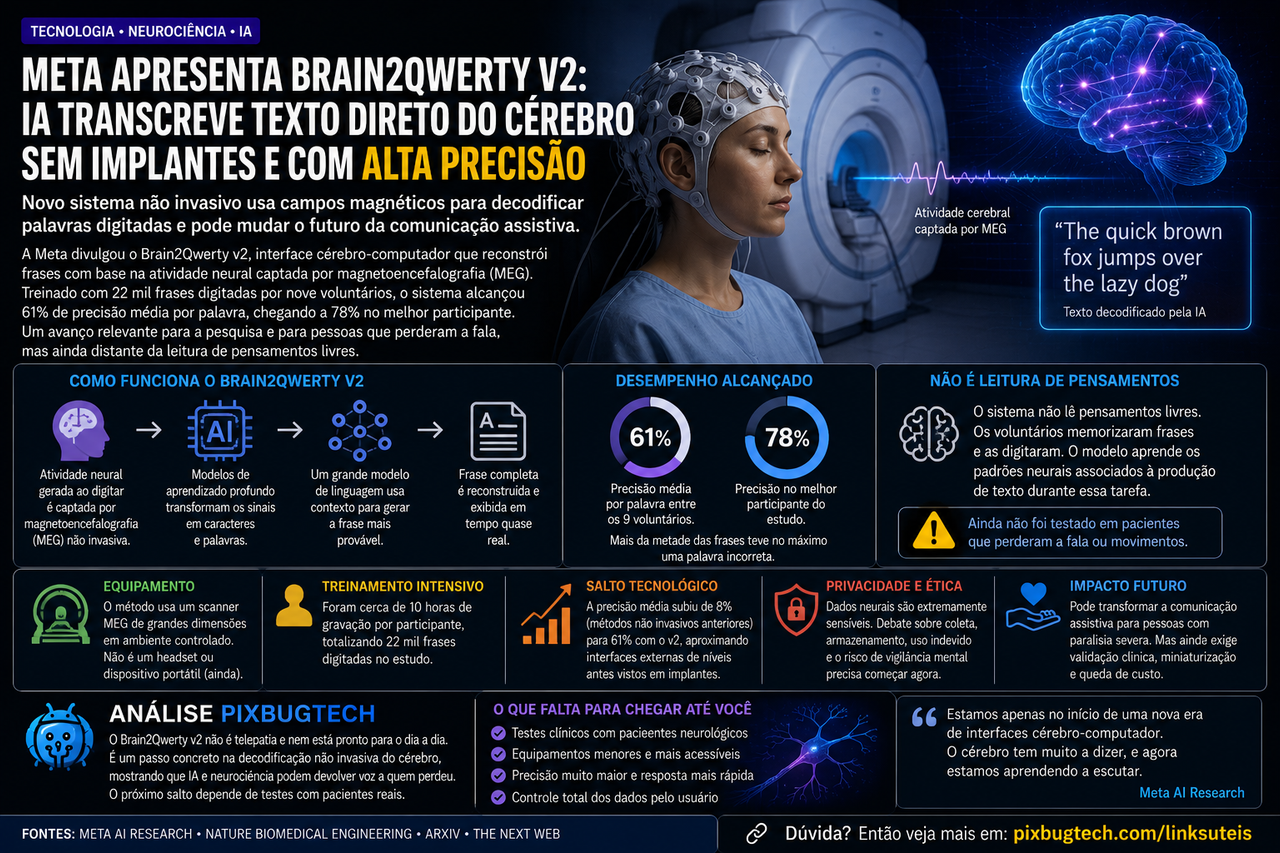
A Meta apresentou o Brain2Qwerty v2, uma interface cérebro-computador não invasiva capaz de reconstruir frases digitadas a partir da atividade cerebral registrada por magnetoencefalografia. O sistema alcançou precisão média de 61% por palavra e chegou a 78% no participante com melhor desempenho, resultados que aproximam métodos externos de níveis antes associados principalmente a implantes cerebrais. A demonstração é tecnicamente importante, especialmente para pesquisas destinadas a pessoas que perderam a capacidade de falar ou se movimentar. Mas a imagem popular de uma máquina silenciosamente vasculhando pensamentos continua distante: os voluntários estavam acordados, colaborando, dentro de um scanner de grandes dimensões e digitando frases conhecidas em um teclado.
A diferença entre esses dois cenários precisa ser preservada. O Brain2Qwerty não descobre ideias escondidas, opiniões privadas ou lembranças espontâneas. Ele identifica padrões neurais associados à produção organizada de texto durante uma tarefa motora específica. A inteligência artificial atua como decodificador probabilístico: recebe sinais cerebrais ruidosos, tenta associá-los a letras e palavras e utiliza contexto linguístico para reconstruir a sentença mais plausível. Isso continua sendo extraordinário, mas pertence ao campo das neuropróteses experimentais, não ao imaginário de uma Meta capaz de abrir a cabeça do usuário como se fosse uma caixa de entrada.
O que a Meta apresentou
O Brain2Qwerty v2 foi treinado com aproximadamente 22 mil frases digitadas por nove voluntários. Cada participante permaneceu cerca de dez horas usando um equipamento de magnetoencefalografia, conhecido pela sigla MEG, enquanto escrevia em um teclado. O scanner mede variações extremamente pequenas nos campos magnéticos produzidos pela atividade neural, sem implantes ou cirurgia. Os pesquisadores utilizaram aprendizado profundo para converter os sinais brutos em representações de caracteres, palavras e sentenças.
A precisão média divulgada foi de 61% das palavras, equivalente a uma taxa média de erro de 39%. No melhor participante, o sistema atingiu 78% de acerto, e mais da metade das frases apresentou no máximo uma palavra incorreta. Esses números são muito superiores aos 8% de precisão atribuídos pela Meta a métodos não invasivos anteriores, embora ainda estejam longe da confiabilidade necessária para uma conversa cotidiana.
O avanço também ocorreu em relação à primeira versão. O Brain2Qwerty v1 dependia do momento exato em que cada tecla era pressionada, o que tornava o método artificialmente alinhado à execução física da tarefa. A nova versão processa gravações contínuas de MEG e tenta gerar a sentença diretamente, sem receber a marcação temporal individual de cada tecla. A Meta descreve o sistema como uma interface de geração online e decodificação em tempo real, ainda que isso não deva ser confundido com um produto de comunicação instantânea pronto para uso clínico.
Não é exatamente uma máquina de leitura de pensamentos
O termo “brain-to-text” é correto dentro do contexto científico, mas pode produzir interpretações exageradas quando sai do laboratório. Os participantes não ficaram parados imaginando frases aleatórias. Eles receberam sentenças, memorizaram o conteúdo e depois as digitaram. O sistema aprendeu a relacionar a atividade cerebral produzida durante essa tarefa com o texto correspondente.
Isso significa que parte relevante do sinal pode estar associada ao planejamento e à execução dos movimentos necessários para digitar. A primeira pesquisa já indicava que o modelo dependia fortemente de processos motores, embora determinados padrões de erros também sugerissem participação de componentes linguísticos e cognitivos de nível mais elevado. Em outras palavras, o sistema não está apenas observando dedos mentalmente; também encontra sinais relacionados à organização da linguagem. Ainda assim, não há demonstração de que consiga transcrever pensamentos espontâneos sem uma tarefa estruturada.
Essa limitação cria uma contradição clínica importante. A tecnologia é apresentada como possível caminho para pessoas que perderam fala e movimento, mas foi treinada em indivíduos saudáveis realizando justamente aquilo que muitos pacientes não conseguem fazer: digitar. Transferir o método para pessoas com paralisia severa exigirá demonstrar que padrões semelhantes podem ser obtidos com movimento tentado, imaginado ou com outra forma de produção linguística que não dependa da execução física real.
A própria Meta reconhece que o sistema ainda não foi validado nos pacientes que pretende beneficiar. O resultado atual prova que sinais não invasivos podem carregar informação suficiente para reconstruir frases em condições controladas. Não prova que uma pessoa com esclerose lateral amiotrófica, lesão cerebral ou síndrome do encarceramento conseguirá utilizar a tecnologia com a mesma precisão.
Como a arquitetura funciona
O Brain2Qwerty v2 combina três níveis de interpretação. Primeiro, uma rede neural processa os sinais magnéticos e tenta localizar padrões associados à produção de caracteres. Depois, um módulo intermediário organiza esses sinais em representações relacionadas a palavras. Por fim, um grande modelo de linguagem utiliza contexto semântico para transformar uma sequência incerta em uma frase coerente.
Esse último estágio é responsável por boa parte do salto de qualidade, mas também exige cuidado na interpretação. O modelo de linguagem não “ouve” diretamente cada palavra dentro do cérebro. Ele recebe sinais incompletos e usa padrões da língua para inferir qual frase seria mais provável. O processo se parece, em parte, com o corretor de um celular: quando algumas letras estão ausentes ou erradas, o sistema tenta completar o restante com base no contexto.
A vantagem é evidente. Sinais neurais não invasivos são fracos, ruidosos e variam entre pessoas. Sem uma camada linguística, pequenas falhas na detecção de caracteres produziriam sequências praticamente ilegíveis. O modelo de linguagem consegue aproveitar relações entre palavras e estrutura gramatical para recuperar frases mais naturais.
O risco é que a frase final pareça mais certa do que os sinais realmente permitiam concluir. Quando um modelo reconstrói linguagem, ele pode trocar um termo raro por outro mais comum, alterar uma negação ou gerar uma sentença linguisticamente elegante, mas semanticamente incorreta. Em um experimento acadêmico, isso reduz a pontuação. Em uma futura interface de comunicação para pacientes, pode alterar a vontade expressada por uma pessoa.
O papel dos agentes de IA no próprio experimento
A Meta também utilizou agentes de inteligência artificial para explorar modificações no pipeline de treinamento. Esses agentes geraram e testaram mudanças no código, procurando configurações capazes de melhorar a decodificação. As escolhas finais, segundo a empresa, foram realizadas por engenheiros humanos.
Esse detalhe é relevante porque mostra a IA operando em duas camadas. Uma família de modelos tenta decodificar os sinais cerebrais, enquanto outros agentes ajudam os pesquisadores a construir uma versão melhor do próprio decodificador. A pesquisa científica passa a utilizar sistemas automatizados não apenas como instrumentos de análise, mas como participantes do processo de engenharia experimental.
O ganho pode acelerar testes e permitir a exploração de combinações que uma pequena equipe humana demoraria muito mais para avaliar. Entretanto, a automatização também aumenta a importância da documentação. Quando centenas de variações de código são sugeridas e executadas por agentes, os pesquisadores precisam preservar rastreabilidade suficiente para explicar por que determinada arquitetura foi escolhida e quais tentativas fracassaram.
O equipamento ainda ocupa uma sala
O Brain2Qwerty v2 não funciona com uma faixa discreta na cabeça, um óculos inteligente ou um headset semelhante aos produtos de realidade virtual. A pesquisa utiliza um equipamento MEG de grandes dimensões, instalado em ambiente controlado e protegido de interferências magnéticas. A própria Meta reconhece que a configuração atual é inacessível para a maioria dos pacientes e inadequada para uso doméstico.
A magnetoencefalografia oferece qualidade de sinal muito superior à eletroencefalografia tradicional. Na primeira versão do estudo, o MEG atingiu taxa média de erro de 29% por caractere, enquanto o EEG ficou em aproximadamente 65%. Essa diferença explica por que a evolução apresentada em 2026 se concentrou no equipamento mais sofisticado.
O problema é que o melhor sinal vem acompanhado do pior formato para adoção ampla. Um hospital pode possuir uma sala de MEG para diagnóstico e pesquisa, mas isso não cria automaticamente uma ferramenta de comunicação disponível durante todo o dia. Uma interface realmente assistiva precisa funcionar quando o paciente deseja conversar, pedir ajuda, trabalhar ou interagir com familiares — não apenas durante uma sessão agendada em um centro de pesquisa.
A Meta deposita parte de sua esperança em sensores magnéticos menores e vestíveis que vêm sendo desenvolvidos por outros grupos. Contudo, equipamentos compactos precisarão demonstrar que preservam qualidade suficiente para alimentar o modelo. Não basta miniaturizar o scanner; é necessário manter precisão, tolerância a movimento, calibração e estabilidade.
O que muda na prática
No curto prazo, o Brain2Qwerty v2 não muda a rotina de consumidores. Não haverá um aplicativo lendo mensagens mentais no celular, nem uma pulseira transformando pensamentos em posts. O impacto imediato está na pesquisa: o sistema demonstra que gravações cerebrais não invasivas, combinadas com grande volume de dados e modelos linguísticos, podem produzir textos mais coerentes do que se considerava possível há poucos anos.
Para a neurotecnologia, isso amplia o espaço entre duas abordagens. De um lado estão implantes que captam sinais diretamente do cérebro, oferecendo maior precisão, mas exigindo cirurgia e acompanhamento médico. Do outro estão equipamentos externos, mais seguros em princípio, porém tradicionalmente limitados pela baixa qualidade do sinal. O Brain2Qwerty reduz parte dessa distância, embora ainda não elimine a vantagem das interfaces invasivas.
O resultado também muda a maneira como laboratórios podem pensar sobre escala. Os pesquisadores observaram que a precisão melhorou de forma aproximadamente log-linear conforme o volume de dados aumentou, sem um platô evidente dentro do conjunto analisado. Isso sugere que mais horas de gravação podem continuar elevando o desempenho, embora não prove que apenas aumentar dados será suficiente para chegar à confiabilidade clínica.
Quem será impactado primeiro
Os primeiros beneficiados serão pesquisadores de neurociência, inteligência artificial, linguística computacional e tecnologias assistivas. A Meta disponibilizou o código de treinamento das duas versões, enquanto o Basque Center on Cognition, Brain and Language liberou os dados da primeira etapa. O conjunto da versão mais recente permanece sob embargo até uma publicação científica posterior.
Essa abertura permite que outros laboratórios reproduzam partes do trabalho, testem arquiteturas diferentes e identifiquem erros metodológicos. Em uma área tão sensível, replicação independente será essencial. Resultados obtidos com nove voluntários em um único ambiente não podem ser tratados como evidência universal sobre cérebros, idiomas e condições clínicas diferentes.
Empresas de neurotecnologia também acompanharão o projeto com atenção. O avanço aumenta a pressão para desenvolver sensores externos melhores e sistemas híbridos que combinem equipamento portátil, modelos personalizados e calibração contínua. O valor comercial, se a técnica amadurecer, não estará apenas no algoritmo, mas no conjunto formado por hardware, dados, treinamento individual e serviço clínico.
Pessoas com limitações severas de comunicação são o público que mais pode ganhar no longo prazo, mas paradoxalmente ainda são as que menos participaram da validação atual. Antes de falar em transformação de vidas, será necessário testar a tecnologia com pacientes reais, diferentes condições neurológicas e capacidades motoras reduzidas.
O que pode dar errado
O primeiro risco é o exagero público. Chamar o sistema de “leitor de pensamentos” cria medo desnecessário e expectativas falsas. A tecnologia exige cooperação, treinamento, um scanner especializado e uma tarefa bem definida. Ela não consegue apontar para uma pessoa na rua e extrair o conteúdo de sua mente.
O segundo risco é a dependência excessiva do modelo de linguagem. Quanto maior o peso do contexto estatístico na reconstrução, mais difícil fica separar aquilo que realmente apareceu no sinal cerebral daquilo que foi completado pela IA. Uma frase pode parecer perfeita porque o modelo conhece bem a língua, não porque decodificou cada elemento com segurança.
Isso se torna especialmente delicado em comunicação médica. Trocar “sim” por “não”, alterar um nome, modificar um pedido ou completar uma sentença de maneira errada pode ter consequências concretas. Sistemas futuros precisarão mostrar graus de confiança, permitir correção, confirmar mensagens críticas e conservar o registro entre o sinal original e o texto produzido.
O terceiro risco é a personalização. O Brain2Qwerty foi treinado com muitas horas de dados de cada participante. Cérebros não produzem sinais idênticos, e uma solução que exige dez horas de calibração em um scanner caro pode ter aplicação limitada. Pacientes cansados, crianças ou pessoas com condições neurológicas instáveis talvez não consigam oferecer o mesmo volume de treinamento.
O quarto risco está no movimento. Equipamentos de magnetoencefalografia são sensíveis ao posicionamento da cabeça e a interferências externas. Uma pessoa saudável consegue permanecer relativamente imóvel durante o experimento; um paciente pode apresentar espasmos, tremores ou dificuldade para manter postura. A passagem do laboratório para a clínica costuma fracassar exatamente nesses detalhes pouco cinematográficos.
Privacidade neural será uma discussão inevitável
Hoje, o Brain2Qwerty precisa de um ambiente altamente controlado, consentimento e treinamento individual. Isso reduz o risco imediato de vigilância mental secreta. Mesmo assim, o projeto antecipa uma discussão que crescerá conforme sensores cerebrais se tornarem menores: quem poderá coletar, armazenar e analisar dados neurais?
Atividade cerebral não é equivalente a uma senha ou conversa gravada, mas pode conter padrões relacionados a movimento, linguagem, atenção e condições neurológicas. Dados desse tipo podem revelar informações que o próprio usuário não sabe interpretar. A combinação entre sensores e modelos cada vez mais poderosos transforma esses registros em ativos sensíveis.
O problema não será apenas impedir que alguém “leia pensamentos”. Empresas poderão utilizar sinais para avaliar fadiga, engajamento, resposta emocional ou desempenho. Em ambientes de trabalho, escolas, seguros e saúde, até medições incompletas podem ser usadas para classificar pessoas. O risco aparece antes da tecnologia se tornar perfeita.
A Meta afirma desenvolver o Brain2Qwerty para pesquisa aberta e restauração da comunicação. Isso não elimina a necessidade de limites. A história da tecnologia mostra que ferramentas criadas para finalidades legítimas podem adquirir usos comerciais e institucionais diferentes quando hardware e custo tornam a adoção possível.
O que ninguém ainda está discutindo
A questão menos visível é que o sistema não decodifica apenas o cérebro; ele também impõe uma língua provável sobre o sinal. O modelo de linguagem precisa escolher entre várias frases plausíveis, e essa escolha carrega os padrões do material utilizado em seu treinamento. Expressões raras, nomes próprios, sotaques, idiomas menos representados e estruturas incomuns podem ser corrigidos para algo mais frequente.
Isso cria um problema de identidade. Uma interface de comunicação não deve apenas produzir frases gramaticais; precisa preservar a forma como aquela pessoa fala. Se o sistema transformar estilos individuais em linguagem padronizada, poderá restaurar comunicação e, ao mesmo tempo, apagar parte da personalidade do usuário.
Também existe uma tensão entre precisão e autonomia. Quanto mais o modelo linguístico intervém para melhorar a frase, maior pode ser a taxa de acerto aparente. Porém, a ferramenta corre o risco de se tornar coautora da mensagem. Em uma conversa comum, sugestões automáticas já alteram a maneira como escrevemos. Em uma neuroprótese, essa influência teria peso muito maior porque o usuário talvez não consiga corrigir facilmente o texto.
Outro ponto pouco discutido é quem controlará os modelos personalizados. Dez horas de sinais cerebrais associados a frases formam um conjunto de dados profundamente individual. Se a pessoa mudar de hospital, empresa ou equipamento, poderá levar consigo o modelo treinado? A calibração pertencerá ao paciente, à clínica ou ao fornecedor da tecnologia? O futuro das interfaces cerebrais também será uma disputa por portabilidade.
Análise PixBugTech
A leitura da PixBugTech é que o Brain2Qwerty v2 merece atenção justamente quando retiramos o exagero da manchete. Ele não lê pensamentos secretos, não funciona em qualquer pessoa e não cabe em um produto doméstico. Ainda assim, conseguiu reconstruir frases a partir de sinais magnéticos externos com uma precisão que parecia improvável para abordagens não invasivas.
O projeto mostra uma mudança importante na relação entre IA e neurociência. Durante muito tempo, o limite parecia estar no sensor: se a gravação cerebral fosse ruidosa, nenhum algoritmo conseguiria recuperar informação útil. Agora, modelos hierárquicos e sistemas linguísticos mostram que parte do ruído pode ser compensada por contexto. O avanço não torna o sensor perfeito; torna a interpretação mais inteligente.
Essa mesma força exige prudência. Um modelo capaz de completar sinais incompletos também consegue produzir frases que parecem confiáveis sem serem fiéis. No entretenimento digital, uma palavra errada é inconveniente. Em uma interface usada por alguém sem outra forma de comunicação, ela pode distorcer identidade, vontade e consentimento.
O caminho promissor não está em vender a fantasia de uma máquina telepática. Está em construir ferramentas assistivas que funcionem com transparência, confirmação e controle do usuário. Para isso, será necessário melhorar sensores, validar pacientes, reduzir calibração, medir confiança e impedir que o modelo de linguagem fale mais alto do que o cérebro que deveria representar.
Conclusão
O Brain2Qwerty v2 reconstruiu frases digitadas por nove voluntários a partir de gravações não invasivas de magnetoencefalografia. O sistema atingiu 61% de precisão média por palavra e 78% no melhor participante, utilizando aprendizado profundo, representações em diferentes níveis e um modelo de linguagem para transformar sinais ruidosos em sentenças coerentes.
O avanço é real, mas continua limitado a um ambiente de pesquisa, um scanner de grandes dimensões, participantes saudáveis e muitas horas de treinamento personalizado. A técnica ainda erra demais para o cotidiano e não foi demonstrada em pessoas completamente incapazes de digitar.
Portanto, a Meta não criou uma máquina que invade pensamentos. Criou um experimento que mostra como atividade cerebral produzida durante a digitação pode ser traduzida em texto com ajuda de IA. Essa diferença parece menos espetacular, mas aponta para algo muito mais útil: um futuro em que pessoas sem fala talvez consigam voltar a se comunicar sem passar por cirurgia cerebral.
A promessa é enorme. O equipamento, por enquanto, também.
👉 Dúvida? Então veja mais em: https://pixbugtech.com/linksuteis