noticias
Mistral e ChatGPT lideram ranking de privacidade em IA, mas políticas já mudaram
**Categoria editorial:** Inteligência Artificial / Privacidade e Segurança
Mistral e ChatGPT lideram ranking de privacidade em IA, mas políticas já mudaram
**Linha fina:** Estudo da Incogni compara treinamento, coleta, compartilhamento e transparência de plataformas de IA, mas uma leitura atualizada mostra por que rankings de privacidade envelhecem rapidamente.
**Meta description:** Ranking de privacidade em IA coloca Mistral e ChatGPT entre os melhores, mas mudanças recentes nas políticas expõem os limites da comparação.
**Slug:** `ranking-privacidade-ia-chatgpt-mistral`
Matéria completa
Perguntar qual inteligência artificial é “melhor para a privacidade” parece simples até o momento em que se tenta definir o que exatamente significa privacidade em um chatbot moderno. A conversa pode ser armazenada, usada para melhorar modelos, analisada por sistemas automáticos ou revisores humanos, associada a informações de conta, enviada a ferramentas conectadas e, dependendo do produto utilizado, submetida a regras completamente diferentes das aplicadas a clientes empresariais.
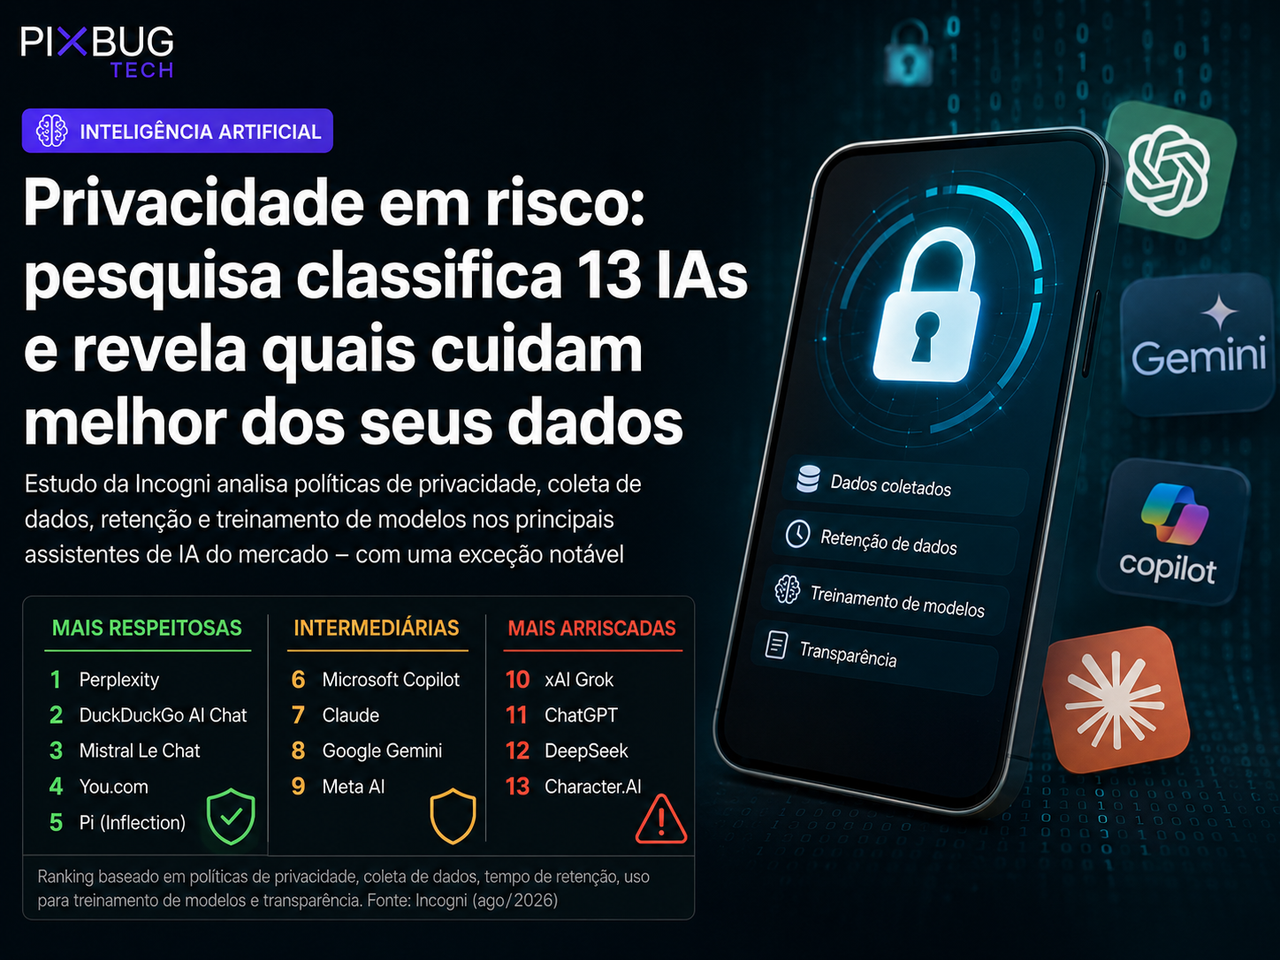
Um estudo da Incogni voltou a chamar atenção para esse problema ao comparar práticas de grandes plataformas de inteligência artificial. Na planilha pública atualmente disponibilizada pela organização, a solução da Mistral aparece com a menor pontuação de risco, seguida praticamente empatada pelo ChatGPT. Grok e Claude ficam no grupo seguinte, enquanto Microsoft Copilot, DeepSeek, Gemini e a plataforma da Meta aparecem na parte mais desfavorável da classificação.
O ranking é útil, mas precisa ser interpretado com cuidado. A reportagem que recolocou o estudo em circulação em agosto de 2026 fala em 13 plataformas analisadas, enquanto o conjunto público de dados ligado à metodologia da Incogni apresenta nove sistemas pontuados. Mais importante: a própria pesquisa registra que políticas poderiam mudar depois da coleta — e várias delas efetivamente mudaram.
A conclusão mais responsável, portanto, não é escolher um vencedor absoluto. É entender quais práticas fizeram algumas plataformas pontuarem melhor, onde estão os riscos reais e por que uma tabela de privacidade pode começar a envelhecer muito antes de um benchmark de desempenho.
O ranking mede muito mais do que o uso das conversas para treinamento
A Incogni estruturou sua comparação em 11 critérios distribuídos por três áreas principais: relação dos dados com o treinamento dos modelos, transparência das plataformas e coleta ou compartilhamento de informações pessoais.
A metodologia considera, por exemplo, se uma conversa pode ser usada para treinamento, se o usuário possui controle sobre isso, se os prompts podem chegar a entidades consideradas não essenciais para a prestação do serviço e quão claramente a empresa explica de onde vieram os dados usados para construir seus modelos.
Também entra na conta a facilidade para encontrar essas informações. Uma política tecnicamente completa, mas espalhada por dezenas de páginas, documentos jurídicos e centrais de suporte, recebe uma leitura diferente daquela em que o usuário consegue descobrir rapidamente o destino de seus dados.
Isso é relevante porque consentimento sem compreensão é um conceito bastante frágil.
Se uma pessoa precisa atravessar quinze páginas de juridiquês para descobrir se uma fotografia enviada ao chatbot pode ajudar a melhorar futuros modelos, a existência formal dessa informação não significa necessariamente que houve uma decisão realmente informada.
A pesquisa também examinou declarações de coleta de dados dos aplicativos para Android e iOS, fontes externas utilizadas pelas empresas para obter informações e categorias de dados pessoais que poderiam ser compartilhadas.
Não é, portanto, um simples teste de “quem treina com meus prompts”.
Mistral e ChatGPT ficaram praticamente empatados no conjunto público de dados
Na planilha pública da Incogni, quanto menor a pontuação final, mais favorável é a avaliação de privacidade.
O Le Chat, da Mistral, recebeu 9,8 pontos. O ChatGPT veio imediatamente depois, com 9,9. Grok aparece com 11,2, Claude com 11,7 e Pi.ai com 12,4.
Na parte inferior da classificação ficam Copilot, com 14,8, DeepSeek, com 15,0, Gemini, com 15,1, e Llama, associado à plataforma de inteligência artificial da Meta, com 15,7.
As diferenças não devem ser interpretadas como uma escala científica universal em que um serviço com 10 pontos seja objetivamente “duas vezes mais privado” que outro com 20. Os valores são resultado da metodologia criada pela Incogni, incluindo pesos definidos pelos pesquisadores para cada critério.
O mérito da comparação está menos no número isolado e mais nas razões que empurram uma plataforma para cima ou para baixo.
Empresas gigantes carregam um problema que chatbots independentes não têm
Uma das observações mais interessantes do estudo é que plataformas pertencentes a grandes ecossistemas digitais tendem a sofrer na categoria de transparência e coleta de dados.
Google, Microsoft e Meta não operam apenas chatbots.
Essas empresas mantêm mecanismos de busca, publicidade, sistemas operacionais, redes sociais, armazenamento em nuvem, suítes de produtividade, navegadores, serviços empresariais e uma longa lista de produtos conectados.
Quando a política de privacidade de uma inteligência artificial remete para documentos construídos para cobrir todo esse universo, torna-se mais difícil determinar qual informação é realmente utilizada pelo chatbot em questão.
Isso não significa automaticamente que uma empresa grande esteja usando todas as informações que poderia coletar em todos os seus produtos para treinar sua IA.
Significa que a fronteira se torna mais difícil de enxergar.
E, quando o assunto é privacidade, ambiguidade também é risco.
Transparência pode valer tanto quanto uma promessa de proteção
O ChatGPT teve desempenho particularmente forte na dimensão de transparência do estudo.
A razão é relativamente simples: a OpenAI disponibiliza controles específicos para decidir se novas conversas podem contribuir para o aprimoramento dos modelos e mantém documentação separada explicando esse funcionamento.
Atualmente, usuários de workspaces pessoais podem desativar a opção de melhorar o modelo com suas conversas. Existe ainda o Chat Temporário, que não utiliza aquelas conversas para treinamento e não as adiciona ao histórico normal, embora cópias possam ser mantidas temporariamente para finalidades de segurança.
Esse detalhe ilustra uma distinção frequentemente ignorada.
“Não usar para treinamento” não significa necessariamente “não processar”, “não armazenar” ou “apagar imediatamente”.
São perguntas diferentes.
Um provedor pode impedir que determinado conteúdo entre no treinamento de futuras versões do modelo e ainda precisar processá-lo para entregar a resposta, detectar abuso, manter registros temporários ou cumprir obrigações legais.
Privacidade em inteligência artificial é um conjunto de camadas, não um botão.
O problema do ranking é que as políticas continuam andando
A comparação pública da Incogni é identificada como ranking de 2025, e sua metodologia reconhece que documentos de privacidade poderiam ser atualizados depois do período de coleta.
Essa ressalva se tornou particularmente importante em 2026.
O Gemini, por exemplo, possui hoje controles que permitem desativar a opção de manter atividade. Segundo a documentação atual do Google, conversas futuras realizadas com essa configuração desligada não são utilizadas para treinar os modelos de IA da empresa, a menos que o usuário envie feedback. Elas ainda podem ser mantidas por um período limitado para fornecimento do serviço e proteção contra abuso.
O Google também oferece conversas momentâneas que não são utilizadas para treinamento.
Isso torna inadequado simplesmente repetir indefinidamente uma conclusão antiga de que o Gemini não permitiria impedir o uso de conversas para melhoria dos modelos.
A política mudou.
Claude também mudou sua relação com dados de usuários
A Anthropic é outro bom exemplo de como rankings desse tipo envelhecem.
A empresa atualizou suas regras para os produtos de consumo e atualmente informa que conversas e sessões de programação podem ser usadas para melhorar o Claude quando o usuário permite essa utilização.
Há exceções relacionadas a segurança, feedback e adesão explícita a programas específicos.
Nos produtos comerciais, a lógica é diferente. Entradas e saídas de clientes empresariais não são utilizadas por padrão para treinar os modelos.
Esse contraste é fundamental para qualquer empresa tentando escolher uma plataforma com base em uma matéria destinada ao consumidor comum.
Dizer simplesmente que “Claude usa dados” ou que “Claude não usa dados” perde informação demais no caminho.
A resposta depende do produto, do tipo de conta, das configurações e da finalidade do processamento.
O antigo Le Chat também mudou — inclusive de nome
A Mistral, líder da planilha publicada pela Incogni, também não está congelada no tempo.
A documentação atual da companhia já apresenta o antigo Le Chat sob a marca Vibe, uma plataforma que reúne recursos de produtividade, programação e conversa.
Usuários de determinados planos podem desativar a utilização de entradas e saídas para treinamento, enquanto planos Team e Enterprise ficam fora desse uso por padrão.
A empresa também oferece Zero Data Retention em situações específicas de sua API, fazendo outra distinção importante: impedir treinamento e impedir retenção são controles diferentes.
Essa diferença deveria estar em letras garrafais em qualquer discussão empresarial sobre IA.
Um sistema pode não aprender com os dados de uma companhia e ainda armazená-los durante algum período.
O plano utilizado importa tanto quanto a marca
Talvez esse seja o maior problema de rankings generalistas.
Duas pessoas podem dizer que usam ChatGPT e, na prática, operar sob regimes de dados bastante diferentes.
Uma delas pode estar em uma conta pessoal gratuita ou paga, com compartilhamento para melhoria dos modelos habilitado. Outra pode utilizar ChatGPT Business ou Enterprise, nos quais a OpenAI afirma não usar entradas e saídas para treinamento por padrão.
O mesmo princípio aparece em outras plataformas.
Produtos empresariais costumam oferecer contratos de processamento de dados, controles administrativos, retenção configurável, auditoria, autenticação corporativa e compromissos diferentes daqueles oferecidos em contas de consumo.
Isso significa que uma empresa não deveria escolher sua infraestrutura de IA olhando apenas para um ranking produzido a partir dos aplicativos utilizados pelo consumidor.
A unidade correta de comparação não é apenas “ChatGPT contra Claude contra Gemini”.
É produto contra produto, plano contra plano e configuração contra configuração.
Privacidade não é a mesma coisa que segurança
Outra cautela é essencial.
O estudo da Incogni avalia risco de privacidade a partir de políticas, declarações de coleta, treinamento, compartilhamento e transparência. Isso não equivale a uma auditoria técnica completa da segurança das plataformas.
Um serviço pode ter uma política de privacidade relativamente clara e ainda sofrer uma vulnerabilidade.
Outro pode possuir infraestrutura de segurança sofisticada, mas coletar mais informações do que o usuário considera aceitável.
Criptografia, controle de acesso, vulnerabilidades, isolamento entre contas, histórico de incidentes, resposta a ataques, armazenamento de credenciais e segurança das integrações pertencem a outra camada da análise.
Misturar os dois conceitos produz uma conclusão perigosa: acreditar que a plataforma mais bem posicionada em privacidade é automaticamente a mais segura contra invasões.
Não é isso que o ranking demonstra.
Memória tornou os chatbots mais úteis — e aumentou a superfície de dados
Os primeiros chatbots generativos pareciam sessões quase descartáveis. O usuário escrevia uma pergunta, recebia uma resposta e começava novamente.
Essa arquitetura está desaparecendo.
ChatGPT, Claude, Gemini, Mistral e concorrentes caminham para experiências persistentes, nas quais o assistente conhece preferências, projetos, arquivos e contexto acumulado.
É justamente essa memória que torna a inteligência artificial mais útil.
Também é ela que aumenta o valor e a sensibilidade dos dados armazenados.
Uma preferência musical isolada possui importância limitada. A combinação de profissão, projetos, documentos, contatos, histórico de decisões, localização, agenda e comunicações forma algo completamente diferente: um perfil operacional do usuário.
Quanto mais inteligente fica o assistente, mais contexto ele precisa.
Privacidade e personalização começam a puxar a mesma corda em direções opostas.
Conectores ampliam o problema para além da conversa
A próxima fronteira é ainda mais delicada.
Assistentes modernos conseguem se conectar a e-mails, calendários, documentos, repositórios de código, serviços empresariais e outras fontes externas.
Nesse momento, a pergunta “o que eu escrevi no prompt?” deixa de capturar todo o fluxo de dados.
O usuário pode escrever apenas “resuma o que aconteceu no projeto nesta semana”, enquanto o sistema consulta dezenas de mensagens, documentos e eventos para responder.
O prompt possui seis palavras.
O processamento pode envolver milhares de informações.
Por isso, políticas de privacidade para IA precisam evoluir de uma visão centrada na caixa de texto para uma visão baseada no fluxo completo: origem dos dados, permissões, processamento, armazenamento, retenção, terceiros envolvidos e destino das respostas.
Agentes tornam a análise ainda mais difícil
Com agentes capazes de executar tarefas, a cadeia fica maior.
Um chatbot convencional recebe informação e devolve informação. Um agente pode receber informação, consultar outro serviço, abrir uma página, executar código, preencher um formulário ou enviar dados para uma ferramenta externa.
Cada integração adiciona outra política de privacidade.
A plataforma de IA pode possuir controles excelentes sobre seus próprios servidores e, mesmo assim, entregar conteúdo a um terceiro porque o usuário autorizou determinada ação.
Isso cria um novo tipo de risco: a privacidade deixa de depender apenas do fornecedor do modelo e passa a depender da cadeia inteira de ferramentas envolvidas na tarefa.
É a versão digital daquela velha história da segurança de uma casa depender também da porta que alguém esqueceu aberta.
Para empresas brasileiras, a pergunta correta começa na LGPD
No Brasil, organizações que adotam IA precisam enquadrar esse debate dentro da Lei Geral de Proteção de Dados.
Antes de liberar ferramentas generativas para funcionários, a empresa deveria saber quais categorias de informações poderão entrar no sistema, qual é a finalidade do processamento, quais fornecedores terão acesso, em quais condições esses dados serão retidos e quais mecanismos existem para atender direitos dos titulares.
Isso se torna particularmente crítico em advocacia, saúde, finanças, recursos humanos, administração pública e setores que lidam diariamente com documentos confidenciais.
Uma conta empresarial que exclui conteúdo do treinamento reduz um risco importante.
Não resolve todos os outros.
Ainda precisam ser analisados controles de acesso, retenção, logs, transferência internacional, subprocessadores, conectores externos e a possibilidade de funcionários enviarem informações que nem deveriam estar naquela ferramenta.
Governança de IA não pode ser resumida a ensinar as pessoas a escrever bons prompts.
O maior vazamento pode começar pelo comportamento do próprio usuário
Há uma ironia desconfortável em toda essa discussão.
Empresas podem gastar milhões em segurança e compliance, enquanto um funcionário copia um contrato inteiro para uma conta pessoal de chatbot porque queria “só um resumo rápido”.
A tecnologia torna esse comportamento extremamente fácil.
Interfaces conversacionais diminuem a percepção de risco porque parecem privadas. A pessoa sente que está conversando com um assistente, não enviando informação para uma infraestrutura computacional externa sujeita a políticas, registros e sistemas de análise.
Essa diferença psicológica importa.
A caixa de conversa parece íntima.
Tecnicamente, continua sendo uma transferência de dados.
Qual IA é mais privada, então?
A resposta depende do que o usuário pretende fazer.
O ranking da Incogni oferece um retrato útil de como grandes plataformas se posicionavam sob uma metodologia comum, e a proximidade entre Mistral e ChatGPT no topo mostra que transparência e controles de usuário fazem diferença mensurável.
Mas transformar essa fotografia em uma verdade permanente seria um erro.
O Google alterou controles do Gemini. A Anthropic modificou regras para produtos de consumo. A Mistral mudou produto, marca e opções de governança. OpenAI mantém diferenças importantes entre contas pessoais e corporativas.
Em IA, a política de privacidade pode mudar mais rápido do que o artigo que explica a política.
Análise da equipe
O estudo da Incogni acerta ao tratar transparência como parte da própria privacidade.
Uma empresa que oferece controles sofisticados, mas torna quase impossível descobrir como utilizá-los, transfere ao usuário uma responsabilidade que deveria ser compartilhada pelo desenho do produto.
Ao mesmo tempo, rankings de marcas começam a perder precisão conforme os assistentes se tornam plataformas completas.
“ChatGPT”, “Claude”, “Gemini” ou “Vibe” já não descrevem uma única experiência de processamento de dados. Cada nome abriga planos, configurações, memórias, conectores, APIs, produtos empresariais e políticas distintas.
É por isso que a posição mais alta de um ranking não deveria funcionar como selo de aprovação.
O melhor critério para um usuário comum continua sendo bastante prático: evitar informações sensíveis desnecessárias, verificar se o uso para treinamento pode ser desativado, compreender o que acontece com o histórico e prestar atenção às integrações habilitadas.
Para empresas, a exigência precisa ser maior.
A escolha deve considerar contrato, finalidade, retenção, treinamento, localização e transferência dos dados, subprocessadores, auditoria, gestão de identidade, controles administrativos e consequências de uma eventual falha.
A pergunta realmente madura deixou de ser “qual chatbot respeita mais minha privacidade?”.
Ela passou a ser “qual fluxo de dados estou criando quando uso esta inteligência artificial?”.
Essa mudança de perspectiva importa porque o maior risco não está necessariamente dentro do modelo.
Pode estar antes dele, na informação que entrou; depois dele, no serviço para o qual ela foi enviada; ou ao redor dele, em uma cadeia de integrações que o usuário autorizou sem perceber a dimensão do acesso concedido.
Os próximos rankings serão mais úteis se conseguirem acompanhar essa transformação.
Comparar apenas chatbots já começa a parecer uma maneira antiga de medir um sistema que está rapidamente deixando de ser apenas um chatbot.
👉 Dúvida? Então veja mais em: https://pixbugtech.com/linksuteis