noticias
Modelos de IA de pesos abertos: por que a próxima disputa da inteligência artificial pode acontecer fora da nuvem
**Categoria editorial:** Inteligência Artificial
Modelos de IA de pesos abertos: por que a próxima disputa da inteligência artificial pode acontecer fora da nuvem
**Linha fina:** Ao permitir que empresas baixem, adaptem e executem modelos em infraestrutura própria, os pesos abertos desafiam a dependência das APIs e deslocam custos, controle e riscos para quem usa a tecnologia.
**Meta description:** Modelos de IA de pesos abertos ampliam controle, personalização e autonomia, mas transferem custos, segurança e infraestrutura para quem os executa.
**Slug:** `modelos-ia-pesos-abertos`
Matéria completa
Há uma mudança importante acontecendo no mercado de inteligência artificial que não envolve apenas quem possui o chatbot mais inteligente ou quem lidera determinado benchmark.
A disputa também está acontecendo em torno de algo menos visível ao usuário comum: **quem controla o próprio modelo depois que ele foi treinado**.
É nesse contexto que ganham importância os chamados **modelos de IA de pesos abertos**, ou *open-weight models*.
Em vez de disponibilizar exclusivamente uma interface na internet ou cobrar pelo uso de uma API, o desenvolvedor pode publicar os parâmetros treinados de uma rede neural, permitindo que terceiros baixem o modelo e o executem em sua própria infraestrutura.
Isso muda profundamente a relação entre quem cria a inteligência artificial e quem depende dela.
O que são os pesos de uma inteligência artificial
Para entender a discussão, primeiro é preciso separar modelo, código e pesos.
Durante o treinamento de uma rede neural, bilhões — e em alguns casos centenas de bilhões — de parâmetros numéricos são ajustados repetidamente.
Esses valores são os **pesos**.
Eles determinam, de maneira extremamente simplificada, como diferentes sinais recebidos pela rede influenciam o resultado produzido pelo modelo.
Quando alguém conversa com um grande modelo de linguagem, portanto, a resposta não está sendo recuperada de uma gigantesca coleção de frases previamente armazenadas.
O sistema realiza uma sequência de operações matemáticas utilizando sua arquitetura e os parâmetros aprendidos durante o treinamento para calcular quais tokens devem aparecer em seguida.
Os pesos carregam boa parte do comportamento aprendido pelo modelo.
Liberá-los significa entregar um componente essencial da IA já treinada.
Mas isso não significa, por si só, revelar tudo o que aconteceu para que aquele modelo existisse.
Pesos abertos não significam necessariamente código aberto
Aqui aparece uma confusão recorrente no mercado.
Um modelo de **pesos abertos não é automaticamente uma IA open source**.
A Open Source Initiative, organização responsável por uma das referências mais utilizadas para definir software aberto, estabeleceu na Open Source AI Definition 1.0 que uma IA verdadeiramente aberta precisa oferecer condições para que terceiros possam usar, estudar, modificar e compartilhar o sistema.
Isso envolve não apenas parâmetros, mas também código e informações suficientemente detalhadas sobre o processo e os dados utilizados no treinamento.
Um laboratório pode, portanto, liberar os arquivos contendo os pesos e continuar mantendo em segredo grande parte do conjunto de dados utilizado para treinamento, processos de filtragem, infraestrutura, técnicas internas ou determinados componentes do pipeline.
Por isso, chamar automaticamente qualquer modelo com pesos disponíveis de “open source” pode esconder diferenças importantes de licença e transparência.
No mercado de IA, a palavra **aberto** possui vários graus.
A grande diferença: a IA pode sair da infraestrutura do fabricante
Nos serviços proprietários tradicionais, normalmente existe uma relação bastante simples.
O usuário envia uma solicitação.
Ela é processada pela infraestrutura da empresa que controla o modelo.
A empresa devolve a resposta.
Com pesos abertos, essa arquitetura pode mudar completamente.
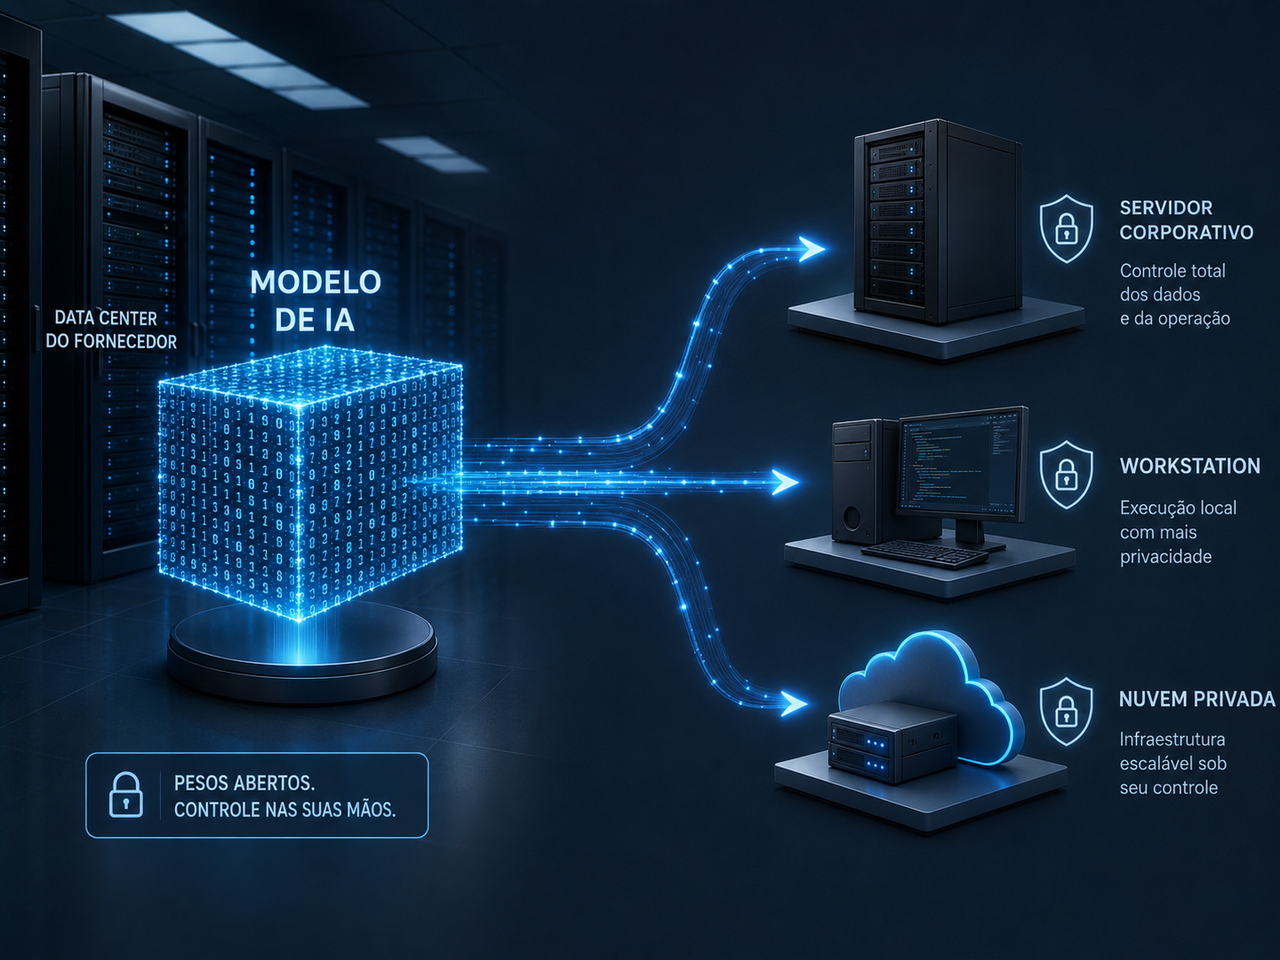
Uma organização pode baixar o modelo e executá-lo em GPUs próprias, servidores internos, data centers contratados ou uma nuvem privada.
Os dados enviados ao modelo, nesse cenário, não precisam necessariamente passar pela infraestrutura original de quem desenvolveu a IA.
Essa possibilidade é especialmente relevante para empresas que trabalham com documentos estratégicos, propriedade intelectual, dados financeiros, informações industriais ou outros conteúdos cuja circulação precisa ser rigidamente controlada.
Também existe uma questão de continuidade operacional.
Se uma empresa constrói um sistema inteiro sobre uma API proprietária, mudanças de preço, limites de utilização, políticas comerciais ou até a descontinuação de um modelo podem afetar diretamente sua operação.
Com pesos disponíveis localmente, parte dessa dependência pode ser reduzida.
Mas executar uma IA localmente não é sinônimo de executá-la de graça
É justamente aqui que o discurso sobre “IA gratuita” costuma desmoronar.
Baixar um modelo pode não custar nada.
**Executá-lo custa.**
GPUs, memória RAM, armazenamento, energia elétrica, refrigeração, rede, monitoramento, manutenção e profissionais especializados continuam existindo.
Modelos muito grandes podem exigir infraestrutura de nível de data center.
Modelos menores, especialmente quando quantizados, conseguem funcionar em workstations e até computadores pessoais mais potentes.
O próprio gpt-oss ilustra bem essa diferença.
A OpenAI disponibiliza os modelos gpt-oss-120b e gpt-oss-20b sob licença Apache 2.0 e afirma que o primeiro pode operar dentro de aproximadamente 80 GB de memória, enquanto o segundo foi projetado para funcionar com cerca de 16 GB, dependendo da implementação utilizada.
Essa diferença transforma completamente o perfil de infraestrutura necessário.
Um modelo que cabe em uma workstation pode ser economicamente interessante para determinadas aplicações.
Um sistema que exige várias GPUs de data center entra em outra categoria de investimento.
A conta muda de API para infraestrutura
Essa é uma das consequências econômicas mais interessantes dos pesos abertos.
No modelo tradicional de API, o custo tende a acompanhar o uso.
Mais tokens processados significam maior despesa.
Com um modelo próprio, boa parte desse custo passa a ser formada por infraestrutura fixa e operação.
Imagine uma empresa que executa milhões de inferências semelhantes todos os meses.
Dependendo do modelo, do hardware, da utilização das GPUs e do preço da energia, comprar ou alugar infraestrutura própria pode se tornar competitivo.
Para uma empresa que utiliza IA ocasionalmente, a situação pode ser exatamente o contrário.
Manter servidores caros ociosos não faz sentido quando uma API consegue entregar o mesmo serviço sob demanda.
Portanto, o debate não deveria ser simplesmente **“aberto é mais barato”**.
A pergunta correta é:
**em qual escala o custo marginal da API ultrapassa o custo total de possuir e operar a infraestrutura?**
Cada empresa terá uma resposta diferente.
Personalização é talvez a maior vantagem
Rodar um modelo próprio também possibilita algo importante: modificá-lo.
Modelos de pesos abertos podem, dependendo da licença, receber ajustes finos para determinados setores, estilos de resposta ou tarefas.
Uma empresa jurídica poderia especializar um modelo em classificação documental.
Uma indústria poderia utilizá-lo para interpretar documentação técnica interna.
Uma companhia de software poderia criar modelos especializados em determinadas linguagens ou bases de código.
Existem ainda técnicas como LoRA e outros métodos de adaptação eficiente que permitem modificar parte do comportamento do modelo sem repetir todo o treinamento original.
Isso cria um ecossistema diferente daquele dos grandes chatbots generalistas.
Em vez de apenas buscar uma inteligência artificial gigantesca capaz de fazer tudo razoavelmente bem, organizações podem construir modelos menores extremamente especializados.
E existe outra estratégia: não alterar o modelo
Também é importante não confundir personalização com treinamento.
Muitas aplicações corporativas sequer precisam modificar os pesos.
Um modelo aberto pode funcionar junto a sistemas de **RAG — Retrieval-Augmented Generation**, em que documentos internos são recuperados por mecanismos de busca e fornecidos ao modelo no momento da pergunta.
Nesse caso, o conhecimento corporativo permanece em uma base externa.
O modelo recebe apenas o contexto necessário para responder.
Essa arquitetura costuma ser mais simples de atualizar porque alterar um documento na base de conhecimento não exige treinar novamente a inteligência artificial.
Pesos abertos, RAG, agentes e bancos vetoriais podem, portanto, fazer parte de uma mesma arquitetura.
O movimento também está alterando a competição global
A abertura de modelos deixou de ser apenas uma discussão ideológica da comunidade de software.
Ela se tornou estratégia empresarial.
Laboratórios chineses vêm utilizando amplamente modelos disponíveis para download como mecanismo de expansão internacional.
Famílias como Qwen e DeepSeek ajudaram a criar um enorme ecossistema de ferramentas, adaptações e serviços construídos por terceiros.
Um levantamento publicado pelo Hugging Face sobre o mercado de modelos no primeiro semestre de 2026 identificou forte presença de licenças permissivas entre grandes lançamentos chineses, embora também tenha observado sinais recentes de licenças mais restritivas em alguns modelos de grande escala.
A consequência estratégica é poderosa.
Uma empresa não precisa conquistar diretamente milhões de consumidores.
Ela pode conquistar **desenvolvedores**.
Depois que milhares de produtos, bibliotecas, sistemas corporativos e aplicações começam a depender de determinado modelo, forma-se um ecossistema em torno dele.
Foi uma estratégia extremamente importante na história do software.
Agora ela começa a aparecer na infraestrutura da inteligência artificial.
Até a OpenAI entrou novamente nesse mercado
Talvez um dos sinais mais claros de que a disputa mudou seja a própria OpenAI.
Embora sua principal linha de produtos continue baseada em serviços proprietários, a empresa lançou em agosto de 2025 os modelos gpt-oss-120b e gpt-oss-20b.
Os pesos podem ser baixados e executados em infraestrutura controlada pelo usuário, e os modelos são distribuídos sob licença Apache 2.0.
É uma mudança relevante porque demonstra que modelos proprietários e modelos de pesos abertos não precisam ser estratégias mutuamente excludentes.
Um mesmo laboratório pode manter seus modelos mais avançados como serviço enquanto utiliza outros modelos para disputar desenvolvedores, infraestrutura local e aplicações especializadas.
A batalha deixa de ser apenas pelo chatbot.
Passa a ser também pela plataforma sobre a qual outras empresas construirão seus próprios produtos.
Privacidade melhora, mas não acontece automaticamente
Existe outro argumento frequentemente associado aos modelos locais: privacidade.
Ele é verdadeiro — com ressalvas importantes.
Executar um modelo dentro da própria infraestrutura pode impedir que prompts e documentos sejam enviados para servidores externos.
Isso reduz um vetor importante de exposição.
Mas simplesmente instalar uma IA local não transforma automaticamente um ambiente em seguro.
O servidor continua precisando de controle de acesso, autenticação, criptografia, monitoramento, isolamento de rede, atualização de bibliotecas e proteção contra vulnerabilidades.
Modelos também podem ser manipulados por ataques como *prompt injection*, especialmente quando estão conectados a ferramentas, bancos de dados e agentes capazes de executar ações.
A arquitetura pode ser privada.
A operação ainda precisa ser segura.
O problema que quase ninguém discute: agora você é o fornecedor
Quando uma empresa contrata uma API, boa parte da complexidade operacional fica escondida.
O fornecedor atualiza o modelo.
Mantém os servidores.
Corrige vulnerabilidades.
Administra capacidade.
Monitora abusos.
Substitui hardware.
Quando uma organização decide operar seu próprio modelo, parte dessas responsabilidades muda de lado.
Isso significa acompanhar versões, dependências, drivers CUDA ou equivalentes, runtimes de inferência, vulnerabilidades em bibliotecas e compatibilidade de hardware.
Também significa decidir quando atualizar o modelo.
Uma atualização pode melhorar desempenho em determinadas tarefas e piorar outras.
Empresas maduras precisarão tratar modelos de IA como qualquer outro componente crítico de infraestrutura: com testes, versionamento, ambientes de homologação, métricas e possibilidade de rollback.
É uma mudança cultural importante.
Existe ainda um problema de segurança sem botão de desligar
Modelos abertos também apresentam um dilema específico.
Depois que os pesos foram publicados e distribuídos, o desenvolvedor original não consegue simplesmente recolhê-los.
A própria OpenAI reconhece esse perfil de risco ao discutir seus modelos gpt-oss: usuários determinados podem realizar novos ajustes no modelo e remover determinadas salvaguardas, sem que o fornecedor consiga posteriormente revogar aquele arquivo já distribuído.
Essa característica é simultaneamente uma força e uma fraqueza.
Ela impede que uma empresa controle permanentemente o que terceiros fazem com aquela tecnologia.
Mas também dificulta responder a usos maliciosos depois da publicação.
É um debate que continuará acompanhando qualquer tentativa de equilibrar abertura e segurança.
Quem ganha com os modelos de pesos abertos
Os primeiros beneficiados provavelmente serão empresas com equipes técnicas maduras e workloads suficientemente grandes para justificar infraestrutura própria.
Cloud providers também podem ganhar.
Parece contraditório, mas não é.
Uma empresa pode abandonar a API oficial de determinado laboratório e continuar pagando para executar os pesos daquele modelo dentro de AWS, Azure, Google Cloud ou outro provedor.
Fabricantes de GPUs e aceleradores também entram naturalmente nessa cadeia.
Quanto maior a variedade de modelos executados diretamente pelos clientes, maior a demanda potencial por capacidade computacional.
Existe ainda um enorme mercado para empresas responsáveis por instalação, ajuste, observabilidade, segurança, otimização e hospedagem desses modelos.
O software pode ser aberto.
A infraestrutura continua sendo negócio.
Quem pode ficar para trás
Pequenas empresas sem conhecimento técnico podem descobrir rapidamente que possuir um modelo significa possuir também os problemas associados a ele.
A facilidade de abrir um aplicativo e conversar com uma IA esconde uma infraestrutura gigantesca.
Executar a própria inteligência artificial elimina parte dessa abstração.
Será preciso escolher modelos, calcular memória, dimensionar throughput, controlar versões e entender licenças.
Isso cria uma oportunidade para plataformas que consigam tornar modelos abertos tão simples de utilizar quanto APIs proprietárias.
Quem resolver essa camada operacional poderá capturar uma parte considerável do valor criado pela abertura dos pesos.
Análise da equipe
A discussão sobre pesos abertos costuma ser apresentada como uma batalha entre “IA livre” e “IA fechada”.
Essa interpretação é limitada.
O que está realmente mudando é **a distribuição de poder dentro da cadeia tecnológica**.
Nas plataformas proprietárias, quem controla o modelo também controla infraestrutura, preços, disponibilidade e grande parte das regras de utilização.
Pesos abertos separam algumas dessas funções.
O laboratório continua criando o modelo, mas outra empresa pode hospedá-lo.
Uma terceira pode modificá-lo.
Outra pode construir aplicações sobre ele.
E o cliente pode decidir onde seus dados serão processados.
Essa fragmentação provavelmente será uma das forças mais importantes do mercado de IA nos próximos anos.
Mas autonomia não elimina custos.
Ela os transfere.
Sai a dependência absoluta do fornecedor e entram gastos com infraestrutura, engenharia, segurança, observabilidade e manutenção.
O verdadeiro avanço não está em declarar vencedores entre modelos abertos e fechados.
Está em permitir que empresas escolham qual arquitetura faz sentido para cada problema.
A próxima guerra da IA pode ser pela infraestrutura
Durante os primeiros anos da corrida dos grandes modelos de linguagem, quase toda a atenção ficou concentrada em capacidade.
Quem escreve melhor?
Quem programa melhor?
Quem possui o maior contexto?
Quem lidera os benchmarks?
Essa competição continuará.
Mas existe uma segunda disputa crescendo silenciosamente.
Ela envolve **onde o modelo será executado, quem controlará seus parâmetros, qual empresa fornecerá o hardware, quem hospedará a inferência e quais aplicações serão construídas sobre ele**.
É uma disputa muito parecida com outras que moldaram a indústria de tecnologia.
Windows contra Linux.
Software proprietário contra software aberto.
Servidores próprios contra computação em nuvem.
A diferença é que agora não estamos falando apenas de sistemas operacionais ou bancos de dados.
Estamos falando da camada que poderá intermediar uma parcela crescente do trabalho intelectual realizado por pessoas e empresas.
Nesse cenário, os pesos de uma rede neural deixam de ser apenas um enorme conjunto de números.
Eles passam a representar uma pergunta bastante concreta sobre o futuro da tecnologia:
**quem realmente controla a inteligência artificial que sua empresa utiliza?**
Essa provavelmente será uma das perguntas mais importantes da próxima fase da corrida da IA.
👉 Dúvida? Então veja mais em: https://pixbugtech.com/linksuteis