noticias
O recurso já não se limita a preferências isoladas: pode recuperar contexto de conversas, arquivos e fontes conectadas, tornando o ChatGPT mais útil e mais dependente de bons controles de dados.
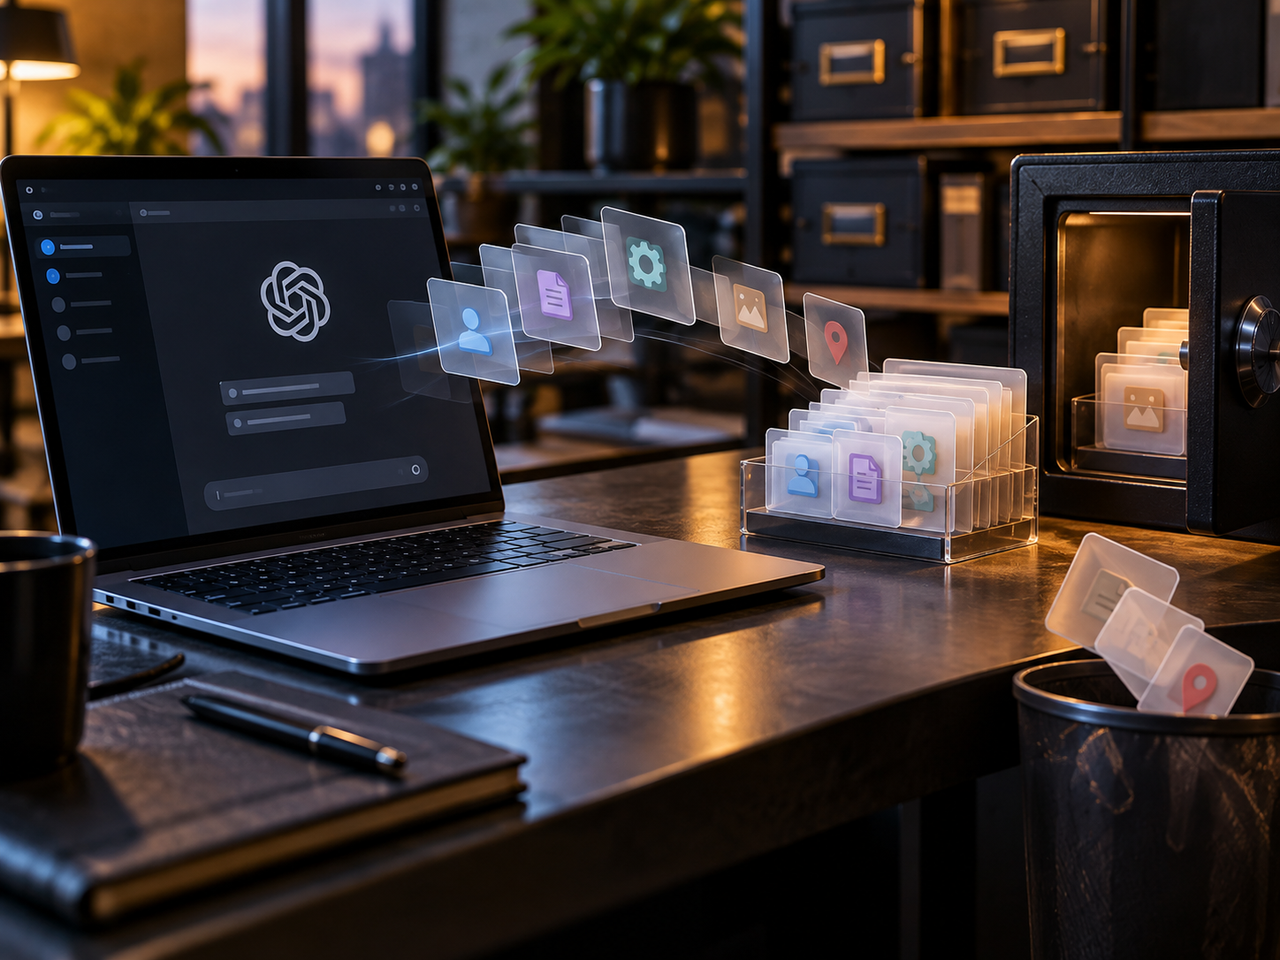
Memória do ChatGPT ficou mais ampla e entender o que ele lembra virou questão de privacidade
**O recurso já não se limita a preferências isoladas: pode recuperar contexto de conversas, arquivos e fontes conectadas, tornando o ChatGPT mais útil e mais dependente de bons controles de dados.**
Você explica ao ChatGPT como prefere um texto, conta em que projeto está trabalhando e encerra a conversa. Dias depois, abre outro chat e percebe que parte daquele contexto continua presente. Não é impressão: a memória do ChatGPT existe justamente para reduzir a necessidade de reconstruir sua vida digital a cada nova janela de conversa.
O recurso, porém, tornou-se mais sofisticado do que simplesmente guardar frases como “prefiro respostas curtas” ou “sou vegetariano”. A experiência atual pode considerar informações relevantes provenientes de conversas anteriores e, dependendo da conta, arquivos, instruções personalizadas e aplicativos conectados. Isso transforma a memória em uma das peças mais importantes da personalização do ChatGPT — e também em uma área que merece atenção especial quando o assunto é privacidade.
A memória não é uma gravação infinita das conversas
A primeira coisa a entender é o que a memória do ChatGPT não é.
Ela não funciona como uma transcrição gigantesca que o modelo relê integralmente antes de responder. A própria OpenAI informa que nem todo detalhe de todas as conversas é retido ou usado. O sistema procura aproveitar informações consideradas relevantes para uma interação futura e essa seleção pode mudar conforme o contexto do usuário também muda.
A versão mais recente da experiência trabalha com um resumo de memória que pode ser atualizado ao longo do uso. Em vez de depender apenas de uma lista estática de fatos isolados, o sistema tenta manter uma representação mais atual do contexto útil daquele usuário.
Isso permite, por exemplo, perceber que uma preferência antiga deixou de ser relevante ou que determinado projeto passou a ocupar um papel mais importante nas conversas recentes.
Há uma consequência curiosa: perguntar “o que você lembra sobre mim?” é útil, mas a resposta não deve ser interpretada necessariamente como uma auditoria completa. O próprio resumo disponibilizado nas configurações é descrito pela OpenAI como uma visão de alto nível e pode não mostrar todos os detalhes ou fontes que influenciam a personalização.
O que o ChatGPT pode usar como memória
A resposta depende do plano, da região e das configurações disponíveis para cada conta.
Conversas anteriores continuam sendo a fonte mais óbvia. Informações recorrentes sobre trabalho, preferências, projetos e forma de comunicação podem ser aproveitadas para tornar novas respostas mais adequadas ao usuário.
Mas o sistema pode ir além. Instruções personalizadas também ajudam a definir o comportamento esperado do assistente. Arquivos mantidos na Biblioteca podem fornecer contexto e aplicativos conectados, como serviços de produtividade, podem participar dessa personalização quando os recursos correspondentes estiverem disponíveis e autorizados.
Isso muda bastante a ideia tradicional de “memória”.
Imagine alguém que utiliza o ChatGPT durante meses para desenvolver um software. Em vez de precisar explicar repetidamente a arquitetura do projeto, as tecnologias usadas e as decisões já tomadas, parte desse contexto pode continuar útil em conversas posteriores. A produtividade aumenta justamente porque o usuário deixa de começar sempre do zero.
O mesmo mecanismo, entretanto, significa que informações compartilhadas casualmente podem permanecer relevantes por mais tempo do que a pessoa imaginava.
Memória e histórico não são exatamente a mesma coisa
Essa diferença costuma confundir usuários.
O histórico é o conjunto de conversas armazenadas na conta. A memória é o mecanismo que permite aproveitar determinados elementos dessas conversas para personalizar respostas futuras.
Excluir ou desativar uma coisa não significa necessariamente eliminar a outra.
Desativar a memória, por exemplo, não apaga automaticamente os chats já existentes. Se o recurso for reativado posteriormente, conversas que continuam disponíveis na conta podem voltar a servir de fonte para novas informações memorizadas, conforme as configurações permitirem.
Da mesma forma, eliminar apenas uma conversa pode não remover uma informação que tenha sido registrada separadamente como memória.
Para quem realmente quer remover determinado dado do contexto utilizado pelo sistema, a tarefa pode exigir olhar também para a origem da informação: conversa, memória, arquivo ou aplicativo conectado.
Esse é um daqueles detalhes pouco empolgantes que fazem toda diferença na prática.
O ChatGPT não está sendo “retreinado em você”
Outra confusão comum mistura personalização com treinamento de inteligência artificial.
Quando o ChatGPT lembra que você trabalha em determinado projeto ou prefere determinado formato de resposta, isso não significa que uma versão exclusiva do modelo esteja sendo treinada novamente para aquela pessoa.
A memória funciona como contexto adicional utilizado para tornar a resposta mais adequada. O modelo continua sendo o modelo oferecido pelo serviço; o que muda é o conjunto de informações relevantes disponibilizadas para aquela interação.
Treinamento é outra questão.
Em contas pessoais, a OpenAI possui um controle chamado “Melhorar o modelo para todos”. Quando ele está ativado, conversas e determinadas informações podem ser usadas para aprimorar os modelos da empresa. O usuário pode desativar essa opção nos controles de dados sem necessariamente abandonar o histórico normal de conversas.
Memória e treinamento, portanto, são escolhas relacionadas a dados, mas não são a mesma função.
Aplicativos conectados tornam a fronteira mais interessante
A evolução mais importante talvez esteja acontecendo fora do próprio histórico de chats.
O ChatGPT pode trabalhar com serviços conectados, arquivos e outras fontes de informação. Em determinadas configurações, dados elegíveis dessas fontes podem ajudar a personalizar respostas futuras.
É uma mudança significativa porque o assistente deixa de conhecer apenas aquilo que foi digitado diretamente na caixa de conversa.
Um usuário que conecta ferramentas externas pode criar um ambiente muito mais contextual: projetos, arquivos e informações profissionais passam a estar disponíveis quando realmente ajudam a responder uma pergunta.
A conveniência é evidente. O custo é que a relação entre informação armazenada, informação consultada e informação memorizada fica menos intuitiva.
A OpenAI afirma que dados acessados diretamente de aplicativos Google conectados possuem regras próprias e não são usados de forma geral para treinar seus modelos simplesmente porque foram acessados pelo serviço. Ainda assim, informações originadas desses aplicativos podem participar da personalização quando a memória está ativada e as configurações correspondentes permitem.
Ou seja: “a IA pode usar isso para me ajudar” e “a empresa pode usar isso para treinar seus modelos” são perguntas diferentes.
Chats temporários são a porta de saída
Há situações em que a personalização simplesmente não é desejável.
Pode ser uma pesquisa isolada, um documento sensível, uma surpresa para alguém da família ou qualquer assunto que o usuário prefira não misturar com seu contexto habitual.
É aí que entram os chats temporários.
Enquanto permanecem temporárias, essas conversas não aparecem no histórico normal, não criam nem atualizam memórias e não são utilizadas para melhorar os modelos. A experiência atual também permite decidir, antes de iniciar a conversa, se aquele chat temporário poderá usar memórias já existentes ou se deverá começar sem personalização.
Isso transforma o chat temporário em algo mais interessante do que um simples “modo anônimo”. Ele funciona como uma forma de separar contextos.
Para determinadas atividades profissionais, talvez essa distinção passe a ser tão natural quanto escolher entre uma janela normal e uma janela privada do navegador.
Apagar a memória exige entender onde o dado está
A existência de múltiplas fontes também torna a exclusão menos trivial.
A memória pode ser desativada nas configurações de Personalização e informações lembradas podem ser corrigidas ou removidas pelos controles disponíveis na conta. Mas eliminar uma referência da memória não significa apagar automaticamente a conversa original, um arquivo ou um dado existente em um serviço conectado.
Da mesma maneira, apagar apenas o chat não garante que uma memória separada produzida anteriormente desapareça junto com ele.
Para remover completamente determinada informação da esfera de personalização, pode ser necessário eliminar a memória correspondente e também suas fontes originais. A documentação da OpenAI informa ainda que registros de memórias salvas excluídas podem ser mantidos por até 30 dias para finalidades de segurança e depuração.
Nada disso significa que o usuário perdeu o controle. Significa que “lembrar” passou a envolver mais peças do que havia nos primeiros anos dos chatbots.
Quanto melhor a memória, maior a responsabilidade
A utilidade do recurso é difícil de negar.
Para quem utiliza inteligência artificial diariamente, repetir instruções, contexto profissional, características de um projeto ou preferências de escrita rapidamente se torna cansativo. Uma memória eficiente aproxima o assistente de uma ferramenta de trabalho contínua, e não de uma calculadora sofisticada que sofre amnésia cada vez que uma nova conversa é aberta.
Mas existe uma troca.
Quanto mais contexto um sistema conhece, maior o potencial de produzir respostas relevantes. Ao mesmo tempo, aumenta a quantidade de informação que o usuário precisa compreender, organizar e eventualmente remover.
Também cresce o risco de uma memória incorreta contaminar respostas posteriores. Uma conclusão equivocada sobre profissão, preferência, objetivo ou projeto pode reaparecer em novos contextos e parecer um fato simplesmente porque foi incorporada à personalização.
É por isso que mecanismos de correção e transparência importam tanto quanto a própria capacidade de lembrar.
Análise da equipe
A memória talvez seja uma das tecnologias menos espetaculares visualmente e mais importantes para transformar assistentes de IA em ferramentas realmente pessoais.
Modelos maiores respondem melhor. Memória melhor faz algo diferente: reduz o atrito entre o usuário e o modelo. Em muitos fluxos de trabalho, isso pode ser mais perceptível do que alguns pontos adicionais em um benchmark.
Também existe uma mudança silenciosa de paradigma. Durante décadas, softwares guardaram nossos dados em bancos de dados estruturados: nome em um campo, endereço em outro, preferências em uma tabela. Uma IA com memória trabalha com contexto muito menos rígido. Projetos, hábitos e relações podem ganhar importância porque aparecem repetidamente em conversas, não porque alguém preencheu um formulário dizendo “memorize isto”.
Isso é extremamente poderoso e, justamente por isso, exige interfaces de controle igualmente boas.
O teste mais importante para essa tecnologia não será descobrir quanto o ChatGPT consegue lembrar. Será descobrir se uma pessoa comum consegue entender por que determinada informação foi lembrada, de onde ela veio, como corrigi-la e como removê-la quando não quiser mais que faça parte daquele contexto.
Uma memória invisível demais pode ser conveniente até o dia em que lembra a coisa errada.
A evolução realmente interessante será aquela em que a inteligência artificial não apenas se lembrar melhor de quem está usando o sistema, mas também tornar essa lembrança compreensível, auditável e descartável.
👉 Dúvida? Então veja mais em: https://pixbugtech.com/linksuteis