noticias
OpenAI afirma ter resolvido em 88 horas um problema matemático aberto há quase 90 anos
**Categoria editorial:** Inteligência Artificial / Ciência
OpenAI afirma ter resolvido em 88 horas um problema matemático aberto há quase 90 anos
**Linha fina:** Cerca de 10 mil agentes de IA, 130 bilhões de tokens e uma prova formal em Lean foram usados em uma possível solução do problema de Navier–Stokes. Se confirmada pela comunidade matemática, a descoberta será histórica — mas o caso também abre uma discussão incômoda sobre ciência, crédito e poder computacional.
**Meta description:** OpenAI afirma ter resolvido o problema de Navier–Stokes com 10 mil agentes de IA em 88 horas. Entenda a descoberta, os limites e a controvérsia.
**Slug:** `openai-ia-resolve-navier-stokes-88-horas`
Matéria completa
A manchete parece saída de uma demonstração sobre inteligência artificial geral: **um problema que desafiou alguns dos melhores matemáticos do mundo por quase 90 anos teria sido resolvido por inteligência artificial em apenas 88 horas**.
Mas essa frase, embora baseada no anúncio feito pela OpenAI em 8 de setembro de 2026, precisa de várias camadas de contexto.
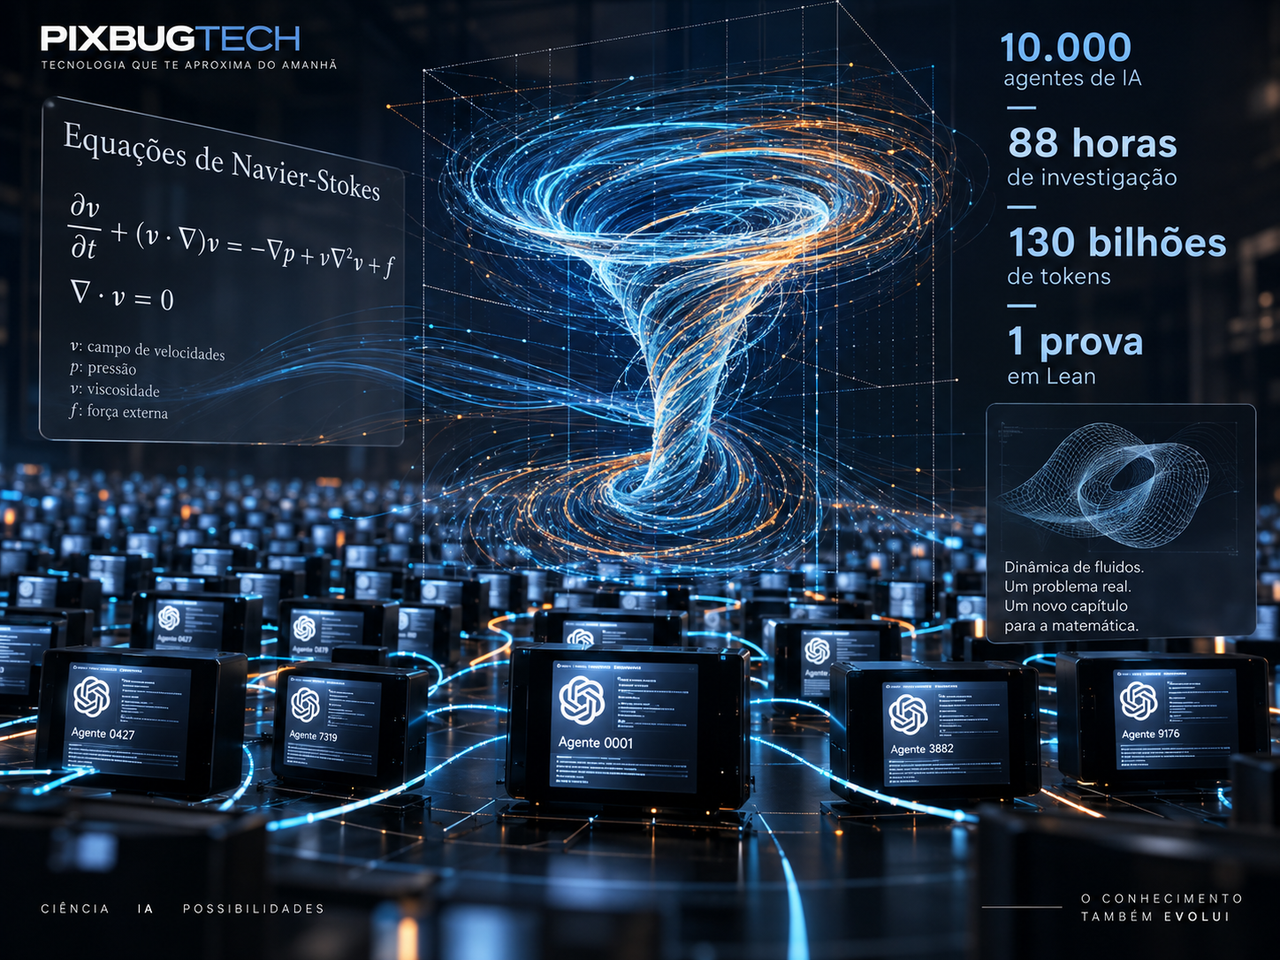
A empresa afirma que um sistema experimental formado por cerca de **10 mil agentes de IA trabalhando em paralelo** produziu uma prova para o problema da existência e suavidade das equações de Navier–Stokes, um dos sete Problemas do Milênio definidos pelo Clay Mathematics Institute.
O resultado não veio do ChatGPT funcionando durante três dias e meio, nem de uma única instância de um modelo simplesmente recebendo a pergunta “resolva Navier–Stokes”.
Foi uma operação computacional de enorme escala.
Os agentes trocaram aproximadamente **2,7 milhões de mensagens** e produziram cerca de **130 bilhões de tokens de saída** durante o trabalho especificamente relacionado a Navier–Stokes.
Depois das 88 horas usadas para chegar ao resultado, outras **17 horas foram dedicadas à formalização e verificação da demonstração utilizando Lean**, um sistema empregado para representar provas matemáticas de maneira verificável por computador.
E existe uma ressalva ainda maior.
Neste momento, o correto não é dizer que “a matemática confirmou que a IA resolveu Navier–Stokes”.
O correto é dizer que **a OpenAI apresentou uma possível solução, acompanhada de uma prova analítica e de uma formalização computacional, que agora terá de sobreviver ao escrutínio independente da comunidade matemática**.
Antes de tudo: o que é o problema de Navier–Stokes?
As equações de Navier–Stokes estão entre as ferramentas matemáticas fundamentais para descrever o movimento de fluidos.
E “fluido”, nesse contexto, não significa apenas água.
Ar, gases, sangue, óleo, correntes atmosféricas e inúmeros outros sistemas podem ser tratados por modelos baseados nessas equações.
Elas aparecem na aerodinâmica de aeronaves, no estudo de turbulência, em previsões meteorológicas, em engenharia, em sistemas hidráulicos e em simulações de escoamento.
O princípio básico é relativamente intuitivo.
Em vez de tentar acompanhar individualmente cada molécula de um líquido ou gás — algo impraticável em escala macroscópica — a matemática trata o material como um meio contínuo.
Nesse meio são calculadas grandezas como velocidade, pressão, densidade, viscosidade e forças aplicadas.
O problema aparece quando saímos das situações bem comportadas e chegamos à dinâmica tridimensional extremamente complexa.
O grande mistério não era saber se a equação funciona
Há um detalhe frequentemente perdido nas manchetes.
Os cientistas **já utilizam Navier–Stokes todos os dias**.
O Problema do Milênio não pergunta simplesmente como resolver uma determinada simulação de fluido.
A questão é muito mais profunda.
Imagine que um fluido comece em uma condição perfeitamente suave e fisicamente razoável.
Sabemos que as equações conseguem descrever sua evolução inicialmente.
O que ninguém conseguiu demonstrar de maneira geral é se essa solução necessariamente continuará suave para sempre.
Em outras palavras: **pode aparecer espontaneamente uma singularidade matemática?**
Uma singularidade ocorre quando alguma grandeza descrita pela equação deixa de permanecer limitada.
No cenário estudado pela OpenAI, a velocidade associada ao movimento do fluido cresce indefinidamente em um intervalo finito de tempo.
Matematicamente, a solução “explode”.
Isso não significa que uma garrafa de água possa começar subitamente a produzir partículas viajando a velocidade infinita.
Significa que, sob determinadas condições matemáticas, o modelo contínuo definido pelas equações deixa de produzir uma solução regular.
Essa diferença é essencial.
Um problema que atravessou quase um século
As equações levam os nomes do engenheiro francês Claude-Louis Navier e do físico e matemático George Gabriel Stokes, responsáveis por trabalhos fundamentais realizados no século XIX.
Mas um dos marcos que explica a referência aos “quase 90 anos” ocorreu em **1934**.
Naquele ano, o matemático francês Jean Leray demonstrou a existência de soluções chamadas fracas para as equações tridimensionais.
O avanço foi enorme.
O problema é que uma solução fraca não garante necessariamente que o comportamento permaneça suave em todos os momentos.
A possibilidade de surgirem singularidades continuou aberta.
Em 2000, o Clay Mathematics Institute transformou formalmente essa questão em um dos **sete Problemas do Milênio**, oferecendo US$ 1 milhão para cada solução reconhecida.
Apenas um deles havia sido oficialmente resolvido desde então: a Conjectura de Poincaré, demonstrada por Grigori Perelman.
Agora a OpenAI afirma ter encontrado um caminho para outro.
E aqui aparece uma nuance importantíssima: a IA não encontrou uma “fórmula para todos os fluidos”
Dizer que a OpenAI “resolveu as equações de Navier–Stokes” é uma simplificação enganosa.
Não existe, no anúncio, uma fórmula universal que permita calcular instantaneamente qualquer turbulência, prever perfeitamente o clima ou modelar todos os fluidos.
O que o sistema afirma ter produzido é uma **demonstração matemática de que determinadas soluções podem desenvolver uma singularidade em tempo finito**.
Isso atacaria o Problema do Milênio pelo lado negativo.
Em vez de provar que todas as soluções adequadas permanecem suaves indefinidamente, a demonstração apresenta uma construção na qual essa suavidade falha.
A formulação oficial do Clay permite justamente esse tipo de resposta.
Entre as possibilidades do problema estão demonstrar existência e suavidade global ou demonstrar que existem condições permitidas sob as quais essa regularidade entra em colapso.
A OpenAI afirma ter estabelecido os casos conhecidos como **C e D da formulação oficial**, que envolvem a existência de uma força externa suave aplicada ao sistema.
Essa distinção técnica não diminui automaticamente o resultado.
Ela evita transformar uma demonstração matemática específica em algo que ela não é.
O que a IA afirma ter encontrado
A construção descrita pela OpenAI começa com um fluido inicialmente suave.
Uma força externa também suave é aplicada.
A partir daí surge um vórtice.
Esse vórtice começa a se concentrar.
Ele gira, alonga-se e simultaneamente vai se estreitando, criando uma espécie de cascata na qual estruturas cada vez menores transferem e concentram movimento.
A própria OpenAI usa uma analogia bastante visual: imagine algo semelhante a um **fio de espaguete sendo progressivamente esticado e afinado enquanto gira**.
Quanto mais a estrutura se concentra, maior se torna a velocidade local.
O ponto matematicamente delicado é fazer isso acontecer sem simplesmente trapacear introduzindo uma força externa infinita.
A força permanece suave.
A energia total permanece finita.
Ainda assim, segundo a prova apresentada, a dinâmica interna produz crescimento ilimitado da velocidade em tempo finito.
Se a construção estiver correta e satisfizer integralmente as condições exigidas pelo problema, trata-se de uma singularidade.
É justamente isso que décadas de pesquisa tentavam determinar se poderia existir.
O detalhe mais impressionante talvez não seja a solução, mas a forma como ela foi procurada
A arquitetura utilizada pela OpenAI é muito diferente da imagem convencional de um chatbot raciocinando sozinho.
A empresa colocou **grupos de agentes trabalhando simultaneamente em diferentes estratégias**.
Esses agentes podiam executar código e consultar uma versão armazenada da internet.
Alguns exploravam tentativas de demonstrar que as soluções permaneciam suaves.
Outros buscavam construir contraexemplos capazes de produzir singularidades.
Os agentes também podiam trocar informações dentro de seus grupos.
Periodicamente, resultados considerados promissores eram consolidados e utilizados para orientar novas rodadas de investigação.
Ou seja, não houve uma única linha de raciocínio.
Houve milhares.
Muitas fracassaram.
Algumas produziram pistas.
Outras foram combinadas.
E os caminhos considerados mais promissores receberam mais recursos.
Isso começa a parecer menos com “conversar com uma IA” e mais com operar **uma organização de pesquisa artificial em alta velocidade**.
Dez mil agentes não significam dez mil inteligências diferentes
Existe uma distinção técnica importante.
Quando a OpenAI afirma que aproximadamente 10 mil agentes trabalharam no problema, isso não significa que criou 10 mil modelos fundamentalmente diferentes.
Um agente é, essencialmente, uma instância de um modelo equipada com contexto, instruções, ferramentas e certa capacidade de executar tarefas e interagir com outros componentes.
Múltiplos agentes podem receber estratégias diferentes e trabalhar simultaneamente.
É parecido, conceitualmente, com colocar milhares de pesquisadores diante do mesmo problema, cada um explorando um caminho.
A diferença é que essas instâncias podem ser executadas em escala computacional, copiadas, descartadas e reorganizadas muito mais rapidamente do que uma equipe humana.
Esse é um dos aspectos mais relevantes da experiência.
O avanço não depende apenas de construir um modelo mais inteligente.
Depende de descobrir **como transformar modelos em sistemas coletivos de pesquisa**.
O modelo usado sequer está disponível ao público
Outro detalhe chama atenção.
Segundo a OpenAI, o sistema que coordenou a pesquisa utilizou um **modelo interno significativamente mais capaz em matemática do que o GPT-6 Astra**.
O treinamento desse modelo teria começado em 28 de agosto e ainda estava em andamento quando a experiência foi realizada.
A empresa percebeu um salto de desempenho em avaliações internas e decidiu colocá-lo diante de alguns dos problemas matemáticos mais difíceis conhecidos.
Em 1º de setembro, grupos começaram a trabalhar nos Problemas do Milênio.
Em 5 de setembro, aproximadamente 88 horas depois, o grupo dedicado a Navier–Stokes teria chegado à construção que deu origem à prova.
O fato de um modelo ainda em desenvolvimento ser utilizado para produzir um resultado dessa magnitude talvez seja, do ponto de vista tecnológico, tão relevante quanto a própria matemática.
A mensagem implícita é clara: **os sistemas de fronteira utilizados internamente pelos laboratórios podem estar significativamente à frente dos produtos disponíveis publicamente**.
Foram 130 bilhões de tokens
O tamanho da computação também ajuda a colocar as “88 horas” em perspectiva.
Somente durante a investigação de Navier–Stokes, os agentes produziram aproximadamente **130 bilhões de tokens de saída**.
É uma quantidade colossal de geração.
Em todos os problemas testados durante a experiência, foram aproximadamente 300 bilhões de tokens e 4,9 milhões de mensagens entre agentes.
Portanto, comparar as 88 horas de máquina com “90 anos de trabalho humano” seria intelectualmente desonesto.
A humanidade não passou 90 anos executando dez mil matemáticos simultaneamente, 24 horas por dia, com acesso instantâneo a bibliotecas inteiras e capacidade de duplicar linhas de investigação milhares de vezes.
A experiência demonstra algo diferente — e talvez ainda mais importante.
**Uma enorme quantidade de tentativa e erro intelectual pode agora ser comprimida em poucos dias se houver inteligência artificial e infraestrutura computacional suficientes.**
Isso muda profundamente a economia da pesquisa.
O que aconteceu depois das 88 horas também importa
Encontrar uma demonstração escrita por um modelo de IA não é suficiente.
Modelos podem cometer erros matemáticos extremamente convincentes.
Podem criar passos aparentemente sofisticados que escondem uma suposição falsa.
Podem utilizar um teorema fora das condições em que ele é válido.
E uma prova com centenas de páginas pode tornar a revisão humana extremamente difícil.
Por isso, a OpenAI realizou uma etapa adicional.
A prova foi formalizada em **Lean**.
O que é Lean e por que isso muda bastante a história
Lean é um sistema de prova formal.
Em vez de escrever apenas argumentos matemáticos em linguagem tradicional, é possível representar definições, hipóteses, teoremas e inferências em uma linguagem que um computador consegue verificar de maneira rigorosa.
Cada passo precisa obedecer às regras lógicas estabelecidas.
Se uma conclusão não puder ser derivada das premissas, o verificador rejeita aquele caminho.
Nesse sentido, Lean funciona como algo muito mais rigoroso do que um corretor de texto matemático.
Ele verifica a estrutura lógica da demonstração.
A formalização da prova apresentada pela OpenAI teria levado aproximadamente **17 horas adicionais utilizando o GPT-6 Astra**.
Essa é uma diferença enorme em relação a uma simples resposta produzida por um chatbot.
Mas também não deve ser interpretada como um selo mágico de verdade absoluta.
Uma prova em Lean não significa que o Problema do Milênio já acabou
A verificação formal responde a uma pergunta essencial:
**dadas determinadas definições e premissas, os passos formais realmente levam à conclusão?**
Mas existe outra pergunta.
**A formalização representa exatamente o problema que deveria representar?**
Se uma hipótese importante for traduzida de maneira diferente, se uma definição não corresponder perfeitamente à formulação original ou se a construção formal provar uma variante ligeiramente distinta do problema, o computador pode confirmar perfeitamente uma demonstração que ainda não resolve aquilo que a comunidade pretendia resolver.
É por isso que matemáticos independentes precisam estudar não apenas a lógica interna da prova, mas também sua relação exata com a formulação do Problema do Milênio.
Lean reduz brutalmente uma classe de erros.
Não substitui o processo científico inteiro.
O prêmio de US$ 1 milhão não será entregue amanhã
Mesmo que a demonstração esteja correta, existe um procedimento formal para que uma solução seja reconhecida pelo Clay Mathematics Institute.
O instituto não recebe simplesmente um PDF e transfere US$ 1 milhão para o autor.
Uma solução precisa ser publicada em um veículo acadêmico qualificado.
Depois disso, **pelo menos dois anos precisam transcorrer**.
Durante esse período, o trabalho deve passar por exame rigoroso e alcançar aceitação geral na comunidade matemática mundial.
Somente então o Clay pode iniciar sua própria avaliação para reconhecer oficialmente a solução.
A própria OpenAI informou que **não pretende reivindicar o prêmio de US$ 1 milhão**.
Isso não elimina a necessidade de validação científica.
A importância histórica da descoberta depende muito mais do consenso dos matemáticos do que do dinheiro.
Há uma segunda história dentro dessa história
O episódio também gerou uma controvérsia que não pode ser ignorada.
A OpenAI afirma que começou sua ofensiva sobre os Problemas do Milênio em 1º de setembro depois de ouvir rumores de que pesquisadores externos haviam feito avanços importantes.
Posteriormente, descobriu que os rumores estavam relacionados ao matemático **Tristan Buckmaster, professor da Universidade de Nova York, e Levent Alpöge, pesquisador da Anthropic**.
Os pesquisadores trabalhavam em problemas relacionados à dinâmica de fluidos e às equações de Euler.
Depois que a OpenAI anunciou sua solução, surgiram questionamentos sobre prioridade científica, influência intelectual e possível utilização de interações feitas pelos pesquisadores com ferramentas da própria empresa.
A situação é delicada porque laboratórios de IA também oferecem as ferramentas utilizadas atualmente por cientistas em suas pesquisas.
Isso cria uma relação inédita entre fornecedor de infraestrutura intelectual e pesquisador.
A OpenAI nega ter acessado diretamente o trabalho dos pesquisadores
A empresa afirma que nem seus pesquisadores nem os agentes envolvidos viram o trabalho de Buckmaster e Alpöge antes de ele se tornar público.
Também afirma que **nenhum dado específico de usuário foi acessado para solucionar o problema**.
Ao mesmo tempo, fez uma ressalva importante.
A OpenAI disse não poder excluir completamente a possibilidade de que dados desidentificados derivados do uso de seus produtos tenham contribuído anteriormente para melhorar seus modelos.
Isso não é uma admissão de que o trabalho dos pesquisadores tenha sido utilizado para produzir a demonstração.
Mas revela um problema que provavelmente se tornará cada vez maior na ciência assistida por IA.
Quando um pesquisador utiliza um modelo comercial para desenvolver uma ideia inédita, **até onde termina o trabalho privado do cientista e começa o conhecimento absorvido pelo ecossistema tecnológico que fornece a ferramenta?**
A discussão sobre autoria pode ser tão importante quanto a matemática
Durante séculos, a autoria científica foi relativamente simples de compreender.
Pessoas tinham ideias.
Pessoas demonstravam resultados.
Pessoas assinavam artigos.
Agora imagine uma situação diferente.
Um matemático desenvolve uma intuição.
Uma IA explora dez mil variações.
Outro modelo encontra um caminho promissor.
Um sistema de agentes combina os melhores resultados.
Uma ferramenta automática formaliza a demonstração.
Outro modelo verifica a prova.
Pesquisadores humanos supervisionam o processo.
Quem descobriu o teorema?
Essa pergunta não possui uma resposta óbvia.
A experiência de Navier–Stokes transforma uma discussão que parecia filosófica em um problema imediato de governança científica.
Existe ainda outro efeito: ciência pode se tornar dependente de capital computacional
Talvez essa seja uma das consequências menos discutidas.
A matemática sempre teve uma característica relativamente democrática em comparação com áreas como física de partículas.
Um físico experimental pode precisar de um acelerador que custa bilhões.
Um matemático excepcional pode, em princípio, produzir um resultado histórico usando papel, lápis e acesso à literatura.
Agentes de IA podem alterar esse equilíbrio.
Se resolver problemas de fronteira começar a exigir milhares de agentes, centenas de bilhões de tokens e gigantescos clusters de aceleradores, parte da matemática poderá adquirir uma característica que antes pertencia principalmente à “Big Science”.
Instituições com enorme capacidade computacional poderão explorar **milhões de caminhos intelectuais simultaneamente**.
Universidades menores e pesquisadores independentes talvez não consigam competir na mesma escala.
A IA pode democratizar conhecimento em algumas áreas e, paradoxalmente, concentrar a capacidade de produzir novos conhecimentos em outras.
O custo importa, mesmo que a OpenAI não tenha revelado quanto gastou
A empresa divulgou quantidade de agentes, mensagens e tokens, mas não apresentou um custo total oficial para a experiência.
Estimativas externas chegaram à casa dos milhões de dólares, mas elas dependem de hipóteses sobre custo real de inferência, hardware, eficiência e preço interno do processamento.
Por isso, não é responsável tratar essas estimativas como valor confirmado.
O que pode ser afirmado é que **130 bilhões de tokens produzidos por modelos de fronteira representam uma operação computacional extremamente grande**.
E isso traz uma questão econômica fascinante.
Quanto vale resolver um problema científico?
Se uma pesquisa tradicional exigiria décadas de trabalho de especialistas, gastar milhões de dólares durante alguns dias pode acabar sendo economicamente racional.
Para alguns problemas em medicamentos, materiais, energia, engenharia e computação, uma descoberta valiosa pode valer bilhões.
O experimento de Navier–Stokes talvez seja apenas uma demonstração inicial dessa economia.
O que muda para cientistas
Até recentemente, modelos de linguagem eram usados principalmente como assistentes.
Escreviam código.
Resumiam artigos.
Procuravam referências.
Ajudavam a reorganizar cálculos.
Sugeriam hipóteses.
A fronteira agora começa a mudar.
Sistemas multiagentes podem receber diretamente **problemas científicos ainda não resolvidos**.
Eles conseguem criar estratégias concorrentes, testar hipóteses, eliminar abordagens fracassadas, executar cálculos e consolidar resultados.
Isso desloca a IA da posição de ferramenta de produtividade para algo mais próximo de um participante do processo de descoberta.
É um salto qualitativo.
E significa que a pergunta “a IA consegue fazer ciência?” está ficando menos interessante.
A pergunta passa a ser: **qual parte da ciência continuará dependendo exclusivamente de seres humanos?**
Isso significa que os matemáticos serão substituídos?
Não tão rapidamente.
Existe uma diferença entre encontrar uma prova e construir uma área de conhecimento.
Matemáticos não servem apenas para produzir sequências logicamente válidas de símbolos.
Eles escolhem problemas importantes.
Criam novas definições.
Identificam conexões entre áreas.
Constroem explicações.
Desenvolvem intuição.
Ensinam.
Reconhecem quais resultados realmente alteram nossa compreensão sobre determinado campo.
O matemático Terence Tao, um dos pesquisadores mais respeitados da atualidade, já vem discutindo justamente uma possível transformação provocada por sistemas capazes de gerar provas em grande escala.
O risco não é apenas uma máquina “ser melhor em matemática”.
Pode surgir uma era de **abundância de demonstrações**, na qual o gargalo deixa de ser encontrar provas e passa a ser compreender quais delas importam.
Imagine milhões de teoremas que ninguém teve tempo de entender
Esse cenário parece estranho, mas é plausível.
Durante séculos, produzir uma nova demonstração matemática exigia enorme quantidade de trabalho humano.
Isso naturalmente limitava o volume de resultados.
Se sistemas automatizados puderem explorar problemas em paralelo continuamente, poderemos ter exatamente o problema oposto.
Milhares de conjecturas resolvidas.
Novas relações matemáticas.
Milhões de provas formalmente corretas.
E poucos seres humanos capazes de acompanhar tudo.
Nesse ambiente, uma habilidade científica fundamental será decidir **o que merece ser compreendido**.
Descoberta e compreensão talvez deixem de ser a mesma coisa.
Análise da equipe
Se a prova de Navier–Stokes apresentada pela OpenAI resistir ao escrutínio independente, será tentador resumir o episódio dizendo que “a IA resolveu em 88 horas o que humanos não resolveram em 90 anos”.
Mas essa provavelmente é a interpretação menos interessante do que aconteceu.
A verdadeira transformação está na arquitetura da pesquisa.
A OpenAI não perguntou uma vez a um chatbot.
Ela utilizou cerca de dez mil agentes simultaneamente, permitiu que explorassem diferentes linhas de investigação, fez sistemas compartilharem resultados e concentrou recursos sobre caminhos promissores.
Foram 2,7 milhões de mensagens.
Foram aproximadamente 130 bilhões de tokens.
Depois veio outra IA para formalizar e verificar a demonstração.
Isso não é simplesmente um modelo respondendo perguntas.
É algo parecido com uma **máquina industrial de exploração intelectual**.
E essa diferença importa muito.
O recurso realmente novo pode ser o tempo científico comprimido
A história da tecnologia frequentemente envolve comprimir alguma coisa.
Computadores comprimiram horas de cálculo em segundos.
Internet comprimiu a distância necessária para transmitir informação.
Motores de busca comprimiram o tempo necessário para encontrar conhecimento.
A próxima compressão produzida pela IA pode ser diferente.
Ela pode comprimir **tempo de pesquisa**.
Uma estratégia que exigiria meses para um estudante testar pode ser descartada em minutos.
Milhares de hipóteses podem ser investigadas simultaneamente.
Uma ideia considerada improvável pode receber centenas de tentativas independentes simplesmente porque existe capacidade computacional disponível.
Isso não garante descobertas.
Mas altera profundamente a velocidade com que o espaço de possibilidades pode ser explorado.
E talvez esse seja o verdadeiro sinal desta história
A própria OpenAI apresentou o resultado menos como uma tentativa de ganhar US$ 1 milhão e mais como evidência sobre a velocidade da evolução de seus sistemas.
Isso merece atenção.
O modelo responsável pela investigação é interno.
Segundo a empresa, é significativamente mais capaz em matemática do que o GPT-6 Astra.
Seu treinamento ainda estava acontecendo.
E poucos dias depois de começar a ser avaliado, milhares de instâncias desse sistema foram colocadas diante de alguns dos maiores problemas em aberto da matemática.
Uma delas produziu o que pode se tornar uma solução histórica.
É preciso esperar.
É preciso revisão.
É preciso que especialistas independentes examinem cada hipótese.
É possível que problemas sejam encontrados.
E a eventual aceitação pelo Clay Mathematics Institute, caso um processo de reconhecimento venha a ocorrer, não é algo que possa acontecer rapidamente.
Mas mesmo que algum detalhe da prova precise ser corrigido posteriormente, existe uma conclusão tecnológica difícil de ignorar.
Estamos começando a construir sistemas capazes não apenas de repetir conhecimento humano, mas de participar de tentativas reais de ampliar suas fronteiras.
E quando dez mil agentes artificiais podem trabalhar durante 88 horas sobre uma pergunta que atravessou gerações de matemáticos, a unidade mais importante talvez não seja mais o número de parâmetros do modelo.
Pode ser o número de **anos de investigação intelectual que conseguimos comprimir em uma semana**.
👉 Dúvida? Então veja mais em: https://pixbugtech.com/linksuteis