noticias
OpenAI e Anthropic cortam preços, mas China muda a guerra da IA: agora vence quem entrega mais por dólar
**Categoria editorial:** Inteligência Artificial / Mercado
OpenAI e Anthropic cortam preços, mas China muda a guerra da IA: agora vence quem entrega mais por dólar
**Linha fina:** GPT-5.6 Luna ficou 80% mais barato, Anthropic segura preços do Claude e rivais chineses pressionam margens; a disputa agora envolve custo por tarefa, abertura e dependência de fornecedor.
**Meta description:** OpenAI e Anthropic cortam preços de IA enquanto DeepSeek, Kimi e outros rivais chineses pressionam o mercado com modelos mais baratos e abertos.
**Slug:** `openai-anthropic-guerra-precos-ia-china`
Matéria completa
A corrida pela inteligência artificial mais poderosa ganhou uma segunda pista, e nela um benchmark espetacular não garante a vitória.
OpenAI e Anthropic estão reduzindo ou segurando preços em partes importantes de seus portfólios enquanto desenvolvedores chineses como DeepSeek e Moonshot AI pressionam o mercado com modelos que combinam desempenho cada vez mais competitivo, preços agressivos e, em vários casos, pesos que podem ser executados fora da infraestrutura do fabricante. O movimento transforma uma disputa que durante anos foi apresentada como corrida pela “melhor IA” em algo muito mais familiar ao mundo empresarial: quanto trabalho útil cada dólar compra.
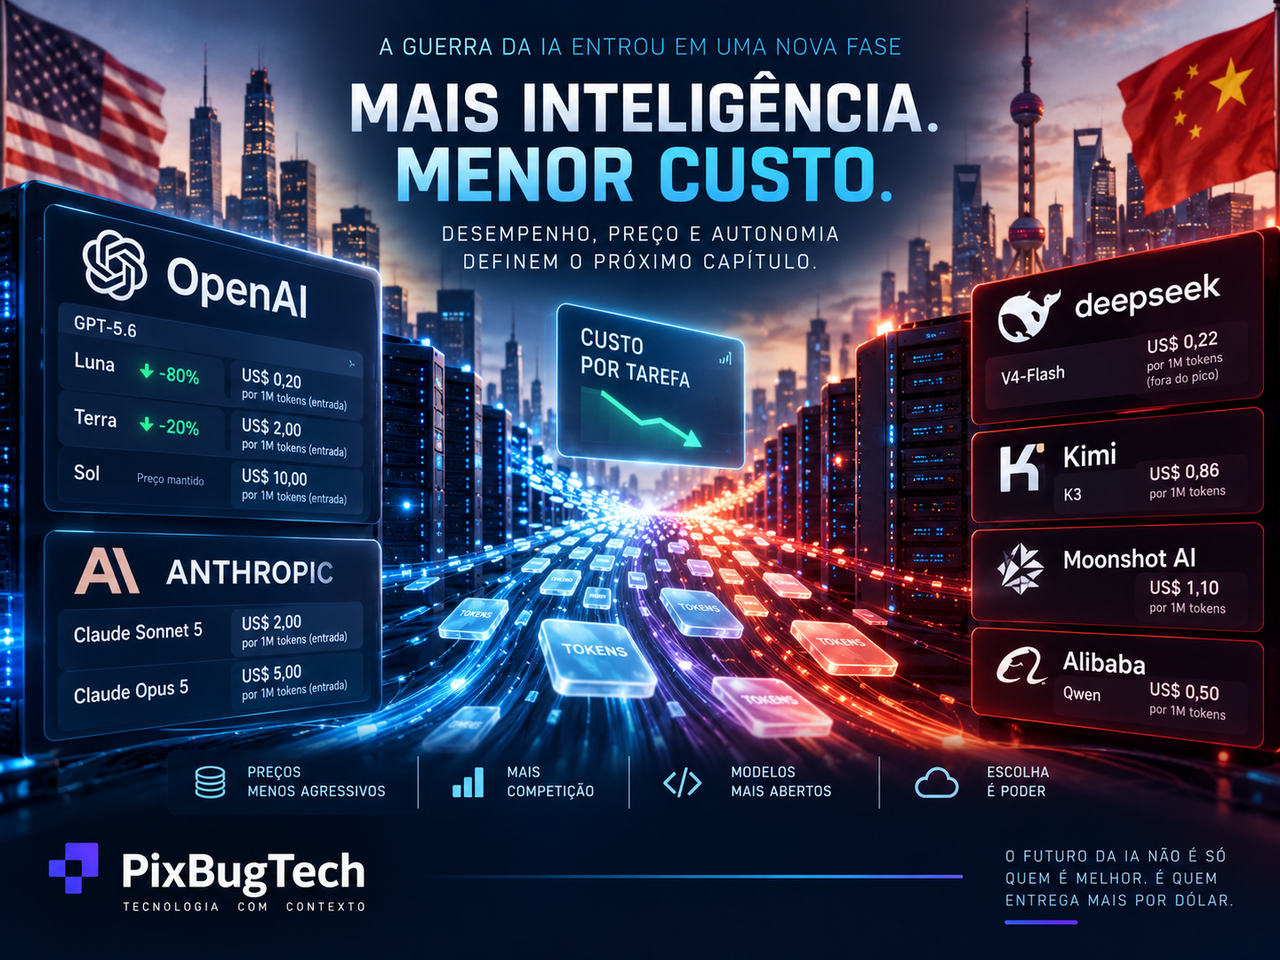
A OpenAI reduziu em 30 de julho o preço do GPT-5.6 Luna em 80%. A entrada passou de US$ 1 para US$ 0,20 por milhão de tokens, enquanto a saída caiu de US$ 6 para US$ 1,20. O GPT-5.6 Terra também ficou mais barato, passando para US$ 2 por milhão de tokens de entrada e US$ 12 na saída. O modelo mais poderoso da família, GPT-5.6 Sol, não entrou nessa liquidação.
A Anthropic seguiu uma lógica semelhante. O Claude Opus 5 custa US$ 5 por milhão de tokens de entrada e US$ 25 de saída, metade dos US$ 10 e US$ 50 cobrados pelo Fable 5. A empresa também desistiu de um aumento que estava planejado para o Claude Sonnet 5: o preço de US$ 2 na entrada e US$ 10 na saída, inicialmente apresentado como promocional até o fim de agosto, virou tarifa permanente.
Isso não parece coincidência.
Os cortes acontecem enquanto empresas começam a perceber que colocar inteligência artificial dentro de processos reais pode produzir uma conta bem diferente daquela assinatura mensal usada para conversar com um chatbot.
O problema começou quando a IA saiu da janela de conversa
Para um consumidor, o preço de uma inteligência artificial costuma aparecer como assinatura.
Para uma empresa que utiliza APIs, a matemática é outra.
Cada documento enviado ao modelo consome tokens de entrada. Cada resposta produz tokens de saída. Um agente que pesquisa arquivos, consulta bancos de dados, executa ferramentas, analisa o resultado e tenta novamente pode multiplicar esse consumo várias vezes antes de concluir uma única tarefa.
Quando centenas ou milhares de funcionários começam a utilizar agentes durante todo o expediente, aquilo que parecia barato individualmente vira infraestrutura.
É por isso que a discussão sobre centavos por milhão de tokens passou a importar.
A reportagem que originou esta pauta aponta que empresas começaram a limitar consumo, revisar contratos e experimentar modelos mais baratos. DoorDash e Airbnb aparecem entre as companhias que já testaram ou utilizaram tecnologias chinesas em determinadas cargas de trabalho.
Não significa que empresas americanas estejam abandonando OpenAI ou Anthropic.
Significa algo mais perigoso para qualquer fornecedor dominante: elas descobriram que nem toda tarefa precisa do modelo mais caro.
A China atacou exatamente nesse espaço
A explosão do DeepSeek R1 em 2025 já havia mostrado que o desenvolvimento chinês poderia pressionar a narrativa de que apenas gigantes com investimentos monumentais conseguiriam competir na fronteira.
Em 2026, a disputa amadureceu.
DeepSeek, Moonshot AI, Z.ai, Alibaba, MiniMax, ByteDance e outros laboratórios passaram a formar um ecossistema no qual novos modelos chegam em sequência e competem não apenas em qualidade, mas também em preço, contexto, programação, agentes e disponibilidade de pesos.
O DeepSeek V4-Flash tornou-se um exemplo extremo.
No começo de agosto, a Artificial Analysis estimou que ele custava aproximadamente três centavos de dólar para executar um de seus testes padronizados. No mesmo conjunto de medições, o Kimi K3 aparecia em US$ 0,86, o GPT-5.6 Sol em US$ 1,86 e o Claude Fable 5 em US$ 3,15.
Não se trata de dizer que todos esses modelos entregam exatamente a mesma qualidade.
Não entregam.
O ponto econômico é outro: quando uma tarefa não exige o melhor resultado disponível no planeta, pagar cem vezes mais por uma pequena melhora pode deixar de fazer sentido.
Essa é a brecha que os concorrentes chineses estão explorando.
Só que “modelo chinês barato” já começa a ficar simplista demais
Há uma ironia interessante acontecendo quase simultaneamente à guerra de descontos nos Estados Unidos.
A DeepSeek anunciou que aumentará os preços de sua família V4 a partir de 16 de agosto de 2026 e adotará tarifas diferentes para horários de pico e fora de pico.
O V4-Flash terá, no período de pico, preço de US$ 0,44 por milhão de tokens de entrada e US$ 1,32 por milhão de saída. Fora do pico, esses valores caem pela metade, para US$ 0,22 e US$ 0,66.
No V4-Pro, o preço de pico será de US$ 1,32 na entrada e US$ 3,96 na saída; fora dele, US$ 0,66 e US$ 1,98.
É um movimento importante porque mostra que a pressão chinesa não aponta necessariamente para uma corrida infinita até o preço zero.
Quando um produto ganha demanda suficiente, o fabricante também tenta monetizá-la.
A guerra está criando faixas.
Há modelos destinados a volume.
Há modelos destinados a tarefas premium.
E começa a surgir algo parecido com tarifa de energia elétrica: se o trabalho puder esperar algumas horas, a inteligência fica mais barata.
Isso é uma mudança estrutural interessante para agentes empresariais.
IA em horário de pico pode virar uma variável de infraestrutura
A ideia de cobrar preços diferentes conforme o horário parece estranha para quem enxerga IA como software.
Faz bastante sentido quando se lembra de que uma resposta não surge de mágica.
Inferência consome GPUs ou aceleradores especializados, memória de alta largura de banda, eletricidade, resfriamento, rede e capacidade de datacenter.
A infraestrutura possui limites.
Se milhares de empresas solicitam processamento pesado ao mesmo tempo, o fornecedor precisa manter capacidade ociosa suficiente para atender aos picos ou aceitar degradação de serviço.
A DeepSeek está transformando esse problema de infraestrutura em sinal de preço.
Isso pode criar um comportamento novo nas empresas.
Relatórios noturnos, classificação de documentos, geração de embeddings, análises de grandes repositórios e outras tarefas que não precisam de resposta imediata poderão ser deslocadas para horários mais baratos.
É exatamente o que computação em nuvem e mercados de energia já fazem há anos.
A diferença é que agora estamos começando a aplicar essa lógica ao raciocínio artificial.
Preço por token é uma métrica perigosamente sedutora
Colocar uma tabela lado a lado parece resolver a comparação.
Modelo A custa US$ 1.
Modelo B custa US$ 5.
Logo, A é cinco vezes mais barato.
Nem sempre.
Um modelo menos capaz pode precisar produzir respostas maiores, utilizar mais ferramentas, repetir etapas ou receber correções até entregar um resultado aceitável.
Um modelo mais caro pode resolver o mesmo problema na primeira tentativa.
Isso significa que a métrica economicamente relevante não é necessariamente “dólares por milhão de tokens”.
É custo por tarefa concluída corretamente.
A diferença parece pequena, mas muda toda a análise.
Um desenvolvedor pode economizar 80% no preço dos tokens e perder o benefício se o agente precisar executar quatro vezes mais passos para corrigir o mesmo bug.
Da mesma forma, um modelo premium pode parecer absurdo numa tabela e ser barato quando evita uma hora de trabalho humano altamente especializado.
A Artificial Analysis já tenta medir esse efeito ao comparar custo real durante benchmarks, e os resultados mostram que o ranking por preço nominal não coincide obrigatoriamente com o ranking por trabalho concluído.
Essa distinção será cada vez mais importante.
Um exemplo mostra o tamanho da diferença
Imagine uma aplicação corporativa que, durante um determinado período, envie 1 bilhão de tokens aos modelos e receba 200 milhões de tokens de resposta.
É apenas um exercício matemático, não uma comparação de qualidade equivalente.
Com os preços atuais do GPT-5.6 Luna, esse volume custaria aproximadamente US$ 440: US$ 200 pela entrada e US$ 240 pela saída.
No Claude Sonnet 5, a mesma quantidade nominal de tokens custaria cerca de US$ 4 mil.
No Claude Opus 5, US$ 10 mil.
No Kimi K3, usando a tabela internacional da Moonshot, aproximadamente US$ 6 mil.
No DeepSeek V4-Flash, após a mudança de preços de 16 de agosto, seriam cerca de US$ 704 durante o pico ou US$ 352 fora dele.
A comparação não diz qual modelo deveria ser escolhido.
Ela mostra por que um diretor financeiro começa a fazer perguntas quando uma equipe decide simplesmente enviar todas as tarefas para o modelo mais sofisticado disponível.
Em escala, arquitetura de IA vira arquitetura de custos.
OpenAI parece estar protegendo o topo e barateando o meio
A maneira como a OpenAI distribuiu os cortes ajuda a revelar sua estratégia.
Luna ficou drasticamente mais barato.
Terra recebeu redução menor.
Sol permaneceu com seu preço.
Isso cria uma escada clara.
Para tarefas que precisam de volume, Luna.
Para demandas intermediárias, Terra.
Para situações em que qualidade máxima justifique o custo, Sol.
A Anthropic apresenta estrutura semelhante com Haiku, Sonnet, Opus e Fable em diferentes níveis de preço e capacidade.
Não é muito diferente da segmentação que existe em processadores, nuvem ou bancos de dados.
O fornecedor não precisa cobrar o mesmo preço de todos.
Ele precisa descobrir quanto cada tipo de cliente está disposto a pagar pelo próximo nível de desempenho.
A diferença é que a concorrência chinesa está comprimindo os degraus inferiores dessa escada.
Se um modelo barato resolve 90% das tarefas suficientemente bem, fica muito difícil cobrar preço premium nesses 90%.
A verdadeira ameaça talvez seja o roteador de modelos
Existe uma consequência que recebe menos atenção do que os cortes propriamente ditos.
Durante a primeira fase da IA generativa, muitas empresas escolheram um fornecedor.
“Nós usamos OpenAI.”
“Nós usamos Claude.”
“Nós usamos Gemini.”
Essa frase pode envelhecer rapidamente.
A arquitetura economicamente mais racional começa a ser outra: selecionar o modelo dinamicamente conforme a tarefa.
Uma classificação simples pode ir para um modelo muito barato.
Um atendimento rotineiro pode usar outro.
Uma revisão jurídica complexa pode ser encaminhada para um modelo superior.
Código pode passar por um modelo especializado.
Uma tarefa extremamente difícil pode escalar para um sistema de fronteira somente depois que opções mais baratas falharem.
O componente estratégico deixa então de ser o modelo.
Passa a ser o roteador.
É o software que decide qual inteligência receberá cada trabalho.
Isso reduz o poder de fidelização das próprias empresas de IA
Se uma organização constrói seus sistemas diretamente ao redor de funções exclusivas de apenas um fornecedor, trocar de modelo pode ser caro.
Se constrói uma camada independente, compatível com várias APIs, a troca pode se resumir a configuração, avaliação e testes.
Os modelos chineses aceleram esse processo porque vários adotam interfaces compatíveis com padrões popularizados por OpenAI e Anthropic.
A DeepSeek, por exemplo, oferece compatibilidade com APIs utilizadas no ecossistema americano e promove integração com ferramentas de agentes.
Esse detalhe aparentemente técnico possui enorme significado comercial.
Quanto mais fácil trocar o motor, menor o poder do fabricante para aumentar preços.
É a velha história da infraestrutura de tecnologia reaparecendo com outro nome.
Bancos de dados tentam prender aplicações.
Nuvens tentam prender workloads.
Sistemas operacionais tentam prender desenvolvedores.
Agora os modelos tentam prender agentes.
Pesos abertos acrescentam outra arma
Há ainda uma diferença entre contratar uma API barata e poder executar um modelo em infraestrutura própria.
Parte importante dos modelos chineses é distribuída com pesos abertos.
Isso não deve ser confundido automaticamente com software livre ou código aberto no sentido tradicional.
“Pesos abertos” significa, essencialmente, que os parâmetros treinados do modelo podem ser baixados dentro das condições de sua licença e executados fora do serviço hospedado pelo fabricante.
Para algumas empresas, isso muda tudo.
Dados internos podem permanecer em infraestrutura controlada pela organização.
O modelo pode ser ajustado.
A empresa pode escolher provedores de inferência diferentes.
Em determinados casos, pode inclusive operar o sistema em datacenters próprios.
Essa autonomia reduz uma forma de dependência, embora crie outras.
Rodar seu próprio modelo não significa rodar de graça
A palavra “aberto” costuma produzir um efeito curioso nas planilhas.
O custo da API desaparece e alguém conclui que a inteligência ficou gratuita.
A GPU discorda.
Modelos grandes exigem memória, servidores, energia, resfriamento, observabilidade, atualizações, engenharia de inferência e profissionais capazes de manter toda essa estrutura funcionando.
Também existe o problema da utilização.
Um provedor de API distribui o custo de suas máquinas entre milhares de clientes.
Uma empresa que compra GPUs próprias paga por elas inclusive quando estão esperando trabalho.
Por isso, uma API aparentemente cara pode ser economicamente superior para cargas pequenas ou imprevisíveis.
Hospedagem própria tende a ficar mais atraente quando volume, privacidade, personalização ou controle justificam o investimento.
A guerra de preços torna essa conta ainda mais interessante porque reduz justamente o custo da alternativa hospedada.
A China ganhou uma vantagem comercial que também virou problema político
A adoção crescente de modelos chineses por empresas ocidentais começou a chamar atenção de autoridades americanas.
Companhias como Airbnb e DoorDash já foram questionadas sobre o uso ou teste desses sistemas.
A discussão mistura segurança de dados, dependência tecnológica, competição industrial e geopolítica.
É importante separar dois cenários.
Enviar informações corporativas diretamente para uma API operada na China cria uma relação de dados e infraestrutura diferente de baixar pesos de um modelo e executá-los por meio de um provedor aprovado ou dentro da própria organização.
Colocar tudo na mesma categoria como “usar IA chinesa” é tecnicamente pobre.
Mas a preocupação estratégica existe.
Se empresas americanas passam a depender de modelos estrangeiros porque são mais baratos, políticas de exportação, sanções, alterações de licença ou restrições nacionais também passam a representar risco operacional.
Preço baixo não elimina risco de fornecedor.
Apenas muda sua origem.
A guerra de preços esbarra numa conta de bilhões
Existe uma contradição no centro de toda essa competição.
Enquanto modelos ficam mais baratos para o usuário, a infraestrutura necessária para sustentar a corrida continua extremamente cara.
Empresas investem pesadamente em chips, datacenters, energia e redes para treinar e executar sistemas cada vez maiores.
Em condições normais de mercado, seria esperado que um produto intensivo em capital buscasse aumentar margens.
Na IA, ocorre simultaneamente o contrário.
A competição está reduzindo o preço de utilização justamente quando o setor precisa justificar investimentos gigantescos.
Isso pode funcionar se a redução de preços aumentar o consumo em proporção ainda maior.
É a aposta clássica da tecnologia.
Fazer cada unidade ficar barata e vender uma quantidade absurdamente maior.
A incógnita é se a curva de demanda será grande o suficiente.
Agentes podem resolver o problema — ou multiplicá-lo
Os agentes de IA são particularmente importantes nessa equação.
Uma pessoa conversando com um chatbot produz uma quantidade limitada de chamadas.
Um agente pode trabalhar durante horas.
Ele pesquisa.
Abre arquivos.
Executa comandos.
Consulta ferramentas.
Analisa resultados.
Planeja o próximo passo.
Tenta novamente.
Cada uma dessas etapas pode gerar novas inferências.
Se agentes se espalharem por desenvolvimento de software, atendimento, marketing, análise financeira e operações corporativas, o volume de tokens pode crescer muito mais rápido do que o número de usuários.
Nesse cenário, baixar o preço por token não reduz necessariamente a receita dos fornecedores.
Pode simplesmente fazer as máquinas consumirem mais inteligência.
É quase um efeito rebote.
Quanto mais barata fica a inferência, mais processos passam a utilizá-la.
Quem ganha eficiência primeiro
Grandes usuários de API são os beneficiados mais óbvios.
Empresas que processam milhões de atendimentos, documentos, requisições de programação ou operações automatizadas conseguem sentir imediatamente qualquer redução de preço.
Startups também ganham.
Um produto que seria inviável a US$ 10 por determinada unidade de trabalho pode funcionar economicamente a US$ 1.
Modelos chineses ampliam ainda mais a pressão porque oferecem uma alternativa real durante negociações comerciais.
Mesmo uma empresa que nunca pretenda trocar de fornecedor ganha poder quando pode demonstrar que existe uma opção tecnicamente aceitável custando menos.
O problema aparece para organizações que construíram aplicações fortemente presas a um único ecossistema.
Essas descobrirão que a guerra de preços beneficia principalmente quem consegue trocar de modelo.
Quem pode ficar para trás
Fornecedores pequenos de IA que não possuem escala, diferenciação ou acesso barato a computação enfrentam uma situação difícil.
Se modelos de alta qualidade ficam progressivamente mais baratos, vender apenas “acesso a uma IA” perde valor.
Também sofrem empresas que fizeram investimentos grandes em infraestrutura baseada numa expectativa de preço de inferência que cai mais rapidamente do que o previsto.
No mercado de software, existe ainda uma pressão silenciosa sobre produtos que cobravam caro por funcionalidades simples baseadas em IA.
Quando o custo de geração, classificação, resumo ou tradução despenca, o cliente começa a perguntar por que deveria continuar pagando um prêmio tão grande pela camada intermediária.
A guerra entre laboratórios pode acabar chegando à margem de centenas de startups.
O que quase ninguém está discutindo: inteligência está virando matéria-prima
Há alguns anos, acesso a um modelo de fronteira era tratado quase como uma vantagem estratégica em si.
Essa vantagem está diminuindo.
Quando vários fornecedores conseguem entregar níveis próximos de capacidade e APIs relativamente intercambiáveis, o modelo começa a se comportar como infraestrutura.
Ele continua importante.
Mas deixa de ser necessariamente o diferencial final.
O valor migra para dados próprios, integração, processos, experiência de usuário, distribuição e capacidade de escolher a inteligência certa para cada problema.
É semelhante ao que aconteceu com computação.
Possuir um servidor já foi vantagem competitiva.
Hoje, quase ninguém constrói uma empresa apenas dizendo que possui servidores.
A IA pode caminhar para o mesmo destino.
Análise da equipe
Chamar o momento atual apenas de “guerra de preços” simplifica demais uma transformação maior.
OpenAI e Anthropic não estão simplesmente tentando cobrar menos que DeepSeek ou Moonshot.
Elas estão reorganizando seus portfólios para defender o que ainda pode sustentar preço premium enquanto reduzem o custo das camadas em que a concorrência ficou difícil de ignorar.
O fato de o GPT-5.6 Luna ter sofrido um corte de 80% enquanto Sol permaneceu intacto explica mais sobre a estratégia da OpenAI do que qualquer declaração de marketing.
A mesma lógica aparece na Anthropic.
O topo continua caro.
O meio está sob pressão.
E a China tornou muito mais difícil justificar preços altos para tarefas em que uma diferença pequena de qualidade não produz diferença econômica equivalente.
A próxima batalha provavelmente não será vencida pelo laboratório que apresentar isoladamente o melhor modelo.
Será vencida por quem conseguir combinar capacidade, custo, latência, confiabilidade, disponibilidade, privacidade e facilidade de integração de maneira sustentável.
Para as empresas que consomem IA, isso produz uma recomendação arquitetônica quase inevitável: evitar construir sistemas que dependam desnecessariamente de um único fornecedor.
A melhor IA para resumir um documento pode não ser a melhor para escrever código.
A melhor para raciocínio científico pode ser desperdício em classificação de tickets.
A mais barata por token pode sair cara depois de várias tentativas.
E a mais cara pode valer cada centavo quando a tarefa é suficientemente importante.
O mercado está aprendendo uma lição que a computação em nuvem já ensinou há muito tempo.
Preço unitário é apenas uma parte da conta.
O que importa é quanto custa concluir o trabalho.
E talvez essa seja a mudança mais profunda provocada pela ascensão dos modelos chineses: eles não precisam necessariamente superar OpenAI e Anthropic em todos os benchmarks para transformar o mercado.
Basta serem bons o suficiente para tornar caro demais usar o melhor modelo em tudo.
👉 Dúvida? Então veja mais em: https://pixbugtech.com/linksuteis