noticias
OpenAI estreia Ultrafast: GPT-5.6 Sol chega a 750 tokens por segundo, mas novidade ainda não está no ChatGPT
**Categoria editorial:** Inteligência Artificial / Infraestrutura / Software
OpenAI estreia Ultrafast: GPT-5.6 Sol chega a 750 tokens por segundo, mas novidade ainda não está no ChatGPT
Matéria completa
A OpenAI colocou velocidade no centro de uma nova etapa da corrida pela inteligência artificial.
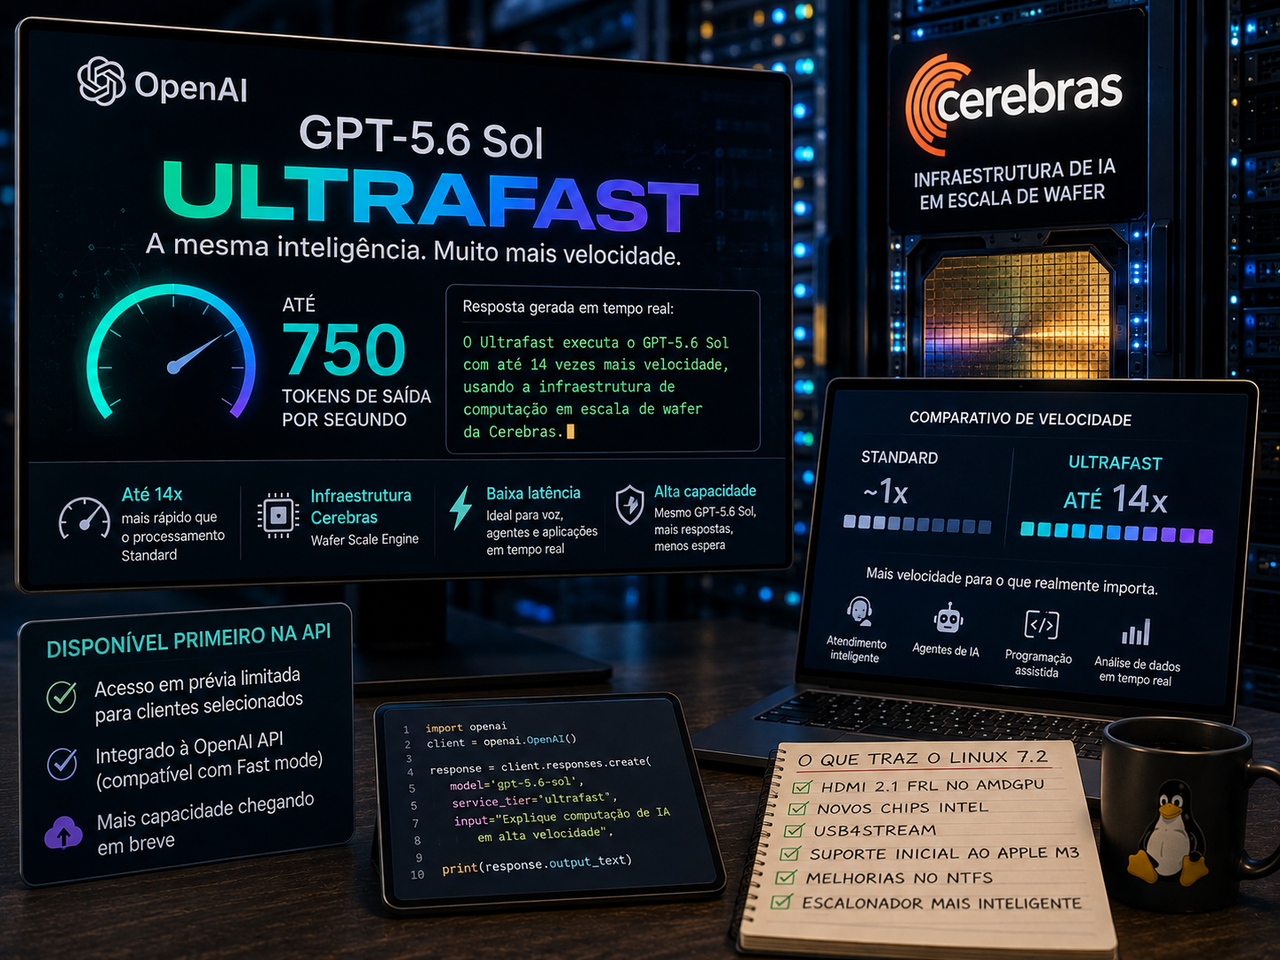
A empresa apresentou o **Ultrafast**, uma nova modalidade de processamento capaz de executar o GPT-5.6 Sol em velocidades anunciadas de até **750 tokens de saída por segundo**, chegando, segundo a companhia, a até **14 vezes a velocidade do processamento Standard**.
A novidade chamou atenção porque o GPT-5.6 Sol é justamente o modelo de maior capacidade da atual família da OpenAI. Até agora, uma das escolhas mais comuns na indústria consistia em recorrer a modelos menores quando a latência precisava cair.
O Ultrafast tenta modificar essa equação.
Em vez de trocar inteligência por velocidade, a proposta é executar o mesmo GPT-5.6 Sol sobre uma infraestrutura muito mais rápida.
Há, porém, uma correção importante em relação a algumas manchetes que começaram a circular: **o ChatGPT não recebeu um botão “Ultrafast” para todos os usuários**.
O lançamento de agosto de 2026 ocorre primeiro na **OpenAI API**, em uma prévia de acesso restrito a clientes selecionados.
A história, portanto, não é simplesmente que “o ChatGPT ficou 14 vezes mais rápido”.
É mais interessante que isso.
A OpenAI está começando a tratar a **velocidade de execução do mesmo modelo como um produto separado**.
O modelo é o mesmo; o que muda é a infraestrutura
Uma das maneiras mais simples de entender o Ultrafast é separar duas coisas que frequentemente aparecem misturadas: o modelo e a infraestrutura responsável por executá-lo.
O GPT-5.6 Sol continua sendo o GPT-5.6 Sol.
Sua arquitetura, capacidades e comportamento não precisam ser substituídos por um modelo menor para obter a nova velocidade.
O que muda é a camada de **inferência**.
Inferência é o momento em que um modelo já treinado recebe um pedido e efetivamente calcula sua resposta.
Cada token produzido exige operações matemáticas sobre os parâmetros da rede.
Em modelos grandes, esse processo envolve mover enormes quantidades de dados entre memória e unidades de processamento repetidas vezes.
É aí que diferenças de arquitetura de hardware começam a importar muito.
O Ultrafast é executado sobre infraestrutura da **Cerebras**, empresa que passou anos desenvolvendo uma abordagem bastante diferente das GPUs convencionais utilizadas em grande parte da indústria de IA.
O que significa gerar 750 tokens por segundo
“Tokens por segundo” virou uma das medidas mais utilizadas para comparar a velocidade de modelos de linguagem.
Um token não corresponde exatamente a uma palavra.
Pode representar uma palavra inteira, parte dela, um símbolo ou outra unidade reconhecida pelo modelo.
Quando uma IA começa a responder, os tokens são produzidos sequencialmente e transformados no texto que aparece na tela.
Uma taxa de 750 tokens de saída por segundo significa que, uma vez iniciada a geração, uma resposta relativamente longa pode ser produzida em uma fração do tempo necessário em sistemas convencionais.
Para uma pessoa lendo uma conversa comum, chega um momento em que isso deixa de fazer tanta diferença.
Nenhum usuário consegue acompanhar centenas de tokens aparecendo a cada segundo.
Para software, a situação muda completamente.
Um agente pode receber a resposta e imediatamente executar a próxima ação.
É aí que velocidade deixa de ser conforto visual e passa a alterar o funcionamento de aplicações inteiras.
Os 14 vezes mais rápidos precisam ser lidos com cuidado
A OpenAI afirma que o Ultrafast pode executar o GPT-5.6 Sol em velocidade **até 14 vezes superior ao processamento Standard**.
O “até” merece permanecer na frase.
Desempenho de modelos não depende apenas de quantos tokens aparecem por segundo.
Existe o tempo até o primeiro token.
Existe o processamento do prompt.
Há tarefas nas quais o modelo utiliza ferramentas externas.
Pode ser necessário consultar bancos de dados, pesquisar documentos, executar código ou esperar por outro serviço.
A rede também adiciona latência.
Em aplicações com agentes, uma tarefa pode possuir dezenas de etapas.
Por isso, 14 vezes mais tokens por segundo não significam automaticamente que qualquer trabalho ficará exatamente 14 vezes mais rápido do início ao fim.
A própria Cerebras divulgou testes em que o ganho de tempo completo variou conforme a carga analisada.
Em uma avaliação de tarefas de conhecimento profissional, a empresa reportou aceleração de aproximadamente 5,6 vezes no tempo total utilizando o mesmo GPT-5.6 Sol.
É um resultado expressivo, mas também é um benchmark realizado pela companhia que fornece a infraestrutura.
Medições independentes e experiências de produção serão importantes conforme o acesso aumentar.
Por que o hardware da Cerebras é diferente
A indústria de inteligência artificial cresceu principalmente sobre GPUs.
Esses chips foram desenvolvidos originalmente para processamento gráfico, mas sua enorme capacidade de executar operações matemáticas em paralelo fez deles peças fundamentais para treinamento e inferência de redes neurais.
A Cerebras escolheu outro caminho.
Sua arquitetura utiliza processadores construídos em escala de wafer, criando chips muito maiores que os processadores convencionais encontrados em placas de servidores.
A ideia central é reduzir um dos grandes gargalos da IA moderna: movimentar dados entre diferentes componentes.
Quanto mais tempo um sistema passa transportando pesos do modelo entre memória e unidades de processamento, menos tempo passa realizando os cálculos propriamente ditos.
A Cerebras tenta manter enormes quantidades de processamento e memória muito próximas fisicamente.
Isso pode favorecer cargas nas quais baixa latência é mais importante do que simplesmente maximizar quantas solicitações podem ser agrupadas.
O Ultrafast transforma essa arquitetura em algo que desenvolvedores da OpenAI poderão consumir sem necessariamente precisar administrar diretamente a infraestrutura da Cerebras.
OpenAI e Cerebras não começaram essa relação agora
O lançamento também precisa ser visto como parte de uma estratégia de infraestrutura maior.
OpenAI e Cerebras anunciaram no início de 2026 uma parceria de longo prazo para expandir capacidade de inferência utilizando sistemas de escala de wafer.
O plano envolve centenas de megawatts de infraestrutura sendo implantados em diferentes etapas.
Esse movimento revela uma mudança importante na corrida por IA.
Durante boa parte da explosão dos modelos generativos, a discussão sobre hardware esteve praticamente associada a uma palavra: GPU.
O crescimento do mercado agora está estimulando arquiteturas especializadas.
Cerebras, Groq e outras empresas tentam demonstrar que determinadas cargas podem ser executadas de maneira mais eficiente em sistemas criados especificamente para inferência.
A OpenAI não precisa abandonar GPUs para aproveitar isso.
Ela pode utilizar diferentes tipos de hardware conforme o trabalho.
A nuvem de IA pode começar a funcionar como um menu de velocidades
Esse talvez seja o aspecto economicamente mais interessante do Ultrafast.
Durante anos, desenvolvedores escolhiam principalmente **qual modelo utilizar**.
Um modelo maior oferecia mais capacidade e geralmente mais custo e latência.
Um modelo menor era rápido e barato, porém menos competente em problemas difíceis.
Agora aparece outra dimensão.
O mesmo modelo pode ser oferecido em diferentes classes de execução.
É semelhante ao que serviços de nuvem já fazem com armazenamento, redes e máquinas virtuais.
Uma aplicação sem urgência pode utilizar infraestrutura mais barata.
Uma tarefa crítica pode pagar mais para receber resposta prioritária ou ultrarrápida.
A inteligência vira uma coisa.
A velocidade com que ela é entregue vira outra.
Ultrafast não é a mesma coisa que Fast mode
A nomenclatura da OpenAI pode causar confusão.
A API já possui uma modalidade chamada **Fast mode**, nome adotado para o que anteriormente era chamado de Priority Processing.
Ela permite enviar determinadas requisições para uma classe de processamento mais rápida, mediante cobrança premium.
Ultrafast é outra camada.
A documentação da API identifica explicitamente solicitações processadas pelo novo serviço como `ultrafast`, e o acesso continua controlado.
Em termos práticos, há uma escada começando a surgir.
Processamento padrão para cargas comuns.
Fast para aplicações que querem menor latência e maior consistência.
Ultrafast para situações nas quais esperar alguns segundos pode alterar o próprio valor da aplicação.
A segmentação provavelmente também será econômica.
No lançamento, porém, a OpenAI ainda não apresentou uma tabela pública ampla de preços específica para o Ultrafast.
Voz é uma das aplicações em que milissegundos importam
Conversar com um chatbot em texto tolera alguma espera.
Uma conversa por voz, não.
Pessoas percebem atrasos muito pequenos durante um diálogo.
Quando alguém termina de falar e o sistema leva vários segundos para responder, a conversa começa a parecer artificial.
Esse problema fica ainda pior quando a IA precisa fazer algo complexo antes de falar.
Imagine um atendente virtual que precise ouvir a pergunta, consultar o cadastro do cliente, verificar um pagamento, entender uma política interna e formular uma resposta.
Cada etapa adiciona tempo.
Um modelo mais veloz permite incluir mais raciocínio dentro do intervalo que o usuário ainda considera natural.
É por isso que a OpenAI cita atendimento e voz entre os primeiros casos de uso do Ultrafast.
Programação também muda quando a IA consegue acompanhar o desenvolvedor
Agentes de programação são outro caso evidente.
Hoje, muitas ferramentas conseguem analisar repositórios, modificar arquivos, executar testes e investigar erros.
O problema é que cada ciclo pode levar tempo.
O agente lê.
Pensa.
Edita.
Compila.
Recebe um erro.
Analisa novamente.
Corrige.
Quanto mais rápido o modelo responde dentro dessa sequência, maior o número de ciclos possíveis no mesmo período.
Isso muda a experiência.
Em vez de solicitar uma tarefa e esperar o agente concluir uma operação longa, o programador pode trabalhar de maneira mais interativa.
A OpenAI afirma que já testa Ultrafast internamente em situações como resposta a incidentes, análise de logs e investigação de falhas enquanto sistemas continuam operando.
Aqui a velocidade possui valor direto.
Cinco minutos durante uma indisponibilidade de produção podem custar muito mais que cinco minutos durante uma tarefa comum.
Cibersegurança talvez seja um dos casos mais delicados
Velocidade também tem consequências importantes para segurança.
Quando um incidente acontece, equipes precisam correlacionar logs, mudanças recentes de código, alertas, comportamento de rede e informações provenientes de várias ferramentas.
Um modelo capaz de processar rapidamente esse volume pode reduzir o intervalo entre detectar um problema e formular uma hipótese útil.
Isso beneficia defensores.
Também existe o outro lado.
Modelos muito rápidos reduzem o custo temporal de executar ciclos automatizados de análise, tentativa e adaptação.
A capacidade ofensiva dependerá das proteções aplicadas aos modelos, das ferramentas disponíveis e dos controles de acesso.
Mas a equação é simples: acelerar inteligência também acelera alguns usos indesejados dessa inteligência.
O ganho talvez seja maior para agentes que para chatbots
Existe uma diferença fundamental entre uma pessoa utilizando ChatGPT e uma aplicação que chama um modelo centenas de vezes.
Em uma conversa, reduzir uma resposta de oito segundos para um pode ser agradável.
Em um agente que realiza 100 chamadas sequenciais, a economia acumulada pode transformar minutos em segundos.
Isso permite arquiteturas que anteriormente eram pouco práticas.
Um agente pode gerar cinco hipóteses, testá-las, comparar resultados e voltar ao modelo várias vezes antes que o usuário perceba uma espera significativa.
A IA deixa de funcionar apenas como geradora de resposta.
Passa a participar de um loop computacional.
É aqui que 750 tokens por segundo começa a significar algo maior que uma demonstração impressionante.
A velocidade também pode fazer a conta crescer muito rápido
Há uma consequência econômica quase óbvia.
Quando sistemas ficam mais rápidos, conseguem consumir recursos mais rapidamente.
Um desenvolvedor que antes fazia dez interações durante determinado período pode passar a realizar cem.
Agentes podem executar muito mais etapas.
Aplicações em tempo real podem manter modelos ativos continuamente.
Isso significa que maior velocidade não equivale automaticamente a menor custo.
Pode ocorrer exatamente o contrário.
A infraestrutura deixa de limitar o consumo, e o orçamento passa a fazer esse papel.
Para empresas, o indicador correto não será apenas tokens por segundo.
Será **custo por tarefa útil concluída**.
Se o Ultrafast custa mais, mas permite concluir um processo crítico muito mais rapidamente, a conta pode fazer sentido.
Se o trabalho poderia esperar alguns minutos, pagar pela velocidade máxima seria desperdício.
O ChatGPT comum vai receber isso?
A OpenAI não anunciou o Ultrafast como uma opção geral do ChatGPT.
O comunicado é explícito ao dizer que o lançamento acontece **primeiro na API**.
A empresa afirma que pretende usar o aprendizado obtido com os clientes iniciais para orientar seus produtos conforme a capacidade aumenta.
Isso deixa aberta a possibilidade de tecnologias semelhantes aparecerem futuramente em produtos voltados ao consumidor.
Mas transformar essa possibilidade em promessa seria especulação.
Hoje, um assinante do ChatGPT não deve procurar nas configurações por um botão “Ultrafast”.
Ele não existe como recurso geral anunciado para o aplicativo.
Essa distinção é especialmente importante porque a palavra ChatGPT costuma ser utilizada informalmente como sinônimo de qualquer tecnologia produzida pela OpenAI.
Não é.
ChatGPT é um produto.
GPT-5.6 Sol é um modelo.
A API é uma plataforma para desenvolvedores.
Ultrafast é uma classe de processamento dessa plataforma.
Misturar tudo facilita manchetes.
Dificulta entender a tecnologia.
Mais velocidade não significa mais inteligência
Outro ponto merece ser separado.
Ultrafast não torna o GPT-5.6 Sol automaticamente mais inteligente.
Ele torna sua execução mais rápida.
Se duas solicitações usam o mesmo modelo, os mesmos parâmetros e condições equivalentes, a proposta é preservar a capacidade enquanto reduz a latência.
Esse detalhe distingue o Ultrafast de estratégias que escolhem um modelo menor para responder rapidamente.
É justamente o argumento comercial da OpenAI e da Cerebras.
O usuário não precisaria escolher entre um cérebro melhor e uma resposta rápida.
Mas até essa afirmação precisa ser observada em produção.
Infraestrutura extremamente rápida só possui valor se conseguir preservar estabilidade, disponibilidade e comportamento consistente sob carga.
Uma demonstração de 750 tokens por segundo é impressionante.
Milhares de aplicações tentando obter a mesma velocidade simultaneamente formam um problema muito diferente.
Capacidade limitada revela o desafio
A própria OpenAI não abriu imediatamente o Ultrafast para todos os desenvolvedores.
A modalidade está em prévia limitada para um grupo selecionado.
A justificativa é capacidade.
Isso mostra uma realidade frequentemente esquecida quando falamos de IA como se fosse apenas software.
Modelos generativos dependem de infraestrutura física.
Chips precisam ser fabricados.
Sistemas precisam ser instalados.
Data centers precisam fornecer energia.
Redes precisam transportar dados.
Equipamentos precisam ser resfriados.
Se a demanda cresce mais rapidamente que essa infraestrutura, não existe atualização de software capaz de criar capacidade física instantaneamente.
A inteligência pode estar na nuvem.
Os servidores continuam no chão.
Análise da equipe
O Ultrafast parece, à primeira vista, uma atualização simples: o mesmo modelo, só que muito mais rápido.
Na prática, ele aponta para uma mudança importante na economia da IA.
Durante os primeiros anos da corrida generativa, empresas competiram principalmente por inteligência.
Quem respondia melhor?
Quem programava melhor?
Quem resolvia mais benchmarks?
Quem possuía mais parâmetros?
A próxima disputa adiciona outra pergunta.
**Quanto tempo essa inteligência demora para chegar?**
Quando modelos ficam suficientemente competentes, latência passa a ser parte da capacidade.
Um agente que possui a resposta correta depois de 40 segundos pode ser inútil em uma conversa telefônica.
Uma IA que detecta uma fraude depois que a transação terminou pode ter inteligência suficiente e velocidade insuficiente.
Um sistema que consegue diagnosticar uma indisponibilidade em dez minutos compete de maneira diferente daquele que realiza análise equivalente em segundos.
Velocidade modifica quais problemas são economicamente possíveis.
Mas há outro ponto ainda mais interessante.
O Ultrafast mostra que o futuro da IA talvez não seja dominado por um único tipo de chip.
GPUs continuarão enormes.
A demanda é grande demais e seu ecossistema é maduro demais para desaparecer.
Mas arquiteturas especializadas podem capturar cargas nas quais latência, memória e comunicação entre componentes possuem características específicas.
A parceria entre OpenAI e Cerebras transforma essa hipótese em infraestrutura de produção.
Isso aumenta a pressão sobre Nvidia e outros fornecedores sem significar que qualquer um deles esteja prestes a ser substituído.
Concorrência de arquitetura é provavelmente saudável para um setor que passou anos extremamente concentrado.
O que quase ninguém discute: a IA pode ficar rápida demais para nossa supervisão
Existe também uma consequência menos confortável.
Grande parte da segurança atual de agentes pressupõe algum intervalo entre ações.
Um sistema propõe uma alteração.
O humano verifica.
O sistema executa.
Quanto mais rápidas se tornam as cadeias de decisão, maior a tentação de retirar a pessoa desse circuito para aproveitar toda a velocidade disponível.
Se um agente consegue analisar, decidir e agir centenas de vezes em poucos segundos, pedir aprovação humana em cada etapa elimina boa parte do ganho.
Isso cria uma pressão econômica pela autonomia.
E autonomia rápida exige controles muito melhores.
Limites de permissão.
Ambientes isolados.
Registro detalhado de ações.
Capacidade de interromper processos.
Validação independente para operações críticas.
A questão deixa de ser apenas quão rápido conseguimos fazer uma IA pensar.
Passa a ser quão rápido estamos dispostos a deixá-la agir.
O que deve ser acompanhado agora
O primeiro ponto será a expansão do acesso.
A OpenAI afirma que disponibilizará o Ultrafast para mais clientes conforme a capacidade da infraestrutura crescer.
O segundo será o preço.
Sem uma tabela pública ampla específica para essa modalidade no lançamento, ainda não é possível avaliar em quais cargas o ganho de velocidade compensará economicamente.
O terceiro será o desempenho independente.
Tokens por segundo são apenas uma métrica.
Testes reais precisarão observar tempo até o primeiro token, duração completa da tarefa, estabilidade, concorrência, uso de ferramentas e custo por trabalho concluído.
O quarto será a chegada dessa tecnologia a produtos voltados diretamente ao usuário.
A OpenAI pode aproveitar o Ultrafast em futuras experiências de ChatGPT, Codex, voz ou agentes.
Por enquanto, porém, isso não foi prometido como disponibilidade geral.
O lançamento de agosto de 2026 é mais específico — e talvez mais importante — do que simplesmente acelerar uma caixa de conversa.
A OpenAI está começando a vender não apenas inteligência computacional.
Está começando a vender **tempo**.
E, para muitos sistemas, alguns segundos podem valer mais do que alguns bilhões de parâmetros.
👉 Dúvida? Então veja mais em: https://pixbugtech.com/linksuteis