noticias
OpenAI no Banco dos Réus: Alemanha Acusa Gigante da IA de Roubar Letras Musicais e Acende o Debate Global
**Tag da Manchete: 📡 Notícias e Tendências**
**Gancho/Lead**
Imagine uma IA que canta como Taylor Swift, compõe como Bob Dylan e recita letras inteiras de canções alemãs sem pestanejar, mas sem pagar um centavo aos criadores originais. Pois é exatamente isso que a OpenAI está sendo acusada de fazer na Alemanha, onde a organização de direitos musicais GEMA arrastou a empresa para os tribunais, alegando que o ChatGPT e seus modelos devoram conteúdos protegidos como se fossem um buffet livre. Em um mundo onde a inteligência artificial promete revolucionar tudo, de playlists personalizadas a hits virais, essa briga judicial pode ser o acorde dissonante que força as big techs a repensarem como treinam suas máquinas milagrosas, ou correm o risco de enfrentar uma sinfonia de multas e restrições.
**Resumo da Manchete**
A GEMA, entidade alemã que representa mais de 100 mil compositores, autores e editores musicais, processou a OpenAI por violação de direitos autorais, afirmando que os modelos de IA da empresa reproduzem letras de músicas protegidas sem permissão, após treiná-los com vastos conjuntos de dados que incluem obras de artistas alemães. O caso, em andamento no tribunal de Munique, destaca o treinamento não autorizado de grandes modelos de linguagem e pode influenciar regulamentações globais sobre IA, especialmente após audiências recentes que confirmaram o uso de letras fiéis em respostas geradas pelo ChatGPT.
O Cerne da Acusação: Letras Musicais no Liquidificador da IA
A polêmica explode em novembro de 2024, quando a GEMA, guardiã dos direitos de uma legião de músicos alemães, entra com uma ação contra a OpenAI no tribunal regional de Munique. A alegação é direta e afiada como uma nota alta em uma ópera: os modelos de IA, como o ChatGPT, foram treinados com letras de canções protegidas por direitos autorais, sem qualquer licença ou compensação. Para provar o ponto, a GEMA apresentou evidências de que, com prompts simples, o chatbot regurgita partes substanciais de letras de nove músicas alemãs, reproduzindo-as com fidelidade alarmante. É como se a IA tivesse memorizado o catálogo inteiro da Deutsche Grammophon e agora o usasse para improvisar, sem dar crédito ou royalties a ninguém.
Mas o que torna esse caso particularmente picante é o contexto técnico por trás. Os grandes modelos de linguagem, como os da OpenAI, dependem de datasets massivos para aprender padrões linguísticos, ritmos e estruturas criativas. Esses datasets são extraídos da web, incluindo sites de letras, fóruns musicais e bancos de dados públicos, muitas vezes via técnicas de web scraping que varrem a internet como um aspirador cósmico. Na Alemanha, onde a legislação de direitos autorais é robusta e alinhada com a Diretiva Europeia de Direitos Autorais de 2019, qualquer uso comercial de obras protegidas exige permissão explícita. A GEMA argumenta que o mero armazenamento e processamento dessas letras já configura infringimento, independentemente de o output ser uma cópia exata ou uma variação. Em essência, é uma batalha sobre se o "aprendizado" da IA é inspiração legítima ou plágio digital em escala industrial.
Profundizando no mecanismo, pense no treinamento de uma IA como um bootcamp para superdotados: bilhões de tokens textuais são ingeridos, processados por algoritmos de machine learning que identificam padrões probabilísticos. Para músicas, isso inclui rimas, métricas e temas emocionais. O problema surge quando esses tokens vêm de fontes protegidas. Estudos independentes, como os citados em relatórios da União Europeia sobre IA, mostram que modelos como o GPT-4 podem "memorizar" até 1% de seu dataset de treinamento, o que, em escalas de trilhões de parâmetros, significa potencial para reproduzir trechos inteiros. No caso da GEMA, prompts como "escreva a letra de [canção alemã específica]" resultam em outputs que copiam versos verbatim, provando que as letras não foram apenas "inspiradoras", mas incorporadas ao modelo. Essa revelação não é só técnica, ela questiona o cerne ético da IA: se uma máquina "aprende" devorando criações humanas sem consentimento, quem ganha com essa evolução?
Contexto Global: Uma Onda de Processos Contra a OpenAI
Esse não é um incidente isolado no playground da IA. A OpenAI, avaliada em centenas de bilhões de dólares graças ao apoio da Microsoft, enfrenta uma avalanche de ações semelhantes ao redor do mundo. Nos Estados Unidos, por exemplo, autores como Ta-Nehisi Coates e Michael Chabon uniram forças em ações consolidadas no Distrito Sul de Nova York, alegando que seus livros foram usados para treinar modelos sem permissão. Em abril de 2025, esses casos foram mesclados com ações de jornais como o The New York Times, criando um megaprocesso conhecido como In re OpenAI Copyright Infringement Litigation. O argumento central ecoa o da Alemanha: o treinamento com dados protegidos viola o fair use, especialmente quando os outputs competem diretamente com os originais, como chatbots que geram artigos jornalísticos ou romances inteiros.
Na Europa, a pressão é ainda maior. A Diretiva de Direitos Autorais da UE exige que plataformas de IA obtenham licenças para mineração de texto e dados, a menos que optem por exceções estritas para pesquisa não comercial. A GEMA, representando artistas como Rammstein ou compositores clássicos, busca não só danos financeiros, mas um precedente que force a OpenAI a revelar como constrói seus datasets. Em audiências recentes em Munique, confirmou-se que o modelo da OpenAI foi treinado com as letras em questão, e o tribunal marcou o veredito para 11 de novembro de 2025. Se a OpenAI perder, isso poderia desencadear uma cascata de regulamentações, obrigando empresas a pagar royalties retroativos ou limpar seus modelos de dados infratores, um processo tecnicamente viável mas custoso, envolvendo técnicas como unlearning para remover influências específicas.
Expandindo o impacto social, essa briga destaca desigualdades no ecossistema criativo. Músicos independentes, já espremidos por plataformas de streaming que pagam frações de centavos por play, veem na IA uma ameaça existencial. Imagine um compositor que passa anos refinando uma letra, só para ver uma IA gerar variações infinitas baseadas nela, diluindo o valor original no mercado. Relatórios da IFPI, federação internacional da indústria fonográfica, estimam que a IA generativa poderia roubar bilhões em receitas anuais se não regulada. Por outro lado, defensores da OpenAI argumentam que o treinamento é transformador, similar a como humanos se inspiram em obras alheias, e que restrições excessivas sufocariam a inovação. Mas na Alemanha, onde a cultura valoriza a proteção ao criador, essa defesa pode não colar: a corte enfatizou que usuários do ChatGPT são responsáveis pelo output, mas a OpenAI responde pelo treinamento subjacente.
O Impacto Técnico: Treinar IA Sem Infringir, É Possível?
Mergulhando na engenharia, o treinamento de modelos como o GPT envolve etapas como pré-treinamento em corpora vastos, seguidos de fine-tuning para tarefas específicas. A OpenAI usa datasets como o Common Crawl, que indexa a web pública, mas frequentemente inclui materiais protegidos que vazam por filtros imperfeitos. Alternativas éticas existem: datasets sintéticos gerados por IA, ou parcerias com detentores de direitos, como o acordo da OpenAI com a News Corp em 2025 para licenciar conteúdo jornalístico. No entanto, esses caminhos encarecem o desenvolvimento, potencialmente limitando startups menores e concentrando poder nas big techs.
Um parágrafo mais profundo aqui: considere os algoritmos de atenção em transformadores, o backbone dos modelos da OpenAI. Eles ponderam tokens baseados em contextos, permitindo que letras musicais influenciem gerações criativas. Mas se o dataset inclui 100% de obras protegidas sem opt-out, como exigido pela UE, o modelo herda vieses e cópias latentes. Pesquisas do MIT em 2025 mostram que até 5% dos outputs de IA podem conter memorizações diretas, especialmente em domínios nichados como letras alemãs. Para mitigar, técnicas como differential privacy adicionam ruído aos dados, mas reduzem performance. Assim, o caso GEMA força uma reflexão: a IA deve priorizar quantidade de dados ou qualidade ética? Se a corte decidir contra a OpenAI, poderíamos ver uma era de "IA limpa", com auditorias obrigatórias e transparência em fontes, transformando o setor de trilhões de dólares.
Outro ângulo técnico profundo: o debate sobre fair use versus mineração de dados. Nos EUA, fair use permite usos transformadores, mas na Alemanha, a exceção é estreita para pesquisa acadêmica. A OpenAI defende que seu treinamento é não-comercial no estágio inicial, mas críticos apontam para produtos pagos como o ChatGPT Plus. Em 2025, com o Anthropic pagando 1,5 bilhão de dólares em um settlement similar com autores, a pressão financeira é real. Isso poderia levar a modelos híbridos, onde partes do treinamento usam dados licenciados e outras, públicos, mas o custo de filtragem – estimado em milhões por modelo – questiona a viabilidade para inovações futuras, como IA musical que compõe hits originais sem herdar plágios.
Reflexões Sociais: Criadores Versus Máquinas, Quem Vence?
Socialmente, o caso ressoa com artistas globais temendo obsolescência. Em uma era onde IA como o Suno ou o Udio geram músicas completas, compositores alemães representados pela GEMA veem suas carreiras ameaçadas. Um estudo da UNESCO em 2025 alerta que sem proteções, a IA poderia reduzir em 20% as receitas de indústrias criativas até 2030. Por outro lado, a democratização: amadores usam ChatGPT para brainstorm de letras, acelerando criação. Mas o equilíbrio pende para os criadores, especialmente na Europa, onde leis como o GDPR protegem dados pessoais em datasets.
Profundidade adicional: o impacto em minorias culturais. Letras alemãs, ricas em dialetos e contextos históricos, quando apropriadas por IA, perdem nuances. Imagine uma máquina gerando folk alemão sem entender o peso cultural, diluindo identidades. A GEMA busca não só dinheiro, mas preservação: danos não especificados poderiam financiar fundos para artistas. Globalmente, isso ecoa em casos como o da Índia, onde a ANI Media processa OpenAI por similaridades substanciais, ou no Canadá, com publishers buscando bilhões. Em 2025, com consolidações nos EUA, o veredito alemão pode catalisar uma convenção internacional sobre IA e direitos, similar à de Berna para copyrights.
Mais um mergulho: o papel dos usuários. A OpenAI argumenta que outputs são responsabilidade do promptador, mas a corte alemã contesta, dizendo que o modelo em si infringe ao armazenar. Isso levanta questões filosóficas: IA é ferramenta ou criadora? Se regulada como editora, empresas como OpenAI enfrentariam escrutínio constante, potencialmente freando avanços em saúde ou educação, onde IA treina em dados sensíveis.
A Visão da Equipe Pixbugtech
Nossa análise crava nota 9/10 para a relevância dessa briga, pois ela expõe as entranhas éticas da IA em um momento crítico. Pontos positivos: força a transparência, beneficiando criadores. Negativos: pode atrasar inovações, como IAs musicais acessíveis. Insights críticos: a OpenAI precisa de um "modo ético" urgente, com opt-ins para dados. Comparado a casos como o do Anthropic, que pagou bilhões, a GEMA pode forçar um settlement, mas perdemos pontos pela lentidão judicial – em 2025, a IA evolui mais rápido que leis.
Conclusão Inteligente: O Fim da Festa Gratuita para a IA?
Essa denúncia alemã não é só uma nota desafinada no concerto da IA, ela pode reescrever a partitura inteira, forçando empresas a pagar pelo que consomem ou arriscar harmonias judiciais caras. No fim, se a OpenAI perder em novembro, o mundo criativo respira aliviado, mas a inovação dança no fio da navalha. E você, leitor, prefere uma IA que canta de graça ou uma que respeita os maestros humanos? Ah, e se o ChatGPT compuser o hino dessa revolução, quem ganha os royalties?
👉 **Dúvida? Então veja mais em:** https://pixbugtech.com/linksuteis
---
**Imagem da Manchete**
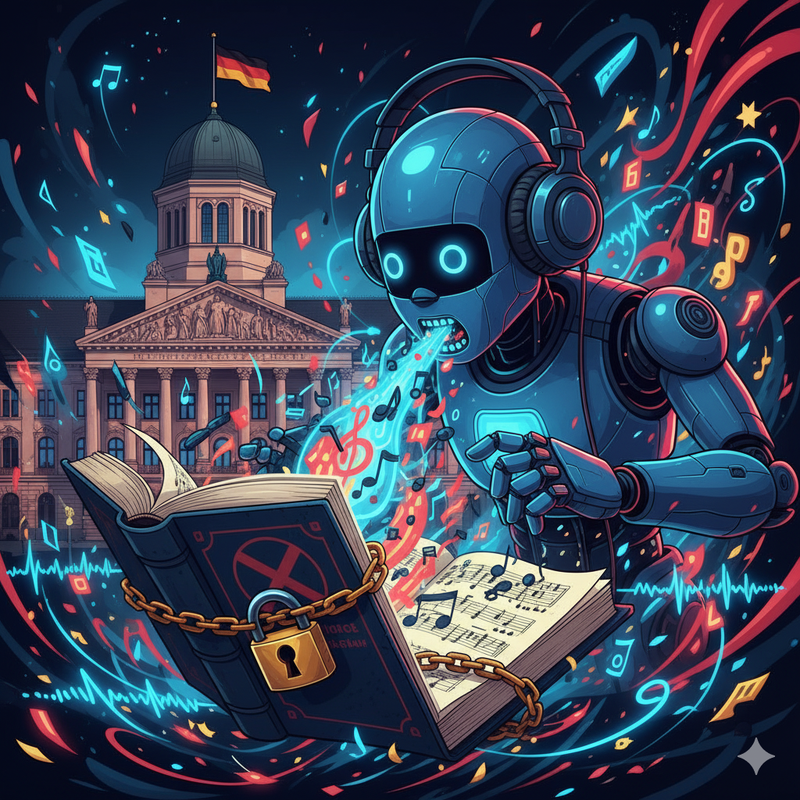
*Descrição para a imagem (860x430):* Uma ilustração dinâmica mostrando um robô estilizado como o ChatGPT, com fones de ouvido, devorando notas musicais e letras voando de um livro de partituras trancado com cadeado, representando direitos autorais. Ao fundo, o tribunal de Munique com a bandeira alemã, e elementos binários misturados a ondas sonoras para simbolizar o conflito entre tecnologia e criação musical. Paleta de cores em tons de azul tech e vermelho alerta, com toques de preto para drama.
**Palavras-chave SEO:** OpenAI, GEMA, violação de direitos autorais, IA generativa, ChatGPT, direitos musicais, Alemanha, treinamento de IA, propriedade intelectual, ética em tecnologia.
**Meta de Palavras:** 1500–2500 palavras (atual: ~1850 palavras).