noticias
Ox Alpha: modelo gratuito de IA chama atenção, mas ninguém sabe quem está por trás dele
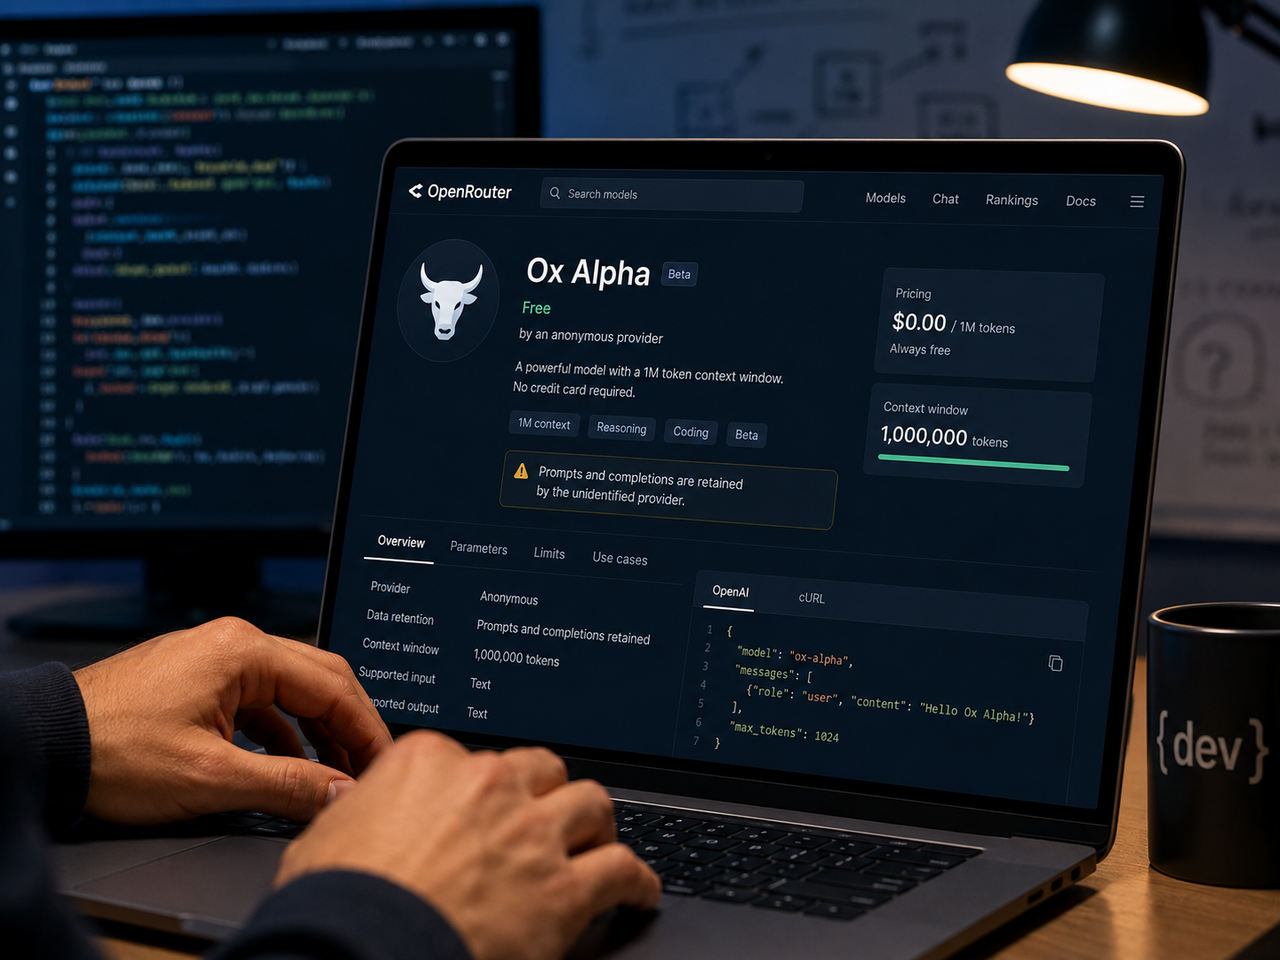
**Categoria editorial:** Inteligência Artificial
Ox Alpha: modelo gratuito de IA chama atenção, mas ninguém sabe quem está por trás dele
**Linha fina:** Com mais de 1 milhão de tokens de contexto e foco em programação e agentes, modelo apareceu no OpenRouter sem revelar seu desenvolvedor — e com uma política de retenção de dados que merece atenção.
**Meta description:** Ox Alpha oferece IA gratuita com contexto de 1 milhão de tokens e foco em programação, mas seu fornecedor anônimo mantém prompts e respostas dos usuários.
**Slug:** ox-alpha-ia-anonima-openrouter
**Palavra-chave principal:** Ox Alpha
Matéria completa
Um modelo de inteligência artificial pode ser tecnicamente interessante por vários motivos: qualidade das respostas, velocidade, preço, capacidade de trabalhar com arquivos extensos ou eficiência em programação. O **Ox Alpha** conseguiu acrescentar outro ingrediente à lista: ninguém sabe publicamente qual empresa está por trás dele.
O modelo apareceu no OpenRouter como uma oferta *stealth*, expressão usada para sistemas colocados em circulação antes de o desenvolvedor revelar sua identidade. Está disponível gratuitamente, possui janela de contexto de **1.048.576 tokens** e é apresentado pela própria plataforma como uma IA voltada a raciocínio, programação, tarefas prolongadas de engenharia de software e fluxos executados por agentes.
Essa combinação bastou para transformá-lo rapidamente em objeto de testes e especulações entre desenvolvedores.
O problema é que a parte mais importante dessa história talvez não seja descobrir se o Ox Alpha pertence a um grande laboratório americano, chinês ou a algum concorrente menos conhecido.
É descobrir quem está recebendo os dados enviados para ele.
Muito contexto, nenhuma assinatura
A ficha técnica do Ox Alpha é suficiente para explicar parte do interesse.
Uma janela superior a 1 milhão de tokens permite colocar dentro da mesma sessão uma quantidade excepcionalmente grande de informação. Dependendo do conteúdo, isso pode significar dezenas de arquivos de código, documentação extensa, registros de execução, especificações de produto e históricos de alterações sendo analisados sem a necessidade de quebrar continuamente o trabalho em pequenas partes.
Para agentes de programação, essa capacidade é especialmente atraente.
Um agente tentando corrigir um sistema real precisa acompanhar relações entre arquivos, dependências, erros anteriores, decisões tomadas durante a execução e resultados de ferramentas externas. Quanto menor o contexto disponível, maior a necessidade de resumir ou descartar informações antigas.
O Ox Alpha tenta trabalhar justamente no extremo oposto dessa limitação.
Mas existe um detalhe que merece ser repetido sempre que fabricantes transformam a quantidade de tokens em argumento comercial: **contexto grande não significa compreensão perfeita**.
Um modelo pode aceitar 1 milhão de tokens e ainda assim perder informações relevantes, confundir relações entre trechos distantes ou concentrar atenção apenas em partes específicas da entrada.
A capacidade de carregar uma biblioteca inteira não garante que alguém tenha lido todos os livros corretamente.
O Ox Alpha parece ter sido feito para agentes, não para conversa casual
O posicionamento do modelo ajuda a compreender melhor sua arquitetura de uso.
O OpenRouter o descreve como um sistema voltado a programação, raciocínio complexo e trabalhos agentivos prolongados. Isso significa que seu terreno mais interessante não é necessariamente responder perguntas em uma janela de chat.
Agentes de IA trabalham em ciclos.
O modelo recebe uma tarefa, analisa o estado do problema, escolhe uma ferramenta, executa uma ação, observa o resultado e decide o próximo passo. Em programação, isso pode significar abrir arquivos, modificar código, executar testes, interpretar erros e tentar novamente.
Quanto maior a duração desse processo, mais informação precisa permanecer disponível.
É exatamente aí que uma janela de contexto muito grande pode produzir vantagens concretas.
Ainda assim, especificações não substituem avaliação independente.
Relatos positivos de desenvolvedores ajudam a mostrar que o modelo merece investigação, mas não permitem afirmar que ele seja superior a Claude, Gemini, GPT, GLM, Qwen ou qualquer outro sistema de ponta.
Sem metodologia comparável, a internet continua fazendo aquilo que sabe fazer com extraordinária eficiência: transformar algumas experiências impressionantes em campeonato mundial antes mesmo de existir regulamento.
Quem criou o Ox Alpha?
Até o momento, não existe uma resposta pública confirmada.
O OpenRouter identifica o desenvolvedor apenas como um fornecedor terceirizado que decidiu permanecer anônimo durante a fase de prévia. A plataforma também faz questão de esclarecer que funciona como intermediária e não é a desenvolvedora nem proprietária do modelo.
A ausência de um nome disparou uma pequena investigação coletiva.
Desenvolvedores passaram a comparar padrões de tokenização, comportamento das respostas, mensagens de erro e outras características técnicas com modelos conhecidos. Entre as hipóteses que circulam estão possíveis ligações com famílias de modelos chineses e sistemas desenvolvidos por grandes laboratórios ocidentais.
São indícios, não provas.
Um tokenizador semelhante pode indicar parentesco tecnológico, mas também pode resultar da reutilização de componentes. Mensagens de erro podem revelar aspectos da infraestrutura de serviço sem necessariamente denunciar quem treinou o modelo.
Até que o responsável se identifique ou apareçam documentos verificáveis, qualquer atribuição permanece especulação.
O mistério funciona como estratégia de produto
A prática de lançar modelos sem identidade não é apenas uma brincadeira de marketing.
Existe lógica técnica.
Se o nome de uma grande empresa aparece antes do primeiro teste, a expectativa do usuário já está contaminada. Um modelo associado a uma marca respeitada tende a receber tolerância diferente de outro vindo de um laboratório pouco conhecido.
Remover o nome permite observar parte do comportamento dos usuários com menos influência da reputação.
Existe também uma vantagem de engenharia.
Colocar uma prévia gratuita nas mãos de milhares de desenvolvedores produz uma variedade de testes que nenhum laboratório consegue reproduzir integralmente em ambiente fechado.
Alguém vai enviar um repositório enorme.
Outro usuário vai conectar ferramentas de maneira inesperada.
Um terceiro colocará o agente para trabalhar durante horas.
Outro descobrirá um erro que jamais apareceu nos testes internos.
Do ponto de vista de quem desenvolveu o modelo, essa utilização funciona como um gigantesco laboratório de campo.
Gratuito não significa sem custo
O Ox Alpha aparece no OpenRouter com preço de inferência zerado durante sua disponibilidade atual.
Isso é excelente para experimentação.
Também merece uma pergunta econômica.
Executar um modelo de grande contexto consome aceleradores, memória, energia, armazenamento e infraestrutura de rede. Quanto maior o volume de tokens processados, maior tende a ser a conta.
Se o usuário não está pagando por essa inferência, alguém está.
O subsídio pode servir para testar a infraestrutura, conquistar desenvolvedores, produzir dados de avaliação, criar reconhecimento para uma futura revelação ou simplesmente medir como o modelo se comporta antes de um lançamento comercial.
Nada disso significa necessariamente que exista algo errado.
Significa apenas que “grátis” descreve o preço cobrado do usuário naquele momento, não a ausência de custo da operação.
Essa diferença importa porque modelos gratuitos em fase de testes podem mudar rapidamente de preço, limites ou disponibilidade.
Projetar um produto inteiro presumindo que essas condições permanecerão indefinidamente seria uma aposta, não uma estratégia de infraestrutura.
O ponto realmente delicado: os prompts são retidos
É aqui que o Ox Alpha deixa de ser apenas uma curiosidade tecnológica.
O próprio OpenRouter informa que **os prompts enviados pelos usuários e as respostas produzidas são retidos pelo fornecedor do modelo**.
A plataforma também informa que esse conteúdo não é utilizado para treinamento.
As duas informações precisam ser consideradas juntas.
Não utilizar conteúdo para treinamento não significa não armazená-lo.
Retenção envolve outra classe de riscos: durante quanto tempo os dados permanecem guardados, onde são armazenados, quem possui acesso, como são protegidos e quais procedimentos existem em caso de incidente ou solicitação de exclusão.
Em serviços empresariais tradicionais, essas perguntas normalmente podem ser dirigidas a uma companhia identificada.
No Ox Alpha, justamente essa companhia permanece anônima.
Código corporativo muda completamente a conversa
Para alguém testando o modelo com um programa público, essa incerteza pode ser administrável.
Para uma empresa, a avaliação é outra.
Imagine um desenvolvedor enviando ao Ox Alpha um repositório contendo código proprietário, arquitetura interna, nomes de servidores, documentação de APIs, consultas de banco de dados e trechos de configuração.
Mesmo sem nenhuma senha presente, esse material pode revelar uma quantidade enorme de informação sobre a organização.
Agora acrescente contratos, dados de clientes, relatórios financeiros ou documentos jurídicos.
A capacidade de contexto que torna o Ox Alpha atraente é justamente o que aumenta a quantidade de informação que um usuário pode inadvertidamente entregar de uma só vez.
Um milhão de tokens pode ser uma ferramenta poderosa.
Também pode ser um caminhão muito eficiente para transportar informação confidencial para fora da empresa.
Não é preciso presumir má-fé para considerar o risco
A questão de privacidade precisa ser tratada sem sensacionalismo.
Não há evidência pública de que o fornecedor do Ox Alpha esteja roubando informações ou utilizando dados de maneira diferente da política declarada.
Esse não é o argumento.
Segurança empresarial não funciona esperando surgir prova de abuso para só então perguntar quem era o fornecedor.
O problema é de governança.
Empresas precisam saber quais terceiros processam suas informações, quais obrigações contratuais existem, quais controles técnicos foram implementados e quem será responsabilizado caso algo dê errado.
Quando a identidade do operador permanece oculta, parte dessa avaliação simplesmente não pode ser realizada.
Para prototipagem com dados públicos, isso pode ser aceitável.
Para conteúdo confidencial, o grau de tolerância deveria ser muito menor.
OpenRouter é a ponte, não o destino final
Essa distinção também ajuda a entender melhor como serviços de IA estão se reorganizando.
O OpenRouter funciona como uma camada de acesso a vários modelos. Em vez de integrar separadamente APIs de diferentes laboratórios, um desenvolvedor pode trabalhar com uma interface relativamente padronizada e trocar o modelo usado por sua aplicação.
É uma conveniência poderosa.
Mas ela também cria uma cadeia.
Existe a aplicação do usuário, o roteador e o fornecedor que realmente executa o modelo.
Políticas de armazenamento e privacidade podem variar entre essas camadas.
Por isso, olhar apenas para o nome exibido no seletor de modelos não é suficiente para decidir se determinada IA pode receber dados corporativos.
É preciso saber quem executa a inferência e sob quais condições.
No caso do Ox Alpha, justamente essa última parte permanece incompleta.
O paradoxo dos modelos stealth
Existe um conflito interessante nessa estratégia.
O anonimato pode melhorar um teste técnico porque reduz o peso da marca.
Ao mesmo tempo, reduz a confiança necessária para utilizar a tecnologia em ambientes sensíveis.
Quanto mais capaz o Ox Alpha demonstrar ser em grandes projetos, mais tentador será enviar a ele justamente os conteúdos que exigem maior proteção.
Essa é provavelmente a contradição mais importante do modelo.
Ele pode conquistar desenvolvedores exatamente pelas tarefas para as quais sua falta de identidade é mais problemática.
Um brinquedo curioso pode funcionar anonimamente.
Um componente de infraestrutura corporativa não recebe a mesma indulgência.
O que a comunidade está realmente testando
Há também algo interessante acontecendo com a forma como novos modelos chegam ao mercado.
Durante anos, a sequência mais comum foi previsível: laboratório anuncia modelo, divulga benchmarks, apresenta gráficos, publica demonstrações e, finalmente, usuários começam a descobrir o que funciona de verdade.
O modelo stealth inverte isso.
Primeiro surgem as experiências.
Depois vêm os testes, os bugs, as comparações e as hipóteses.
Só posteriormente pode aparecer a marca responsável.
É quase um lançamento conduzido de trás para frente.
Essa abordagem oferece ao desenvolvedor um benefício: a primeira reputação do modelo precisa nascer parcialmente de seu comportamento, não apenas de uma apresentação preparada pela empresa.
Mas há um preço.
Sem documentação completa, arquitetura conhecida e responsável identificado, os primeiros usuários também viram participantes involuntários de uma fase experimental.
Análise da equipe PixBugTech
O Ox Alpha seria interessante mesmo sem nenhum mistério.
Contexto superior a 1 milhão de tokens, foco em engenharia de software e capacidade para trabalhos agentivos prolongados colocam o modelo exatamente no centro de uma das disputas mais importantes da IA atual: transformar modelos de linguagem em sistemas capazes de executar trabalho técnico por períodos cada vez maiores.
O anonimato apenas deixa visível outra disputa que normalmente fica escondida atrás da interface.
**Quem controla a infraestrutura também controla uma parte importante da relação de confiança.**
Nos últimos anos, boa parte da discussão sobre modelos de IA ficou concentrada em benchmarks.
Quem programa melhor?
Quem raciocina melhor?
Quem possui mais contexto?
Quem custa menos por milhão de tokens?
Essas perguntas continuam importantes.
Mas, conforme modelos passam a receber bases de código, documentos empresariais e executar agentes conectados a sistemas reais, outra pergunta passa a ter o mesmo peso: **para onde esses dados estão indo?**
No Ox Alpha, a resposta ainda termina antes do nome da empresa.
É justamente aí que a curiosidade precisa dar lugar à prudência.
Nada impede que a eventual revelação mostre um laboratório conhecido, com infraestrutura madura, políticas claras e um modelo realmente competitivo.
Também pode ocorrer de a tecnologia perder parte do brilho quando comparações independentes mais amplas aparecerem.
As duas possibilidades continuam abertas.
Por enquanto, a posição mais razoável é simples.
O Ox Alpha parece ser uma ferramenta particularmente interessante para testes com código aberto, conteúdo público e experimentação controlada.
Para dados confidenciais, propriedade intelectual ou informações de clientes, a capacidade técnica não compensa a ausência de uma resposta básica sobre quem está do outro lado da API.
A indústria de inteligência artificial está entrando numa fase em que identificar o modelo talvez deixe de ser suficiente.
Será necessário identificar também sua cadeia de execução.
Porque um milhão de tokens diz quanto o Ox Alpha consegue receber.
A pergunta mais importante é saber **quem recebe junto com ele**.
👉 Dúvida? Então veja mais em: https://pixbugtech.com/linksuteis