noticias
Pentágono quer usar IA para modernizar detector de mentiras mas a tecnologia ainda enfrenta um problema científico antigo
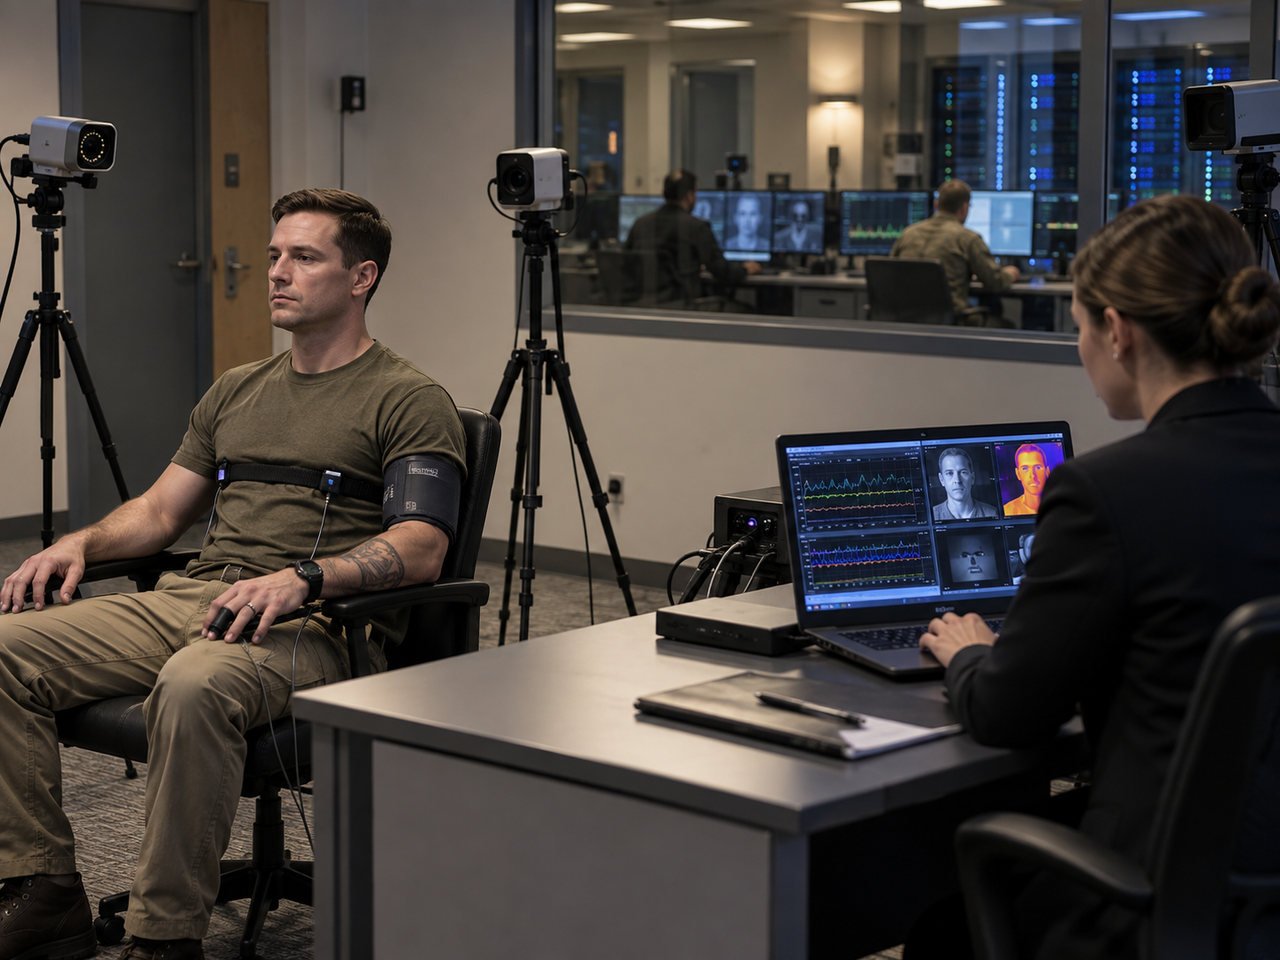
O Departamento de Defesa dos Estados Unidos quer levar inteligência artificial, aprendizado de máquina e sensores fisiológicos sem contato para um território que há décadas desperta controvérsia: os testes de polígrafo.
O programa, chamado **Polygraph Next** e também descrito como **Polygraph+**, aparece em documentos orçamentários da Defense Counterintelligence and Security Agency, a DCSA.
A proposta prevê investimentos de aproximadamente **US$ 30,3 milhões ao longo de cinco anos** para desenvolver uma nova geração de sistemas de avaliação de credibilidade.
A ideia é modernizar tanto a coleta dos sinais fisiológicos quanto a forma como eles são interpretados.
O problema é que um polígrafo nunca detectou uma mentira diretamente.
Ele mede reações do corpo. A conclusão vem depois.
E essa diferença continua sendo o ponto mais delicado de toda a tecnologia.
O que o Pentágono quer mudar
O polígrafo tradicional depende de sensores conectados ao corpo para acompanhar variáveis como frequência cardíaca, respiração, pressão arterial e atividade eletrodérmica da pele.
Esses sinais são registrados enquanto a pessoa responde a perguntas específicas.
O examinador tenta então identificar padrões considerados relevantes durante o teste.
O Polygraph Next pretende atualizar esse processo em duas frentes.
A primeira envolve algoritmos de inteligência artificial e aprendizado de máquina capazes de analisar simultaneamente grandes volumes de dados fisiológicos e ajudar na atribuição de pontuações.
A segunda envolve o chamado **standoff sensing**, uma abordagem baseada em sensores capazes de realizar determinadas medições sem contato físico direto com o examinado.
Na prática, isso pode incluir câmeras ópticas, sensores térmicos e outros equipamentos capazes de captar mudanças fisiológicas à distância.
A intenção é tornar o procedimento mais rápido, menos dependente da instalação manual de equipamentos e potencialmente mais padronizado.
Isso resolve parte do problema operacional.
Não necessariamente resolve o problema científico.
Medir estresse não é o mesmo que detectar mentira
O ponto central está justamente na interpretação dos sinais.
Uma alteração na frequência cardíaca pode estar associada a ansiedade.
Mudanças respiratórias podem aparecer por tensão.
Variações térmicas podem ocorrer por estresse.
Nenhuma dessas respostas, isoladamente, significa que alguém mentiu.
Esse sempre foi um dos principais limites do polígrafo.
O sistema mede reações fisiológicas relacionadas ao estado emocional ou ao nível de ativação do organismo e tenta associá-las a determinados tipos de resposta.
A inteligência artificial pode melhorar bastante a capacidade de encontrar padrões nesses dados.
Pode comparar milhares de exames.
Pode detectar combinações que passariam despercebidas a um examinador.
Pode reduzir algumas variações provocadas pela interpretação humana.
Mas não pode transformar automaticamente um sinal fisiológico em prova de mentira.
Se a relação entre o dado medido e a conclusão desejada for frágil, um algoritmo mais sofisticado apenas produzirá uma inferência mais sofisticada.
IA pode reduzir erros humanos e criar outros
Há uma vantagem técnica clara no uso de aprendizado de máquina nesse tipo de análise.
Algoritmos conseguem processar simultaneamente uma quantidade de variáveis muito maior do que um examinador humano.
Também conseguem aplicar os mesmos critérios repetidamente, sem fadiga e sem mudanças de interpretação entre diferentes profissionais.
Isso pode aumentar a consistência.
Mas consistência não é a mesma coisa que precisão.
Um modelo treinado com dados incompletos, pouco representativos ou enviesados pode aprender padrões que funcionam bem em laboratório e falham em situações reais.
Características individuais também complicam a análise.
Medicamentos, ansiedade, condições médicas, treinamento prévio, experiência com situações de pressão e até diferenças fisiológicas naturais podem alterar as respostas registradas.
Uma pessoa extremamente nervosa pode reagir intensamente mesmo dizendo a verdade.
Outra pessoa pode permanecer aparentemente tranquila em condições semelhantes.
O algoritmo precisa lidar com esse ruído.
E isso é muito mais difícil do que simplesmente reconhecer um rosto ou classificar uma imagem.
O desafio científico continua existindo
A confiabilidade dos polígrafos é discutida há décadas.
Avaliações científicas produzidas nos Estados Unidos já apontaram limitações importantes na qualidade das evidências usadas para validar esses exames.
Em determinadas situações envolvendo eventos específicos, testes de polígrafo conseguem apresentar resultados superiores ao acaso.
Ainda assim, estão longe de oferecer precisão absoluta.
A dificuldade aumenta quando o equipamento é usado para triagem de grandes populações.
Imagine uma organização avaliando milhares de funcionários à procura de um número muito pequeno de pessoas que realmente representam algum risco.
Mesmo que o sistema apresente uma taxa relativamente baixa de falsos positivos, a quantidade de pessoas incorretamente classificadas pode se tornar significativa.
Adicionar inteligência artificial não elimina essa matemática.
O novo sistema pode produzir uma pontuação mais detalhada.
Pode integrar mais variáveis.
Pode encontrar novos padrões estatísticos.
Mas ainda será necessário demonstrar que esses padrões realmente representam aquilo que o sistema afirma estar medindo.
O sistema pode gerar um enorme banco de dados fisiológicos
Outro ponto importante do Polygraph Next está na infraestrutura por trás dos exames.
A documentação do programa prevê recursos de armazenamento em nuvem e ferramentas voltadas para análise dos dados coletados.
Isso pode permitir que resultados produzidos em diferentes exames sejam reunidos e analisados em larga escala.
Do ponto de vista técnico, é extremamente útil.
Quanto maior a quantidade de dados disponíveis, maiores são as possibilidades de treinamento, comparação e refinamento dos modelos.
Ao mesmo tempo, surge uma questão delicada de privacidade.
Informações fisiológicas podem ser extremamente sensíveis.
Dependendo da forma como forem armazenadas, podem estar associadas à identidade da pessoa, ao histórico de exames e às circunstâncias em que determinada avaliação foi realizada.
Centralizar grandes volumes desse tipo de informação cria novas exigências de segurança.
Controle de acesso, criptografia, auditoria, retenção de dados e definição clara de finalidade passam a ser partes essenciais do sistema.
Um projeto criado para melhorar a segurança institucional pode acabar criando também um novo conjunto de dados altamente atraente para espionagem ou ataques cibernéticos.
O Pentágono pesquisa alternativas ao polígrafo há décadas
A busca por métodos mais precisos de avaliação de credibilidade não começou agora.
O governo dos Estados Unidos mantém pesquisas nesse campo há bastante tempo.
Ao longo dos anos, diferentes iniciativas investigaram técnicas envolvendo atividade cerebral, análise comportamental, sensores biométricos e outros indicadores fisiológicos.
O que mudou foi a capacidade tecnológica disponível.
Câmeras térmicas ficaram mais precisas.
Sensores ópticos evoluíram.
Infraestruturas de nuvem permitem armazenar e processar quantidades enormes de dados.
E modelos de aprendizado de máquina conseguem analisar simultaneamente dezenas ou centenas de variáveis.
Pela primeira vez, existe capacidade computacional suficiente para construir sistemas de avaliação fisiológica muito mais complexos do que o polígrafo tradicional.
Isso torna a pesquisa tecnicamente interessante.
Mas também aumenta a responsabilidade sobre como seus resultados serão utilizados.
O perigo da aparência de certeza
Uma das características mais sedutoras dos sistemas automatizados é a precisão aparente.
Um algoritmo pode produzir uma pontuação como 82%, 91% ou 97%.
O número parece objetivo.
Parece científico.
Mas a precisão visual do resultado não significa necessariamente que a conclusão seja igualmente precisa.
Em aplicações envolvendo pessoas, essa diferença é especialmente importante.
Se uma pontuação produzida por inteligência artificial começar a influenciar decisões sobre acesso a informações confidenciais, carreira profissional ou investigações internas, será necessário compreender exatamente como aquele resultado foi produzido.
Também será necessário conhecer a margem de erro.
E saber quais fatores podem gerar falsos positivos ou falsos negativos.
Sem isso, o risco é transformar uma ferramenta de apoio em uma espécie de autoridade matemática difícil de contestar.
Análise da equipe
O Polygraph Next é um exemplo interessante de uma tendência maior: tecnologias antigas estão sendo reconstruídas com inteligência artificial.
Em alguns casos, isso produz avanços reais.
Algoritmos conseguem analisar sinais complexos, reduzir variabilidade entre examinadores e detectar padrões difíceis de identificar manualmente.
Mas inteligência artificial não corrige automaticamente uma premissa científica frágil.
Se o problema original estiver na relação entre o que o sensor mede e a conclusão que se pretende obter, melhorar o algoritmo resolve apenas parte da equação.
Esse será o verdadeiro teste do programa.
Não basta demonstrar que o novo sistema consegue medir melhor.
Será necessário provar que consegue interpretar melhor.
E, principalmente, que essa melhora continua existindo quando a tecnologia sai do laboratório e passa a ser aplicada em pessoas reais, sob condições reais e com consequências reais.
Se os testes independentes confirmarem avanços significativos, o Polygraph Next poderá representar uma evolução importante nos métodos de avaliação de credibilidade.
Se isso não acontecer, o governo americano terá criado um polígrafo mais moderno, mais conectado e mais caro.
Mas não necessariamente mais confiável.
👉 Dúvida? Então veja mais em: https://pixbugtech.com/linksuteis