noticias
Por que o ChatGPT, Gemini e Claude parecem estar piorando? A explicação técnica e econômica que poucos admitem
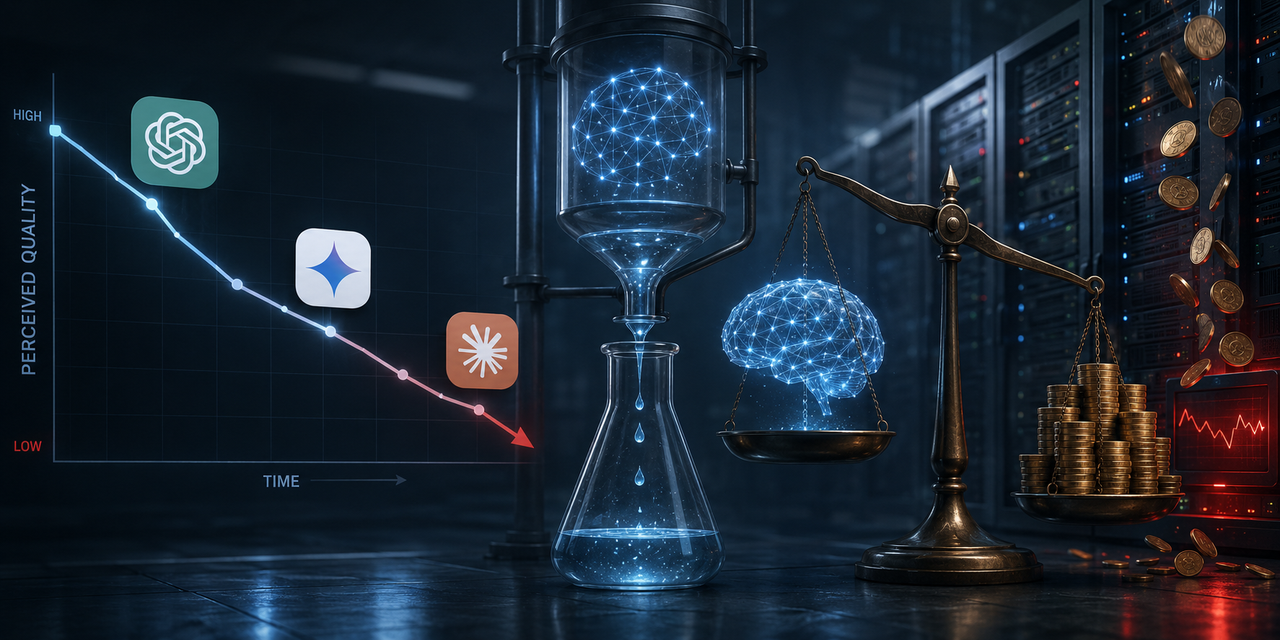
Você não está louco. Muitos usuários têm percebido que o ChatGPT, o Gemini e o Claude entregam respostas mais rasas, mais repetitivas e menos úteis do que há alguns meses. Não é impressão. É design. As grandes empresas de IA estão otimizando custos de forma agressiva — e o usuário final está pagando o preço em qualidade.
O que realmente está acontecendo
Os modelos de linguagem não são estáticos. Eles são serviços vivos, rodando em servidores caros. Cada token processado custa dinheiro. Quanto mais raciocínio (thinking steps), mais contexto e mais tempo de computação, maior o custo.
Para proteger margens, as empresas adotam estratégias silenciosas:
• **Roteamento inteligente de modelos**: Perguntas simples vão para versões mais baratas. Perguntas complexas podem (ou não) subir para modelos mais potentes.
• **Destilação de modelos**: Versões grandes e caras são comprimidas para entregar respostas parecidas com menos recursos.
• **Limitação de raciocínio**: Redução intencional do número de etapas internas de pensamento para economizar tokens.
• **Substituição gradual**: Modelos antigos são descontinuados e substituídos por versões “melhoradas” que, na prática, mudam o tom, a profundidade e a confiabilidade.
O resultado é uma experiência inconsistente. O mesmo prompt que funcionava bem há dois meses agora entrega respostas preguiçosas ou fora do tom desejado.
Mergulho técnico: o custo por trás da resposta
Quando você faz uma pergunta complexa, o modelo precisa:
1. Ler o prompt + histórico de conversa
2. Realizar múltiplas etapas de raciocínio interno
3. Consultar fontes (quando habilitado)
4. Gerar a resposta final
Cada uma dessas etapas consome tokens. Empresas como OpenAI, Google e Anthropic cobram (internamente) por isso. Para reduzir despesas, elas:
• Ativam por padrão o modo “rápido” ou “econômico”
• Reduzem a janela de contexto efetiva
• Limitam o esforço de verificação e refutação
• Destilam o modelo (mantém o nome, mas reduz a capacidade computacional)
É como um professor que para de explicar o caminho e começa a dar só a resposta final. Mais rápido, mais barato, mas menos rico.
Mergulho 1 — A ilusão da “melhoria contínua”
Toda vez que sai um novo modelo (GPT-5.4, Gemini 2.5, Claude 4.6), as empresas celebram. Na prática, muitos usuários relatam perda de capacidade em tarefas específicas que funcionavam melhor em versões anteriores. O problema é que você não pode mais voltar para a versão antiga. A escolha foi retirada.
Mergulho 2 — A alternativa offline
Existe uma saída técnica viável: modelos locais open-source. Ferramentas como o Hand (hand.computer) para transcrição e LLMs rodando localmente oferecem consistência que os serviços online não entregam mais.
Embora ainda menos potentes que os modelos de fronteira, eles são previsíveis, baratos a longo prazo e livres de censura excessiva ou mudanças repentinas de comportamento.
Análise da Equipe PixBugTech
• **Qualidade percebida pelo usuário**: 6/10 — Em declínio gradual para tarefas médias e complexas.
• **Razão econômica**: 9.5/10 — As empresas operam com prejuízo em muitos modelos de fronteira. A destilação é inevitável.
• **Consistência**: 4.5/10 — O maior problema atual. O serviço se torna imprevisível.
• **Recomendação prática**: 8/10 — Manter uso híbrido (online para tarefas leves + local para fluxos críticos).
Conclusão
A sensação de que “a IA está piorando” não é paranoia coletiva. É o resultado previsível de um modelo de negócio que prioriza escala e rentabilidade sobre experiência estável do usuário.
As empresas não estão tornando os modelos mais burros. Elas estão tornando-os mais eficientes para elas — e menos úteis para quem realmente precisa pensar com profundidade.
Enquanto isso, quem depende de IA para trabalho sério deve diversificar: usar os serviços online com consciência de suas limitações e investir em soluções locais para tarefas que exigem confiabilidade.
O futuro da IA não será definido apenas por quem tem o modelo mais inteligente, mas por quem conseguir entregar a inteligência mais consistente.
---