noticias
Qwen3.8-Max desafia GPT-5.6 e Fable 5 mas o benchmark não conta a história inteira
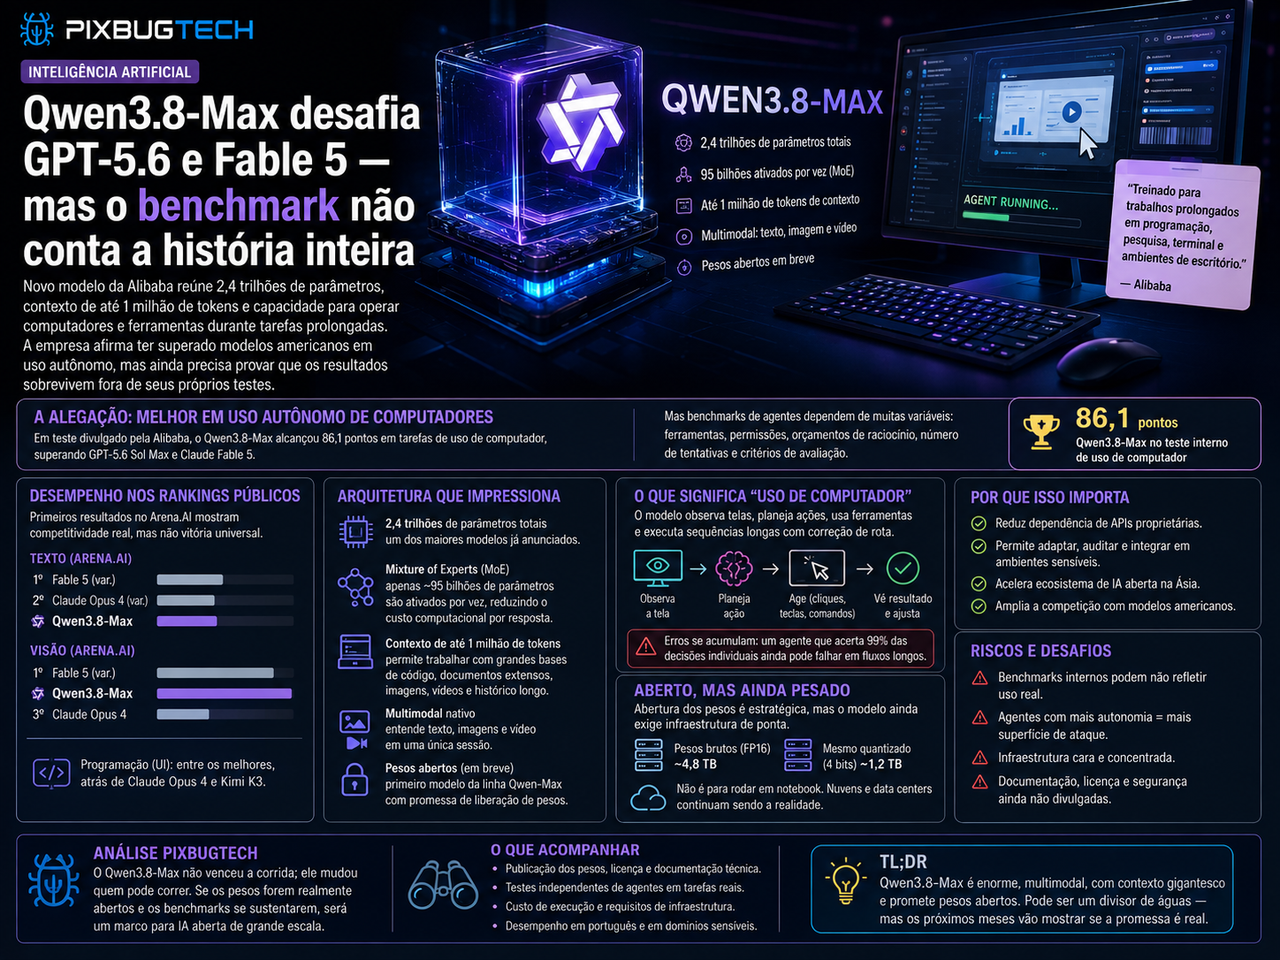
**Novo modelo da Alibaba reúne 2,4 trilhões de parâmetros, contexto de até 1 milhão de tokens e capacidade para operar computadores e ferramentas durante tarefas prolongadas. A empresa afirma ter superado modelos americanos em uso autônomo, mas ainda precisa provar que os resultados sobrevivem fora de seus próprios testes**
A Alibaba apresentou o Qwen3.8-Max como seu modelo de inteligência artificial mais poderoso até agora e escolheu um alvo bastante específico para demonstrar essa capacidade. Em vez de limitar a comparação a perguntas acadêmicas, geração de texto ou resolução isolada de problemas, a empresa afirma ter superado GPT-5.6 Sol Max e Claude Fable 5 em tarefas de uso autônomo de computadores.
Em um dos testes destacados no lançamento, o Qwen3.8-Max teria alcançado 86,1 pontos. O número sugere que o modelo consegue observar uma interface, planejar ações, utilizar ferramentas e executar sequências relativamente longas com menos erros do que alguns dos sistemas proprietários mais avançados disponíveis.
É uma alegação importante. Também é exatamente o tipo de alegação que precisa ser lida com cuidado.
Os resultados mais impressionantes foram apresentados pela própria Alibaba. A configuração dos modelos comparados, o orçamento de raciocínio, as ferramentas disponíveis, as permissões concedidas e os critérios usados para considerar uma tarefa concluída podem alterar profundamente a classificação. Uma vitória em determinado ambiente não significa que o Qwen3.8-Max seja superior em programação, pesquisa, produção de texto, análise visual, segurança e uso empresarial ao mesmo tempo.
Ainda assim, o lançamento não pode ser descartado como simples marketing. O modelo apareceu rapidamente entre os sistemas mais bem avaliados em rankings públicos, tornou-se o modelo chinês mais bem colocado em comparações de texto e alcançou a segunda posição em avaliações visuais, atrás apenas de uma variante do Fable 5.
O cenário mais plausível é menos cinematográfico e mais relevante: a Alibaba construiu um modelo capaz de disputar a fronteira mundial em algumas tarefas e pretende oferecê-lo com pesos abertos. Isso muda a conversa porque coloca uma tecnologia potencialmente comparável aos melhores serviços proprietários nas mãos de empresas, governos e pesquisadores que desejam executá-la sob sua própria infraestrutura.
Não é apenas um chatbot maior
O Qwen3.8-Max possui 2,4 trilhões de parâmetros. Esse número o coloca entre os maiores modelos já anunciados publicamente, abaixo dos 2,8 trilhões atribuídos ao Kimi K3, da Moonshot AI.
Parâmetros são valores ajustados durante o treinamento e utilizados pelo modelo para reconhecer padrões, relacionar conceitos e produzir respostas. A contagem ajuda a indicar escala, mas não mede inteligência diretamente. Um sistema maior pode ser pior treinado, utilizar arquitetura menos eficiente ou desperdiçar capacidade em tarefas que um modelo menor resolve com mais precisão.
No caso do Qwen3.8-Max, os 2,4 trilhões também não são acionados simultaneamente. O modelo utiliza uma arquitetura conhecida como Mixture of Experts, ou mistura de especialistas. Em vez de processar cada entrada com a rede inteira, um mecanismo escolhe subconjuntos especializados para trabalhar em cada etapa.
Segundo as informações divulgadas, aproximadamente 95 bilhões de parâmetros são ativados por vez. A proporção é pequena diante do total, mas ainda corresponde a um modelo enorme em operação.
Essa arquitetura procura combinar duas vantagens. O modelo pode armazenar uma quantidade muito grande de conhecimento e especializações, enquanto reduz o custo computacional de cada resposta ao ativar apenas as partes consideradas relevantes.
A economia não transforma o Qwen3.8-Max em um sistema leve. Todos os parâmetros precisam estar armazenados e acessíveis, ainda que apenas uma parte seja utilizada em determinado momento. Em precisão de 16 bits, os pesos brutos de um modelo com 2,4 trilhões de parâmetros ocupariam aproximadamente 4,8 terabytes. Mesmo uma quantização agressiva de quatro bits permaneceria próxima de 1,2 terabyte, antes de considerar cache, roteamento, contexto e demais estruturas necessárias.
A promessa de pesos abertos, portanto, não significa que qualquer pessoa poderá baixar o modelo em um notebook e substituir o ChatGPT durante o fim de semana. O público capaz de executá-lo integralmente continuará concentrado em empresas de nuvem, laboratórios, governos e organizações com clusters de aceleradores.
A abertura aumenta o controle, mas não democratiza automaticamente a infraestrutura.
Um milhão de tokens não significa memória perfeita
O Qwen3.8-Max aceita até 1 milhão de tokens de contexto. Em termos práticos, isso permite fornecer grandes bases de código, coleções de documentos, históricos extensos, imagens, vídeos e instruções dentro de uma mesma sessão.
Para empresas, a capacidade pode ser mais relevante do que uma pequena vantagem em testes acadêmicos. Um agente consegue analisar contratos, navegar por repositórios, consultar documentação técnica e acompanhar decisões anteriores sem depender de recortes tão agressivos.
Contexto longo, no entanto, não deve ser confundido com compreensão integral. Um modelo pode aceitar 1 milhão de tokens e ainda ignorar detalhes, recuperar trechos incorretos, confundir versões ou perder prioridades ao longo da tarefa.
A quantidade suportada descreve o limite de entrada. Não garante a qualidade com que cada fragmento será utilizado.
Há também um custo. Quanto maior o histórico processado, maior tende a ser o consumo de memória, processamento e tempo. Agentes que acumulam ações, capturas de tela, logs e resultados de ferramentas podem carregar enormes quantidades de informação irrelevante. Sem um sistema de compactação e seleção bem projetado, o contexto vira um depósito caro.
O avanço real não está apenas em aceitar um arquivo gigantesco. Está em decidir o que manter, resumir, descartar e recuperar no momento correto.
O que significa usar um computador como agente
O termo “uso de computador” costuma ser apresentado como se a IA ganhasse mãos digitais. Na prática, o modelo recebe representações da tela, interpreta elementos visuais ou estruturais e escolhe ações como clicar, digitar, abrir menus, executar comandos e consultar ferramentas.
A tarefa exige mais do que reconhecer uma imagem. O agente precisa entender o objetivo, construir uma sequência, observar o resultado de cada ação e corrigir o plano quando algo inesperado acontece.
Considere uma tarefa aparentemente simples: abrir um sistema empresarial, localizar uma planilha, filtrar registros, comparar valores com um contrato e preparar um relatório. Um modelo pode falhar ao interpretar um botão, perder o estado da sessão, escolher a data errada, sobrescrever o arquivo original ou declarar sucesso antes de terminar.
Esses pequenos erros se acumulam. Um agente que acerta 99% das decisões individuais ainda pode apresentar desempenho ruim em um fluxo com centenas de etapas. Quanto mais longa a tarefa, maior a importância da recuperação de falhas.
É nesse ponto que o Qwen3.8-Max tenta se diferenciar. A Alibaba afirma que o modelo foi treinado para trabalhos prolongados em programação, pesquisa, terminal e ambientes de escritório. A empresa também diz ter mantido o sistema envolvido em um projeto de engenharia de software durante 16 dias.
A demonstração é interessante porque tarefas longas expõem defeitos que benchmarks curtos escondem. O agente precisa preservar objetivos, compreender mudanças realizadas anteriormente, administrar ferramentas e não destruir o próprio trabalho depois de horas de execução.
Ainda faltam detalhes independentes sobre esse experimento. Não está claro quanto da tarefa foi concluído autonomamente, quantas intervenções humanas ocorreram, quais ferramentas foram fornecidas e como a qualidade final foi avaliada.
Uma IA permanecer ativa por 16 dias não é necessariamente uma IA produtiva por 16 dias. Às vezes, a diferença entre persistência e teimosia é apenas a conta da nuvem.
O significado real dos 86,1 pontos
A pontuação de 86,1 ganhou destaque porque colocaria o Qwen3.8-Max acima de GPT-5.6 Sol Max e Fable 5 em determinado teste de operação autônoma.
O número não deve ser ignorado, mas também não pode ser tratado como uma classificação definitiva dos modelos. Avaliações de agentes são particularmente sensíveis à infraestrutura ao redor do modelo.
Um sistema pode receber acesso direto ao navegador, enquanto outro depende de capturas de tela. Um pode trabalhar com raciocínio máximo e outro utilizar configuração intermediária. Diferenças no tamanho da tela, latência, número de tentativas, mensagens de erro e ferramentas disponíveis mudam o resultado.
O próprio agente pode ser apenas uma parte do desempenho. O software que administra memória, seleciona ações, interpreta respostas, valida resultados e reinicia tarefas também influencia a pontuação.
Isso significa que o benchmark pode medir o modelo, o sistema de agente ou uma combinação difícil de separar.
A comparação correta exige os mesmos ambientes, ferramentas, limites de tempo, custos e regras. Também precisa registrar quantas vezes cada modelo tentou, quantos tokens consumiu e quanto custou para terminar as tarefas.
Sem essas informações, a pontuação indica potencial, não domínio.
Os primeiros rankings públicos confirmam parte da ambição
Embora os testes internos devam ser tratados como alegações da fabricante, os primeiros resultados públicos reforçam que o Qwen3.8-Max é competitivo.
No Arena.AI, plataforma em que usuários comparam respostas de modelos sem conhecer imediatamente sua identidade, o sistema tornou-se o modelo chinês mais bem classificado na categoria de texto. Ficou atrás do Fable 5 e de variantes da família Claude Opus.
Em análise visual, o Qwen alcançou a segunda posição, superado apenas por uma versão do Fable 5. Em programação de interfaces, permaneceu entre os melhores, embora atrás de modelos Claude Opus e do Kimi K3.
Esses rankings oferecem uma evidência diferente dos benchmarks controlados pela Alibaba. Pessoas reais avaliam respostas em uma diversidade maior de solicitações, reduzindo parte do risco de otimização para um conjunto conhecido.
Ainda assim, o Arena também possui limitações. A preferência humana pode favorecer respostas bem apresentadas, mesmo quando possuem erros sutis. Modelos podem receber configurações distintas de raciocínio. A composição dos usuários não representa necessariamente ambientes empresariais.
O resultado mais honesto é dizer que o Qwen3.8-Max chegou ao grupo da frente. A ordem exata dentro desse grupo continuará mudando conforme aparecem testes independentes, correções e novas versões dos concorrentes.
A era em que um lançamento conseguia permanecer “o melhor modelo do mundo” por meses parece ter acabado. Agora, o título frequentemente expira antes do material de divulgação.
Pesos abertos são a parte mais estratégica do lançamento
A Alibaba promete divulgar os pesos do Qwen3.8-Max na semana seguinte ao anúncio. Segundo a empresa, será a primeira vez que um modelo da categoria Qwen-Max receberá esse tipo de abertura.
É uma mudança importante. Até agora, os modelos mais poderosos da linha Max eram oferecidos principalmente como serviços controlados pela própria companhia.
Com os pesos disponíveis, organizações poderão executar o modelo em infraestrutura própria, adaptar seu comportamento, aplicar quantização, realizar ajustes especializados e integrá-lo a ambientes que não podem enviar dados para APIs externas.
Para bancos, indústrias, governos, hospitais e escritórios que lidam com informações confidenciais, essa possibilidade pode ser mais relevante do que uma diferença marginal em benchmarks.
O termo “aberto”, porém, precisa ser utilizado com precisão. Disponibilizar pesos não equivale necessariamente a abrir código de treinamento, conjuntos de dados, filtros, procedimentos de alinhamento e documentação completa.
Um modelo pode ser open-weight sem ser plenamente open source no sentido tradicional do software.
A licença também será decisiva. Empresas precisarão saber quais usos comerciais são permitidos, quais obrigações permanecem e se existem restrições geográficas, de escala ou de finalidade.
Até a publicação efetiva dos arquivos, da licença e do cartão técnico, a abertura continua sendo uma promessa.
A China encontrou uma arma comercial na abertura
A estratégia chinesa de IA passou a utilizar modelos de pesos abertos como instrumento de competição global. DeepSeek, Moonshot, Alibaba e outros laboratórios entenderam que não precisam necessariamente vencer todos os rankings para conquistar desenvolvedores.
Eles precisam oferecer sistemas suficientemente capazes, adaptáveis e mais baratos.
Modelos americanos de fronteira permanecem majoritariamente fechados. Empresas acessam GPT-5.6 Sol, Claude Fable e outros sistemas por APIs e produtos controlados por seus fabricantes. Isso facilita atualizações e reduz a infraestrutura necessária para o cliente, mas cria dependência.
Preços podem mudar. Modelos podem ser substituídos. Políticas de uso podem impedir aplicações específicas. Informações precisam atravessar a infraestrutura do fornecedor, salvo contratos e ambientes especiais.
Um modelo de pesos abertos oferece outra relação. O usuário assume custos, segurança e manutenção, mas também passa a controlar a execução.
A China não está apostando apenas em desempenho. Está transformando abertura em distribuição.
Quanto mais empresas utilizarem Qwen como base para produtos, mais o ecossistema chinês ganhará influência sobre bibliotecas, ferramentas, formatos e práticas de desenvolvimento.
O modelo aberto ainda depende de nuvens gigantes
Existe uma contradição nessa estratégia. O Qwen3.8-Max poderá ser aberto e, ao mesmo tempo, permanecer inacessível para quase todos os desenvolvedores independentes.
Armazenar e executar uma arquitetura de 2,4 trilhões de parâmetros exige uma infraestrutura extraordinária. Mesmo com apenas 95 bilhões ativados por etapa, o sistema precisa distribuir especialistas, movimentar dados entre aceleradores e manter uma enorme quantidade de pesos pronta para uso.
Uma organização pode ter o direito de executar o modelo sem possuir os meios econômicos para fazê-lo.
Na prática, grande parte do uso ocorrerá em serviços de nuvem, provedores especializados ou versões quantizadas administradas por terceiros. A dependência deixa de ser obrigatoriamente da API da Alibaba, mas não desaparece. Migra para quem controla GPUs, redes de alta velocidade e energia.
Os principais beneficiados pela abertura podem ser justamente os grandes provedores de infraestrutura capazes de hospedar o modelo.
Empresas menores terão mais escolha entre fornecedores, o que é positivo, mas dificilmente operarão a versão completa dentro de um servidor comum.
A abertura reduz o monopólio do modelo. Não resolve a concentração da computação.
Empresas não precisam do “melhor modelo do mundo”
A disputa entre Qwen3.8-Max, GPT-5.6 Sol Max e Fable 5 produz manchetes, mas a decisão empresarial costuma ser menos emocional.
Uma companhia não precisa necessariamente do modelo que vence mais benchmarks. Precisa de um sistema capaz de concluir suas tarefas dentro de requisitos de custo, privacidade, latência, confiabilidade e suporte.
Um modelo ligeiramente inferior, porém mais barato e controlável, pode ser a escolha correta. Um modelo de fronteira extremamente capaz pode ser um desperdício para classificar documentos, consultar sistemas internos ou preencher formulários repetitivos.
O Qwen3.8-Max será atraente quando sua combinação de capacidade e abertura compensar o custo de infraestrutura.
Empresas poderão utilizá-lo como modelo principal de agentes complexos, como professor para treinar sistemas menores ou como ferramenta de produção de dados sintéticos. Também poderão especializá-lo em código, documentos internos, processos industriais e idiomas específicos.
O uso mais interessante talvez não seja oferecer o Qwen3.8-Max diretamente a todos os funcionários. Pode ser utilizar sua capacidade para construir modelos menores e fluxos mais eficientes.
Um sistema com 2,4 trilhões de parâmetros não precisa responder a cada e-mail para justificar sua existência.
Agentes mais capazes aumentam o tamanho do acidente
Quanto melhor um modelo opera computadores, maior o impacto de seus erros.
Um chatbot incorreto produz uma resposta ruim. Um agente incorreto pode enviar uma mensagem, excluir dados, aprovar uma despesa, alterar código ou fornecer credenciais a uma página maliciosa.
Esse risco não é teórico. Agentes que utilizam navegadores e ferramentas podem encontrar instruções escondidas em sites, documentos e mensagens. Um texto aparentemente comum pode tentar convencer o modelo a ignorar sua tarefa, compartilhar informações ou executar comandos.
É o problema da injeção de prompt aplicado a sistemas com capacidade de agir.
Um agente empresarial precisa operar com permissões mínimas, ambientes isolados, registros completos e confirmações humanas para ações sensíveis. Também precisa distinguir instruções legítimas de conteúdo encontrado durante a navegação.
Quanto maior o horizonte da tarefa, mais oportunidades surgem para o sistema perder o objetivo ou aceitar uma orientação maliciosa.
A pontuação de 86,1 pode ser impressionante em um benchmark. Em um processo financeiro, os 13,9 pontos restantes são o departamento jurídico chegando mais cedo.
O que ainda precisa ser provado
O Qwen3.8-Max chega com uma combinação incomum de escala, multimodalidade, contexto longo, capacidade de agente e promessa de pesos abertos.
Ainda faltam respostas importantes.
A Alibaba precisa publicar documentação sobre treinamento, limites de segurança, comportamento em diferentes idiomas, custos de execução e requisitos de infraestrutura. Também precisa detalhar os benchmarks e permitir que pesquisadores reproduzam as comparações.
Será necessário avaliar o modelo em tarefas nas quais a resposta não pode ser julgada apenas por aparência. Segurança de código, precisão jurídica, fatos históricos, resistência a manipulação, uso de ferramentas e comportamento sob pressão precisam de estudos independentes.
A qualidade em português também merece atenção. Modelos Qwen anteriores oferecem bom suporte multilíngue, mas resultados gerais não garantem o mesmo desempenho em linguagem jurídica brasileira, documentos administrativos ou conversas informais.
A abertura dos pesos permitirá que essa investigação seja mais profunda do que em modelos fechados. Pesquisadores poderão testar os mecanismos internos, desenvolver correções e identificar vulnerabilidades sem depender exclusivamente da interface oferecida pelo fabricante.
Essa vantagem só existirá plenamente se a documentação e a licença forem compatíveis com a promessa.
O Qwen3.8-Max não venceu a corrida — ele mudou quem pode correr
A manchete de que o Qwen3.8-Max superou GPT-5.6 Sol Max e Fable 5 é tecnicamente defensável dentro de um teste específico. Transformá-la em uma declaração universal seria marketing.
Os dados disponíveis mostram algo mais importante. A distância entre os modelos chineses e os sistemas proprietários americanos diminuiu ao ponto de as comparações dependerem da tarefa, da configuração e do custo.
A Alibaba não precisa provar que o Qwen é sempre melhor. Precisa provar que ele é bom o bastante para que empresas considerem trocar uma API fechada por uma arquitetura que podem controlar.
Se os pesos forem realmente publicados e a comunidade conseguir reproduzir os resultados, o lançamento poderá se tornar um marco para modelos abertos de grande escala.
Se os custos de execução forem excessivos, a documentação insuficiente ou os benchmarks não se sustentarem, o Qwen3.8-Max continuará sendo uma demonstração impressionante, mas restrita a poucos operadores.
O cenário mais provável está entre os extremos. O modelo não tornará GPT-5.6 ou Fable 5 irrelevantes. Também não será apenas uma curiosidade chinesa.
Ele representa uma mudança na economia da inteligência artificial: sistemas próximos da fronteira começam a deixar de ser exclusivamente produtos acessados por assinatura e passam a ser infraestrutura que organizações podem possuir, modificar e hospedar.
O verdadeiro teste não será saber se o Qwen consegue clicar mais corretamente do que um rival em uma tela controlada. Será descobrir se empresas conseguem transformar essa capacidade em trabalho confiável sem criar uma máquina caríssima, autônoma e autorizada a cometer erros em escala.
A IA agente está deixando de ser uma demonstração de laboratório. O Qwen3.8-Max mostra que a próxima disputa não será apenas por quem responde melhor, mas por quem consegue agir por mais tempo, custar menos e entregar controle suficiente para que alguém aceite assumir a responsabilidade quando a ação der errado.
👉 Dúvida? Então veja mais em: https://pixbugtech.com/linksuteis