noticias
Servidor com dez GPUs mostra por que a IA local deixou de ser brinquedo e por que ainda não serve para qualquer empresa
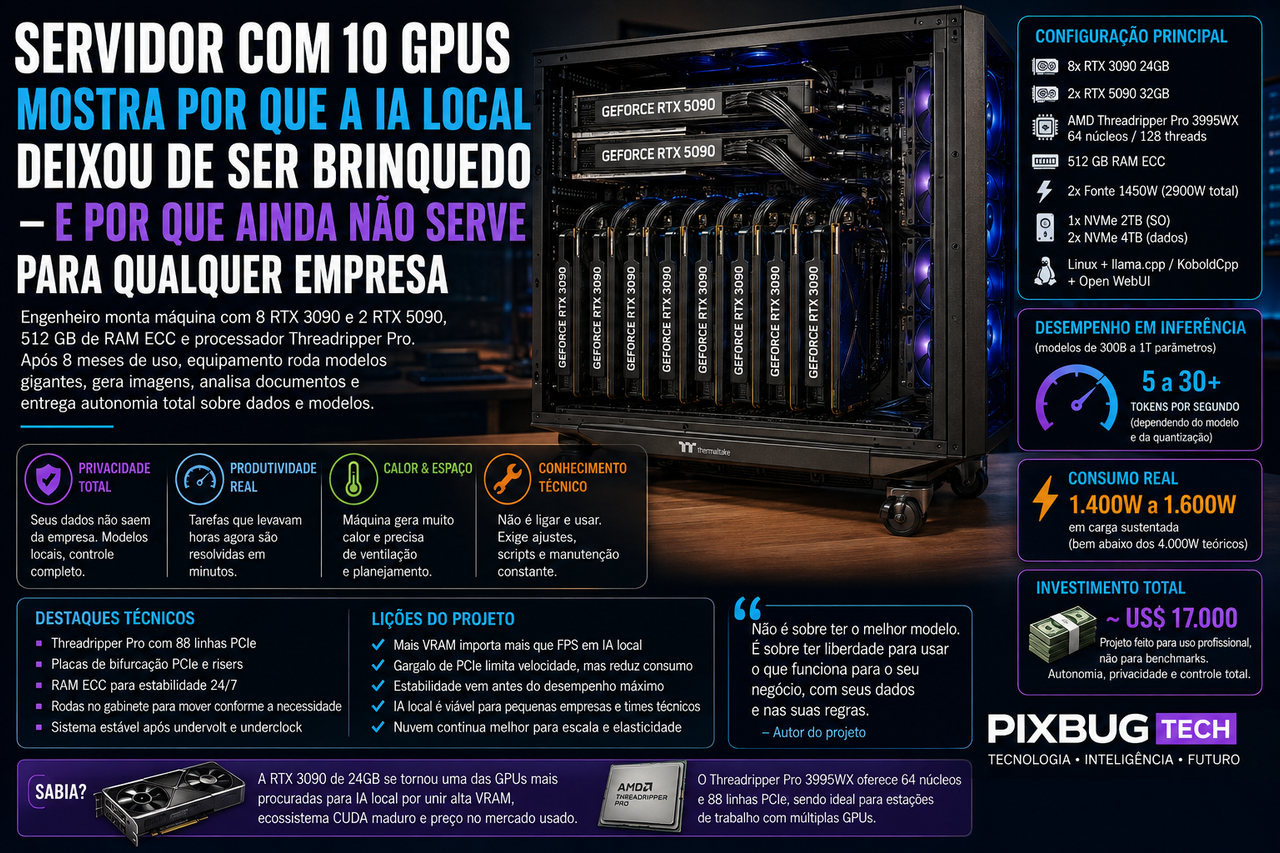
Um engenheiro de infraestrutura decidiu concentrar em uma única máquina oito placas GeForce RTX 3090, duas RTX 5090, 512 GB de memória RAM ECC e um processador AMD Threadripper Pro com 64 núcleos. Depois de aproximadamente oito meses de uso, o resultado não foi apenas uma demonstração extravagante de hardware. O equipamento passou a executar modelos de linguagem com centenas de bilhões de parâmetros, produzir imagens, analisar documentos e apoiar tarefas profissionais sem depender continuamente de APIs comerciais.
O projeto custou cerca de US$ 17 mil e entrega 256 GB de memória de vídeo distribuídos entre as dez placas. É uma configuração absurda para um computador doméstico, mas curiosamente racional quando observada como infraestrutura de uma pequena empresa. Em vez de pagar por créditos, limites de mensagens e processamento externo, o proprietário absorveu o custo antecipadamente e passou a controlar o equipamento, os modelos e os dados.
A experiência ajuda a responder uma pergunta que começa a aparecer fora dos círculos de entusiastas: em que momento comprar servidores próprios de inteligência artificial deixa de ser capricho e passa a fazer sentido econômico?
A resposta não cabe em uma comparação simples entre US$ 17 mil e uma assinatura mensal. O servidor demonstra que a IA local já é tecnicamente viável para certos profissionais e pequenas organizações, mas também expõe custos ocultos, gargalos de comunicação, riscos de estabilidade e uma dependência de conhecimento técnico que a nuvem convenientemente esconde.
Um “data center em uma caixa”, mas com compromissos importantes
A base do sistema é um AMD Ryzen Threadripper Pro 3995WX, processador lançado originalmente para estações de trabalho profissionais, com 64 núcleos, 128 threads e grande quantidade de pistas PCI Express. Essa disponibilidade de conexões é essencial para uma máquina com dez GPUs. Em computadores convencionais, simplesmente não existem pistas, slots ou espaço físico suficientes para manter tantas placas operando de maneira minimamente organizada.
A placa-mãe ASUS Pro WRX80E-SAGE/SE WiFi fornece a estrutura principal, complementada por três placas de bifurcação PCIe e dez extensores de comprimentos variados. O conjunto foi instalado em um gabinete Thermaltake Core W200, escolhido menos pela elegância do que pelo volume interno. Parte do espaço originalmente destinado a unidades de armazenamento precisou ser convertida em área para as GPUs.
O sistema possui oito RTX 3090 com 24 GB de memória cada e duas RTX 5090 com 32 GB. Somadas, as placas chegam aos 256 GB anunciados. Essa soma, porém, não deve ser confundida com uma única GPU dotada de 256 GB de memória contínua.
Cada placa mantém sua própria memória. Para executar um modelo maior do que a capacidade individual de uma GPU, ferramentas como llama.cpp e KoboldCpp distribuem camadas ou partes dos tensores entre as placas. O software precisa coordenar a passagem dos dados durante cada etapa da inferência. A memória total pode ser aproveitada, mas a comunicação entre as GPUs torna-se parte central do desempenho.
É justamente aí que aparece o principal compromisso do projeto. As RTX 3090 e RTX 5090 possuem enorme capacidade de processamento quando trabalham isoladamente, mas o servidor não utiliza uma interconexão de data center projetada para manter dez aceleradores trocando dados em altíssima velocidade. Grande parte da comunicação passa pelo PCI Express.
O resultado é um sistema com muita memória disponível, mas incapaz de manter todas as placas calculando em potência máxima durante toda a execução. As GPUs processam uma etapa e aguardam dados vindos das demais. O gargalo reduz a velocidade potencial, mas também produz um efeito inesperadamente útil: limita o consumo elétrico sustentado.
Dez GPUs não consomem tudo ao mesmo tempo
A especificação nominal das placas sugere um cenário quase impraticável. Cada RTX 3090 pode chegar a aproximadamente 350 watts, enquanto uma RTX 5090 possui potência gráfica de referência de 575 watts. Se todas trabalhassem simultaneamente perto do limite, somente as GPUs poderiam se aproximar de 4 mil watts, antes de considerar processador, memória, armazenamento, ventoinhas e perdas das fontes.
Na operação real com grandes modelos de linguagem, o autor relata consumo sustentado entre 1.400 e 1.600 watts para o sistema. Ainda é bastante energia — equivalente a manter um aquecedor elétrico potente ligado durante boa parte do dia —, mas está muito abaixo da soma teórica dos componentes.
O motivo não é uma eficiência milagrosa. As placas passam parte do tempo esperando umas pelas outras. Quando um modelo é dividido entre várias GPUs, os dados percorrem o barramento PCIe repetidamente. A capacidade computacional fica parcialmente ociosa enquanto a comunicação acontece.
Essa situação revela uma contradição interessante. O mesmo gargalo que impede o servidor de entregar toda a velocidade prometida pelas dez placas ajuda a torná-lo eletricamente administrável. O sistema deixa de ser uma coleção de GPUs trabalhando em paralelo com eficiência perfeita e passa a funcionar como uma grande linha de montagem: cada estágio realiza sua parte, mas alguns trabalhadores permanecem parados aguardando a peça seguinte.
O proprietário mantém a máquina ativa por cerca de 12 a 14 horas por dia. Considerando apenas a faixa de consumo informada durante cargas intensas, uma jornada desse tamanho pode representar algo entre 17 e 22 quilowatts-hora. O custo mensal dependerá da tarifa local, do tempo efetivo em carga, dos períodos de ociosidade e da utilização da RTX 5090 dedicada à geração de imagens.
Não é uma despesa desprezível. Também não é necessariamente proibitiva para uma empresa que usa intensamente modelos comerciais, processa documentos volumosos ou mantém vários profissionais consumindo APIs ao longo do dia. A comparação correta precisa incluir energia, manutenção, depreciação e tempo do responsável técnico, não apenas o preço inicial das placas.
O problema mais sério apareceu em frações de segundo
Apesar das duas fontes de alimentação oferecerem capacidade combinada de 2.900 watts, a máquina inicialmente sofria reinicializações aleatórias. O comportamento parecia ilógico: o consumo médio estava bem abaixo do limite das fontes, nenhuma proteção havia sido acionada e as placas não permaneciam próximas da potência máxima.
A causa provável estava nos picos transitórios. Quando várias GPUs aumentavam o consumo no mesmo instante para processar uma nova etapa, uma queda momentânea de tensão podia desestabilizar a placa-mãe e reiniciar o sistema. O valor médio observado nos painéis não mostrava adequadamente o que acontecia durante esses intervalos muito curtos.
A solução foi limitar potência e frequência. As RTX 3090 tiveram seus clocks travados em torno de 1.200 MHz e receberam limites de até 200 watts. A RTX 5090 principal foi configurada para operar perto de 2.000 MHz, com limite de aproximadamente 400 watts. A segunda 5090, reservada para o ComfyUI, pode permanecer sem a mesma restrição quando precisa gerar imagens ou vídeos.
Segundo o autor, depois desses ajustes o servidor passou a funcionar durante dias seguidos sem reinicializações, mesmo processando grandes quantidades de texto e imagens.
Essa talvez seja uma das lições mais importantes do projeto. Em sistemas de IA, desempenho máximo nem sempre é o melhor objetivo. Reduzir clocks e potência pode produzir uma pequena perda de velocidade, mas entregar estabilidade, previsibilidade térmica e menor risco elétrico. Uma empresa não se beneficia de alguns tokens adicionais por segundo se a máquina reinicia no meio de uma análise longa.
Também existe uma diferença entre montar algo que funciona em um teste e manter algo que funciona todos os dias. O segundo cenário exige scripts para reaplicar configurações, documentação da topologia PCIe, monitoramento das temperaturas e capacidade de diagnosticar falhas que não aparecem em computadores convencionais.
A IA local pode eliminar a dependência de uma API, mas cria outra dependência: alguém precisa compreender a máquina.
As RTX 3090 continuam valiosas por um motivo simples: memória
A presença de oito RTX 3090 em um projeto montado anos depois do lançamento dessas placas não é apenas uma tentativa de economizar. Para inferência local, os 24 GB de memória de cada unidade continuam sendo extremamente úteis.
Modelos de linguagem grandes exigem espaço para armazenar pesos, contexto e estruturas auxiliares. A velocidade importa, mas a primeira condição é conseguir carregar o modelo. Uma placa mais nova e rápida, porém equipada com pouca memória, pode simplesmente não comportar a carga desejada.
No mercado de usados, a RTX 3090 passou a ocupar uma posição peculiar. Foi criada para jogos e produção gráfica, mas tornou-se uma opção recorrente em laboratórios domésticos de IA porque combina suporte ao ecossistema CUDA, 24 GB de VRAM e disponibilidade relativamente ampla. O autor afirma ter comprado as unidades por valores entre US$ 750 e US$ 1.000, chegando a aproximadamente US$ 6.500 pelas oito placas.
As RTX 5090 cumprem funções diferentes. Uma atua como placa principal na distribuição do modelo, ajudando no processamento dos prompts e oferecendo 32 GB adicionais. A outra fica reservada para o ComfyUI, permitindo gerar imagens enquanto as demais GPUs continuam atendendo o modelo de linguagem.
A divisão é estrategicamente mais interessante do que usar todas as placas para uma única tarefa. Em uma pequena empresa, ter um modelo gigantesco produzindo texto com alguns tokens adicionais por segundo pode ser menos útil do que manter dois fluxos funcionando simultaneamente: um para análise e outro para criação visual.
O sistema também mostra que infraestrutura de IA não precisa ser homogênea para produzir valor. Equipamentos de gerações diferentes podem ser combinados, desde que o software permita controlar a distribuição das cargas. O preço dessa flexibilidade aparece na complexidade: placas distintas possuem consumo, temperatura, frequência, capacidade de memória e comportamento térmico diferentes.
O próprio autor afirma que, se refizesse o projeto, tentaria adquirir modelos mais uniformes de RTX 3090. Misturar versões de fabricantes e sistemas de refrigeração diferentes torna o controle térmico menos previsível.
A máquina executa modelos enormes, mas não derrota a nuvem
O servidor foi usado para testar variantes de DeepSeek, Nemotron Ultra, GLM, Qwen e Kimi. Segundo o relato, o melhor equilíbrio entre tamanho, qualidade e velocidade apareceu em modelos situados entre aproximadamente 300 bilhões e 600 bilhões de parâmetros, utilizando diferentes níveis de quantização.
Quantização é o processo de representar os pesos do modelo com menos bits. Isso reduz a quantidade de memória necessária e torna possível executar modelos enormes em hardware que não comportaria a versão original. A economia, entretanto, pode afetar precisão, qualidade e comportamento. Quanto mais agressiva a compressão, maior o risco de degradar determinadas capacidades.
O responsável também afirma ter carregado versões quantizadas de modelos ainda maiores, chegando à faixa de um trilhão de parâmetros. Conseguir carregar não significa, porém, obter uma experiência eficiente. Parte dos dados pode precisar permanecer na memória RAM convencional, muito mais lenta que a VRAM, e a comunicação entre dez placas adiciona latência.
Os benchmarks publicados mostram diferenças relevantes entre os modelos. Dependendo da arquitetura, do tamanho e da quantização, a geração variou de poucos tokens por segundo a mais de 30. Para tarefas de análise documental, pesquisa ou produção assistida, essa velocidade pode ser suficiente. Para atender muitos usuários simultaneamente, provavelmente não.
O próprio autor não recomenda a máquina para grande concorrência, treinamento intensivo ou tentativa de extrair o desempenho máximo das placas. O projeto foi construído para inferência de grandes modelos e para fluxos criativos de uma pessoa ou pequena equipe.
Essa ressalva impede uma conclusão exagerada. O servidor não substitui um data center, não oferece a elasticidade de uma nuvem e não acompanha automaticamente a chegada dos modelos proprietários mais avançados. Serviços comerciais podem distribuir requisições entre milhares de aceleradores, atualizar modelos sem intervenção do cliente e absorver picos de demanda.
A máquina local oferece outra coisa: autonomia.
Privacidade é o argumento mais forte, mas precisa ser tratada com seriedade
Quando um documento é processado localmente, seu conteúdo não precisa ser enviado a um provedor externo de IA. Para escritórios, consultorias, laboratórios, equipes de engenharia e empresas que manipulam informações estratégicas, esse controle pode ser mais importante do que alcançar a melhor pontuação possível em um benchmark.
A soberania dos dados, porém, não nasce automaticamente porque o servidor está dentro do prédio. É preciso proteger o sistema operacional, controlar usuários, limitar acesso remoto, registrar atividades, criptografar armazenamento e manter os modelos e interfaces atualizados.
O projeto utiliza Open WebUI na interface e llama.cpp ou KoboldCpp no processamento. O acesso remoto pode ser realizado por uma rede privada virtual. Essa arquitetura oferece bastante controle, mas também transfere para o proprietário responsabilidades normalmente assumidas pelo provedor de nuvem.
Uma instalação mal configurada pode expor documentos, interfaces administrativas ou o próprio servidor à internet. Modelos locais também podem processar arquivos maliciosos, seguir instruções escondidas em documentos ou gerar códigos inseguros. Local não é sinônimo de protegido; significa apenas que o perímetro de proteção mudou de lugar.
Há ainda uma limitação de hardware. A memória RAM principal é ECC, capaz de detectar e corrigir determinados erros, mas as GeForce usadas no projeto são placas de consumo. Elas não oferecem o mesmo conjunto de garantias, validações, gerenciamento remoto e suporte corporativo encontrado em aceleradores de data center.
Para uma pequena empresa, esse compromisso pode ser aceitável. Para hospitais, instituições financeiras ou infraestruturas críticas, a economia precisa ser confrontada com exigências de continuidade, suporte, certificação e responsabilidade.
As rodas resolvem um problema que o gabinete não consegue esconder
Um dos detalhes mais celebrados pelo autor foi a instalação de rodas no gabinete. Parece quase cômico diante de dez GPUs e meio terabyte de memória, mas resolve um problema bastante concreto: toda a energia consumida termina, em grande parte, convertida em calor no ambiente.
As temperaturas internas permaneceram relativamente controladas. Em repouso, as GPUs mais frias operariam perto dos 20 °C e a mais quente ficaria na faixa dos 40 °C. Durante inferências prolongadas, a maioria permaneceria em torno dos 60 °C. A RTX 5090 dedicada à geração visual poderia alcançar a casa dos 70 °C.
Isso significa que as placas estão refrigeradas, não que o calor desapareceu. As ventoinhas apenas transportam a energia térmica para fora do gabinete. Depois de algumas horas, o cômodo recebe o equivalente ao calor liberado por um aquecedor potente.
A solução foi mover o servidor. Quando o escritório está ocupado, a máquina pode ser levada para outro quarto e acessada pela rede. Quando o trabalho é remoto, volta para perto da conexão cabeada.
É uma resposta engenhosa para um laboratório doméstico, mas também revela a distância entre esse projeto e uma infraestrutura empresarial convencional. Um data center trata refrigeração, fluxo de ar, energia, prevenção de incêndio e redundância como partes centrais da arquitetura. Colocar rodas em um gabinete permite escolher qual cômodo ficará quente; não resolve o problema energético em escala.
Ainda assim, a ideia contém uma lição útil. A expansão da IA local não dependerá apenas de chips e modelos. Instalações elétricas, ar-condicionado, ruído, ventilação e espaço físico voltarão a importar. A nuvem tornou esses elementos invisíveis para o usuário. Trazer a computação de volta para dentro da empresa faz com que todos reapareçam.
US$ 17 mil podem ser baratos ou muito caros
O orçamento informado inclui cerca de US$ 6.500 nas oito RTX 3090, US$ 5.500 nas duas RTX 5090, pouco mais de US$ 1.000 no Threadripper Pro e aproximadamente US$ 950 na placa-mãe. Memória, gabinete, fontes, armazenamento, risers e placas de bifurcação completam o investimento.
O proprietário reconhece que a configuração seria difícil de reproduzir pelos mesmos valores. Parte dos componentes foi adquirida usada ou antes de aumentos nos preços de hardware e memória. Há também uma quantidade significativa de trabalho próprio que não aparece na planilha.
Essa última parte costuma ser ignorada nas comparações entre IA local e serviços em nuvem. O servidor não se montou, configurou ou estabilizou sozinho. Foram necessários conhecimentos de Linux, PCI Express, alimentação elétrica, refrigeração, drivers, modelos quantizados e distribuição de tensores. Se uma empresa precisar contratar esse trabalho, o custo aumenta.
Por outro lado, a nuvem também carrega despesas que se acumulam silenciosamente. APIs são cobradas por uso, planos mudam, limites podem ser reduzidos e modelos podem ser retirados. Uma empresa que processa grandes volumes diariamente pode gastar dezenas de milhares de dólares sem adquirir qualquer ativo.
O servidor próprio oferece previsibilidade depois da compra, mas somente quando permanece ocupado. Uma máquina de US$ 17 mil utilizada algumas horas por semana é um investimento ruim. O mesmo equipamento trabalhando todos os dias em tarefas que antes exigiam profissionais, serviços externos ou APIs caras pode se pagar.
A utilização é o ponto decisivo. A nuvem cobra quando o recurso é consumido e absorve períodos de ociosidade. A infraestrutura local cobra antecipadamente, consome energia e envelhece mesmo quando ninguém está usando.
A decisão correta não é ideológica. Depende do volume, da sensibilidade dos dados, da necessidade de modelos específicos, da tolerância a indisponibilidade e da capacidade técnica da organização.
Pequenas empresas podem ganhar autonomia, mas surge uma nova desigualdade
O projeto foi pensado para uma pequena operação criativa, com geração de textos, tradução, pesquisa, análise de dados e produção de imagens. É justamente esse perfil que pode se beneficiar primeiro de servidores locais: organizações que possuem fluxo constante, dados privados e profissionais capazes de transformar os modelos em ferramentas de trabalho.
Empresas sem equipe técnica, capital inicial ou volume suficiente continuarão dependentes de serviços externos. Isso pode criar uma divisão entre organizações capazes de construir sua própria infraestrutura cognitiva e aquelas obrigadas a aceitar preços, políticas e limitações definidas por fornecedores.
Grandes corporações já operam modelos internos ou ambientes privados de nuvem. O movimento mais interessante agora ocorre abaixo desse nível. GPUs usadas, modelos abertos e softwares como llama.cpp permitem que equipes pequenas montem estruturas que, poucos anos atrás, exigiriam servidores especializados muito mais caros.
Não significa democratização completa. US$ 17 mil continuam fora do alcance de muitos profissionais, especialmente em países com hardware importado, energia cara e crédito limitado. Também não inclui o custo de alguém responsável pela operação.
A IA local reduz uma forma de dependência e pode aprofundar outra: quem possui capital e conhecimento técnico ganha mais controle, enquanto os demais alugam inteligência por mensagem.
A verdadeira novidade não são as dez GPUs
É fácil olhar para o gabinete e enxergar apenas excesso. O número de placas, as duas fontes e os 512 GB de RAM produzem uma imagem perfeita para fóruns de hardware. Mas a parte mais importante do relato não está na quantidade de componentes.
A novidade é que o equipamento permaneceu útil depois que a curiosidade inicial passou.
Durante meses, o servidor foi incorporado à rotina profissional. Segundo seu responsável, tarefas que consumiam horas passaram a ser resolvidas em minutos, enquanto projetos de dias foram reduzidos a períodos menores. Essa avaliação é pessoal e não substitui métricas independentes, mas mostra que modelos locais começaram a atravessar a fronteira entre demonstração e infraestrutura.
O sistema não executa os melhores modelos proprietários do mercado, não possui suporte corporativo amplo e não entrega a eficiência de aceleradores conectados por redes de data center. Mesmo assim, oferece qualidade suficiente para trabalhos concretos, sem limite diário de mensagens e sem enviar todos os dados para outra companhia.
Esse “bom o bastante” pode ser mais transformador do que a liderança absoluta de um benchmark. Tecnologias mudam mercados quando deixam de exigir perfeição para se tornarem úteis.
A nuvem continuará dominante porque oferece conveniência, escala e acesso imediato às novidades. A IA local crescerá onde privacidade, previsibilidade e autonomia justificarem o trabalho adicional. Entre esses extremos, surgirão modelos híbridos: tarefas sensíveis executadas internamente, cargas esporádicas enviadas à nuvem e modelos menores operando diretamente em computadores pessoais.
O servidor com dez GPUs não representa o computador que todos terão em casa. Ele representa uma direção. Conforme modelos abertos se tornarem mais eficientes e placas antigas mantiverem valor por causa da memória, pequenas estruturas privadas de IA deixarão de parecer laboratórios excêntricos.
Ainda haverá fios, calor, ruído, reinicializações e contas de energia. A inteligência pode ser artificial, mas a infraestrutura continua obedecendo à física — e alguém ainda precisa colocar rodas no gabinete.
👉 Dúvida? Então veja mais em: https://pixbugtech.com/linksuteis