noticias
Seus chats podem estar treinando inteligências artificiais e desligar uma opção não apaga tudo
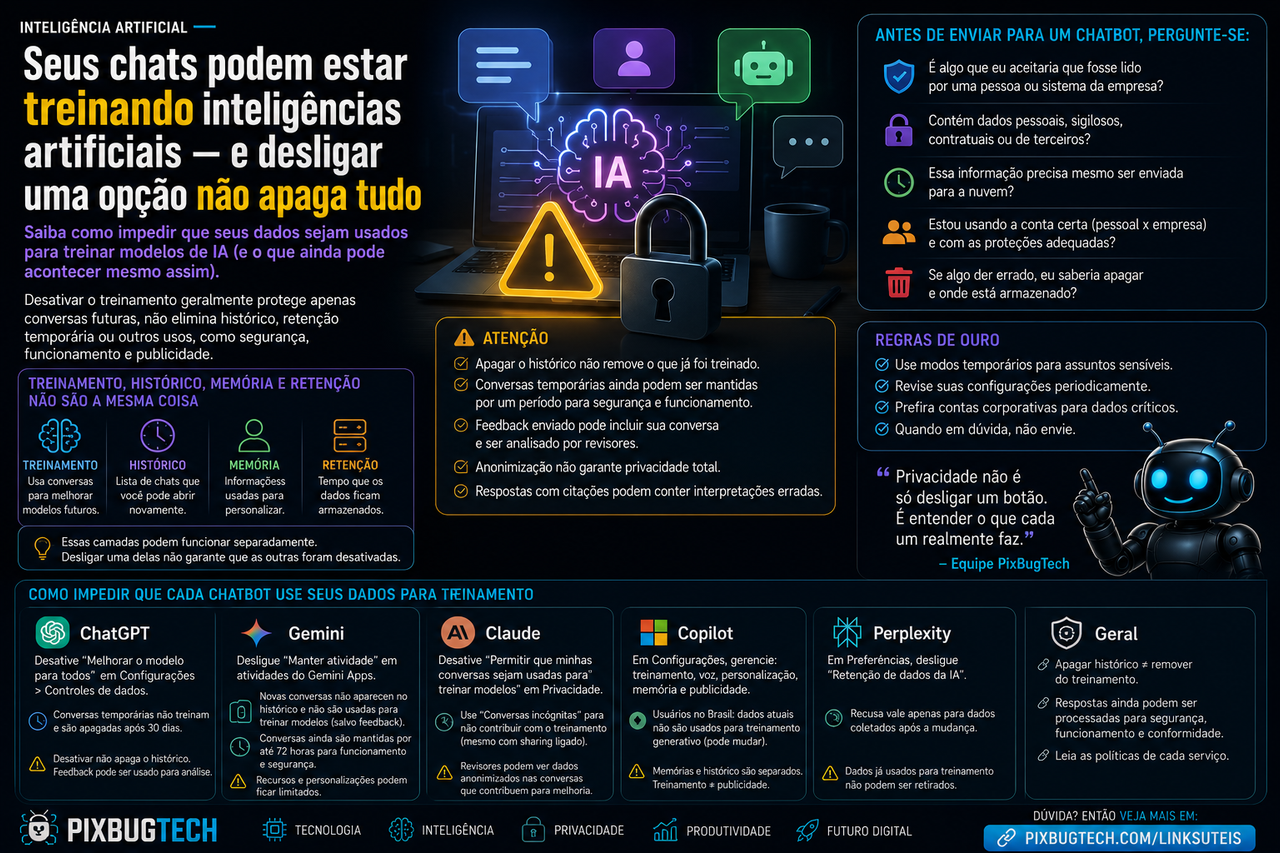
**ChatGPT, Gemini, Claude, Copilot e Perplexity oferecem algum tipo de controle sobre o uso das conversas no treinamento de seus modelos, mas cada empresa esconde decisões diferentes atrás de palavras parecidas. Desativar o treinamento geralmente protege apenas as interações futuras, não elimina necessariamente o histórico já armazenado e tampouco impede que dados sejam processados para segurança, funcionamento, publicidade ou melhoria geral dos serviços. A privacidade na inteligência artificial não depende de um único botão: exige compreender onde a conversa fica, por quanto tempo permanece e para quais finalidades ainda poderá ser utilizada.**
Milhões de pessoas conversam diariamente com sistemas de inteligência artificial como se estivessem diante de uma ferramenta privada de anotações. Enviam contratos, códigos-fonte, exames, informações familiares, problemas financeiros, estratégias comerciais, documentos jurídicos e detalhes sobre suas vidas pessoais. A interface é íntima, a resposta chega em tom individual e a conversa acontece longe dos olhos de outras pessoas, criando uma sensação quase automática de confidencialidade.
Essa sensação, entretanto, não corresponde necessariamente ao funcionamento técnico e contratual dos serviços. Em plataformas destinadas ao consumidor, as conversas podem ser armazenadas, analisadas por sistemas automatizados, utilizadas em processos de segurança, revisadas por equipes autorizadas e, dependendo das configurações da conta, incorporadas ao desenvolvimento de futuras versões dos modelos.
A maioria das grandes empresas oferece alguma forma de recusa. O problema é que cada uma utiliza nomes, caminhos e efeitos diferentes. Uma plataforma chama o controle de “melhorar o modelo”; outra fala em “manter atividade”; outra utiliza “retenção de dados da IA”. Em alguns casos, desligar a opção impede o treinamento, mas mantém o histórico. Em outros, reduz recursos de personalização ou desativa integrações. Há ainda serviços nos quais a recusa vale apenas para aquilo que for coletado depois da alteração.
O usuário imagina que está respondendo a uma pergunta simples: quero ou não quero que meus dados sejam usados para treinar inteligência artificial? Na prática, está administrando várias decisões independentes que as interfaces frequentemente apresentam como se fossem uma só.
Treinamento, histórico, memória e retenção não são a mesma coisa
A primeira confusão surge porque o termo “dados” é utilizado para representar operações diferentes. Uma conversa pode permanecer visível no histórico sem participar do treinamento. Pode desaparecer da interface e ainda ser conservada temporariamente nos servidores. Pode deixar de ser usada para aprimorar o modelo e continuar sendo processada para detectar fraude, abuso ou violações de segurança.
O treinamento é o processo pelo qual exemplos são utilizados para desenvolver ou melhorar o comportamento de futuros modelos. O histórico é a lista de conversas que o usuário consegue abrir novamente. A memória representa informações extraídas das interações para personalizar respostas futuras. A retenção define por quanto tempo os registros continuam armazenados, mesmo quando não estão sendo utilizados para treinamento.
Essas quatro camadas podem funcionar separadamente. Desligar o treinamento não apaga automaticamente o histórico. Apagar uma conversa pode não remover informações que já foram desconectadas da conta e analisadas por revisores. Desativar a memória impede personalização, mas não necessariamente altera as regras de treinamento. Utilizar um modo temporário reduz a persistência, mas ainda pode envolver retenção por determinado período para segurança.
Essa fragmentação dificulta a compreensão, mas também reflete necessidades reais. Um serviço precisa processar a solicitação para produzir a resposta. Pode precisar conservar registros durante algum tempo para investigar falhas, combater ataques e cumprir obrigações legais. O problema não está na existência dessas funções, mas na maneira pouco intuitiva como são comunicadas.
O usuário deveria conseguir responder claramente a cinco perguntas: minha conversa será usada para treinar modelos? Ela poderá ser vista por uma pessoa? Por quanto tempo será armazenada? Será lembrada em conversas futuras? Posso removê-la integralmente?
Na maioria das plataformas, essas respostas estão espalhadas por diferentes configurações e páginas de privacidade.
ChatGPT permite desligar o treinamento sem apagar o histórico
No ChatGPT, contas pessoais possuem um controle denominado “Melhorar o modelo para todos”. Ele pode ser encontrado nas configurações da conta, dentro da área de controles de dados.
Ao desligar essa opção, as novas conversas continuam aparecendo normalmente no histórico, mas deixam de ser utilizadas para aprimorar os modelos gerais. A configuração acompanha a conta e vale para os diferentes dispositivos nos quais o usuário estiver conectado.
Essa separação é importante porque permite manter a conveniência de recuperar conversas anteriores sem contribuir automaticamente para o treinamento. Desligar o recurso não impede o funcionamento normal do ChatGPT e não exige que o usuário abra mão de todo o histórico.
Para assuntos mais delicados, existe a conversa temporária. Esse modo não aparece no histórico, não cria memórias e não é utilizado para treinamento. Ainda assim, o conteúdo pode ser mantido nos sistemas por até 30 dias e analisado exclusivamente para monitoramento de abuso.
Isso mostra por que “temporário” não significa desaparecimento instantâneo. A conversa deixa de integrar a experiência persistente do usuário, mas ainda atravessa uma janela de retenção operacional.
Outro cuidado envolve o envio de feedback. Quando uma pessoa avalia negativamente uma resposta ou envia informações adicionais para explicar um problema, o material associado pode ser utilizado para análise e melhoria. A lógica é compreensível, porque a empresa precisa observar a falha relatada. Ainda assim, o usuário deve evitar incluir documentos sensíveis em uma conversa que pretende encaminhar como exemplo de erro.
Em ambientes empresariais, educacionais e corporativos, as regras costumam ser diferentes. Produtos organizacionais geralmente oferecem proteções adicionais e não utilizam os dados dos clientes para treinamento por padrão. Isso não significa que qualquer assinatura paga individual possua automaticamente a mesma garantia. É necessário distinguir uma conta pessoal premium de um ambiente empresarial contratado sob regras específicas.
Gemini exige uma troca mais visível entre privacidade e funcionalidade
O Google organiza grande parte do controle do Gemini por meio da opção “Manter atividade”. Quando ela está ligada, prompts, respostas, arquivos, imagens, telas compartilhadas, informações de uso e outros elementos podem ser armazenados na atividade da conta e utilizados para desenvolver serviços, incluindo modelos generativos.
Uma parte das conversas pode ser analisada por revisores humanos treinados. Antes dessa revisão, o Google afirma separar o conteúdo da conta do usuário, mas os registros avaliados podem permanecer conservados durante anos.
Ao desligar “Manter atividade”, as futuras conversas deixam de aparecer no histórico de atividade e não são usadas para treinar os modelos, salvo quando a pessoa escolhe enviar feedback. O material ainda é mantido por até 72 horas para que o serviço consiga responder, preservar contexto imediato, lidar com falhas e proteger seus sistemas.
Essa retenção curta é menor do que aquela aplicada ao modo temporário do ChatGPT, mas traz um custo funcional. Determinados aplicativos conectados e recursos personalizados podem deixar de funcionar quando a atividade está desligada.
O Gemini também possui conversas temporárias, que não são utilizadas para treinamento e permanecem armazenadas por até 72 horas. Elas são úteis quando o usuário precisa discutir algo que não deseja incluir na atividade persistente, mas continuam sujeitas ao processamento necessário para funcionamento e segurança.
Outro detalhe importante está nos diferentes tipos de mídia. Áudios, vídeos e compartilhamentos de tela do Gemini Live possuem controles próprios e não são utilizados para aprimorar os serviços por padrão em determinadas configurações. As transcrições textuais dessas conversas, porém, podem seguir as regras gerais de atividade.
Esse tipo de separação mostra como as políticas estão se tornando complexas. O usuário pode impedir o uso do áudio original, mas permitir o uso da transcrição; pode desligar o treinamento geral, mas enviar feedback que inclui o contexto da conversa; pode apagar o histórico do Gemini sem eliminar conteúdos armazenados em outros produtos do Google.
Quanto mais integrado se torna o assistente, mais difícil é localizar todas as cópias e derivados de uma mesma informação.
Claude oferece controle de melhoria e conversas incógnitas
O Claude permite que usuários de seus produtos pessoais decidam se suas conversas e sessões de programação poderão ajudar no aprimoramento do modelo. Essa escolha pode ser alterada nas configurações de privacidade.
Quando o compartilhamento está autorizado, a Anthropic afirma remover a ligação direta entre o conteúdo e identificadores como o endereço de e-mail antes da revisão, limitar o acesso a uma pequena quantidade de profissionais e aplicar mecanismos destinados a filtrar ou ocultar informações sensíveis.
A existência dessas proteções reduz parte do risco, mas não transforma uma conversa pessoal em ambiente apropriado para qualquer tipo de informação. Dados anonimizados ou desvinculados ainda podem conter nomes, números, trechos contratuais, códigos e características suficientes para revelar o contexto original.
O Claude também oferece conversas incógnitas. Elas não são utilizadas para aprimorar o modelo mesmo quando o compartilhamento geral da conta está habilitado.
Esse modo funciona como uma barreira adicional para assuntos pontuais, mas deve ser compreendido dentro da mesma lógica aplicada aos concorrentes: não contribuir para treinamento não significa impedir todo tratamento necessário para produzir a resposta, manter segurança ou cumprir exigências legais.
A distinção entre produtos pessoais e ambientes empresariais também é decisiva. Organizações que trabalham com propriedade intelectual, dados regulados ou informações de clientes deveriam operar sob contratos corporativos, políticas administrativas e controles de retenção apropriados. Utilizar uma conta pessoal e apenas desligar o treinamento pode ser insuficiente para atender às obrigações internas da empresa.
Copilot permite separar treinamento, memória e publicidade
O Microsoft Copilot possui controles independentes para treinamento de conversas escritas, treinamento de interações por voz, personalização, memória e publicidade. Essa separação é tecnicamente mais honesta, embora torne o painel mais complexo.
O usuário pode impedir que futuras conversas sejam usadas para treinamento e ainda manter a personalização. Nesse cenário, o Copilot continua lembrando elementos úteis para adaptar respostas, mas não utiliza essas interações para aprimorar os modelos generativos.
Também é possível apagar memórias específicas, eliminar toda a memória ou desativar a personalização. O histórico de conversas permanece separado e precisa ser administrado por outro caminho.
Para o público brasileiro, existe uma particularidade importante. A Microsoft informa que, atualmente, não utiliza para treinamento generativo os dados de usuários do Copilot localizados no Brasil, assim como ocorre em alguns outros países. Essa proteção regional pode mudar futuramente, e a própria empresa admite que poderá ampliar o treinamento e seus controles de recusa conforme as regras locais e a evolução do produto.
Isso não torna todas as interações invisíveis para a Microsoft. As conversas ainda podem ser processadas para fornecer o serviço, segurança, conformidade, melhoria geral do produto e outros usos descritos em sua política.
O controle de treinamento também não desativa anúncios personalizados. Essa é outra configuração, administrada na conta Microsoft.
A fragmentação pode parecer burocrática, mas revela uma realidade importante: uma empresa pode deixar de utilizar a conversa para treinar o modelo e continuar utilizando outros sinais para personalização ou publicidade. Privacidade de treinamento e privacidade comercial não são sinônimos.
Perplexity deixa claro que a recusa não retroage
Nas contas pessoais gratuitas ou pagas do Perplexity, a retenção de dados para treinamento fica habilitada por padrão. O usuário pode entrar nas configurações da conta, abrir a área de preferências e desligar a opção relacionada à retenção de dados da inteligência artificial.
A recusa não prejudica os recursos centrais do serviço, mas possui uma limitação expressa: ela vale somente para informações coletadas depois da mudança.
Dados que já tenham sido incorporados aos processos de treinamento não podem ser retirados individualmente. Essa limitação é comum em sistemas de aprendizado de máquina, porque o material deixa de existir apenas como um registro isolado e passa a influenciar estruturas estatísticas do modelo.
A transparência sobre essa impossibilidade é importante. Muitas pessoas acreditam que apagar a conta ou desligar uma opção obrigará a empresa a “desensinar” tudo o que o modelo aprendeu anteriormente. Em grande parte dos sistemas atuais, esse processo não é simples, individualizável ou garantido.
Mesmo com a retenção para treinamento desligada, o Perplexity continua processando informações para funcionamento, segurança, conformidade legal e melhoria do produto. Novamente, a recusa elimina uma finalidade específica, não todo o tratamento.
Contas empresariais seguem regras mais protetivas. A empresa afirma que os dados dessas organizações não são usados para treinamento e que os acordos com provedores externos impedem que modelos de terceiros aproveitem as consultas para suas próprias bases.
Essa diferença reforça uma conclusão recorrente: serviços voltados ao consumidor são construídos sob uma lógica de dados diferente daquela aplicada aos ambientes empresariais.
Apagar a conversa não significa retirar o que já foi aprendido
Uma vez que uma interação participa do treinamento, ela não permanece necessariamente armazenada como uma frase recuperável dentro do modelo. Durante o aprendizado, os sistemas ajustam bilhões de parâmetros com base em padrões estatísticos extraídos de grandes conjuntos de dados.
Isso torna difícil localizar a influência exata de uma única conversa. O modelo não funciona como um arquivo no qual alguém encontra uma pasta com o nome do usuário e apaga suas mensagens. A contribuição se mistura com enormes volumes de outros exemplos.
Essa característica não deve ser utilizada como desculpa para ignorar direitos de privacidade. Pelo contrário, mostra por que a prevenção é mais importante do que a tentativa de remoção posterior.
O usuário precisa tomar a decisão antes de enviar o material. Desativar o treinamento depois de meses de uso geralmente protege o futuro, não reescreve o passado.
Algumas empresas permitem excluir o histórico, baixar uma cópia das informações ou apagar a conta. Essas ações são relevantes e podem remover registros associados ao usuário dentro dos prazos previstos. Elas não garantem que um modelo já treinado seja reconstruído sem qualquer influência daquele material.
A indústria ainda desenvolve técnicas de desaprendizado de máquina, mas elas permanecem limitadas, caras e difíceis de verificar em modelos de grande escala.
A melhor proteção continua sendo não fornecer aquilo que não deveria sair do ambiente controlado.
A anonimização não torna qualquer documento seguro
Empresas de inteligência artificial frequentemente afirmam remover identificadores antes de utilizar conversas em revisões ou treinamentos. Essa prática é necessária, mas possui limites.
Um contrato pode não conter o nome do usuário da conta e ainda incluir nomes das partes, endereços, valores e números de documentos. Um trecho de código pode revelar o nome de uma empresa, domínios internos e arquitetura de sistemas. Um exame médico pode identificar uma pessoa por idade, condição rara, hospital e data.
Retirar o endereço de e-mail associado à conta não elimina essas informações.
Também existe o problema da reidentificação. Conjuntos aparentemente anônimos podem ser combinados com dados públicos ou internos para reconstruir a identidade de alguém. Quanto mais específico é o conteúdo, menor a proteção oferecida pela simples remoção de identificadores diretos.
Por isso, as recomendações das próprias empresas costumam ser claras: não envie informações confidenciais que você não gostaria que fossem vistas por revisores autorizados ou processadas nos sistemas.
Esse aviso parece contraditório com o marketing de ferramentas capazes de analisar qualquer documento. As plataformas anunciam produtividade sobre contratos, arquivos, códigos e relatórios, mas mantêm a responsabilidade final sobre o usuário.
O resultado é uma assimetria. A empresa oferece a capacidade; o cliente assume o risco de decidir se deve utilizá-la.
O modo temporário é útil, mas não é um cofre
Conversas temporárias, incógnitas ou sem atividade representam uma das melhores opções para assuntos pontuais. Elas reduzem a persistência, impedem o treinamento em diferentes serviços e evitam que o conteúdo seja utilizado como memória pessoal.
Mesmo assim, esses modos não deveriam ser tratados como ambientes de sigilo absoluto. Os dados ainda precisam chegar aos servidores, ser processados e permanecer durante algum período para segurança ou estabilidade.
Eles também não substituem criptografia controlada pelo cliente, infraestrutura local ou contratos empresariais. Uma conversa temporária continua ocorrendo dentro da plataforma do fornecedor.
Para dúvidas pessoais comuns, rascunhos e informações de baixo risco, esse nível pode ser suficiente. Para segredos comerciais, dados médicos identificáveis, estratégias jurídicas, credenciais, documentos financeiros ou informações protegidas por dever profissional, a análise precisa ser muito mais rigorosa.
O critério não deve ser apenas “a ferramenta promete não treinar”. Deve incluir a natureza do dado, a legislação aplicável, o contrato do serviço, o local de processamento e as consequências de uma exposição.
Em determinados casos, a resposta correta será utilizar uma solução empresarial. Em outros, executar um modelo local. E haverá situações em que o dado simplesmente não deve ser colocado em uma inteligência artificial generativa.
O envio de feedback pode reabrir a porta
Um detalhe frequentemente ignorado é o efeito do feedback. Mesmo quando o treinamento geral está desativado, o envio de uma avaliação pode incluir a conversa relacionada, arquivos associados e informações adicionais necessárias para investigar o problema.
Isso faz sentido operacionalmente. Uma empresa não consegue compreender por que uma resposta foi ruim sem examinar o contexto que a produziu.
O risco surge quando o usuário pressiona o botão de avaliação dentro de uma conversa que contém material confidencial. Ao fazer isso, pode autorizar um fluxo de tratamento diferente daquele aplicado às interações comuns.
Antes de enviar feedback, a pessoa deveria revisar o conteúdo e considerar se a empresa realmente precisa receber todo o material. Quando possível, é melhor reproduzir o erro em uma conversa sem informações sensíveis.
Esse cuidado é especialmente importante em ambientes profissionais. Um funcionário pode acreditar que está apenas ajudando a melhorar a ferramenta e acabar enviando documentos internos para uma análise humana ou técnica não prevista pela organização.
As empresas precisam incluir o feedback em suas políticas de uso de IA. Não basta dizer quais documentos podem ser enviados; é necessário definir também como falhas e comportamentos estranhos devem ser reportados.
Quem será impactado primeiro
Os primeiros afetados por essa complexidade são usuários comuns que começaram a tratar chatbots como confidentes digitais. Pessoas compartilham conflitos familiares, preocupações de saúde, dificuldades financeiras e dúvidas íntimas sem compreender que as conversas podem seguir regras distintas das de uma consulta profissional.
Estudantes também enfrentam riscos ao enviar trabalhos, dados pessoais e materiais de terceiros. Um documento acadêmico pode conter entrevistas, informações ainda não publicadas ou pesquisas protegidas por acordos institucionais.
Profissionais autônomos formam outro grupo vulnerável. Advogados, médicos, contadores, desenvolvedores, consultores e jornalistas possuem deveres de confidencialidade que não desaparecem porque a ferramenta é conveniente.
Dentro das empresas, o maior risco está na chamada inteligência artificial invisível. Funcionários utilizam contas pessoais para resumir documentos, revisar código ou preparar relatórios sem que a área de tecnologia conheça o fluxo. A organização perde controle sobre quais dados foram enviados, quais configurações estavam ativas e onde as informações permanecem.
As proteções individuais ajudam, mas não substituem uma política corporativa, contas administradas, classificação de informações e monitoramento adequado.
O que pode dar errado
O primeiro problema é acreditar que a configuração permanecerá inalterada. Empresas atualizam políticas, reorganizam menus e introduzem novos produtos. Uma opção desligada hoje pode ganhar subdivisões futuras ou deixar de controlar novos tipos de mídia.
O segundo risco é a sincronização incompleta. O usuário pode desativar o treinamento em um aplicativo e manter outra configuração ativa em uma ferramenta conectada, extensão, navegador ou serviço relacionado.
O terceiro está nos arquivos enviados. Uma conversa pode não ser utilizada para treinamento, mas o documento pode permanecer armazenado como parte de um projeto, notebook, agente personalizado ou base de conhecimento.
Também existe o risco de compartilhamento. Links públicos de conversas, projetos colaborativos e integrações podem expor conteúdo independentemente das configurações de treinamento.
Por fim, existe a falsa sensação de segurança produzida pela assinatura. Pagar por um plano individual não significa necessariamente receber as mesmas garantias de uma conta empresarial. O tipo de contrato, e não apenas o preço, define como os dados são tratados.
O que quase ninguém está discutindo
A principal discussão não deveria ser apenas como desligar o treinamento, mas por que a participação continua habilitada por padrão em tantos serviços de consumo.
O desenho baseado em recusa transfere a responsabilidade para o usuário. A empresa recebe uma fonte ampla de dados enquanto a pessoa precisa descobrir menus, interpretar termos técnicos e compreender consequências que nem sempre são apresentadas com clareza.
Essa lógica explora a inércia. A maioria das pessoas não altera configurações padrão, especialmente quando a opção está escondida atrás de expressões positivas como “ajudar a melhorar”.
Existe uma diferença psicológica entre perguntar “você autoriza o uso de suas conversas para treinamento?” e apresentar uma função chamada “melhorar o modelo para todos”. A segunda linguagem transforma a recusa em gesto aparentemente antissocial, como se proteger dados pessoais significasse impedir o progresso tecnológico.
Outro ponto negligenciado é a desigualdade entre usuários pessoais e empresariais. Organizações que pagam por contratos corporativos recebem garantias mais claras, menor retenção e ausência de treinamento. O consumidor comum frequentemente recebe uma experiência financiada parcialmente pelo valor de suas interações.
A privacidade passa a funcionar como recurso premium.
No futuro, essa divisão poderá criar dois tipos de inteligência artificial: uma versão popular, personalizada e alimentada por grandes fluxos de dados pessoais; e outra, empresarial, contratualmente isolada e protegida.
Análise da equipe PixBugTech
A possibilidade de desligar o treinamento é positiva, mas não deveria ser confundida com controle completo sobre os dados. As plataformas avançaram na oferta de configurações, porém continuam apresentando uma arquitetura fragmentada, na qual treinamento, histórico, memória, publicidade e retenção precisam ser administrados separadamente.
O ChatGPT oferece um dos controles mais diretos, permitindo manter o histórico sem participar do treinamento. O Gemini possui regras mais detalhadas, mas cobra um preço funcional quando a atividade é desligada. O Claude combina configuração de melhoria com modo incógnito. O Copilot separa treinamento, memória e publicidade, enquanto o Perplexity deixa explícito que a recusa não remove informações já utilizadas.
Nenhum desses sistemas deveria receber informações críticas apenas porque o botão correto foi desligado.
A atitude mais madura consiste em classificar o conteúdo antes do envio. Informações públicas e rascunhos comuns apresentam risco relativamente baixo. Documentos internos, dados pessoais, credenciais e materiais protegidos exigem ferramentas e contratos adequados. Alguns conteúdos devem permanecer fora dos chatbots de consumo.
No curto prazo, usuários precisarão revisar regularmente suas configurações. No médio prazo, empresas e escolas terão de oferecer orientações claras sobre quais plataformas podem ser utilizadas. No longo prazo, reguladores poderão exigir privacidade por padrão e controles comparáveis entre diferentes serviços.
O trade-off permanecerá. Mais histórico e memória produzem respostas personalizadas. Menor retenção reduz conveniência. Compartilhar conversas pode ajudar os modelos a melhorar, mas também transfere parte da vida digital do usuário para sistemas que ele não controla.
O melhor botão de privacidade ainda é não enviar
Desligar o treinamento vale a pena. Utilizar conversas temporárias também. Apagar históricos antigos, revisar memórias e controlar integrações são medidas sensatas.
Nenhuma delas oferece a mesma proteção de manter a informação fora do sistema.
Antes de colar um contrato, código, laudo, senha ou conversa pessoal, o usuário deveria imaginar que aquele conteúdo poderá permanecer temporariamente em servidores, ser processado por sistemas de segurança ou escapar do contexto original por falha humana ou técnica.
A pergunta não deve ser apenas “esta empresa promete não treinar com meus dados?”. Deve ser “eu aceitaria que esse conteúdo saísse do meu controle?”.
A inteligência artificial pode organizar pensamentos, acelerar trabalho e ampliar capacidades. Mas sua conveniência não altera a natureza da informação entregue.
Um chatbot não precisa ter intenção maliciosa para criar um problema de privacidade. Basta que o usuário confunda uma conversa confortável com um ambiente confidencial.
As configurações ajudam a reduzir o risco.
A prudência continua sendo a proteção mais eficiente.
👉 Dúvida? Então veja mais em: https://pixbugtech.com/linksuteis