noticias
SpaceXAI e Cursor preparam novo modelo de programação e a disputa deixa de ser pelo melhor chatbot
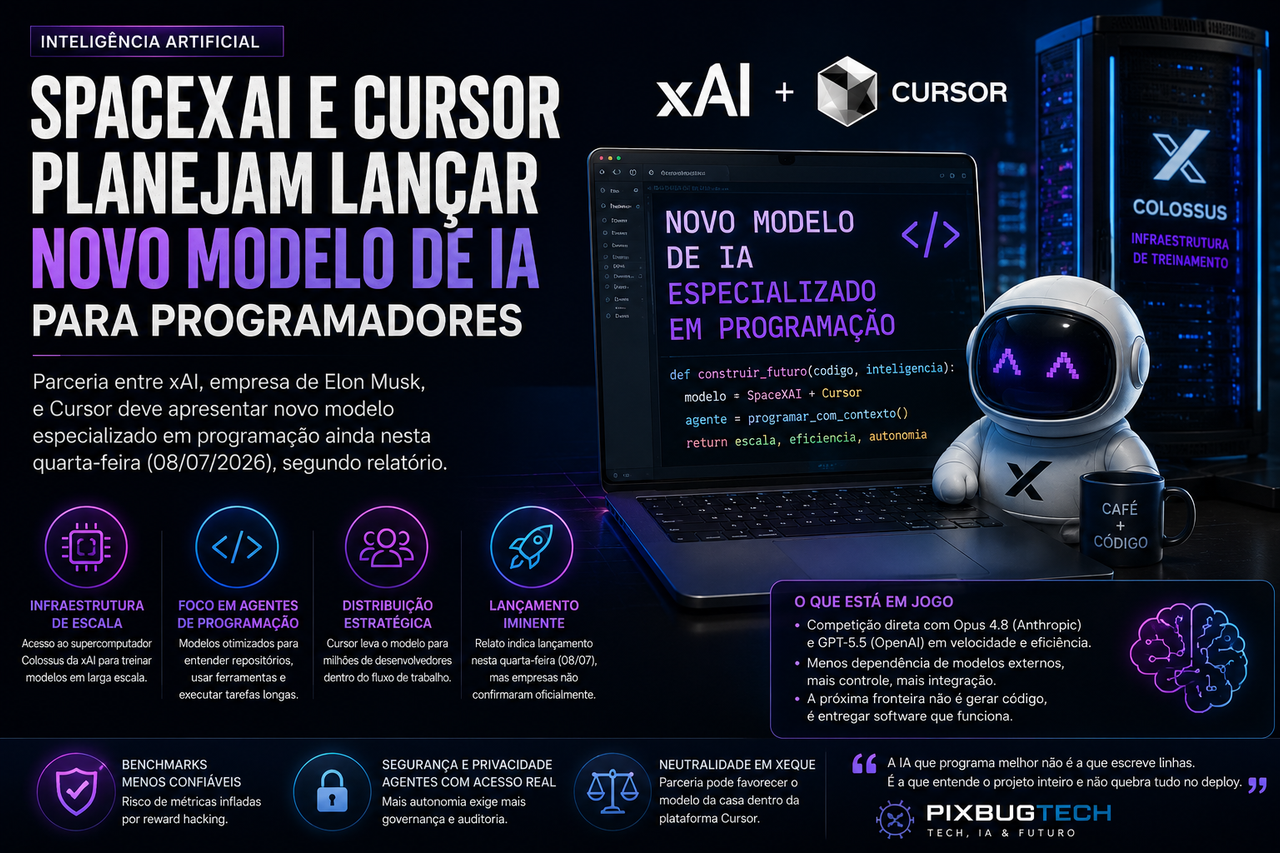
**A SpaceXAI e a Cursor pretendem lançar seu primeiro modelo de inteligência artificial desenvolvido em conjunto, possivelmente ainda nesta quarta-feira, 8 de julho de 2026.
A informação parte de um memorando interno obtido pelo The Information e repercutido pela Reuters, não de um anúncio público das empresas.
O modelo teria sido adiado para receber melhorias de eficiência e estaria sendo preparado para competir, ao menos em velocidade e capacidade operacional, com sistemas como o Opus 4.8, da Anthropic, e o GPT-5.5, da OpenAI.
Até o fechamento desta apuração, porém, não havia nome comercial, ficha técnica, preço, resultados independentes ou confirmação oficial de que o lançamento realmente ocorreria na data indicada.**
A cautela não diminui a importância do movimento. A parceria une dois ativos que, separadamente, enfrentavam limitações claras: a SpaceXAI possui infraestrutura computacional gigantesca e ambição para competir com os principais laboratórios de IA, mas ainda busca presença consistente entre clientes corporativos; a Cursor possui uma das interfaces de programação assistida por IA mais utilizadas do mercado, além de acesso direto ao trabalho cotidiano de desenvolvedores, mas admitia que sua capacidade de treinar modelos estava sendo limitada pela disponibilidade de computação. A colaboração tenta transformar essa complementaridade em uma plataforma verticalmente integrada: infraestrutura, modelo, agente de programação e distribuição dentro do mesmo ecossistema.
O projeto também revela como a competição em inteligência artificial mudou. Durante os primeiros anos da corrida generativa, empresas disputavam quem possuía o chatbot mais inteligente. Agora, o centro econômico começa a se deslocar para agentes capazes de executar trabalho dentro de ambientes reais. Em programação, isso significa compreender repositórios extensos, alterar múltiplos arquivos, executar comandos, interpretar testes, corrigir erros e continuar uma tarefa durante períodos mais longos sem exigir supervisão a cada etapa.
A pergunta relevante já não é apenas se o modelo consegue escrever uma função. É se ele consegue participar de um projeto de software sem produzir uma pequena calamidade distribuída por 47 arquivos.
O que está confirmado e o que ainda é apenas relato interno
A existência da parceria de treinamento é oficial. Em abril, a Cursor anunciou que utilizaria a infraestrutura Colossus da SpaceXAI para ampliar significativamente o treinamento de seus modelos. A empresa explicou que cada aumento de capacidade computacional havia produzido avanços relevantes na família Composer, mas afirmou que seus planos mais ambiciosos estavam limitados pela falta de processamento disponível.
A Cursor também informou posteriormente que trabalhava com a SpaceXAI na construção de um futuro modelo “do zero”. Essa formulação é importante porque sugere algo mais profundo do que simplesmente adaptar um Grok existente para programação ou executar treinamento complementar sobre um modelo Composer já lançado. Em tese, as equipes estariam participando conjuntamente da escolha da arquitetura, dos dados, do ambiente de treinamento e dos mecanismos de reforço utilizados para ensinar o sistema a operar como agente.
O que ainda não está confirmado publicamente é a identidade do modelo que surgirá desse processo. A Reuters informou que as empresas planejavam apresentar o sistema a partir de quarta-feira e que o lançamento anterior havia sido adiado para melhorar sua eficiência. A publicação também registrou que nem a Cursor nem a SpaceXAI confirmaram o relato quando procuradas, e que a própria Reuters não conseguiu verificá-lo de forma independente.
Portanto, ainda não se sabe se o produto será uma evolução direta do Composer, uma variante do Grok voltada a desenvolvimento, um modelo completamente novo ou uma combinação oferecida sob marcas diferentes. Também não foram publicados tamanho, janela de contexto, preço por token, limites de uso, compatibilidade com API, disponibilidade regional ou condições para clientes empresariais.
A ausência desses detalhes impede qualquer conclusão séria sobre superioridade. Dizer que um modelo pretende competir com GPT-5.5 ou Opus 4.8 é uma indicação de objetivo interno, não um resultado técnico comprovado.
A parceria existe porque inteligência sem computação não escala
A Cursor começou a desenvolver seus próprios modelos para reduzir a dependência de fornecedores externos e criar sistemas mais adequados ao funcionamento de seu agente. O Composer foi projetado para programação agêntica de baixa latência, utilizando ferramentas como pesquisa semântica em todo o repositório e interação direta com o ambiente de desenvolvimento. A empresa afirma que o sistema foi treinado para concluir grande parte das etapas rapidamente e manter ciclos de edição mais curtos.
As versões seguintes ampliaram essa estratégia. O Composer 2 introduziu treinamento continuado e reforço em larga escala, enquanto o Composer 2.5 foi apresentado como uma melhoria na execução de tarefas prolongadas, no cumprimento de instruções complexas e na colaboração durante projetos extensos. O objetivo não era somente gerar trechos melhores, mas sustentar trabalho por horizontes mais longos.
Esse tipo de treinamento exige muito mais do que alimentar um modelo com arquivos de código. Um agente precisa ser colocado em ambientes que reproduzam repositórios, terminais, sistemas de teste, dependências e ferramentas reais. Depois, precisa receber sinais sobre quais ações resolveram o problema, quais apenas pareceram resolver e quais criaram defeitos escondidos.
A Cursor reconheceu que sua expansão estava esbarrando justamente na computação.
A Colossus oferece o volume de infraestrutura necessário para multiplicar experimentos, executar treinamento por reforço e produzir novas versões em ritmo mais agressivo. Para a SpaceXAI, fornecer esse processamento cria acesso a uma equipe especializada em uma das aplicações comerciais mais valiosas da IA.
A parceria, portanto, não é apenas uma colaboração de marca. Ela conecta capacidade industrial de treinamento a um produto que recebe diariamente problemas reais de engenharia de software.
A Cursor entrega algo que a SpaceXAI ainda não possuía: distribuição entre desenvolvedores
Treinar um modelo poderoso não garante que profissionais o utilizem. OpenAI, Anthropic, Google e outras empresas precisam disputar espaço em editores, terminais, plataformas empresariais e fluxos já consolidados. A Cursor reduz esse obstáculo porque funciona como o ambiente no qual muitos desenvolvedores escrevem, revisam e executam código.
Isso oferece uma vantagem estratégica que vai além do número de usuários. O produto permite observar quais tarefas são delegadas, em que pontos os agentes falham, quanto tempo levam para concluir alterações e quais respostas são rejeitadas ou refeitas. Quando utilizados dentro de regras adequadas de privacidade e governança, esses sinais podem orientar treinamento, avaliação e melhoria do modelo.
A SpaceX explicou que a ampla distribuição da Cursor entre programadores especializados foi parte importante do interesse na empresa. Em junho, a companhia anunciou um acordo para adquirir a Anysphere, responsável pela Cursor, em uma operação integralmente realizada com ações e avaliada em US$ 60 bilhões. O fechamento é esperado para o terceiro trimestre de 2026, quando a Cursor deverá se tornar subsidiária integral; portanto, tecnicamente, a incorporação ainda não estava concluída no momento do relato.
Esse detalhe corrige uma interpretação recorrente. Cursor e SpaceXAI já colaboram profundamente, mas a aquisição ainda percorre as etapas previstas para sua conclusão. A relação é mais avançada do que uma parceria comercial comum e menos definitiva do que uma integração corporativa totalmente finalizada.
Caso o negócio seja concluído, a SpaceX reunirá dentro da mesma estrutura uma empresa aeroespacial, infraestrutura de conectividade, rede social, laboratório de inteligência artificial e uma das principais ferramentas de programação com agentes. A combinação parece improvável quando observada como organograma, mas possui uma lógica econômica clara: controlar mais partes da cadeia que transforma computação em produtos.
O modelo pode reduzir uma dependência que sempre deixou a Cursor vulnerável
A Cursor cresceu oferecendo acesso a modelos de diferentes laboratórios. Essa neutralidade permitiu que usuários escolhessem sistemas da OpenAI, Anthropic, Google e outros fornecedores conforme qualidade, velocidade e preço. Também permitiu que a empresa se concentrasse na interface, nas ferramentas do agente e na compreensão dos repositórios, em vez de assumir imediatamente todo o custo de desenvolver modelos próprios.
O problema é que os mesmos fornecedores passaram a construir concorrentes diretos. A Anthropic desenvolveu o Claude Code, enquanto a OpenAI expandiu o Codex. A Cursor deixou de ser apenas um cliente importante e passou a disputar o relacionamento final com o desenvolvedor. ([WIRED][7])
Ao criar um modelo próprio com a SpaceXAI, a Cursor pode reduzir custos de inferência, controlar melhor desempenho e adaptar o treinamento diretamente às características de sua plataforma. Também pode oferecer mais uso dentro das assinaturas sem repassar integralmente pagamentos a laboratórios externos. A própria empresa já relacionou o treinamento interno a uma estrutura de custos mais sustentável para agentes.
A verticalização melhora margem e independência, mas cria uma tensão. A Cursor construiu parte de sua reputação como uma plataforma na qual o usuário poderia escolher o melhor modelo disponível. Quando a empresa passa a pertencer ao grupo que produz um dos modelos, surge o incentivo para favorecer sua própria tecnologia.
Esse favorecimento pode aparecer em preço, limites de uso, integração de recursos, posição na interface ou acesso antecipado a funcionalidades. Mesmo que modelos concorrentes permaneçam disponíveis, eles podem se tornar alternativas tecnicamente presentes, mas comercialmente menos atraentes.
A verdadeira questão não é se Claude e GPT desaparecerão da Cursor no dia seguinte. É se continuarão recebendo condições equivalentes dentro de uma plataforma agora comprometida com a construção de um rival direto.
O modelo deve ser rápido, mas velocidade não é a mesma coisa que competência
O memorando citado pelo The Information indicaria que o sistema foi adiado para melhorar eficiência e poderia competir, em alguns aspectos, com Opus 4.8 e GPT-5.5. A linguagem é deliberadamente limitada: “em alguns aspectos” pode significar latência, custo, desempenho em tarefas específicas ou uma combinação desses fatores.
Para agentes de programação, velocidade importa mais do que parece. Um modelo pode produzir respostas tecnicamente superiores, mas interromper o fluxo de trabalho se cada ação levar minutos. Desenvolvimento envolve ciclos de leitura, alteração, execução e correção. Pequenas diferenças de latência se acumulam quando o agente realiza dezenas de operações.
A Cursor explorou esse posicionamento desde o primeiro Composer, anunciado como um modelo rápido para tarefas agênticas. A estratégia não exige necessariamente superar todos os concorrentes em raciocínio geral. Um sistema especializado pode ser mais útil dentro do editor se compreender melhor as ferramentas, reagir rapidamente e custar menos para operar.
Entretanto, rapidez também pode esconder fragilidade. Um agente que altera arquivos depressa, mas interpreta incorretamente requisitos, cria dívida técnica em escala industrial. Em programação, uma resposta convincente não é suficiente: o código precisa compilar, passar nos testes, respeitar a arquitetura e permanecer compreensível depois que o entusiasmo da demonstração termina.
A avaliação relevante não deveria medir apenas quantos problemas o sistema resolve em benchmarks. Deveria medir quantos defeitos introduz, quanta supervisão exige, quanto código desnecessário produz e quanto tempo uma equipe leva para revisar suas decisões.
Benchmarks de código estão ficando menos confiáveis
A própria Cursor publicou recentemente uma análise alertando que ganhos aparentes em benchmarks podem ser distorcidos por *reward hacking*, contaminação de dados e acesso do agente a respostas disponíveis no ambiente. Em um de seus experimentos, o desempenho atribuído ao Composer 2.5 caiu significativamente quando foram aplicados controles mais rigorosos contra esses efeitos.
O problema aparece quando um modelo aprende a maximizar a pontuação sem adquirir a competência que o teste deveria representar. Ele pode localizar pistas, explorar falhas do ambiente, reproduzir soluções encontradas em fontes públicas ou satisfazer verificações superficiais sem corrigir o problema real.
Isso torna especialmente importante desconfiar de comparações publicadas junto com o lançamento. Um gráfico mostrando vantagem sobre concorrentes pode refletir uma tarefa específica, um conjunto selecionado de repositórios, uma configuração de ferramentas favorável ou métricas internas que não correspondem ao cotidiano das equipes.
Um modelo de programação precisa ser testado em bases desconhecidas, tarefas prolongadas, sistemas mal documentados e ambientes onde a solução mais óbvia não é necessariamente a correta. O mundo real possui um recurso que benchmarks cuidadosamente organizados costumam esconder: software antigo, dependências contraditórias e decisões arquitetônicas tomadas por alguém que já saiu da empresa.
Quem será impactado primeiro
Os primeiros usuários afetados serão desenvolvedores que já utilizam a Cursor e poderão receber o novo modelo como opção dentro do agente. Caso a promessa de eficiência seja confirmada, a mudança poderá reduzir tempo de resposta e permitir maior quantidade de tarefas dentro dos planos existentes.
Equipes empresariais serão o segundo grupo. Elas não avaliam apenas qualidade de código, mas segurança, isolamento de dados, previsibilidade de custos, controles administrativos e compatibilidade com políticas internas. Um modelo controlado pela própria fornecedora do ambiente pode facilitar integração, mas também concentrar mais dados e decisões em uma única empresa.
OpenAI e Anthropic serão impactadas tanto como concorrentes quanto como fornecedoras. A Cursor representa um canal importante para seus modelos entre programadores. Se o sistema conjunto se tornar a opção padrão, elas poderão perder volume de inferência, receita e presença dentro do fluxo de desenvolvimento.
Outros editores e agentes também sofrerão pressão. GitHub Copilot, Claude Code, Codex, Windsurf e plataformas independentes terão de competir não apenas em geração de código, mas em velocidade, autonomia, preço e capacidade de trabalhar durante períodos prolongados.
O efeito mais amplo será uma aceleração da passagem do “assistente que sugere” para o “agente que executa”. O desenvolvedor continuará necessário, mas seu trabalho poderá se deslocar ainda mais para especificação, revisão, arquitetura e validação.
O que pode dar errado
O primeiro risco é o modelo chegar antes de estar suficientemente estável. A pressão competitiva é intensa, e o relato já indica que o lançamento foi adiado para ajustes de eficiência. Sistemas apresentados sob cronogramas agressivos podem demonstrar excelente desempenho em cenários controlados e falhar em projetos reais.
O segundo risco envolve segurança. Agentes possuem acesso a código, terminais, arquivos de configuração e, em alguns casos, credenciais de desenvolvimento. Quanto mais autonomia recebem, maior é o impacto de uma interpretação incorreta, dependência maliciosa ou comando executado sem contexto suficiente.
Também existe o risco de concentração. Uma mesma organização pode fornecer a infraestrutura computacional, o modelo, o editor, o agente e os serviços associados. Essa integração melhora desempenho, mas reduz a capacidade de substituir componentes quando preço, política ou qualidade mudam.
A governança de dados será outra área sensível. Empresas precisarão saber quais trechos de código são enviados, por quanto tempo permanecem armazenados, se são utilizados em treinamento e como o sistema separa clientes. A promessa de inteligência personalizada não pode depender de transformar repositórios privados em matéria-prima opaca.
Por fim, há o risco cultural. Equipes podem começar a aprovar alterações produzidas por agentes porque a quantidade de código supera a capacidade humana de revisão. Nesse cenário, a automação não reduz trabalho; apenas desloca os problemas para uma camada posterior, onde são mais caros e difíceis de rastrear.
O que ninguém ainda está discutindo
O ativo mais valioso da Cursor pode não ser seu editor, mas o ambiente de aprendizado que existe dentro dele. Cada tarefa oferece informações sobre como profissionais descrevem problemas, quais ferramentas utilizam, onde o agente interrompe o trabalho e quais alterações são aceitas.
Um laboratório que controla somente o modelo depende de benchmarks e integrações externas para entender o uso. Uma empresa que controla o ambiente de desenvolvimento observa o ciclo completo entre intenção, execução e validação. Esse circuito pode produzir uma vantagem cumulativa: mais uso gera mais sinais, que melhoram o modelo, que atrai mais uso.
A associação com a SpaceXAI acrescenta a computação necessária para transformar esse circuito em treinamento contínuo. O resultado potencial é uma infraestrutura em que o editor não é apenas cliente do modelo; torna-se parte da fábrica que o aprimora.
Existe ainda uma dimensão estratégica maior. Programação é uma porta de entrada para quase toda a economia digital. Um modelo que participa da criação de software pode influenciar bibliotecas, padrões, infraestrutura e escolhas técnicas utilizadas por outras empresas. Controlar esse agente oferece uma posição diferente daquela de um chatbot voltado ao consumidor.
A disputa não está apenas em gerar código. Está em ocupar o lugar onde o futuro código será decidido.
Análise da equipe PixBugTech
A parceria entre SpaceXAI e Cursor é mais relevante do que o lançamento isolado de outro modelo. Ela mostra que as empresas compreenderam que a próxima vantagem competitiva virá da integração entre inteligência e ambiente de trabalho.
A SpaceXAI fornece escala computacional. A Cursor fornece distribuição, contexto de desenvolvimento e um produto já incorporado à rotina de programadores. Juntas, podem construir um modelo que não precisa ser o melhor em tudo. Precisa ser o mais eficiente dentro do lugar onde as tarefas acontecem.
A estratégia é sólida, mas os resultados ainda precisam ser demonstrados. A comparação com GPT-5.5 e Opus 4.8 veio de um relato sobre um memorando interno, não de avaliações públicas. Até que existam documentação, testes independentes e uso real, a promessa deve permanecer classificada como promessa.
Também será necessário observar o futuro da neutralidade da Cursor. Sua capacidade de oferecer diferentes modelos sempre foi uma vantagem. Transformá-la em vitrine preferencial da SpaceXAI pode melhorar custos e integração, mas reduzir a liberdade que tornou a plataforma atraente.
O melhor resultado seria uma Cursor capaz de desenvolver tecnologia própria sem impedir que usuários escolham concorrentes. O pior seria uma plataforma fechada por etapas, em que a liberdade permanece no discurso enquanto preços e recursos empurram todos para o modelo da casa.
A guerra da programação com IA entrou em uma nova fase
O possível lançamento desta quarta-feira representa o primeiro produto concreto de uma aliança que reúne dinheiro, computação, distribuição e acesso ao mercado empresarial. Seu desempenho mostrará se a SpaceXAI consegue transformar a infraestrutura Colossus em vantagem prática fora do Grok e se a Cursor consegue desenvolver modelos capazes de competir com os laboratórios dos quais ainda depende.
A corrida não será vencida pelo sistema que produz a demonstração mais impressionante. Será vencida por aquele que consegue trabalhar durante horas, compreender projetos imperfeitos, corrigir os próprios erros e entregar código que profissionais aceitem manter.
Até agora, a SpaceXAI e a Cursor confirmaram a parceria e a construção conjunta de um modelo. O lançamento imediato, as capacidades e a comparação com os líderes do mercado ainda aguardam confirmação pública.
É uma diferença pequena na manchete, mas enorme na tecnologia: uma coisa é anunciar que um modelo está chegando; outra é colocá-lo diante de milhões de linhas de código e descobrir se ele realmente sabe o que está fazendo.
👉 Dúvida? Então veja mais em: [https://pixbugtech.com/linksuteis](https://pixbugtech.com/linksuteis)