noticias
Teste com PDF de 200 páginas expõe o limite das IAs: contexto gigante não significa compreensão
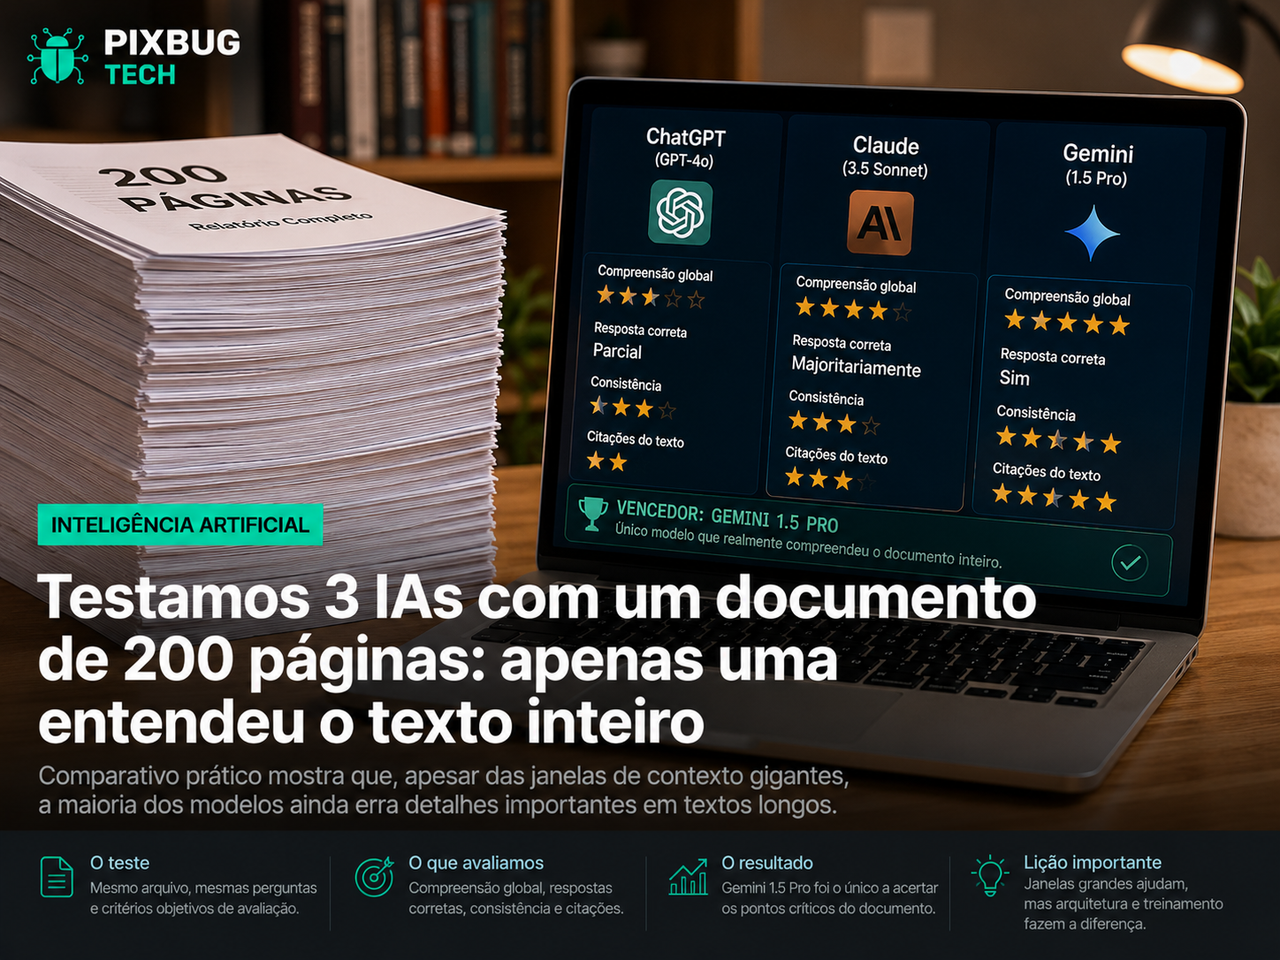
**Categoria editorial:** Inteligência Artificial
Teste com PDF de 200 páginas expõe o limite das IAs: contexto gigante não significa compreensão
**Linha fina:** GPT-5.6 Luna, Claude Sonnet 5 e Gemini 3.6 Flash conseguem receber documentos enormes, mas um teste prático mostra que localizar informação, explicar relações e sustentar respostas continuam sendo problemas diferentes.
**Meta description:** Teste com GPT-5.6 Luna, Claude Sonnet 5 e Gemini 3.6 Flash mostra por que contexto longo não garante compreensão de documentos extensos.
**Slug:** `ia-documentos-longos-contexto-compreensao`
Matéria completa
Enviar um PDF de 200 páginas para uma inteligência artificial já deixou de ser uma demonstração impressionante por si só. Modelos atuais conseguem receber centenas de milhares — e, em alguns casos, cerca de um milhão — de tokens dentro de uma única janela de contexto. A pergunta mais difícil agora é outra: depois que todo esse material cabe na entrada, a IA realmente consegue relacionar informações espalhadas pelo documento ou apenas encontra passagens relevantes e escreve uma resposta convincente?
Um teste publicado pelo Android Police em 19 de agosto colocou essa questão de forma bastante prática. O mesmo relatório anual do Reserve Bank of India, com aproximadamente 200 páginas, foi enviado ao **GPT-5.6 Luna**, da OpenAI, ao **Claude Sonnet 5**, da Anthropic, e ao **Gemini 3.6 Flash**, do Google. As perguntas foram mantidas iguais entre os modelos e concentradas em temas ligados à inflação, permitindo comparar não apenas se cada sistema localizava dados, mas como explicava as relações apresentadas no documento.
O resultado mais interessante não é a existência de um vencedor absoluto. É justamente a ausência dele.
Os três modelos conseguiram trabalhar com o documento, mas chegaram às respostas por estilos diferentes. Em uma das comparações, o Gemini 3.6 Flash foi considerado superior aos rivais; em outra avaliação apertada, o autor terminou escolhendo o Sonnet 5, principalmente pela forma mais natural de estruturar a resposta e pela facilidade de verificar de onde a informação havia sido extraída. O GPT-5.6 Luna apareceu como uma espécie de ponto intermediário entre abordagens mais opostas.
Esse tipo de teste não é um benchmark científico, mas expõe um problema real do uso cotidiano de IA: **janela de contexto e compreensão são métricas diferentes**.
Um milhão de tokens não é um milhão de tokens de atenção perfeita
Os três modelos comparados possuem capacidade suficiente para receber um documento de 200 páginas sem que o tamanho bruto seja o principal obstáculo.
A documentação da OpenAI informa uma janela de contexto de aproximadamente **1,05 milhão de tokens** para o GPT-5.6 Luna. A Anthropic estabelece **1 milhão de tokens** para o Claude Sonnet 5. O teste do Android Police registra capacidade semelhante para o Gemini 3.6 Flash, na casa de 1,048 milhão de tokens.
Isso pode transmitir uma impressão enganosa.
Uma janela de contexto define aproximadamente quanto material pode estar disponível ao modelo durante uma solicitação. Ela não garante que todos os pedaços desse material sejam tratados com a mesma importância, que relações distantes sejam corretamente identificadas ou que informações semelhantes espalhadas pelo texto sejam reconciliadas.
Há uma diferença entre **ter acesso** a uma página e **perceber que uma informação naquela página modifica a interpretação de outra encontrada 150 páginas antes**.
É nesse intervalo que começam os problemas de documentos longos.
Imagine um relatório financeiro no qual a definição de determinado indicador aparece na página 12, uma mudança metodológica é explicada na página 86 e o resultado final surge em uma tabela da página 190. Encontrar cada um desses elementos isoladamente é uma tarefa de recuperação de informação. Perceber que os três precisam ser combinados para responder corretamente a uma pergunta exige integração contextual.
Os modelos de linguagem melhoraram enormemente nessa segunda tarefa, mas capacidade máxima de entrada não é sinônimo de atenção uniforme ao conteúdo inteiro.
O teste também revela um problema na comparação entre modelos
Existe uma ressalva importante na própria escolha dos participantes.
Embora GPT-5.6 Luna, Claude Sonnet 5 e Gemini 3.6 Flash sejam modelos contemporâneos, eles não representam exatamente a mesma posição dentro das famílias de seus fabricantes.
A OpenAI descreve oficialmente o **GPT-5.6 Luna** como seu modelo otimizado para cargas de trabalho de alto volume e sensíveis a custo, e não como o modelo de maior capacidade da família GPT-5.6. Acima dele estão Terra e Sol.
O Sonnet 5 ocupa uma posição diferente no catálogo da Anthropic, enquanto o cenário do Google mudou poucos dias antes da publicação do teste: o **Gemini 3.7 Flash foi lançado em agosto de 2026** e passou a ser apresentado pelo Google como seu Flash mais capaz, deixando o 3.6 Flash como geração anterior.
Isso não invalida o experimento do Android Police. Ele continua sendo útil como retrato de três ferramentas que um usuário pode escolher para analisar documentos.
Mas impede transformar o resultado em uma conclusão do tipo “empresa A tem a melhor IA para textos longos”.
Para isso seria necessário controlar versões, configurações de raciocínio, instruções, processamento do PDF, repetição dos testes e critérios objetivos de avaliação — e, idealmente, utilizar modelos comparáveis em custo e posicionamento.
Ler um PDF envolve mais coisas do que o modelo
Há outro detalhe frequentemente escondido pela interface dos chatbots: o modelo de linguagem pode não estar recebendo o PDF exatamente como o usuário o vê.
Antes da resposta existir, a plataforma pode precisar extrair texto, interpretar tabelas, identificar títulos, reconhecer imagens, selecionar páginas relevantes ou transformar partes do documento em representações internas destinadas à recuperação.
Em outras palavras, quando uma IA responde mal sobre um relatório, o erro pode ter ocorrido antes mesmo de a pergunta chegar efetivamente ao modelo.
Um gráfico pode ter sido interpretado incorretamente. Uma tabela pode perder relações entre colunas. Uma nota de rodapé pode ser tratada como texto secundário. Um PDF digitalizado pode depender de reconhecimento óptico de caracteres. Em documentos empresariais, jurídicos e científicos, justamente esses detalhes costumam carregar as exceções que mudam a conclusão.
É por isso que comparar somente o tamanho anunciado da janela de contexto diz pouco sobre a qualidade final de uma ferramenta para análise documental.
O pipeline inteiro importa.
O diferencial do Claude no teste foi também editorial
Um comportamento observado no Sonnet 5 merece atenção porque toca diretamente na confiança.
Segundo o teste, o Claude indicava logo no começo da resposta qual seção do documento havia utilizado, tornando mais rápida a conferência manual da informação. O autor considerou esse comportamento útil durante a comparação.
Isso não prova que a resposta esteja correta.
Uma IA pode apontar para o trecho certo e ainda interpretar a passagem de forma errada. Também pode construir uma conclusão que extrapola aquilo que a fonte realmente afirma.
Mas mostrar ao usuário onde procurar muda a experiência de verificação.
Para atividades profissionais, essa característica pode valer mais do que uma resposta ligeiramente mais elegante. Um advogado analisando um contrato, um pesquisador examinando um artigo ou um executivo consultando um relatório financeiro não deveria receber apenas uma conclusão. Precisa conseguir voltar rapidamente ao material original e confirmar se a interpretação se sustenta.
A IA mais útil nesse cenário talvez não seja aquela que responde com maior confiança, mas a que reduz o custo de verificar se ela própria está errada.
Resumo não é compreensão
Modelos atuais são extremamente bons em produzir resumos plausíveis.
Esse sucesso cria um problema psicológico interessante: texto bem estruturado parece demonstrar entendimento.
Nem sempre demonstra.
Um modelo pode identificar as frases mais importantes de cada seção, agrupá-las e gerar um excelente resumo sem construir corretamente todas as relações causais presentes no documento.
Isso fica mais evidente quando a pergunta deixa de ser “quais são os principais pontos?” e passa a exigir algo como “por que o indicador mudou mesmo depois da alteração descrita anteriormente?” ou “qual conclusão depende simultaneamente de informações apresentadas em três capítulos diferentes?”.
São perguntas desse segundo tipo que começam a separar recuperação de informação, síntese e raciocínio sobre contexto longo.
E é justamente aí que avaliações de PDFs extensos precisam evoluir.
Empresas não deveriam entregar documentos críticos a um chatbot e encerrar o expediente
A capacidade de processar centenas de páginas é extremamente útil e já pode economizar horas de leitura inicial.
Ela funciona bem para localizar tópicos, construir cronologias, extrair referências, encontrar cláusulas, comparar seções e preparar uma primeira visão de um documento volumoso.
O problema surge quando essa velocidade é confundida com validação.
Em documentos jurídicos, financeiros, médicos, regulatórios ou científicos, uma passagem ignorada pode ser justamente aquela que contém a exceção, a mudança metodológica ou a condição que invalida toda a conclusão anterior.
Quanto maior o documento, mais sedutora fica a ideia de não lê-lo.
É também quando o risco aumenta.
Um fluxo profissional mais responsável utiliza a IA como camada de navegação e análise, mas exige que afirmações importantes retornem à fonte original. Quando possível, o sistema deve indicar páginas, seções ou trechos utilizados e permitir que um humano confira rapidamente o raciocínio.
A economia real não está em eliminar a leitura humana. Está em direcioná-la para onde ela faz diferença.
Contexto gigante ou RAG?
A corrida por janelas de contexto cada vez maiores criou outra discussão técnica importante.
Uma estratégia consiste em colocar praticamente todo o documento diretamente no contexto do modelo. Outra utiliza **Retrieval-Augmented Generation**, ou RAG, técnica em que o sistema divide o material em partes, cria um índice e recupera apenas os trechos considerados relevantes para cada pergunta.
As duas abordagens têm vantagens e defeitos.
Contextos gigantes preservam mais material simultaneamente e podem facilitar relações entre partes distantes. Também aumentam o volume que o modelo precisa processar e não eliminam problemas de atenção.
RAG reduz a quantidade de texto enviada a cada consulta e pode tornar sistemas corporativos mais baratos e rastreáveis. Mas cria um novo ponto de falha: se o mecanismo de busca não recuperar a passagem correta, o modelo jamais terá oportunidade de utilizá-la.
Em aplicações mais maduras, a tendência é combinar estratégias. Documentos são estruturados e indexados, trechos relevantes são recuperados e uma quantidade maior de contexto é fornecida ao modelo quando a pergunta exige relações mais amplas.
O objetivo não deveria ser ostentar quantos tokens cabem numa janela.
Deveria ser encontrar a evidência certa e conseguir demonstrar como ela sustenta a resposta.
O que o teste realmente permite concluir
O experimento do Android Police mostra que modelos modernos já conseguem manipular documentos que, poucos anos atrás, precisariam ser fragmentados agressivamente antes de qualquer análise.
Também mostra que resultados continuam variando conforme a pergunta e o comportamento do modelo.
Gemini 3.6 Flash se saiu melhor em parte da comparação. Sonnet 5 apresentou características que fizeram o autor preferi-lo em outra. GPT-5.6 Luna ficou entre abordagens diferentes. Isso é mais informativo do que um simples pódio porque reflete como essas ferramentas funcionam no mundo real: uma pode ser melhor para determinada tarefa e pior para a seguinte.
E há um detalhe ainda mais importante.
Uma experiência realizada uma única vez, com um documento e um conjunto pequeno de perguntas, não mede estatisticamente “compreensão”. Mede o comportamento daqueles modelos diante daquela tarefa.
Chamar isso de benchmark exigiria um conjunto muito maior de documentos, respostas de referência, perguntas distribuídas por diferentes posições do contexto, testes repetidos e métricas capazes de separar recuperação, fidelidade factual, raciocínio e alucinação.
Análise da equipe
A indústria de inteligência artificial passou os últimos anos tratando a janela de contexto quase como fabricantes de câmeras trataram megapixels: um número simples, grande e fácil de colocar em uma tabela.
Ele importa. Só não conta a história inteira.
Um milhão de tokens resolve uma limitação objetiva: o modelo pode receber quantidades de informação que antes não cabiam em uma única interação. Isso abre aplicações sérias em contratos, auditorias, código, pesquisa científica, documentação técnica e relatórios empresariais.
O problema seguinte é muito mais difícil de colocar numa ficha técnica: **quanto desse contexto o modelo consegue usar corretamente quando a resposta depende de detalhes distantes, contraditórios ou discretos?**
Esse deveria ser o próximo campo de batalha.
Para o usuário, a pergunta mais útil deixa de ser “qual IA aceita meu PDF de 200 páginas?” e passa a ser “qual delas consegue mostrar de onde tirou a resposta, relacionar partes diferentes do documento e admitir quando a evidência não é suficiente?”.
Quando documentos importantes entram na conversa, eloquência é bônus.
Rastreabilidade é infraestrutura.
👉 Dúvida? Então veja mais em: https://pixbugtech.com/linksuteis