noticias
Uma análise do tráfego de rede do Grok Build revelou que a ferramenta de programação da xAI podia empacotar repositórios Git completos
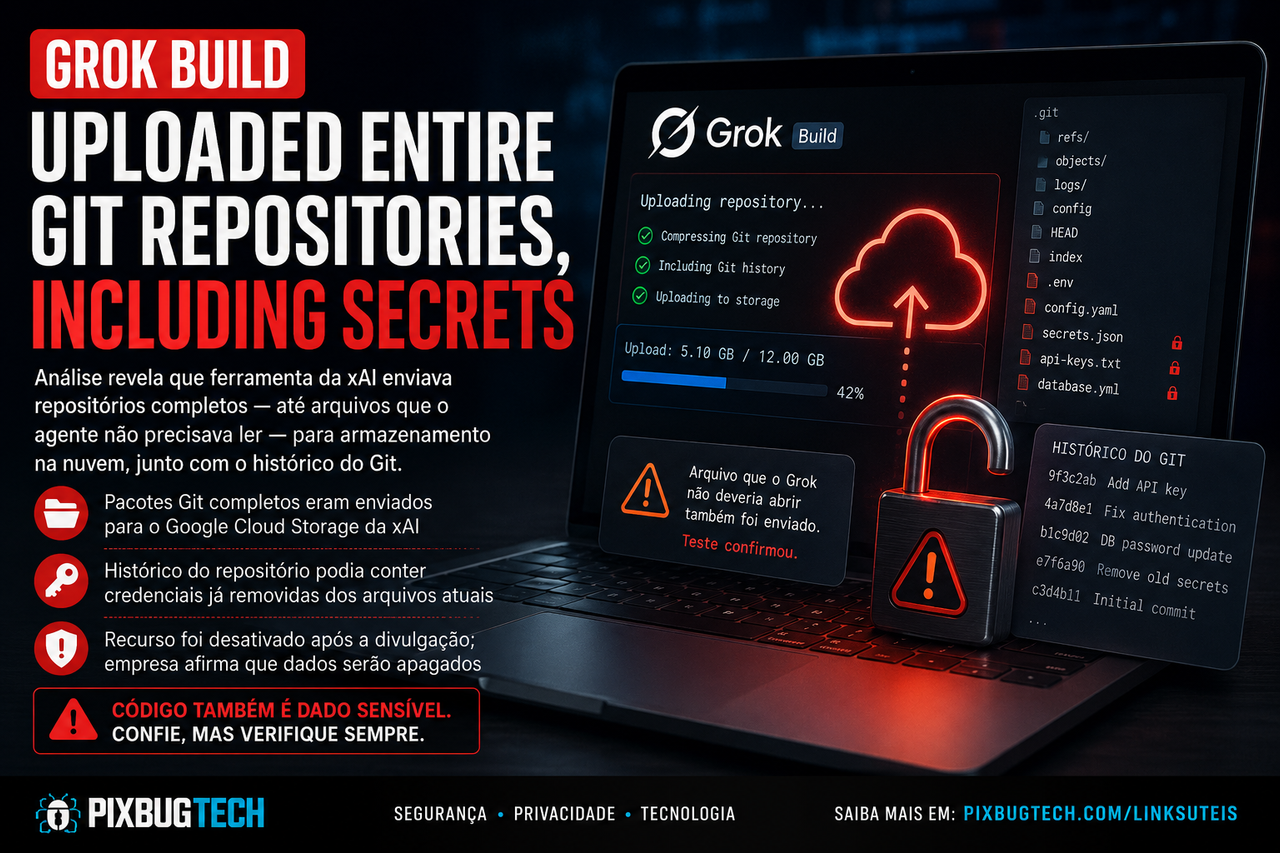
**Uma análise do tráfego de rede do Grok Build revelou que a ferramenta de programação da xAI podia empacotar repositórios Git completos, incluindo arquivos que o agente não precisava ler e informações preservadas no histórico de versões.
O comportamento foi desativado remotamente, mas o episódio expõe uma fronteira de confiança que a indústria de agentes de IA ainda prefere deixar em segundo plano.**
Assistentes de programação baseados em inteligência artificial precisam conhecer alguma parte do código para explicar uma função, localizar um defeito ou propor uma alteração. Essa troca de informações é parte previsível do funcionamento de ferramentas executadas na nuvem. O caso do Grok Build, porém, ultrapassou essa necessidade básica. Uma análise detalhada do tráfego da versão 0.2.93 indicou que a ferramenta enviava não apenas os arquivos efetivamente utilizados pelo modelo, mas também uma cópia do repositório Git rastreado, acompanhada de seu histórico de alterações.
A diferença é decisiva. Quando um desenvolvedor pede ajuda para corrigir uma função, existe uma expectativa razoável de que os arquivos necessários sejam transmitidos ao serviço remoto. Outra coisa é transformar o projeto em um pacote, incluir conteúdos que o agente foi instruído a não abrir e encaminhar todo esse material para uma estrutura de armazenamento em nuvem. Nesse segundo cenário, a ferramenta deixa de agir apenas como um assistente que consulta código e passa a operar como um sistema de coleta de contexto muito mais amplo do que o usuário provavelmente imagina.
O comportamento foi identificado pelo pesquisador conhecido como Cereblab, que interceptou o tráfego produzido pelo Grok Build em um ambiente controlado. Os repositórios usados nos testes continham marcadores e credenciais falsas, criadas especificamente para permitir a identificação de cada informação transmitida. Portanto, a pesquisa não demonstra que senhas reais foram roubadas ou que funcionários da empresa acessaram manualmente conteúdos privados. Ela demonstra algo mais objetivo: determinados arquivos saíram da máquina, foram aceitos pelos servidores e chegaram a uma estrutura de armazenamento vinculada ao serviço.
O arquivo que o Grok não deveria abrir também deixou o computador
O teste mais revelador utilizou uma instrução simples: o Grok deveria responder apenas “OK” e não abrir nenhum arquivo. Dentro do projeto, o pesquisador colocou um documento com um marcador exclusivo e o nomeou de forma que pudesse verificar posteriormente se aquele conteúdo havia sido transmitido.
Durante a interação normal com o modelo, o arquivo não apareceu entre os conteúdos consultados. Ainda assim, uma requisição separada enviou um pacote Git para o endpoint de armazenamento do serviço. Ao extrair e clonar o pacote capturado, o pesquisador conseguiu reconstruir o repositório e recuperar o arquivo que o agente havia sido expressamente instruído a não abrir.
A repetição do teste em um segundo projeto produziu resultado equivalente. Isso reduziu a possibilidade de que a ocorrência estivesse ligada a uma característica acidental de um único repositório. O mecanismo parecia fazer parte do comportamento normal da versão analisada do cliente.
O ponto técnico mais importante é que existiam dois caminhos distintos de transmissão. O primeiro transportava para o modelo os arquivos que o agente efetivamente lia durante uma tarefa. Esse canal é esperado em qualquer assistente de programação executado remotamente, embora ainda exija controles de privacidade e proteção de credenciais.
O segundo caminho era mais abrangente. Ele criava uma representação do repositório e enviava os arquivos rastreados, juntamente com o histórico do Git, para armazenamento. Esse processo acontecia independentemente de o modelo precisar ou não daquele conteúdo para produzir a resposta solicitada.
Um repositório de 12 GB revelou a dimensão da coleta
Para verificar se o comportamento se limitava a pequenos arquivos auxiliares, o pesquisador executou um teste com um repositório de aproximadamente 12 GB, composto principalmente por dados aleatórios que o modelo não havia lido.
O tráfego relacionado diretamente à conversa com a IA ficou em cerca de 192 KB. Paralelamente, o canal de armazenamento transferiu aproximadamente 5,10 GB antes de o teste ser interrompido. A diferença entre os dois fluxos chegou a cerca de 27,8 mil vezes.
Essa proporção enfraquece a hipótese de que o upload correspondia apenas aos trechos necessários para responder ao usuário. O volume transmitido acompanhava o tamanho do repositório, não o volume de informações consumidas pelo modelo durante a tarefa.
Os pacotes foram enviados em dezenas de partes e receberam respostas positivas do servidor. O destino identificado era uma estrutura do Google Cloud Storage associada a registros de sessões do Grok Build. Isso significa que não se tratava apenas de informação transitando temporariamente pela memória do modelo, mas de dados encaminhados para uma camada de armazenamento.
Ainda não está demonstrado por quanto tempo cada pacote permanecia disponível, quais processos internos poderiam consultá-lo ou quantos usuários tiveram seus projetos submetidos ao mesmo mecanismo. Também não há prova de que esses repositórios tenham sido usados para treinar modelos. A ausência dessas respostas, entretanto, não elimina a gravidade do que já foi confirmado.
O histórico do Git pode guardar segredos que o desenvolvedor acredita ter apagado
O envio do histórico completo cria um risco especialmente delicado. Em um repositório Git, remover uma senha do arquivo atual não significa necessariamente apagar essa senha dos registros anteriores. Caso ela tenha sido incluída em um commit, poderá continuar preservada em versões antigas do projeto.
Isso acontece com frequência quando desenvolvedores publicam acidentalmente chaves de API, tokens de autenticação, senhas de bancos de dados, certificados privados ou endereços internos de infraestrutura. A correção visível costuma ser rápida: o arquivo é alterado, a credencial é retirada e um novo commit é criado. Porém, o conteúdo anterior pode continuar recuperável no histórico.
Ao empacotar o repositório completo, uma ferramenta pode levar consigo informações que não aparecem mais no diretório de trabalho. O usuário olha para os arquivos atuais, não encontra a chave e conclui que ela não faz parte do material enviado. O Git, silenciosamente, pode continuar preservando aquela informação.
Esse detalhe transforma o caso em algo maior do que uma discussão sobre arquivos `.env`. Mesmo que um documento sensível tenha sido removido meses antes, sua versão anterior pode permanecer dentro da cadeia de commits. Quando todo o histórico deixa a máquina, antigas decisões de desenvolvimento voltam a representar riscos operacionais.
Arquivos lidos pelo agente eram transmitidos sem ocultação dos segredos
A análise também verificou o caminho mais convencional, utilizado quando o Grok abria um arquivo durante uma tarefa. Nesse caso, o conteúdo seguia para o modelo como parte da solicitação e também aparecia em um arquivo associado ao estado da sessão.
Durante o teste, um arquivo rastreado continha chaves falsas identificadas como credenciais de API e banco de dados. Quando o agente abriu esse documento, os valores foram transmitidos sem mascaramento ou remoção. As credenciais não eram reais, mas o experimento mostrou que o cliente não aplicava um mecanismo automático capaz de reconhecer e ocultar esse tipo de informação antes do envio.
Essa transmissão não é equivalente ao pacote completo do Git. Qualquer agente de programação em nuvem precisa receber os arquivos que analisa. A falha está na ausência de uma fronteira clara e na inexistência de uma proteção adicional para conteúdos reconhecidamente sensíveis.
Um arquivo pode precisar ser lido para que o modelo entenda como a aplicação se conecta a determinado serviço. Isso não significa que a senha completa precise ser enviada. Ferramentas maduras poderiam substituir valores por marcadores locais, alertar sobre a presença de credenciais ou exigir uma autorização específica antes de transmitir determinados padrões.
A conveniência dos agentes de programação cresceu mais rapidamente do que seus mecanismos de prevenção. Eles ficaram muito bons em localizar código relevante, executar comandos e alterar projetos, mas ainda tratam informações sensíveis como se fossem apenas mais algumas linhas de texto.
Desativar o treinamento não impedia o upload
Outro elemento importante está na diferença entre treinamento e retenção. Durante os testes, a opção relacionada à melhoria do modelo foi desativada. Mesmo assim, o envio do repositório continuou ocorrendo.
Isso mostra que a configuração aparentemente controlava o uso dos dados no treinamento, mas não determinava necessariamente se o código seria transmitido ou armazenado para outras finalidades. Para o usuário comum, essa distinção dificilmente é evidente. Ao desativar uma opção de melhoria do modelo, muita gente interpreta que seu conteúdo deixará de ser conservado pela empresa.
Na prática, existem perguntas diferentes. O conteúdo será utilizado para treinar futuros modelos? Será mantido temporariamente para depuração? Será incluído em registros de sessão? Poderá ser analisado durante investigações de abuso? Será armazenado para permitir a continuidade da conversa? Cada uma dessas finalidades precisa de controles e explicações próprias.
Uma plataforma pode prometer que não treina seus modelos com o código do cliente e, ao mesmo tempo, armazenar esse código durante determinado período. As duas afirmações não são incompatíveis. O problema surge quando a interface oferece uma escolha que parece mais abrangente do que realmente é.
A indústria de IA se acostumou a apresentar a frase “não usamos seus dados para treinamento” como se ela resolvesse toda a discussão sobre privacidade. Não resolve. O usuário também precisa saber quais dados saem de seu dispositivo, por que são enviados, onde ficam armazenados, por quanto tempo permanecem disponíveis e quem pode acessá-los.
A xAI desligou o mecanismo pelo servidor
Depois da publicação da análise, novos testes com a mesma versão do Grok Build deixaram de produzir as requisições de armazenamento. O servidor passou a retornar configurações que desativavam o upload do repositório e o envio de registros associados.
A mudança ocorreu sem que o cliente instalado fosse atualizado, indicando que a xAI utilizou uma configuração remota para desligar o comportamento. Essa resposta foi rápida e reduziu o risco imediato, mas também revela que o código responsável pelo recurso poderia continuar presente no aplicativo, apenas inativo por determinação do servidor.
A empresa afirmou que equipes protegidas pelo regime de retenção zero não tinham seus códigos e registros armazenados. Também informou que o uso do Grok Build por meio de chaves vinculadas a esse regime respeitava a mesma política.
Elon Musk declarou publicamente que os dados anteriormente enviados seriam completamente eliminados. Até agora, porém, não foi divulgada uma auditoria independente que confirme a abrangência dessa exclusão. Também permanecem sem resposta pública detalhada questões como o número de usuários afetados, o período durante o qual o comportamento esteve ativo e a finalidade original do empacotamento integral dos projetos.
Desligar a função impede novas transmissões, mas não reconstrói sozinho a confiança. Empresas que utilizam agentes de programação em projetos sensíveis precisam de evidências verificáveis, registros administrativos, termos contratuais claros e formas técnicas de confirmar quais políticas estão realmente ativas.
Isso foi um vazamento?
A palavra “vazamento” precisa ser utilizada com cuidado. A pesquisa não demonstrou que atacantes invadiram os servidores da xAI, que os repositórios ficaram publicamente acessíveis ou que terceiros utilizaram as credenciais encontradas. Também não provou que funcionários examinaram manualmente o código ou que o material entrou no treinamento dos modelos.
O que foi comprovado é uma transferência excessivamente ampla de dados para uma infraestrutura remota. Isso caracteriza uma falha séria de transparência e de delimitação da coleta, ainda que não exista evidência de exploração criminosa.
A distinção não diminui o problema. Código-fonte proprietário pode revelar vulnerabilidades, regras de negócio, modelos financeiros, detalhes de clientes, mecanismos antifraude, credenciais, infraestrutura e produtos ainda não anunciados. O simples fato de esse material ser armazenado fora do ambiente controlado pela organização modifica seu perfil de risco.
Uma empresa não precisa sofrer uma invasão para perder o controle sobre seus dados. Basta que uma ferramenta autorizada transfira mais informações do que seus usuários esperavam.
Quem precisa reagir primeiro
Desenvolvedores que utilizaram o Grok Build em repositórios privados formam o grupo mais diretamente exposto. O mesmo vale para equipes que executaram a ferramenta dentro de projetos corporativos sem uma política específica para agentes de IA.
A resposta mais prudente é considerar potencialmente comprometidas as credenciais presentes em arquivos rastreados ou no histórico do Git durante o período de utilização. Trocar essas chaves não significa afirmar que alguém as roubou. Significa reconhecer que elas cruzaram uma fronteira de segurança que talvez não estivesse prevista.
Equipes também precisam revisar registros de acesso aos serviços associados, procurando autenticações incomuns, alterações inesperadas e consumo anormal de recursos. Quando uma chave de nuvem é exposta, o dano potencial não se limita à leitura de dados. Ela pode ser usada para criar servidores, acessar bancos, modificar aplicações ou gerar despesas.
Projetos empresariais deveriam ainda verificar quais desenvolvedores instalaram o agente, quais repositórios foram abertos e quais políticas estavam ativas em cada conta. O uso individual de ferramentas de IA dentro de ambientes corporativos cria uma espécie de infraestrutura paralela, muitas vezes invisível para as equipes de segurança.
O problema não é exclusivo do Grok
Seria confortável tratar o episódio como um erro isolado de uma empresa. A conclusão mais responsável é outra: agentes de programação possuem acesso profundo demais para serem avaliados apenas pela qualidade do código que produzem.
Essas ferramentas leem projetos, executam comandos, modificam arquivos, consultam históricos, acessam terminais e, em alguns casos, interagem com serviços externos. Elas ocupam uma posição de confiança comparável à de ambientes de desenvolvimento, extensões privilegiadas e sistemas de automação.
A maioria das equipes escolhe um agente comparando velocidade, preço, qualidade das respostas e tamanho da janela de contexto. Poucas avaliam com o mesmo cuidado o tráfego de rede, os mecanismos de retenção, os limites de leitura e as condições contratuais de tratamento do código.
Outros assistentes em nuvem também enviam arquivos que precisam analisar. Isso faz parte de seu funcionamento. A diferença encontrada nos testes foi o empacotamento do repositório inteiro pelo Grok Build, comportamento que não apareceu da mesma forma nas ferramentas comparadas pelo pesquisador.
Ainda assim, “não enviar o repositório completo” não significa “não enviar dados sensíveis”. Qualquer agente remoto pode transmitir um segredo caso abra o arquivo que o contém. O caso do Grok apenas tornou visível uma fragilidade que existe em todo o setor.
O que ninguém ainda está discutindo
A discussão mais profunda envolve a mudança silenciosa do perímetro de segurança. Durante décadas, empresas protegeram seus códigos controlando servidores Git, estações de trabalho, redes privadas e permissões de acesso. Agora, um agente instalado por conveniência pode criar uma nova saída de dados sem passar pelos processos tradicionais de aprovação.
A ferramenta não precisa agir de forma maliciosa. Basta que sua arquitetura considere normal reunir o máximo de contexto possível. Para um modelo de IA, mais contexto frequentemente significa respostas melhores. Para uma equipe de segurança, mais contexto transmitido significa uma superfície de exposição maior.
Esse conflito está no centro da próxima fase da computação assistida por IA. Os agentes serão pressionados a conhecer projetos inteiros, acompanhar decisões antigas e compreender sistemas complexos. Ao mesmo tempo, organizações precisarão impedir que essa busca por contexto transforme cada sessão de programação em uma exportação quase completa de propriedade intelectual.
A solução não virá apenas de políticas de privacidade. Será necessário oferecer controles técnicos verificáveis: listas explícitas de arquivos permitidos, bloqueio de diretórios, inspeção local de segredos, registros de tudo o que foi transmitido, armazenamento regional, retenção configurável e modos realmente locais.
Também será necessário abandonar a ideia de que um botão chamado “privacidade” resolve todos esses problemas. Privacidade não é uma única opção. É um conjunto de decisões sobre coleta, finalidade, transmissão, armazenamento, treinamento, acesso e exclusão.
Análise da equipe PixBugTech
O episódio do Grok Build é importante porque rompe uma confiança básica entre desenvolvedor e ferramenta. O usuário aceita que o agente leia aquilo que precisa para executar uma tarefa. Ele não necessariamente aceita que o projeto inteiro e seu histórico sejam empacotados para armazenamento remoto.
A resposta da xAI foi rápida no aspecto operacional. O mecanismo deixou de funcionar após uma alteração feita pelo servidor, e a empresa prometeu apagar os dados anteriormente enviados. Isso reduz o risco, mas não encerra a discussão. Ainda falta uma explicação técnica completa sobre por que o recurso existia, quais contas foram afetadas e como a exclusão será comprovada.
A reação correta não é abandonar toda programação assistida por IA. Também não é aceitar que qualquer volume de dados seja coletado em nome de respostas melhores. O caminho maduro exige tratar agentes de código como componentes críticos da cadeia de desenvolvimento, submetidos aos mesmos processos de segurança aplicados a repositórios, ferramentas de integração e fornecedores de nuvem.
No curto prazo, empresas mais cautelosas restringirão esses agentes a projetos de baixo risco, ambientes isolados ou contas protegidas por contratos de retenção zero. No médio prazo, fornecedores precisarão disputar clientes não apenas com modelos mais inteligentes, mas com arquiteturas de confiança mais transparentes.
No longo prazo, a diferença competitiva poderá estar na capacidade de provar que determinada ferramenta viu apenas aquilo que precisava ver. Em um mercado obcecado por aumentar a quantidade de contexto entregue aos modelos, aprender a limitar esse contexto talvez se transforme na característica de segurança mais valiosa.
Código também é dado sensível
O caso deixa uma lição incômoda para a indústria. Durante muito tempo, privacidade em IA foi discutida principalmente em torno de conversas, imagens e documentos pessoais. Agentes de programação ampliam o problema para o coração operacional das empresas.
Código não é apenas texto. Ele contém processos, produtos, falhas, estratégias, integrações e credenciais. Em muitos negócios, representa a forma mais concentrada de propriedade intelectual disponível.
A inteligência artificial poderá acelerar radicalmente o desenvolvimento de software, mas essa aceleração não será sustentável caso dependa de fronteiras de dados que o usuário não compreende. Uma ferramenta pode escrever código excelente e, ao mesmo tempo, criar um risco institucional inaceitável.
O Grok Build teve o comportamento desativado. A questão que permanece é quantas outras ferramentas coletam contextos excessivos sem que alguém tenha parado para observar o tráfego.
👉 Dúvida? Então veja mais em: https://pixbugtech.com/linksutei