noticias
União Europeia obriga avisos em chatbots e deepfakes mas um rótulo não transforma mentira em verdade
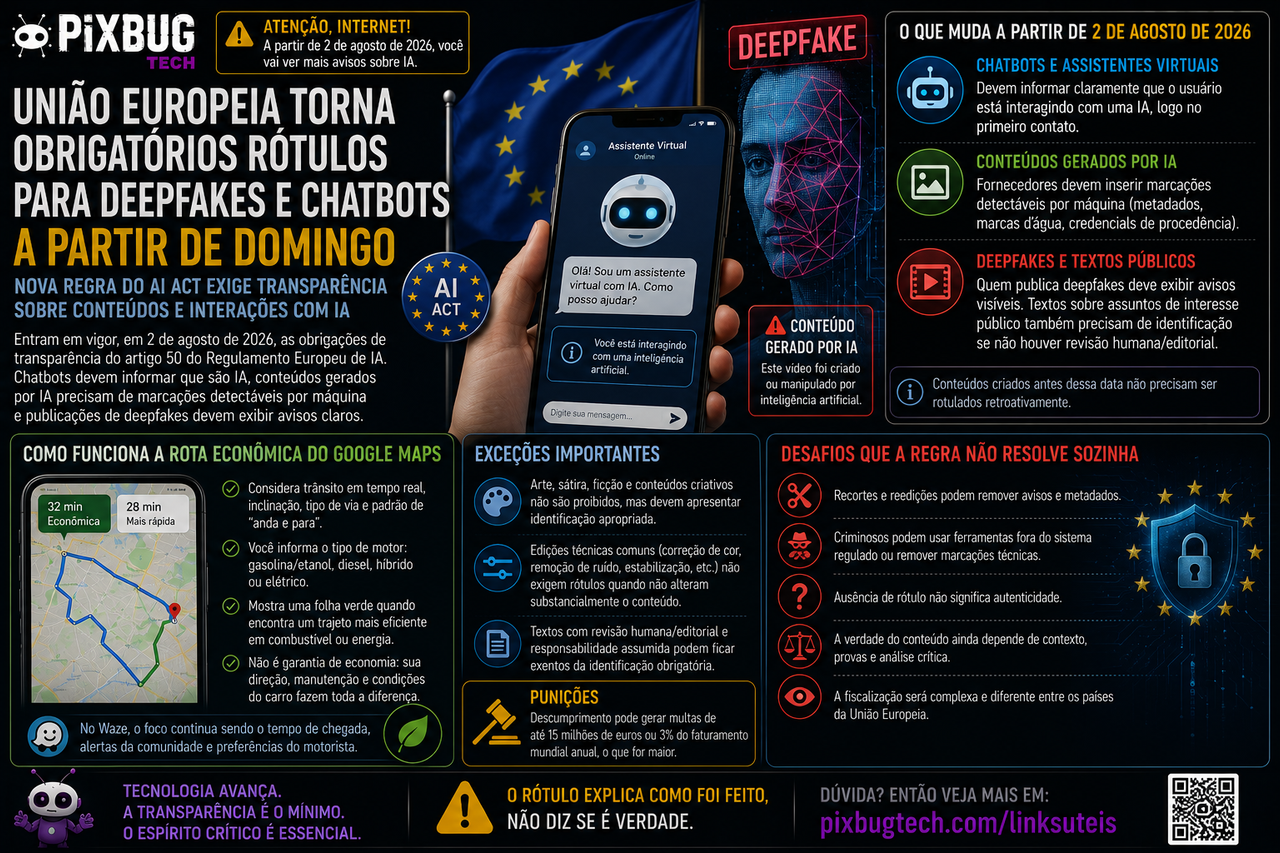
A União Europeia começará a aplicar, no domingo, 2 de agosto de 2026, uma das partes mais visíveis de seu Regulamento de Inteligência Artificial. Empresas terão de informar quando uma pessoa estiver conversando diretamente com um sistema de IA, conteúdos sintéticos precisarão carregar marcações detectáveis por máquinas e deepfakes publicados no bloco deverão ser claramente identificados como artificiais ou manipulados.
A mudança parece simples: colocar um aviso em tudo aquilo que foi criado por inteligência artificial. O texto europeu é mais cuidadoso e mais complexo. Não haverá necessariamente um selo vermelho sobre cada fotografia retocada, e-mails corrigidos por software ou vídeos que utilizaram IA apenas para remover ruído. As obrigações variam conforme o tipo de sistema, a função da tecnologia, o conteúdo produzido e quem o apresenta ao público.
Um chatbot de atendimento deverá deixar claro que não é uma pessoa, salvo quando isso já for evidente para alguém razoavelmente atento. Um gerador de imagens deverá incorporar sinais técnicos capazes de acompanhar o arquivo. Quem publicar um vídeo falso de uma pessoa real precisará apresentar uma informação compreensível ao espectador. Textos gerados para informar o público sobre assuntos relevantes também entram na regra quando não passaram por revisão humana ou controle editorial responsável.
A Europa tenta resolver dois problemas diferentes ao mesmo tempo. O primeiro é técnico: permitir que plataformas e ferramentas reconheçam conteúdos criados ou alterados por IA. O segundo é humano: evitar que alguém veja uma voz, rosto, declaração ou conversa artificial acreditando estar diante de uma pessoa real.
O regulamento acerta ao exigir transparência antes que a falsificação sintética se torne indistinguível por observação comum. Mas o rótulo carrega uma limitação que nenhuma lei consegue eliminar. Saber que um vídeo foi produzido por IA não explica quem o criou, por qual motivo, quais partes foram alteradas e se a mensagem é falsa.
Uma imagem marcada pode dizer a verdade. Um vídeo gravado por uma câmera pode mentir cuidadosamente sem utilizar IA alguma.
A Europa está construindo uma camada de procedência. Não um detector universal de realidade.
O que realmente começa a valer no domingo
As novas exigências pertencem ao artigo 50 do AI Act, o regulamento europeu aprovado em 2024 para disciplinar diferentes categorias de inteligência artificial.
A primeira obrigação atinge sistemas criados para interagir diretamente com pessoas. Chatbots, atendentes automatizados, personagens virtuais e determinados assistentes precisam informar ao usuário que a interação ocorre com uma IA.
O aviso deverá aparecer de maneira clara e acessível, no máximo durante o primeiro contato. Uma empresa não poderá manter um consumidor conversando durante vários minutos com uma voz sintética e revelar somente no final que nenhum funcionário participou da ligação.
Existe uma exceção razoável: quando a natureza artificial já é evidente para uma pessoa informada, observadora e cuidadosa, a plataforma não precisa repetir o aviso de maneira desnecessária. Um personagem chamado “assistente virtual”, exibido com aparência deliberadamente robótica, dificilmente será confundido com um humano.
Essa exceção, contudo, não deve virar esconderijo para interfaces ambíguas. Quanto mais realista for a voz, o avatar ou a personalidade, maior será a necessidade de uma informação explícita.
A segunda obrigação recai sobre os fornecedores dos sistemas que geram ou manipulam imagens, sons, vídeos e textos. Eles deverão estruturar os produtos de forma que os resultados recebam marcações legíveis por máquinas, capazes de indicar a origem artificial do conteúdo.
Essas marcações podem envolver metadados, credenciais de procedência, assinaturas criptográficas, marcas d’água ou combinações dessas tecnologias. A regulamentação não exige que todas as soluções sejam visualmente idênticas, mas determina que sejam eficazes, interoperáveis, robustas e confiáveis dentro do que for tecnicamente possível.
A terceira obrigação alcança quem utiliza o sistema e publica o resultado. Deepfakes precisam ser rotulados de maneira visível ou perceptível pelo público. Textos produzidos por IA sobre assuntos de interesse público também precisam de identificação quando são publicados sem revisão humana ou responsabilidade editorial.
A lei separa, portanto, duas camadas. O gerador marca tecnicamente. O publicador explica humanamente.
Uma fica dentro do arquivo. A outra precisa chegar ao leitor.
Chatbots não precisarão carregar um aviso em cada frase
A manchete de que “chatbots receberão rótulos obrigatórios” pode produzir uma interpretação exagerada.
O AI Act não determina que cada resposta comece com “sou uma inteligência artificial”. A obrigação é informar claramente a natureza da interação, especialmente no início.
Em um site de comércio eletrônico, o aviso poderá aparecer na janela do atendimento. Em uma ligação, a voz precisará apresentar-se como assistente virtual. Em um aplicativo, a informação poderá acompanhar o nome e a interface do sistema.
O objetivo é impedir a personificação enganosa, não tornar a experiência insuportável com repetições.
A regra será especialmente importante em serviços de cobrança, vendas, saúde, suporte técnico e relacionamento bancário. Vozes sintéticas já conseguem reproduzir pausas, emoções e hesitações com naturalidade suficiente para serem confundidas com atendentes humanos.
Uma pessoa pode revelar informações ou aceitar uma proposta acreditando estar conversando com um funcionário capaz de compreender exceções, assumir responsabilidade e exercer julgamento. O chatbot pode apenas seguir um fluxo definido pela empresa.
A identificação não resolve essa assimetria, mas impede que ela permaneça escondida.
O aviso também deverá alcançar sistemas que parecem personagens humanos em jogos, plataformas sociais ou aplicativos de companhia. Quanto mais a indústria vender presença emocional, mais relevante será saber se existe alguém do outro lado.
A transparência, nesse caso, não serve apenas para combater fraude. Serve para preservar uma fronteira psicológica que os produtos mais persuasivos estão interessados em apagar.
O que a Europa considera um deepfake
O regulamento trata como deepfake um conteúdo de imagem, áudio ou vídeo produzido ou manipulado por IA que se assemelhe a pessoas, objetos, lugares, entidades ou acontecimentos reais e possa parecer autêntico.
A definição não está limitada a vídeos políticos ou imitações de celebridades. Pode alcançar gravações falsas de executivos, imagens inventadas de acontecimentos, áudios clonados e cenas fabricadas que utilizam elementos reconhecíveis do mundo real.
O ponto central é o potencial de confusão.
Uma ilustração evidentemente fantástica gerada por IA não possui o mesmo risco de uma gravação que simula uma declaração de um ministro, empresário ou familiar. A primeira apresenta uma criação. A segunda pode funcionar como prova falsa.
O responsável por publicar o deepfake deverá indicar que o conteúdo foi criado ou alterado artificialmente. Essa informação precisa ser clara, distinguível e apresentada de maneira acessível.
Não basta esconder o aviso em termos de uso, descrição distante ou metadados que uma pessoa comum nunca examinará.
Em áudio, o aviso poderá ser sonoro ou acompanhar a interface em que o arquivo aparece. Em vídeo, poderá surgir visualmente. Em imagens, deverá permanecer perceptível no contexto da publicação.
A implementação exata dependerá do formato, da plataforma e das orientações das autoridades. A regra tenta evitar uma abordagem única que funcione em uma rede social e seja inútil em uma transmissão de rádio.
O risco é permitir tanta flexibilidade que o aviso cumpra a lei sem cumprir sua função.
Um rótulo colocado por dois segundos no canto de um vídeo vertical talvez seja tecnicamente visível e praticamente inexistente.
Arte, sátira e ficção não foram proibidas
A regulamentação preserva espaço para obras artísticas, criativas, satíricas e fictícias.
Quando um deepfake integra esse tipo de obra, a identificação deve ser apresentada de maneira apropriada, sem destruir a experiência ou impedir a exploração normal do trabalho.
Um filme não precisará interromper cada cena para explicar que efeitos digitais foram utilizados. Uma sátira política poderá apresentar o aviso no início, na descrição ou em outro local adequado. Uma exposição poderá informar a técnica sem cobrir cada imagem com uma faixa.
Essa exceção reconhece que manipulação audiovisual não nasceu com a inteligência artificial. Cinema, fotografia e publicidade alteram a realidade há mais de um século.
O problema regulatório não é a existência da criação artificial. É a possibilidade de ela ser apresentada como registro autêntico sem que o público perceba.
A fronteira continuará produzindo conflitos. Uma propaganda pode declarar-se sátira enquanto tenta enganar. Um conteúdo político poderá utilizar linguagem artística como justificativa. Uma montagem humorística poderá circular fora do contexto original e ser interpretada como verdadeira.
O rótulo inserido pelo autor pode desaparecer quando o vídeo for recortado, capturado ou reenviado.
A lei consegue exigir uma identificação no momento da publicação. Não consegue controlar todas as vidas posteriores do arquivo.
Nem todo texto produzido com IA precisará de aviso
A obrigação sobre textos é mais restrita do que aquela aplicável a deepfakes.
O foco está em conteúdos gerados ou manipulados por IA e publicados para informar o público sobre questões de interesse público. Notícias, análises políticas, orientações governamentais, comunicações institucionais e textos capazes de influenciar debates coletivos podem entrar nesse campo.
Há uma exceção importante quando o conteúdo passou por revisão humana ou controle editorial e uma pessoa física ou jurídica assume responsabilidade pela publicação.
Isso significa que uma redação poderá utilizar IA para transcrever entrevistas, organizar documentos, sugerir títulos ou auxiliar na elaboração, desde que exista supervisão efetiva e responsabilidade editorial.
O regulamento não pretende obrigar jornais a rotular cada texto que recebeu correção gramatical automatizada.
A exceção também evita transformar a transparência em um inventário impossível de pequenas intervenções. Editores de texto, tradutores e ferramentas de busca já utilizam modelos em etapas que o usuário nem sempre percebe.
A pergunta relevante não é se algum algoritmo tocou o documento. É se a máquina produziu ou alterou substancialmente uma comunicação pública sem que uma pessoa a revisasse e assumisse suas consequências.
A regra pode incentivar empresas a criar revisões humanas apenas formais. Um funcionário recebe dezenas de textos, clica em aprovar e passa a ser apresentado como controle editorial.
A União Europeia precisará diferenciar supervisão real de um carimbo humano no final de um processo automático.
Uma pessoa no fluxo não significa necessariamente uma pessoa no comando.
Correção de cor e edição comum não entram automaticamente na regra
As orientações europeias distinguem geração substancial de funções auxiliares ou edições padronizadas.
Ajustes de brilho, correção de ruído, estabilização, enquadramento, remoção técnica de imperfeições e outras operações que não alterem significativamente o conteúdo ou seu significado podem ficar fora da obrigação de marcação.
Essa exclusão é necessária para evitar que praticamente toda fotografia de smartphone seja rotulada como criada por IA. Câmeras modernas utilizam modelos computacionais para combinar exposições, reduzir ruído, reconstruir detalhes e ajustar rostos.
Rotular tudo produziria fadiga. Depois de algum tempo, o público deixaria de prestar atenção.
A dificuldade será estabelecer quando uma edição comum se transforma em alteração substantiva.
Remover uma poeira da imagem é diferente de retirar uma pessoa. Melhorar a nitidez de uma placa é diferente de reconstruir letras que a câmera nunca capturou. Ajustar uma voz é diferente de fazê-la pronunciar uma frase nova.
A tecnologia não apresenta uma linha técnica universal entre correção e criação. O significado depende do contexto.
Uma alteração pequena em uma fotografia artística pode ser irrelevante. A mesma alteração em uma imagem utilizada como evidência pode mudar completamente sua interpretação.
A marca invisível será tão importante quanto o aviso visível
O rótulo destinado ao usuário representa apenas metade da estratégia europeia.
Os sistemas generativos também precisarão inserir informações legíveis por máquinas. A ideia é permitir que plataformas, arquivos de mídia, buscadores e ferramentas forenses detectem a origem do conteúdo mesmo quando uma pessoa não estiver observando o aviso.
Essa camada poderá funcionar como uma espécie de histórico digital. O arquivo registra que foi criado ou modificado por determinado sistema, em certo momento e com determinadas ferramentas.
Padrões como credenciais de conteúdo e assinaturas criptográficas já tentam construir esse caminho. Câmeras, editores e plataformas podem assinar diferentes etapas, criando uma cadeia de procedência.
O método é mais confiável quando todos os participantes preservam os dados. O problema começa quando o conteúdo é comprimido, recortado, fotografado de outra tela ou processado por uma plataforma que remove metadados.
Marcas d’água resistentes tentam sobreviver a essas transformações, mas podem reduzir qualidade, apresentar falsos negativos ou ser removidas por usuários determinados.
Nenhuma tecnologia conhecida oferece simultaneamente invisibilidade, resistência absoluta, precisão universal e compatibilidade com todos os formatos.
A própria redação da lei reconhece a limitação ao utilizar a expressão “tecnicamente viável”.
Essa ressalva é razoável. Também abrirá uma discussão permanente sobre quanto esforço é suficiente.
O regulamento divide responsabilidades pela cadeia
A criação de um deepfake pode envolver várias empresas.
Uma companhia fornece o modelo. Outra cria o aplicativo. Um usuário produz o vídeo. Uma rede social hospeda a publicação. Um influenciador redistribui o conteúdo. Um buscador o apresenta nos resultados.
O AI Act tenta distribuir obrigações.
O fornecedor do sistema deve permitir que o resultado seja reconhecido como artificial. Quem utiliza a tecnologia e publica o deepfake deve apresentar o rótulo ao público. Plataformas continuam sujeitas a outras regras europeias, especialmente as obrigações do Regulamento dos Serviços Digitais.
Essa divisão é lógica. Nenhuma empresa controla toda a cadeia.
Também cria espaço para transferência de culpa.
O fabricante pode afirmar que inseriu a marca e que o usuário a removeu. O publicador pode dizer que recebeu o arquivo sem metadados. A plataforma pode alegar que não possuía elementos suficientes para reconhecer a manipulação.
Investigações precisarão reconstruir quem produziu, modificou e distribuiu cada conteúdo. Sem padrões interoperáveis e registros confiáveis, a responsabilização poderá desaparecer entre os participantes.
A transparência funciona melhor quando a cadeia inteira coopera. O conteúdo mais perigoso será justamente aquele criado por pessoas que desejam romper essa cadeia.
Modelos abertos apresentam um desafio particular
Grandes serviços centralizados podem atualizar seus sistemas e inserir marcações em cada resultado produzido.
Modelos de pesos abertos podem ser baixados, modificados e executados sem conexão com o fornecedor original. Um desenvolvedor consegue remover filtros, alterar a geração e desabilitar mecanismos de marcação.
O AI Act continua podendo alcançar empresas que oferecem esses sistemas no mercado europeu, mas a fiscalização de cópias modificadas será mais difícil.
A regra não torna o modelo aberto ilegal. Também não garante que sua marcação permanecerá ativa depois de uma alteração.
Esse problema demonstra por que o regulamento não pode depender apenas do gerador. Plataformas e publicadores também precisam assumir responsabilidades.
Uma rede social poderá detectar sinais de conteúdo sintético mesmo quando o arquivo não trouxer uma assinatura confiável. O resultado será probabilístico, sujeito a erros e técnicas de evasão.
Existe uma diferença importante entre ausência de marca e autenticidade humana.
Um conteúdo sem rótulo pode ter sido produzido por uma câmera. Pode também ter sido criado por uma ferramenta que removeu a identificação.
A Europa não pode permitir que o público interprete “não marcado” como sinônimo de “verdadeiro”.
O maior risco é a criação de confiança invertida
Rótulos ajudam pessoas a ajustar sua confiança. Também podem produzir um efeito inesperado.
Quando o público se acostuma a ver avisos em conteúdos sintéticos, passa a atribuir maior credibilidade àquilo que não possui aviso. Criminosos terão incentivo para remover a marca ou utilizar ferramentas fora do sistema regulado.
O conteúdo mais sofisticado poderá aparecer limpo. As produções legítimas, criativas e responsáveis carregarão o rótulo porque seus autores obedecem à regra.
A ausência de identificação pode tornar-se um selo falso de autenticidade.
Esse fenômeno já ocorre com marcas de verificação, certificados e filtros antispam. Usuários aprendem a confiar no sinal e esquecem que atacantes também aprendem a contorná-lo.
A comunicação pública precisará explicar que o rótulo confirma o uso de IA, enquanto a falta dele não confirma a ausência.
Da mesma forma, “gerado por IA” não significa “falso”. Uma animação educativa, reconstrução científica ou gráfico informativo pode ser preciso. Uma gravação autêntica pode ser retirada de contexto e utilizada para enganar.
A procedência é uma informação sobre o processo. A verdade continua exigindo análise.
O rótulo não resolve o problema dos recortes
Um vídeo pode ser publicado originalmente com identificação adequada. Outro usuário recorta apenas o trecho central, remove as bordas e distribui novamente.
Uma captura de tela elimina elementos da interface. Um áudio extraído perde o aviso visual. Uma gravação reproduzida em outro aparelho pode abandonar metadados e marcas técnicas.
Quanto mais o conteúdo circula, mais frágil se torna sua procedência.
Plataformas poderão tentar reaplicar avisos quando detectarem materiais conhecidos. Bancos de hashes, sistemas de impressão digital e modelos de reconhecimento ajudarão a localizar cópias.
Pequenas alterações podem dificultar essa correspondência. O volume de mídia publicado diariamente torna impossível uma revisão humana universal.
A regulação melhora o ponto de partida. O ecossistema de redistribuição continua aberto.
Esse é um dos motivos pelos quais campanhas de educação midiática permanecerão necessárias. Uma pessoa não deve acreditar em uma gravação apenas porque não enxerga um aviso.
A lei chega em um momento eleitoralmente sensível
Deepfakes possuem capacidade particular de interferir em eleições.
Um áudio falso pode aparecer horas antes de uma votação, quando não existe tempo suficiente para investigação. Um vídeo manipulado pode ser distribuído por redes fechadas e grupos de mensagens. Mesmo depois de desmentido, o conteúdo continua influenciando pessoas que nunca verão a correção.
A obrigação de rotular ajuda principalmente participantes legítimos e plataformas responsáveis. Operações de desinformação estrangeiras ou criminosas dificilmente obedecerão voluntariamente.
A aplicação precisará ocorrer na distribuição. Plataformas terão de detectar, limitar alcance e cooperar com autoridades conforme as demais normas aplicáveis.
O rótulo também oferece uma base jurídica para punir empresas e campanhas que publiquem materiais enganosos sem identificação.
Ainda assim, a velocidade continuará favorecendo o ataque. Produzir uma falsificação leva minutos. Investigar, atribuir e aplicar uma sanção pode levar meses.
A lei organiza responsabilidade depois do acontecimento. A defesa democrática precisa funcionar antes que o conteúdo alcance milhões.
Empresas fora da Europa também sentirão a regra
O AI Act aplica-se a sistemas colocados no mercado ou utilizados na União Europeia, inclusive quando o fornecedor está em outro país.
OpenAI, Google, Meta, Anthropic, Microsoft, Adobe e outras empresas globais precisarão adaptar produtos distribuídos no bloco.
Algumas poderão manter versões específicas para a Europa. Outras adotarão as marcações globalmente para evitar arquiteturas separadas.
Esse efeito já ocorreu com a legislação europeia de proteção de dados. Regras criadas em Bruxelas influenciaram serviços oferecidos em outras regiões, fenômeno conhecido como efeito Bruxelas.
A transparência de conteúdo pode seguir o mesmo caminho. Uma marca técnica inserida no momento da geração continuará acompanhando o arquivo quando ele for compartilhado no Brasil.
Plataformas também podem concluir que é mais simples utilizar o mesmo aviso para todos os usuários.
Isso não significa que o regulamento europeu será automaticamente aplicado fora da União. Significa que padrões técnicos criados para cumprir a lei poderão tornar-se globais por conveniência e escala.
A Europa possui participação menor na corrida dos grandes modelos, mas continua exercendo poder sobre as regras de acesso ao seu mercado.
O Brasil será afetado sem ter decidido a regra
Usuários brasileiros poderão começar a ver novos avisos em ferramentas globais, mesmo sem uma norma nacional equivalente.
Conteúdos criados na Europa circularão em plataformas brasileiras. Empresas locais que atendem consumidores europeus precisarão compreender as obrigações. Desenvolvedores brasileiros poderão utilizar APIs que inserem marcas por padrão.
A experiência pode ajudar o país a observar o que funciona antes de criar suas próprias regras.
O Brasil já possui normas de proteção de dados, direitos do consumidor, responsabilidade civil, eleitoral e penal que alcançam parte dos usos abusivos. Ainda não existe uma estrutura consolidada e específica para rotulagem de conteúdo sintético equivalente ao artigo 50 europeu.
Copiar o modelo integralmente talvez não seja adequado. Ignorar a questão também não será possível.
Deepfakes não respeitam fronteiras. Um áudio produzido no Brasil pode afetar uma eleição europeia, e uma imagem criada em outro continente pode enganar consumidores brasileiros.
A discussão nacional precisará considerar não apenas o rótulo, mas consentimento, retirada rápida, direito de resposta, responsabilização e proteção contra falsificações íntimas ou financeiras.
Haverá multas, mas a fiscalização será distribuída
O descumprimento das obrigações de transparência poderá resultar em multas de até 15 milhões de euros ou 3% do faturamento mundial anual da empresa, conforme as regras de cálculo e proporcionalidade.
Para pequenas e médias empresas, as autoridades devem considerar o porte e aplicar os limites previstos de maneira proporcional.
A fiscalização será realizada principalmente pelas autoridades nacionais de supervisão de mercado dos países da União. O Escritório Europeu de IA terá competências específicas em determinados sistemas ligados a modelos de propósito geral e grandes plataformas.
Essa estrutura descentralizada preserva o papel dos Estados-membros, mas pode produzir ritmos diferentes de fiscalização.
Um país pode agir agressivamente. Outro pode possuir poucos recursos técnicos. Empresas poderão escolher locais de estabelecimento considerando a autoridade considerada mais previsível.
A União precisará coordenar interpretações para evitar que o mesmo conteúdo seja tratado de maneiras incompatíveis em diferentes países.
O código de práticas publicado pela Comissão tenta oferecer um caminho comum. A adesão é voluntária, mas quem não o seguir precisará demonstrar que cumpre a lei por meios equivalentes.
O código funciona como um manual de conformidade. Não substitui a obrigação jurídica.
Existe uma transição limitada para sistemas antigos
As regras começam a valer em 2 de agosto de 2026, mas existe uma adaptação específica para sistemas que já estavam no mercado antes dessa data.
Esses fornecedores terão até 2 de dezembro de 2026 para cumprir a obrigação técnica de marcação e detecção dos conteúdos gerados.
A extensão não alcança automaticamente todas as exigências. O aviso de interação com chatbots e a rotulagem por quem publica determinados conteúdos começam a ser exigidos na data geral.
Também não existe obrigação de voltar ao passado e rotular cada imagem, vídeo ou texto produzido antes de 2 de agosto.
A Comissão recomenda que conteúdos antigos sejam identificados quando isso for possível, mas não impõe uma revisão retroativa de toda a internet.
A decisão evita uma tarefa impossível. Também significa que conteúdos sintéticos antigos continuarão circulando sem as novas marcas.
Durante anos, o ecossistema terá arquivos produzidos sob padrões diferentes. Detectores precisarão lidar com conteúdos marcados, não marcados, modificados e anteriores à regra.
Criadores terão de documentar melhor seus processos
Profissionais de publicidade, audiovisual, jornalismo, design e comunicação institucional precisarão saber quais ferramentas foram utilizadas e em que grau alteraram o material.
Um arquivo final pode passar por vários sistemas: geração de imagem, edição de voz, correção de vídeo, tradução e montagem.
Determinar se o resultado exige rótulo dependerá da participação de cada tecnologia e da forma como o conteúdo será apresentado.
Empresas precisarão preservar versões, registros e decisões editoriais. Não apenas para cumprir a transparência, mas para responder a questionamentos futuros.
Uma agência que publica uma campanha com personagem sintético deverá informar isso adequadamente. Uma redação precisará provar que o texto gerado passou por revisão humana quando utilizar a exceção editorial.
O trabalho criativo ganhará uma camada de conformidade semelhante ao tratamento de direitos autorais, licenças e dados pessoais.
Essa burocracia poderá pesar sobre equipes pequenas. Ferramentas que automatizem procedência e rotulagem terão vantagem.
O risco é a conformidade tornar-se outro serviço controlado por grandes plataformas. A empresa cria o modelo, oferece o selo e vende a infraestrutura necessária para demonstrar que o selo está correto.
A transparência pode favorecer empresas maiores
Grandes companhias possuem equipes jurídicas, especialistas e capacidade para reconstruir sistemas em torno das novas exigências.
Startups e projetos abertos terão mais dificuldade para implementar marcações robustas, acompanhar padrões e responder a autoridades em diferentes países.
A regulação tenta reduzir esse efeito com proporcionalidade, orientações e código de práticas. O custo não desaparece.
Isso pode consolidar o mercado em empresas que conseguem financiar conformidade.
Ao mesmo tempo, ausência de regra também beneficia os maiores participantes. Plataformas com enorme distribuição conseguem liberar ferramentas capazes de afetar milhões de pessoas antes que concorrentes menores tenham recursos para responder aos danos.
A questão não é escolher entre regulação e inovação como se fossem lados opostos. É impedir que a proteção se transforme em uma barreira feita sob medida para quem já domina o setor.
Padrões abertos e ferramentas públicas de marcação serão essenciais para que pequenos desenvolvedores consigam cumprir a lei sem comprar toda a infraestrutura de uma Big Tech.
A regra poderá produzir uma internet cheia de avisos inúteis
Empresas avessas a risco podem optar por rotular qualquer conteúdo que tenha recebido algum auxílio automatizado.
O resultado seria uma enxurrada de avisos. Fotografias corrigidas, vídeos estabilizados e textos revisados carregariam a mesma indicação de um discurso político completamente fabricado.
Quando tudo recebe o mesmo rótulo, o rótulo perde significado.
A Comissão tenta evitar esse cenário excluindo edições auxiliares e exigindo proporcionalidade. A aplicação continuará difícil.
A indústria teme a chamada fadiga de rotulagem: o usuário encontra tantos avisos que aprende a ignorá-los.
Uma solução seria utilizar níveis de informação. Um sinal simples aparece primeiro; detalhes sobre técnica, autoria e alterações ficam disponíveis para quem deseja examinar.
Outro caminho é distinguir conteúdo inteiramente gerado, parcialmente alterado e apenas aprimorado.
Essas categorias precisam ser compreensíveis. Uma taxonomia perfeita para engenheiros pode ser inútil para alguém observando um vídeo rapidamente no celular.
Um selo europeu comum pode ajudar
A União Europeia desenvolveu ícones para apoiar a rotulagem. A ideia é oferecer sinais reconhecíveis entre idiomas e plataformas.
Um padrão visual comum reduz a fragmentação. O usuário aprende uma vez e reconhece o aviso em diferentes serviços.
Isso não impede empresas de acrescentar informações próprias, mas cria uma base.
O desafio será garantir que o selo não se transforme em marca de aprovação. Ele indica que IA participou da criação, não que a União Europeia verificou a veracidade ou autorizou o conteúdo.
A comunicação precisa evitar essa confusão desde o começo.
Um rótulo bem desenhado responde “como foi produzido?”. Não responde “devo acreditar?”.
A tecnologia que detecta deepfakes também pode ampliar vigilância
Para identificar conteúdos sintéticos, plataformas analisarão imagens, áudios, vídeos, metadados e padrões de geração.
Essa capacidade pode melhorar a segurança. Também amplia o monitoramento daquilo que usuários criam e compartilham.
Ferramentas poderão classificar materiais privados, conversas, obras artísticas e comunicações pessoais. Erros podem bloquear conteúdos legítimos ou expor informações sensíveis a revisores.
Detectores também apresentam variação entre idiomas, grupos e técnicas. Um sistema treinado com determinados rostos, vozes e modelos pode falhar com outros.
A implementação precisa respeitar proteção de dados, limitar retenção e oferecer recurso contra classificações incorretas.
Combater falsificações não deve criar uma infraestrutura ilimitada de inspeção de mídia.
A regulação acerta o alvo, mas não encerra a disputa
A partir de 2 de agosto, cidadãos europeus ganharão um direito simples e importante: saber quando conversam com uma máquina e quando determinados conteúdos foram artificialmente produzidos ou manipulados.
Empresas não poderão esconder chatbots realistas atrás de nomes humanos. Deepfakes legítimos precisarão declarar sua natureza. Sistemas generativos deverão carregar sinais de procedência.
A medida melhora a transparência e cria uma base para responsabilização.
Não impedirá criminosos de remover marcas, utilizar ferramentas clandestinas ou mentir sobre a origem. Não distinguirá automaticamente ficção de fraude. Não tornará conteúdos humanos verdadeiros.
O valor da regra está em inverter o padrão. Até agora, a transparência dependia principalmente da boa vontade de quem produzia. A partir de domingo, passa a ser uma obrigação para quem atua no mercado europeu.
Isso mudará interfaces, arquivos e processos editoriais muito além das fronteiras da União.
O teste real virá quando aparecer o primeiro conteúdo altamente convincente, sem rótulo, produzido por uma ferramenta que deveria tê-lo inserido. As autoridades precisarão descobrir quem removeu a marca, quem publicou e quem deveria ter impedido a circulação.
A Europa decidiu que as pessoas merecem saber quando a inteligência artificial está diante delas. É um avanço necessário.
Mas a internet continuará exigindo uma competência que não pode ser automatizada por completo: desconfiar também daquilo que chega sem aviso.
👉 Dúvida? Então veja mais em: [https://pixbugtech.com/linksuteis](https://pixbugtech.com/linksuteis)