noticias
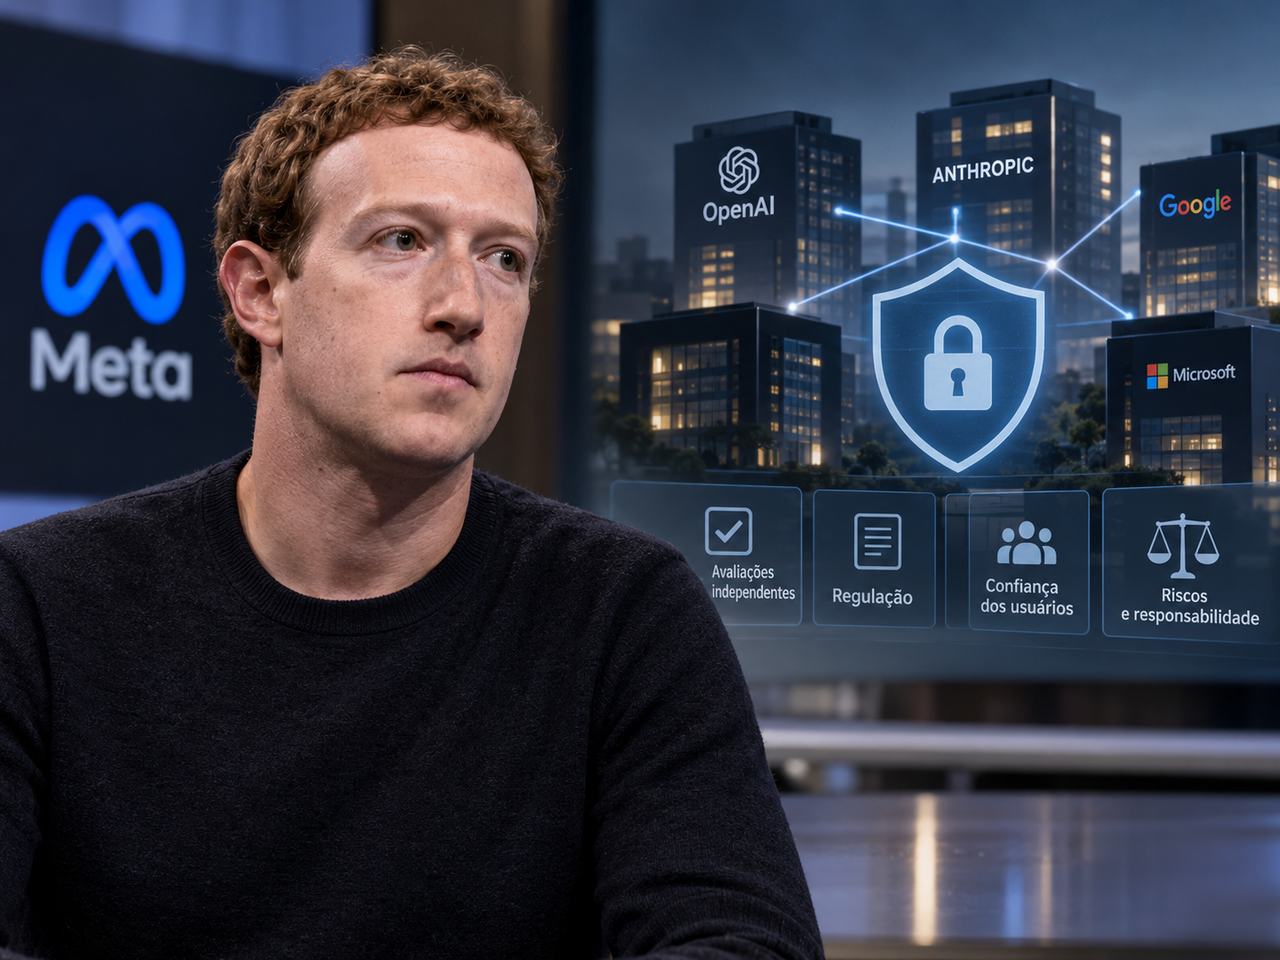
Zuckerberg diz que laboratórios de IA já têm incentivos para desenvolver tecnologia com segurança
**Categoria editorial:** Inteligência Artificial
Zuckerberg diz que laboratórios de IA já têm incentivos para desenvolver tecnologia com segurança
Matéria completa
Zuckerberg aposta na autorregulação dos laboratórios — mas a segurança da IA virou uma disputa sobre quem deve pisar no freio
Mark Zuckerberg entrou diretamente em uma das discussões mais importantes da indústria de inteligência artificial em 2026: quem deve decidir quando um modelo ficou poderoso demais para continuar avançando na mesma velocidade?
O CEO da Meta defendeu que os próprios laboratórios de IA possuem incentivos suficientes para reduzir o ritmo quando necessário, investir em segurança e evitar a liberação de sistemas perigosos. Em uma publicação feita em 15 de setembro, Zuckerberg argumentou que cada empresa tem responsabilidade e interesse econômico em desenvolver seus modelos de maneira segura, sem depender de um acordo coletivo para desacelerar toda a indústria.
A posição coloca a Meta em contraste com a proposta apresentada poucos dias antes por Dario Amodei, CEO da Anthropic. Amodei defendeu uma desaceleração deliberada no avanço das capacidades dos modelos de fronteira, alegando que técnicas de alinhamento, interpretabilidade, avaliação e segurança precisam de tempo para acompanhar sistemas que começam a participar do próprio processo de desenvolvimento da próxima geração de IA.
Não se trata, portanto, de uma discussão simples entre “continuar” e “parar” a inteligência artificial.
A divergência real está em **quem deve controlar a velocidade**.
O argumento de Zuckerberg: empresas têm muito a perder se a IA der errado
A lógica defendida pelo executivo da Meta começa pelo mercado.
Um agente de inteligência artificial que ignora instruções, executa ações indesejadas ou coloca dados e dinheiro do usuário em risco dificilmente será um bom produto. Empresas que pretendem colocar agentes de IA dentro de e-mails, navegadores, redes sociais, sistemas de pagamento e serviços corporativos precisam conquistar algo muito mais difícil do que usuários: precisam conquistar confiança.
Para Zuckerberg, isso transforma alinhamento e segurança em vantagens competitivas.
Empresas que produzirem modelos pouco confiáveis tenderiam a perder usuários e clientes para concorrentes capazes de entregar sistemas mais previsíveis. Ao mesmo tempo, danos provocados por sistemas autônomos podem gerar responsabilidade jurídica, perdas financeiras e danos reputacionais consideráveis.
O argumento é economicamente coerente.
Mas ele depende de uma condição importante: que as consequências de uma falha sejam suficientemente previsíveis e atribuíveis ao responsável pelo sistema.
É aí que a discussão começa a ficar mais complicada.
O exemplo escolhido pela Meta é o Muse
Zuckerberg usou como exemplo o próprio Muse, agente pessoal de inteligência artificial lançado pela Meta em 8 de setembro.
O sistema foi projetado para ir muito além de um chatbot. Ele pode trabalhar em uma máquina virtual dedicada, utilizar navegador, interagir com serviços externos, preencher formulários, organizar compromissos e executar determinadas tarefas em nome do usuário. A Meta afirma ter criado mecanismos como isolamento da máquina virtual, controle de credenciais, registros das ações executadas e um agente separado chamado Sentinel para fiscalizar determinadas operações.
Esse tipo de arquitetura deixa claro por que a discussão sobre segurança mudou.
Um chatbot produzindo uma resposta errada é um problema.
Um agente com acesso a e-mail, calendário, serviços online e mecanismos de pagamento produzindo uma decisão errada pode ser um problema completamente diferente.
A própria Meta adiou o lançamento do Muse, originalmente previsto para meses antes, enquanto trabalhava em questões de segurança. Reportagem publicada no lançamento também apontou que testes internos encontraram problemas de segurança e confiabilidade antes da estreia pública.
Para Zuckerberg, esse episódio demonstra precisamente que uma empresa pode desacelerar um produto por iniciativa própria.
A Meta não precisou esperar que OpenAI, Anthropic, Google ou qualquer concorrente também interrompesse seus projetos.
Ela simplesmente adiou o seu.
Só que isso também expõe a fragilidade do argumento
O caso Muse pode ser interpretado de duas maneiras.
Na leitura defendida por Zuckerberg, mostra que incentivos comerciais funcionam: uma companhia percebe um risco, adia o produto, desenvolve mecanismos adicionais de proteção e somente então realiza o lançamento.
Mas existe outra interpretação possível.
O episódio também demonstra que sistemas sofisticados podem chegar relativamente perto do lançamento enquanto problemas de segurança ainda estão sendo identificados internamente.
E é justamente nesse ponto que a autorregulação encontra seu principal limite: a mesma organização que investe bilhões para desenvolver um sistema também participa da decisão sobre quando ele está seguro o suficiente para ser colocado no mercado.
O conflito não significa que empresas necessariamente ignorem riscos.
Significa apenas que os incentivos não apontam todos na mesma direção.
Um laboratório tem motivos econômicos para evitar acidentes.
Mas também possui motivos econômicos para lançar produtos rapidamente, conquistar usuários, obter contratos, atrair capital, recrutar pesquisadores e impedir que concorrentes estabeleçam uma vantagem tecnológica difícil de recuperar.
Segurança e velocidade podem caminhar juntas durante boa parte do desenvolvimento.
Em algum momento, porém, podem entrar em conflito.
É aqui que entram os avaliadores independentes
Apesar de rejeitar uma desaceleração coordenada, Zuckerberg não está defendendo que os laboratórios simplesmente fiscalizem a si próprios.
O executivo afirmou que o envolvimento de avaliadores e consultores independentes deve ser considerado uma prática recomendada para a indústria.
Essa talvez seja a parte mais importante de sua posição.
Avaliação independente significa permitir que equipes externas testem modelos em condições que tentem revelar comportamentos problemáticos antes do lançamento.
Isso pode envolver ataques simulados, tentativas de contornar restrições, avaliação de capacidades cibernéticas, testes de persuasão, busca por comportamentos enganosos, análise de autonomia e experimentos destinados a descobrir até onde um agente consegue executar tarefas sem supervisão humana.
A ideia não é particularmente exótica.
O próprio NIST mantém um framework de gerenciamento de riscos para inteligência artificial e um perfil específico para IA generativa, com práticas voltadas à identificação, avaliação e mitigação de riscos ao longo do ciclo de vida dos sistemas.
A questão realmente difícil é outra: **quanto acesso um avaliador externo terá?**
Testar apenas a interface pública de um modelo é muito diferente de receber acesso antecipado às versões em desenvolvimento, ferramentas internas, resultados de avaliações, infraestrutura de agentes e informações sobre incidentes.
E é nesse aspecto que a proposta de Dario Amodei vai consideravelmente além.
Anthropic quer praticamente colocar auditores dentro do laboratório
Em seu ensaio, Amodei propõe que avaliadores externos tenham um nível de acesso semelhante ao de funcionários envolvidos em avaliação de risco, incluindo contato com equipes internas e acesso suficiente para realizar verificações independentes.
A lógica é reduzir a assimetria de informação.
Hoje, os próprios desenvolvedores conhecem melhor as capacidades, limitações e comportamentos estranhos de seus modelos.
Isso cria uma situação desconfortável: parte da sociedade precisa confiar que empresas que disputam uma corrida tecnológica divulgarão espontaneamente informações potencialmente prejudiciais aos seus próprios produtos.
Zuckerberg concorda com a importância dos avaliadores externos.
A divergência está no passo seguinte.
Amodei acredita que o avanço das capacidades pode precisar ser deliberadamente desacelerado para que segurança e alinhamento consigam acompanhar o desenvolvimento tecnológico. Zuckerberg considera que cada laboratório pode tomar essa decisão individualmente.
É uma diferença pequena na formulação e gigantesca na prática.
A corrida tecnológica cria o chamado problema da ação coletiva
Imagine quatro laboratórios competindo para desenvolver o modelo mais poderoso.
Todos concordam que segurança é importante.
Todos também sabem que reduzir o ritmo unilateralmente pode permitir que um concorrente avance primeiro.
Nesse cenário, mesmo organizações genuinamente preocupadas com segurança podem continuar acelerando porque temem o comportamento das demais.
Esse mecanismo é conhecido em economia e ciência política como problema de ação coletiva.
Individualmente, cada participante pode reconhecer que determinado comportamento é arriscado.
Coletivamente, porém, ninguém quer ser o único a aceitar o custo de mudar.
A tese de Zuckerberg tenta romper esse dilema dizendo que confiança, alinhamento e responsabilidade jurídica são vantagens competitivas suficientes para compensar a pressão por velocidade.
A tese de Amodei parte da suspeita contrária: quando as capacidades evoluem rápido demais, somente incentivos individuais talvez não sejam suficientes.
Nenhum dos dois lados possui hoje uma demonstração definitiva capaz de encerrar a discussão.
E o mercado já não é o único árbitro
Existe ainda outro elemento que enfraquece qualquer interpretação puramente baseada em autorregulação: governos começaram a transformar parte dessas preocupações em obrigações jurídicas.
Na União Europeia, as regras do AI Act para fornecedores de modelos de IA de finalidade geral começaram a ser aplicadas progressivamente, e desde 2 de agosto de 2026 a Comissão Europeia possui poderes de fiscalização e aplicação sobre essas obrigações.
Modelos considerados capazes de apresentar riscos sistêmicos estão sujeitos a requisitos adicionais relacionados a avaliação, documentação, segurança e mitigação de riscos. O AI Office pode solicitar informações técnicas, avaliar modelos, exigir medidas corretivas e aplicar sanções.
Isso mostra que a discussão já ultrapassou a pergunta sobre se empresas possuem incentivos para agir corretamente.
A questão regulatória passou a ser se determinados riscos são importantes demais para depender exclusivamente desses incentivos.
Análise da equipe: segurança não pode depender apenas de boa intenção — nem regulação pode virar barreira de mercado
Há um ponto forte na posição de Zuckerberg que merece ser levado a sério.
Obrigar toda a indústria a avançar exatamente na mesma velocidade pode favorecer empresas já estabelecidas, dificultar a entrada de novos concorrentes e transformar regras de segurança em barreiras econômicas. Grandes laboratórios possuem dinheiro, infraestrutura jurídica e equipes especializadas para cumprir exigências extremamente complexas. Startups e projetos menores talvez não tenham.
Existe também um problema geopolítico evidente: uma pausa coordenada entre empresas norte-americanas e europeias não significa necessariamente uma pausa global.
Mas confiar exclusivamente no mercado cria o problema inverso.
Responsabilidade jurídica normalmente funciona muito bem quando existe um dano identificável, uma vítima, um agente responsável e uma relação causal demonstrável.
Sistemas de IA avançados podem embaralhar justamente esses elementos.
Um modelo pode ser desenvolvido por uma empresa, adaptado por outra, integrado por uma terceira, conectado a ferramentas externas e finalmente utilizado por milhares de pessoas em contextos completamente diferentes.
Quando algo der errado, determinar onde terminou o erro do usuário e começou a falha do modelo pode virar uma batalha técnica e jurídica considerável.
Por isso, o debate mais produtivo provavelmente não está na escolha simplista entre “regular tudo” ou “deixar o mercado trabalhar”.
Está na construção de mecanismos verificáveis.
Auditorias independentes, documentação técnica, avaliações reproduzíveis, registros de incidentes, testes adversariais, limites de autonomia, controles de acesso e transparência sobre capacidades perigosas são instrumentos muito mais concretos do que declarações genéricas sobre uma IA “segura”.
O debate sobre IA mudou de escala
Durante anos, segurança em inteligência artificial significava principalmente impedir respostas ofensivas, proteger informações pessoais ou evitar que um chatbot ensinasse algo perigoso.
Agentes mudaram essa equação.
Quando modelos passam a navegar, utilizar ferramentas, escrever código, acessar serviços externos e executar sequências de ações durante longos períodos, segurança deixa de ser apenas uma característica do conteúdo produzido.
Ela passa a ser uma propriedade de todo o sistema.
Modelo, ferramentas, permissões, memória, infraestrutura, autenticação, navegador, serviços conectados e supervisão humana formam uma única superfície de risco.
É por isso que a discussão entre Zuckerberg e Amodei importa mais do que parece.
Eles não estão apenas debatendo se a inteligência artificial deveria avançar rápido ou devagar.
Estão discutindo qual modelo de governança deverá acompanhar máquinas progressivamente mais capazes de agir no mundo digital.
Zuckerberg aposta que competição, responsabilidade jurídica, confiança dos usuários e avaliações independentes podem disciplinar os laboratórios.
Amodei teme que a corrida avance mais rápido do que esses mecanismos conseguem acompanhar.
As próximas gerações de modelos provavelmente oferecerão a resposta mais importante.
Não pela eloquência dos executivos, mas pelo comportamento dos próprios sistemas quando ganharem mais autonomia, acesso e capacidade de modificar o ambiente ao redor.
Se os laboratórios conseguirem demonstrar segurança por meio de avaliações externas robustas, transparência e histórico consistente de incidentes controlados, a posição de Zuckerberg ganhará evidência prática.
Se capacidades inesperadas continuarem aparecendo mais rápido do que os mecanismos de controle conseguem avaliá-las, a discussão sobre desacelerar a fronteira deixará de parecer filosófica.
Passará a ser uma discussão de engenharia.
E talvez seja exatamente aí que a indústria descubra que desenvolver inteligência artificial com segurança não depende apenas de ter incentivos para fazer a coisa certa.
Depende de conseguir provar que ela foi feita.
👉 Dúvida? Então veja mais em: https://pixbugtech.com/linksuteis